


novembro 18, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
A maioria dos engenheiros conhece o Claude Code primeiro como um preenchimento automático mais inteligente. Peça para ele escrever uma função e você receberá uma função de volta. Essa definição funciona bem até que você comece a usá-lo de fato e perceba que algo diferente está acontecendo.
O Claude Code vai além do simples preenchimento automático. Ele lê arquivos, raciocina sobre bases de código, propõe edições, executa comandos de shell e se ajusta com base nos resultados. Isso é execução, não apenas previsão. Uma vez que um modelo pode executar, o prompt é apenas parte da história.
As equipes que percebem isso cedo param de perguntar "o que o Claude Code pode fazer?" e começam a fazer uma pergunta melhor: como o fluxo de trabalho realmente funciona? Que tipo de contexto ele está usando? Quais ferramentas ele chama? O que acontece quando um teste falha no meio do caminho? Como ele decide tentar novamente?
O prompt não responde a essas perguntas. As respostas estão no fluxo de trabalho.
Este guia explica como os fluxos de trabalho do Claude Code são estruturados, onde eles falham, como escalá-los em uma equipe e como é o uso em produção depois que as demonstrações terminam. Para entender esses aspectos, precisamos primeiro esclarecer o que é, de fato, um fluxo de trabalho do Claude Code.
Um(a)Claude Code Um fluxo de trabalho não é um prompt. Um prompt é apenas o início do fluxo de trabalho.
O fluxo de trabalho é o processo completo: o modelo recebe uma instrução, extrai contexto da base de código, escolhe quais ferramentas usar, faz alterações, lê os resultados e então decide o que fazer a seguir. Esse ciclo de interpretar, agir, observar e ajustar é o fluxo de trabalho.
Pense nele como cinco partes que estão todas conectadas:
Um exemplo concreto torna isso tangível. Você diz ao Claude Code: "Adicione validação de entrada ao manipulador de login". O que acontece na prática:
Essa sequência é o fluxo de trabalho: o prompt é uma linha, enquanto a execução ocorre em cinco etapas. Para ver como cada estágio se desenrola em detalhes, vamos percorrer o fluxo de trabalho passo a passo.
Um loop de execução estruturado pode se desenrolar a partir de uma única instrução. Cada etapa tem sua própria lógica e seu próprio modo de falha.
O fluxo de trabalho começa trazendo os arquivos relevantes. O Claude Code lê os arquivos de origem, inspeciona a estrutura do módulo e constrói uma visão funcional da base de código. Esta etapa é mais importante do que parece. Se você carregar os arquivos errados ou não carregar o suficiente, o modelo começará com uma visão distorcida. Essa distorção é transmitida para tudo o que vem a seguir.
Os limites da janela de contexto significam que esta é sempre uma visão parcial. A questão é se a fatia escolhida é a fatia certa.
A instrução é traduzida em um plano de ação. "Corrigir o teste instável" ainda não é algo acionável; o modelo precisa inferir o escopo, identificar quais arquivos são relevantes e se esta é uma tarefa de depuração, uma reescrita de teste ou um problema de fixture. A ambiguidade nesta etapa tende a aparecer como desvio mais tarde.
Uma vez que a tarefa é estruturada, ele começa a chamar as ferramentas. Leituras de arquivos. Buscas de símbolos. Geração de patches. Comandos de shell. Neste ponto, o fluxo de trabalho deixa de ser passivo. O modelo está agindo no repositório, não apenas raciocinando sobre ele. É aqui também que os limites de permissão e as configurações de ferramentas começam a importar.
A alteração proposta foi aplicada. Então, o fluxo de trabalho lê o que está realmente acontecendo: os testes são executados, as compilações funcionam ou falham, os linters reclamam. A execução produz feedback. Esse feedback é o que transforma a geração única em um loop agente. O modelo não termina quando produz um diff. Ele só é concluído quando o ciclo de feedback é fechado.
Com base no retorno, o modelo faz ajustes. Ele pode refinar o patch, abrir outro arquivo, mudar a abordagem ou determinar que a tarefa foi concluída. Esse ciclo pode ser rápido em tarefas bem definidas. Ele pode sair do controle em tarefas mal delimitadas, especialmente quando o contexto piora durante a execução.
O caminho de execução básico é mais ou menos assim:
ler arquivos → interpretar tarefa → invocar ferramentas → aplicar patch → executar testes → observar saída → iterar ou parar.
Compreender esse caminho ajuda a esclarecer a arquitetura por trás dos fluxos de trabalho do Claude Code.
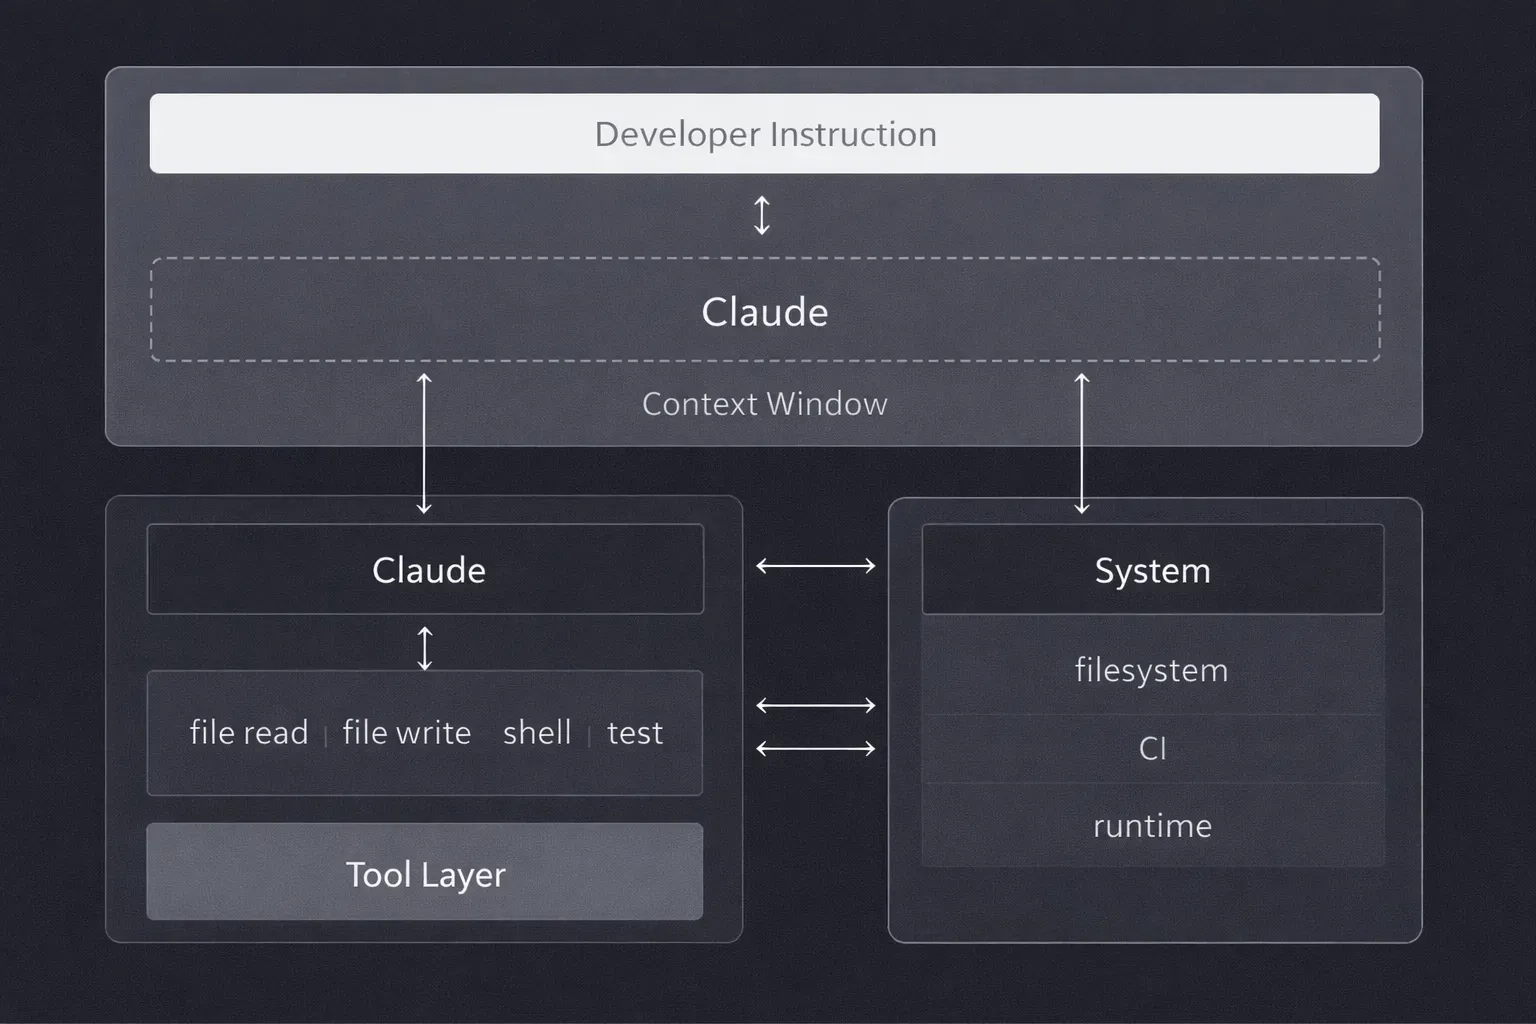
No nível mais alto, a arquitetura segue um caminho simples:
instrução do desenvolvedor → Claude → camada de ferramentas → sistema de arquivos e tempo de execução.
Mas cada limite introduz restrições que moldam como o fluxo de trabalho realmente se comporta.
O fluxo de trabalho passo a passo descreve o que o Claude Code faz. Esta seção explica o que está acontecendo por baixo desses passos.
O Claude trabalha dentro de uma janela de contexto limitada. Ele não consegue ler toda a base de código de uma só vez. Ele vê uma fatia escolhida pelo que foi carregado no início da execução e pelo que se acumulou durante o processo. Isso não é um erro; é uma propriedade fundamental. Mas significa que cada decisão que o modelo toma é baseada em informações incompletas, mesmo quando não parece ser assim do lado de fora.
O Claude não modifica arquivos nem executa comandos diretamente. Ele chama ferramentas que fazem isso. Leituras de arquivos, edições e execuções de shell são expostas como interfaces estruturadas. Em princípio, essa abstração mantém o fluxo de trabalho combinável e auditável. Você pode inspecionar o que o modelo solicitou. Mas isso também significa que falhas na camada de ferramentas (timeouts, gravações parciais, formatos de saída inesperados) aparecem como problemas de comportamento do modelo quando, na verdade, são problemas de infraestrutura.
O estado reside em dois lugares. O estado implícito se acumula dentro da janela de contexto à medida que o raciocínio progride. Durante a execução, o estado explícito é gravado em arquivos, logs e saídas de comando. Quando a janela de contexto enche ou é reduzida, o estado implícito se degrada. O modelo continua a execução, mas usa uma imagem interna diferente daquela com a qual começou.
O Claude Code se encaixa em vários fluxos de trabalho de desenvolvimento comuns. Você pode usá-lo para entender códigos existentes, fazer alterações, investigar problemas e verificar seu trabalho sem precisar alternar entre várias ferramentas.
Quando você estiver em um repositório novo, peça ao Claude Code para rastrear como um recurso ou função funciona. Ele pode encontrar arquivos relevantes, seguir dependências e explicar a implementação existente antes que você toque no código.
Para uma nova funcionalidade, comece fornecendo o requisito ao Claude Code e pedindo que ele analise a base de código e crie um plano de implementação. Assim que a abordagem parecer correta, ele pode realizar as alterações e executar as verificações relevantes.
Compartilhe o erro, o teste com falha ou o comportamento inesperado com o Claude Code. Ele pode rastrear o problema, identificar a causa provável, aplicar uma correção e testar se o problema foi realmente resolvido.
Use o Claude Code quando uma refatoração abranger vários arquivos ou envolver alterações repetitivas. Ele pode seguir os padrões existentes ao fazer as alterações, após o que você pode revisar o diff e executar seus testes.
O Claude Code pode escrever testes para novos comportamentos e executar testes existentes após uma alteração. Quando algo falha, ele pode investigar a falha e iterar sobre a implementação.
Antes de abrir um pull request, peça ao Claude Code para revisar as alterações em busca de bugs, testes ausentes e inconsistências. Ele também pode resumir o trabalho e destacar qualquer coisa que mereça uma revisão humana mais detalhada.
O Claude Code inclui vários recursos que tornam esses fluxos de trabalho mais fáceis de gerenciar, automatizar e repetir. Cada um resolve uma parte diferente do processo de desenvolvimento.
O CLAUDE.md fornece instruções e contexto específicos do projeto para o Claude Code. Você pode usá-lo para definir convenções de codificação, comandos comuns, notas de arquitetura e regras que o agente deve seguir.
As habilidades (Skills) permitem que você empacote instruções repetíveis para tarefas específicas. Em vez de explicar o mesmo processo em cada prompt, você pode criar uma habilidade que o Claude Code pode usar quando essa tarefa surgir.
Os subagentes permitem que o Claude Code delegue tarefas específicas para agentes separados. Isso é útil quando um fluxo de trabalho envolve investigação paralela, análise especializada ou tarefas que podem ser tratadas de forma independente.
Os hooks permitem que você execute comandos automaticamente em pontos específicos do fluxo de trabalho do Claude Code. Você pode usá-los para tarefas como formatação, validação, registro ou outras verificações que devem ocorrer de forma consistente.
Os Git worktrees permitem que você trabalhe em várias ramificações (branches) em diretórios separados sem alternar repetidamente a mesma árvore de trabalho. Isso pode ser útil quando o Claude Code precisa lidar com tarefas paralelas ou experimentos.
O MCP conecta o Claude Code a ferramentas externas e fontes de dados. Com o servidores MCP, você pode dar ao Claude Code acesso a serviços como bancos de dados, APIs, rastreadores de problemas ou outras ferramentas usadas no seu fluxo de trabalho de desenvolvimento.
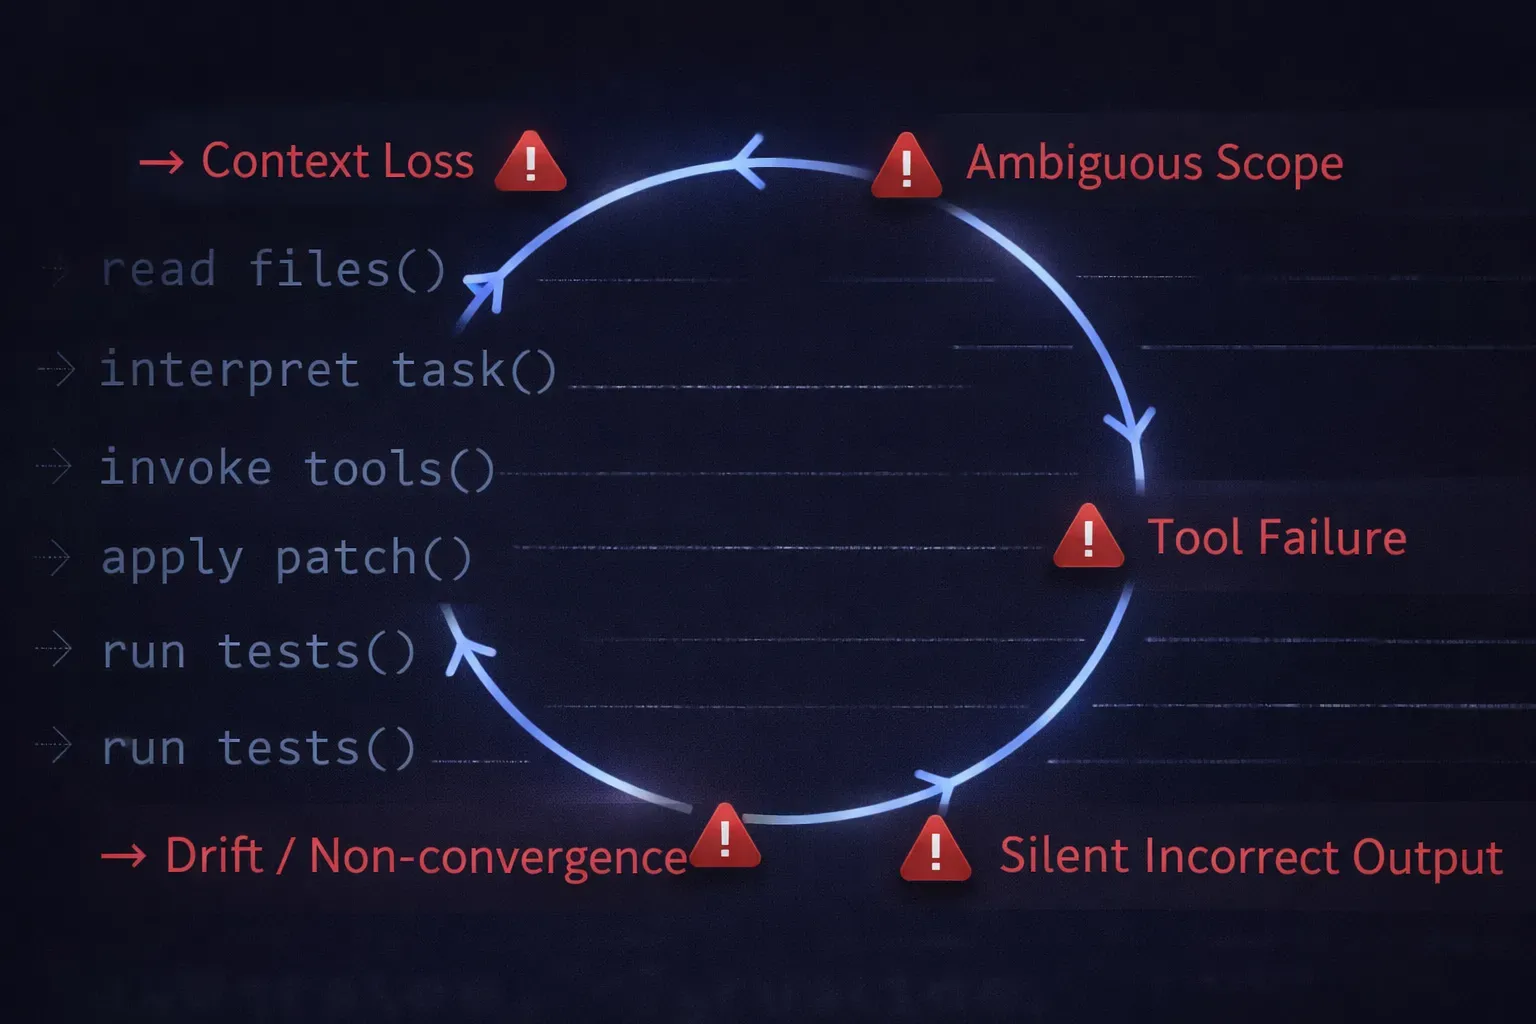
Esta é a parte que as equipes frequentemente ignoram. O modo de falha raramente é dramático. O Claude Code geralmente não produz códigos obviamente ruins. Ele falha silenciosamente, com edições que parecem plausíveis, mas que estão sutilmente erradas, alterações que passam nos testes, mas perdem o objetivo, e um raciocínio que se desvia no meio da execução sem um sinal claro.
O fluxo de trabalho começa com os arquivos certos. Então, mais contexto é carregado, junto com saídas adicionais de ferramentas, patches intermediários e resultados de comandos. A janela de contexto enche. Algo é descartado. O modelo continua raciocinando, mas com base em uma imagem interna diferente. Nada parece obviamente quebrado. É isso que o torna perigoso.
Uma chamada de função no patch gerado referencia um objeto inexistente. Uma refatoração introduz uma dependência que nunca foi necessária. O diff parece limpo demais, quase perfeito. Ele chega formatado como um código correto. É exatamente por isso que ele passa despercebido na revisão.
Você vê o diff final. Você não consegue ver a ordem das leituras e tentativas que o produziram. Quando o resultado está errado, não há um rastro confiável explicando por que o modelo se desviou. A depuração torna-se uma arqueologia voltada para o passado, em vez de uma instrumentação voltada para o futuro. Ferramentas de observabilidade para agentes de IA pode ajudar.
Execute a mesma tarefa duas vezes e os resultados divergem. Nem sempre de forma drástica, mas o suficiente para tornar a depuração de padrões irritante. O contexto varia ligeiramente entre as execuções. As saídas das ferramentas diferem. O modelo segue um caminho diferente para o mesmo problema. A reprodutibilidade é um requisito operacional subestimado, especialmente quando esses fluxos de trabalho afetam códigos críticos.
O modelo trabalha com o que as ferramentas retornam. Um comando de shell atinge o tempo limite. Um executor de testes encerra com saída parcial. Uma gravação de arquivo é bem-sucedida, mas o conteúdo é truncado. O modelo responde ao que realmente recebeu, não ao que deveria ter recebido. O que parecia robusto em testes locais rapidamente se desfaz quando a infraestrutura real entra em jogo.
A robustez observada em demonstrações rapidamente dá lugar à fragilidade com a infraestrutura real. Essas falhas complicam o dimensionamento de fluxos de trabalho em equipes e sistemas maiores.
Um desenvolvedor executando um fluxo de trabalho é um experimento de produtividade. Uma equipe de engenheiros executando fluxos de trabalho sobrepostos em uma base de código compartilhada torna-se um problema operacional. As falhas tornam-se facilmente identificáveis em escala, mas mais difíceis de isolar.
Em um único repositório, o modelo consegue construir uma imagem funcional do código. Essa imagem se quebra quando você adiciona um service mesh, múltiplos repositórios, bibliotecas compartilhadas e dependências com versões fixas. Uma alteração que parece correta dentro de um repositório cria uma inconsistência sutil em outro. O fluxo de trabalho não sabe o que não consegue ver.
Dois engenheiros pedem independentemente ao Claude Code por alterações semelhantes. Eles recebem padrões diferentes. Nenhum está exatamente errado, mas agora existem duas maneiras de resolver o mesmo problema na base de código. Sem estado compartilhado ou visibilidade sobre o que o agente já alterou, a coordenação falha no nível do fluxo de trabalho, não apenas no nível do código.
Fluxos de trabalho de agentes que podem executar comandos de shell ficam próximos aos limites de produção. Permissões muito amplas aumentam o raio de impacto. Permissões muito restritas causam falhas imprevisíveis. Nenhum desses problemas é resolvido ajustando prompts. Isso exige configuração deliberada de ferramentas e controle de acesso em nível de infraestrutura.
Eventualmente, alguém perguntará: “Qual fluxo de trabalho alterou este arquivo? Qual comando foi executado como parte dessa tarefa? Quem aprovou? Se o sistema não consegue responder a essas perguntas, ele carece de governança. Ele tem atividade. Essa distinção é importante quando esses fluxos de trabalho tocam em códigos que lidam com dinheiro, autenticação ou dados. Nosso artigo sobre governança de agentes de IA explica o conceito com mais detalhes.
Depurar uma única execução com falha já é complicado porque os rastreamentos de execução são incompletos. Depurar padrões em várias execuções é mais difícil. As saídas variam ligeiramente por execução. O contexto difere. O comportamento da ferramenta muda. Sem um log de execução estável e estruturado, reproduzir uma falha é uma perseguição, não uma investigação.
O uso em produção muda o que é importante. Em uma demonstração, o objetivo é a qualidade da saída. Em produção, o objetivo é uma execução confiável, auditável e repetível. As práticas que levam a isso não são sobre o modelo; são sobre como você estrutura o sistema ao redor dele.
"Refatore o módulo de autenticação" é uma direção. "Refatore o módulo de autenticação para consolidar a lógica duplicada de validação de token, mas não altere as assinaturas de métodos públicos e não toque no diretório de migrações" é uma restrição. Restrições são mais úteis do que entusiasmo. Elas dão ao fluxo de trabalho algo concreto a respeitar, não apenas um destino genérico.
Mais contexto nem sempre é melhor. Carregar metade do repositório junto com logs obsoletos e arquivos de saída irrelevantes aumenta o ruído sem aumentar a precisão. Fluxos de trabalho eficazes são seletivos: forneça ao modelo o suficiente para raciocinar sobre a tarefa, não tudo o que possa estar tangencialmente relacionado. A disciplina aqui é cortar, não adicionar.
Se o fluxo de trabalho está gerando testes, ele provavelmente não precisa de acesso a scripts de implantação. Se está refatorando o código da aplicação, acesso amplo ao shell é desnecessário. Restringir o acesso a ferramentas reduz o raio de impacto e diminui a superfície de raciocínio que o modelo precisa navegar. Mais restrito é, geralmente, mais confiável.
Uma etapa de revisão de diff, uma flag de simulação (dry-run) e um portão de confirmação antes que as alterações sejam aplicadas. Isso desacelera o fluxo de trabalho levemente e detecta suposições fracas antes que se tornem commits. Em sistemas agentes, o ponto de verificação não é burocracia; é o lugar onde o julgamento humano se integra à execução automatizada. Removê-lo é apostar que o modelo nunca se desviará.
Saber que o código final compilou não é suficiente. Você precisa saber quais arquivos foram lidos, quais comandos foram executados, quantas tentativas ocorreram e como estava o estado intermediário. Um fluxo de trabalho pode produzir uma saída correta e ainda assim ser instável. Essa instabilidade geralmente aparece no rastreamento da execução antes de se tornar um incidente.
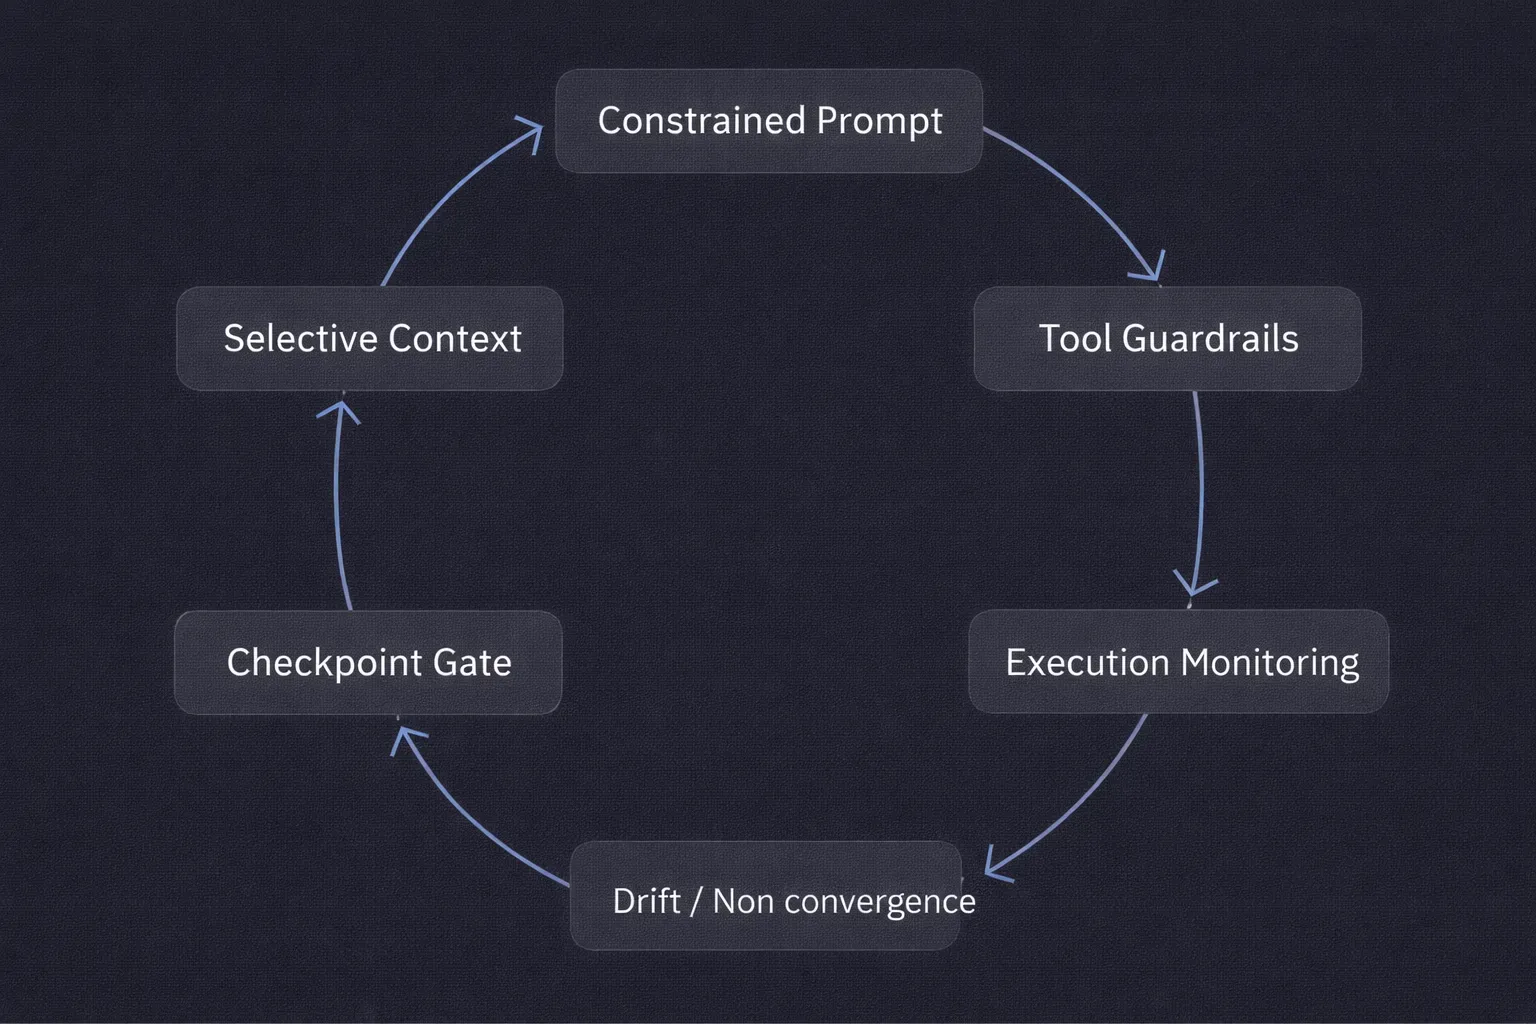
Não trate a verificação como uma etapa manual final. Torne as compilações, testes, linting e outras verificações relevantes parte do próprio fluxo de trabalho, para que cada alteração seja validada antes de prosseguir. Isso dá ao agente um feedback imediato e torna a execução bem-sucedida mais fácil de reproduzir.
Os fluxos de trabalho do Claude Code são úteis para tarefas que são estruturadas o suficiente para serem feitas automaticamente, mas entediantes o suficiente para que as pessoas sempre as adiem. Essa é uma categoria bastante específica, e ser claro sobre isso economiza tempo.
A decisão não é entre Claude Code ou não Claude Code. É entre Claude Code com o escopo correto e Claude Code sendo solicitado a fazer algo em que não consegue se limitar de forma confiável.
A transição do preenchimento automático para a execução por agentes já está em andamento. O Claude Code não é um mecanismo de sugestão mais inteligente; é um sistema de execução que lê, age, observa e ajusta. Essa distinção muda o que significa confiabilidade.
Um fluxo de trabalho bem executado com o Claude Code oferece algo real: menos tempo gasto em refatorações mecânicas, cobertura de testes mais rápida e tarefas de migração que não ficam presas no backlog de ninguém. Mas o termo "bem executado" é fundamental aqui. Ele exige um controle cuidadoso do contexto, permissões de ferramentas definidas, prompts estruturados, pontos de verificação antes da execução e instrumentação do que foi realmente executado.
As equipes que descobrem isso tratam o fluxo de trabalho menos como um prompt inteligente e mais como um sistema de execução delimitado, que precisa da mesma disciplina operacional que qualquer outra peça de infraestrutura que interage com código de produção.
Assim que os fluxos de trabalho começam a modificar repositórios, executar comandos e operar dentro de ambientes reais, eles deixam de ser experimentos. Eles se tornam infraestrutura. A questão, então, é se o sistema ao redor oferece visibilidade e controle suficientes para tornar isso seguro.
TrueFoundry oferece às equipes uma camada centralizada para gerenciar a execução de agentes, acesso a ferramentas, observabilidade e governança de IA à medida que os fluxos de trabalho do Claude Code avançam para a produção. Se você está criando fluxos de trabalho com o Claude Code em escala, a TrueFoundry pode ajudá-lo a gerenciar a execução de agentes, acesso a ferramentas, observabilidade e governança a partir de uma única plataforma.
Agende uma demonstração para ver como ele se encaixa na sua configuração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Claude skills are reusable capabilities or instructions for specific tasks, while workflows describe the broader sequence of steps used to complete a task. A workflow can use one or more skills as part of its execution.
There is no single best workflow. A practical approach is to first understand the codebase, plan the change, implement it, run tests, review the diff, and then verify the final result.
Yes. Claude can create flowcharts from a process or set of instructions, including formats such as Mermaid. You can describe the workflow you want to visualize, and Claude can structure the steps and relationships into a flowchart.
No. Claude Code workflows are structured development processes for tasks such as coding, testing, and debugging. Dynamic workflows generally adapt their steps or behaviour based on changing inputs, conditions, or results during execution.
Yes. Claude Code can use subagents to delegate specific tasks. This allows a workflow to split work such as research, code analysis, testing, or review into separate tasks that can be handled independently.
Yes. Independent tasks can be delegated to multiple subagents and run concurrently where the workflow supports it. Parallel execution can reduce overall time, although tasks with dependencies still need to run sequentially.
Not automatically in their entire runtime state. However, project instructions, skills, configuration, and other persistent files can carry context across sessions. You should explicitly store important workflow instructions or state that Claude Code needs to reuse.
Start by defining the task and constraints, then give Claude Code the required context, allow the appropriate tools, execute the changes, and verify the result through tests or other checks



As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















