



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
O Bifrost aparece em quase todas as listas de seleção de “gateways de IA” em 2026, geralmente acompanhado das palavras mais rápido e open source. Nenhuma das duas alegações resiste a uma leitura direta dos próprios números do fornecedor, por isso verificamos da forma mais rigorosa: fizemos nosso próprio benchmark em um ambiente isolado de 1 vCPU.
Este artigo aborda em que medida as promessas de desempenho do Bifrost se sustentam sob medição real — em uma infraestrutura fixa de 1 vCPU / 2 GB, o mesmo padrão que exigimos de todos os gateways nesta comparação.
Esta é a seção à qual toda alegação de “gateway mais rápido” precisa responder.
O número do fornecedor: ~5.000 RPS com ~11 microssegundos de overhead médio — em uma t3.xlarge (4 vCPUs), contra um upstream simulação (mock). Antes de comparar isso com qualquer outra coisa, leia o que ele realmente mede. Segundo o próprio código-fonte do Bifrost, o valor em microssegundos é obtido sem o processamento de requisições HTTP e serialização JSON — ou seja, é o tempo gasto no pipeline interno do gateway, não a latência líquida adicionada à requisição do chamador. O mesmo código-fonte indica 59 µs em uma t3.medium, o que significa que ele já degrada cerca de 5x em uma máquina menor. Além disso, é uma média, não um percentil, obtida em 4x a capacidade computacional que a maioria das equipes realmente aloca para um contêiner de gateway.
Nada disso torna o número desonesto; ele apenas responde a uma pergunta diferente de “como é o meu p99?”. Tudo a seguir é o outro número: latência adicionada de ponta a ponta para tamanhos de payload reais e documentados, incluindo serialização e HTTP — o custo total que o chamador paga por ter o gateway no caminho. Tanto microssegundos quanto milissegundos são verdadeiros aqui, porque estão medindo coisas diferentes.
Montamos um ambiente fixo — 1 vCPU, 2 GB de RAM, carga em malha aberta, o mesmo padrão que exigimos de todos os gateways nesta comparação — e medimos o Bifrost diretamente em três tamanhos de payload: pequeno (200 tokens de entrada / 100 de saída), médio (2.000/500) e grande (20.000/1.000). O mock upstream atrás do Bifrost também foi fixado, para que qualquer lentidão fosse do Bifrost e não de um dublê de teste instável: 50 ms de tempo de “pensamento” + 50 ms até o primeiro token para chamadas sem streaming, e um intervalo fixo de streaming de 500 ms para chamadas com streaming — esses são os pisos de ~55 ms e ~530–627 ms que você verá nos gráficos abaixo, presentes em todos os tamanhos de payload.
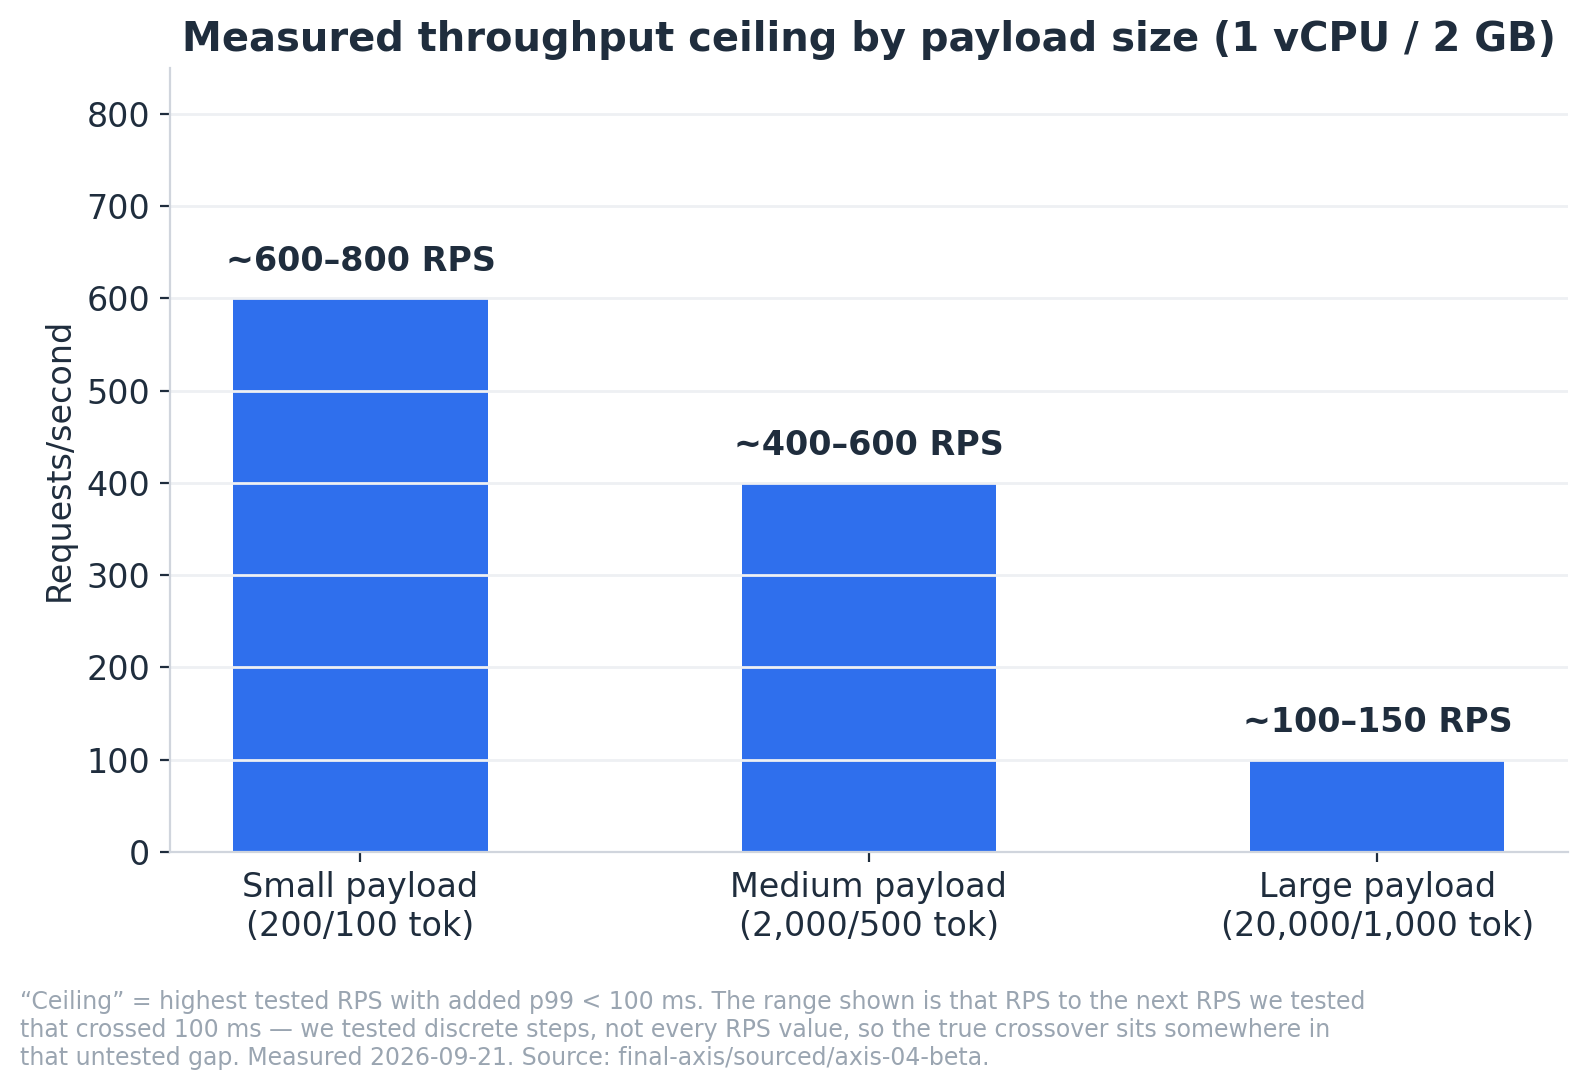
Limites reais de throughput, com uma margem de latência adicionada de 100 ms: ~600–800 RPS para payloads pequenos, ~400–600 para médios, ~100–150 para grandes. Esses valores são intervalos, e não números exatos, de propósito — testamos passos discretos de RPS, não todos os valores, portanto cada teto é na verdade “o último RPS que confirmamos estar adequado, até o próximo que confirmamos não estar”. Abaixo do limite inferior desses intervalos, a requisição mediana paga de 2 a 6 ms pelo gateway. Essa mediana é o número mais amigável desta seção e o menos útil para o planejamento de capacidade: ela quase não se altera com a carga — de 2,1 a 3,1 ms para payloads pequenos em uma variação de 60x do tráfego oferecido — portanto, permanece reconfortante até o exato momento em que o gateway falha. O número que realmente varia é o p99. O p99 adicionado sobe de +5,6 ms (pequeno), +7,5 ms (médio) e +15,2 ms (grande) a 10 RPS para +60 ms para pequeno a 600 RPS, +75 ms para médio a 400, e +41 ms para grande a apenas 100 — e então ultrapassa o teto de 100 ms logo no passo seguinte testado nos três casos. Acima do limite superior, nenhum dos três tamanhos de payload degrada de forma suave, e cada um falha de maneira diferente. Veja cada payload lado a lado, o gateway comparado à sua própria medição direta em relação ao mock (não uma única linha de base aproximada compartilhada entre os tamanhos — pequeno, médio e grande têm, cada um, um piso direto genuinamente diferente de ~55–62 ms, e o gráfico mostra o número real para cada um):
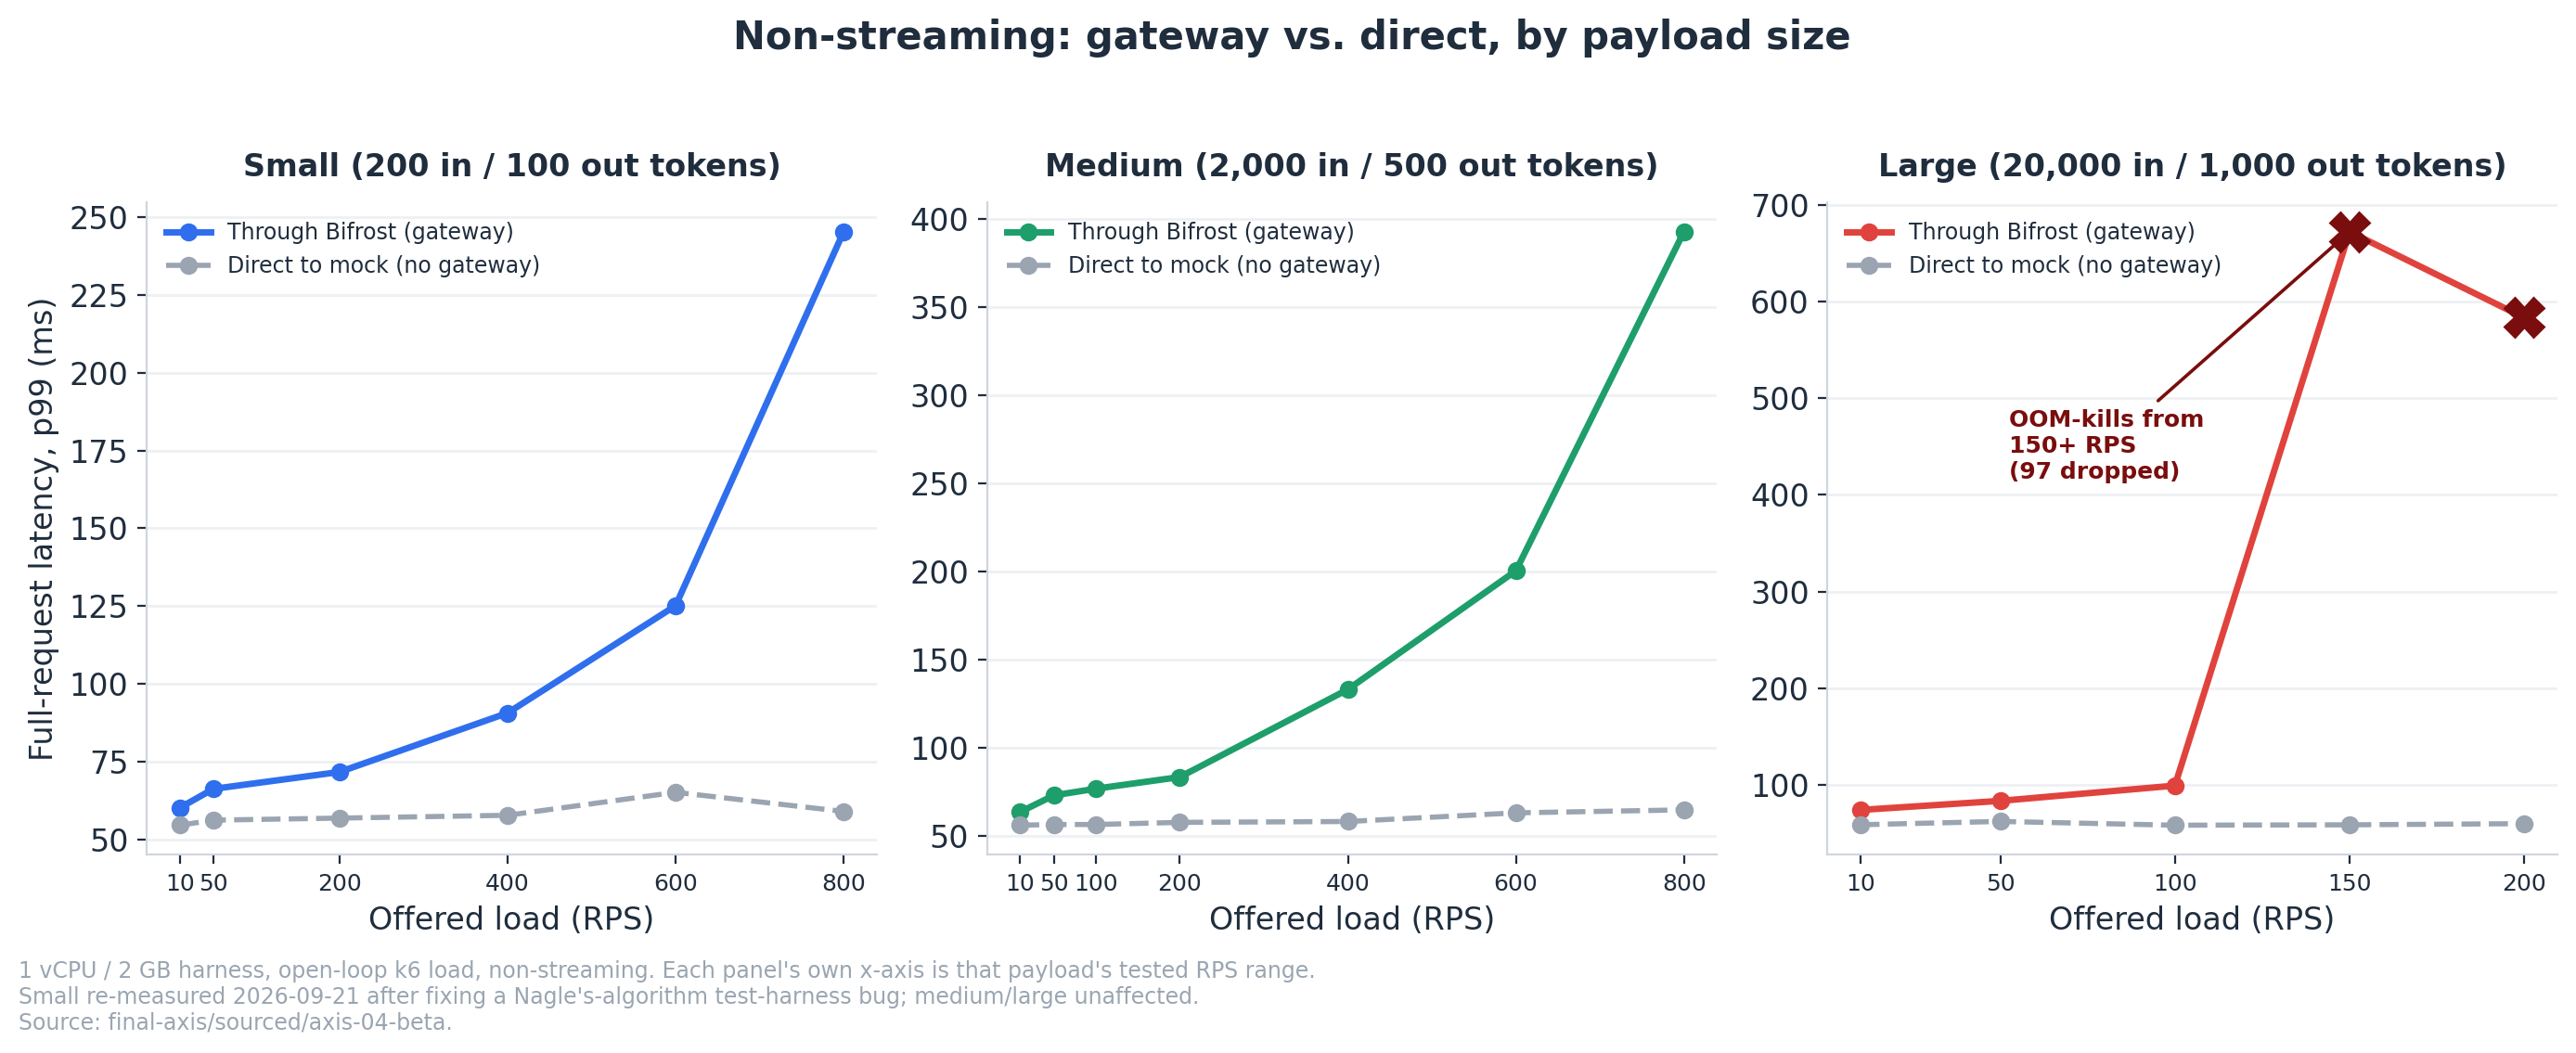
Payloads pequenos e médios seguem o mesmo padrão — estável, seguido por uma cauda de p99 em ascensão — apenas em taxas de RPS diferentes. A subida do payload pequeno começa em torno de 400–600 RPS; a do médio começa antes por requisição, mas seu teto mais rígido está mais distante (400+ RPS) porque sua entrada de 2.000 tokens mantém o custo por requisição mais alto do início ao fim. O payload grande não sobe gradualmente: permanece estável de 10 a 100 RPS, e então sofre uma queda abrupta a 150 RPS, onde o pod começa a ser encerrado por falta de memória (OOM-kill) no meio da execução (61 requisições perdidas a 150 RPS, e mais 97 a 200). Isso não é um gargalo de enfileiramento como no caso dos payloads pequenos/médios — é um limite rígido de recursos, que se manifesta como um salto quase vertical em vez de uma curva.
O streaming atinge o mesmo teto, só que mais rápido, porque cada stream aberto mantém seus buffers na memória por mais tempo — mesmo tratamento, gateway vs. direto, por payload:
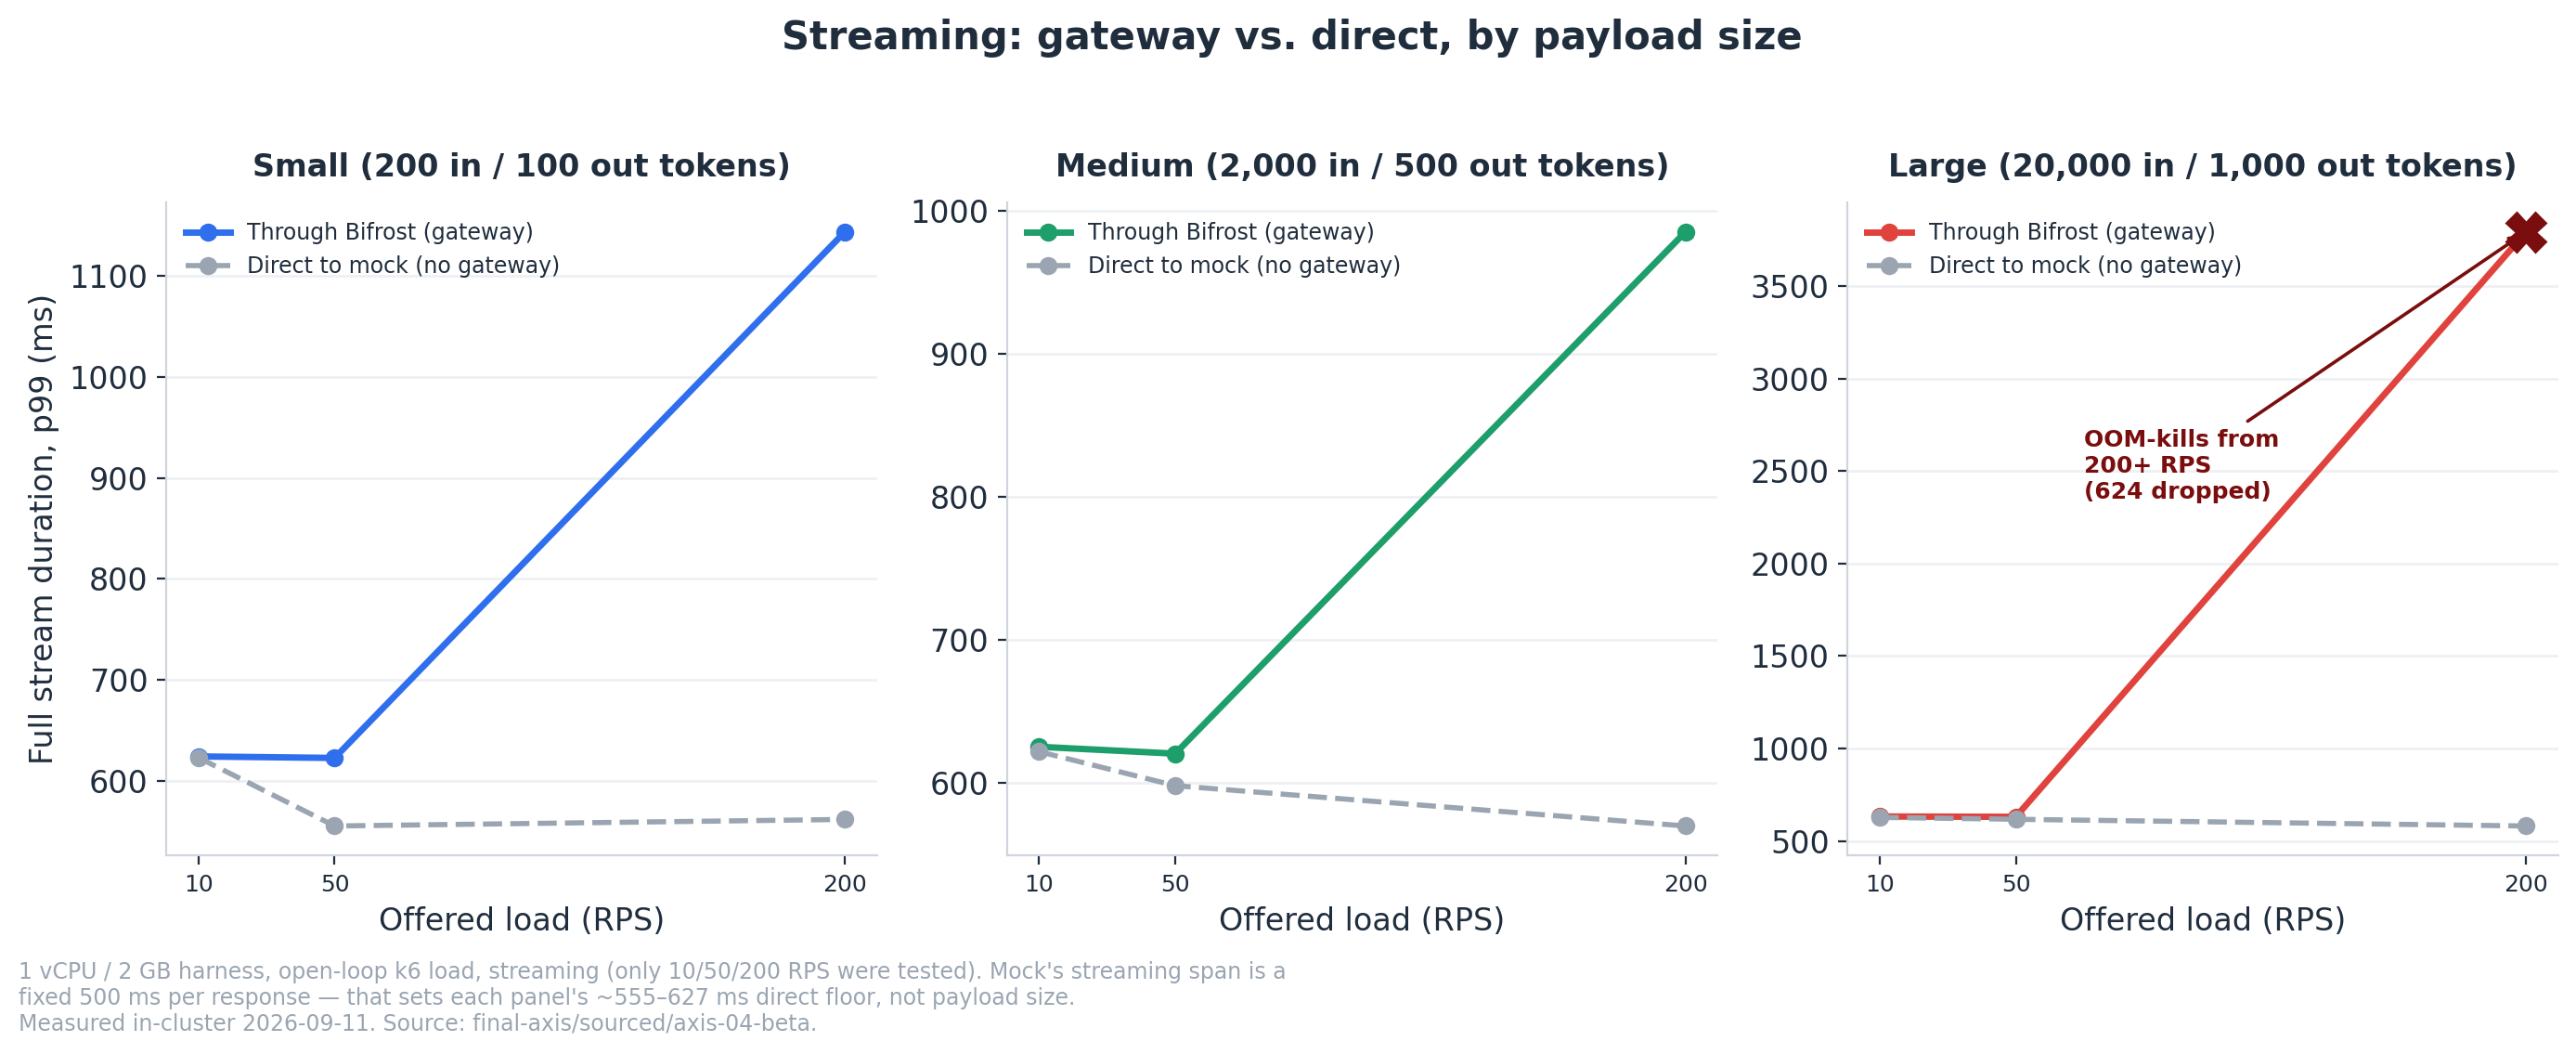
O streaming pequeno e o médio acompanham de perto seu piso direto de ~555–627 ms até 50 RPS, e começam a subir por volta de 200 RPS (o p99 pequeno atinge ~1,14 s, e o médio ~985 ms — ambos por enfileiramento, não por OOM). O streaming grande também não apresenta essa subida gradual: a 200 RPS ele entra em colapso por OOM no meio da execução, derrubando 624 de 12.001 streams e elevando o p99 para ~3,8 segundos. Se sua carga de trabalho faz streaming de documentos grandes, 200 RPS em uma vCPU não é um nível “mais lento” — é um nível em que o sistema “falha”.
A duração total do stream não é o número mais importante se a sua interface só precisa que o primeiro token apareça — por isso, medimos isso separadamente, com uma sonda assíncrona pareada que mede o tempo real até o primeiro token de conteúdo, e não o TTFB do k6 (que não é válido para SSE aqui, já que o mock envia os cabeçalhos antes de qualquer token existir):
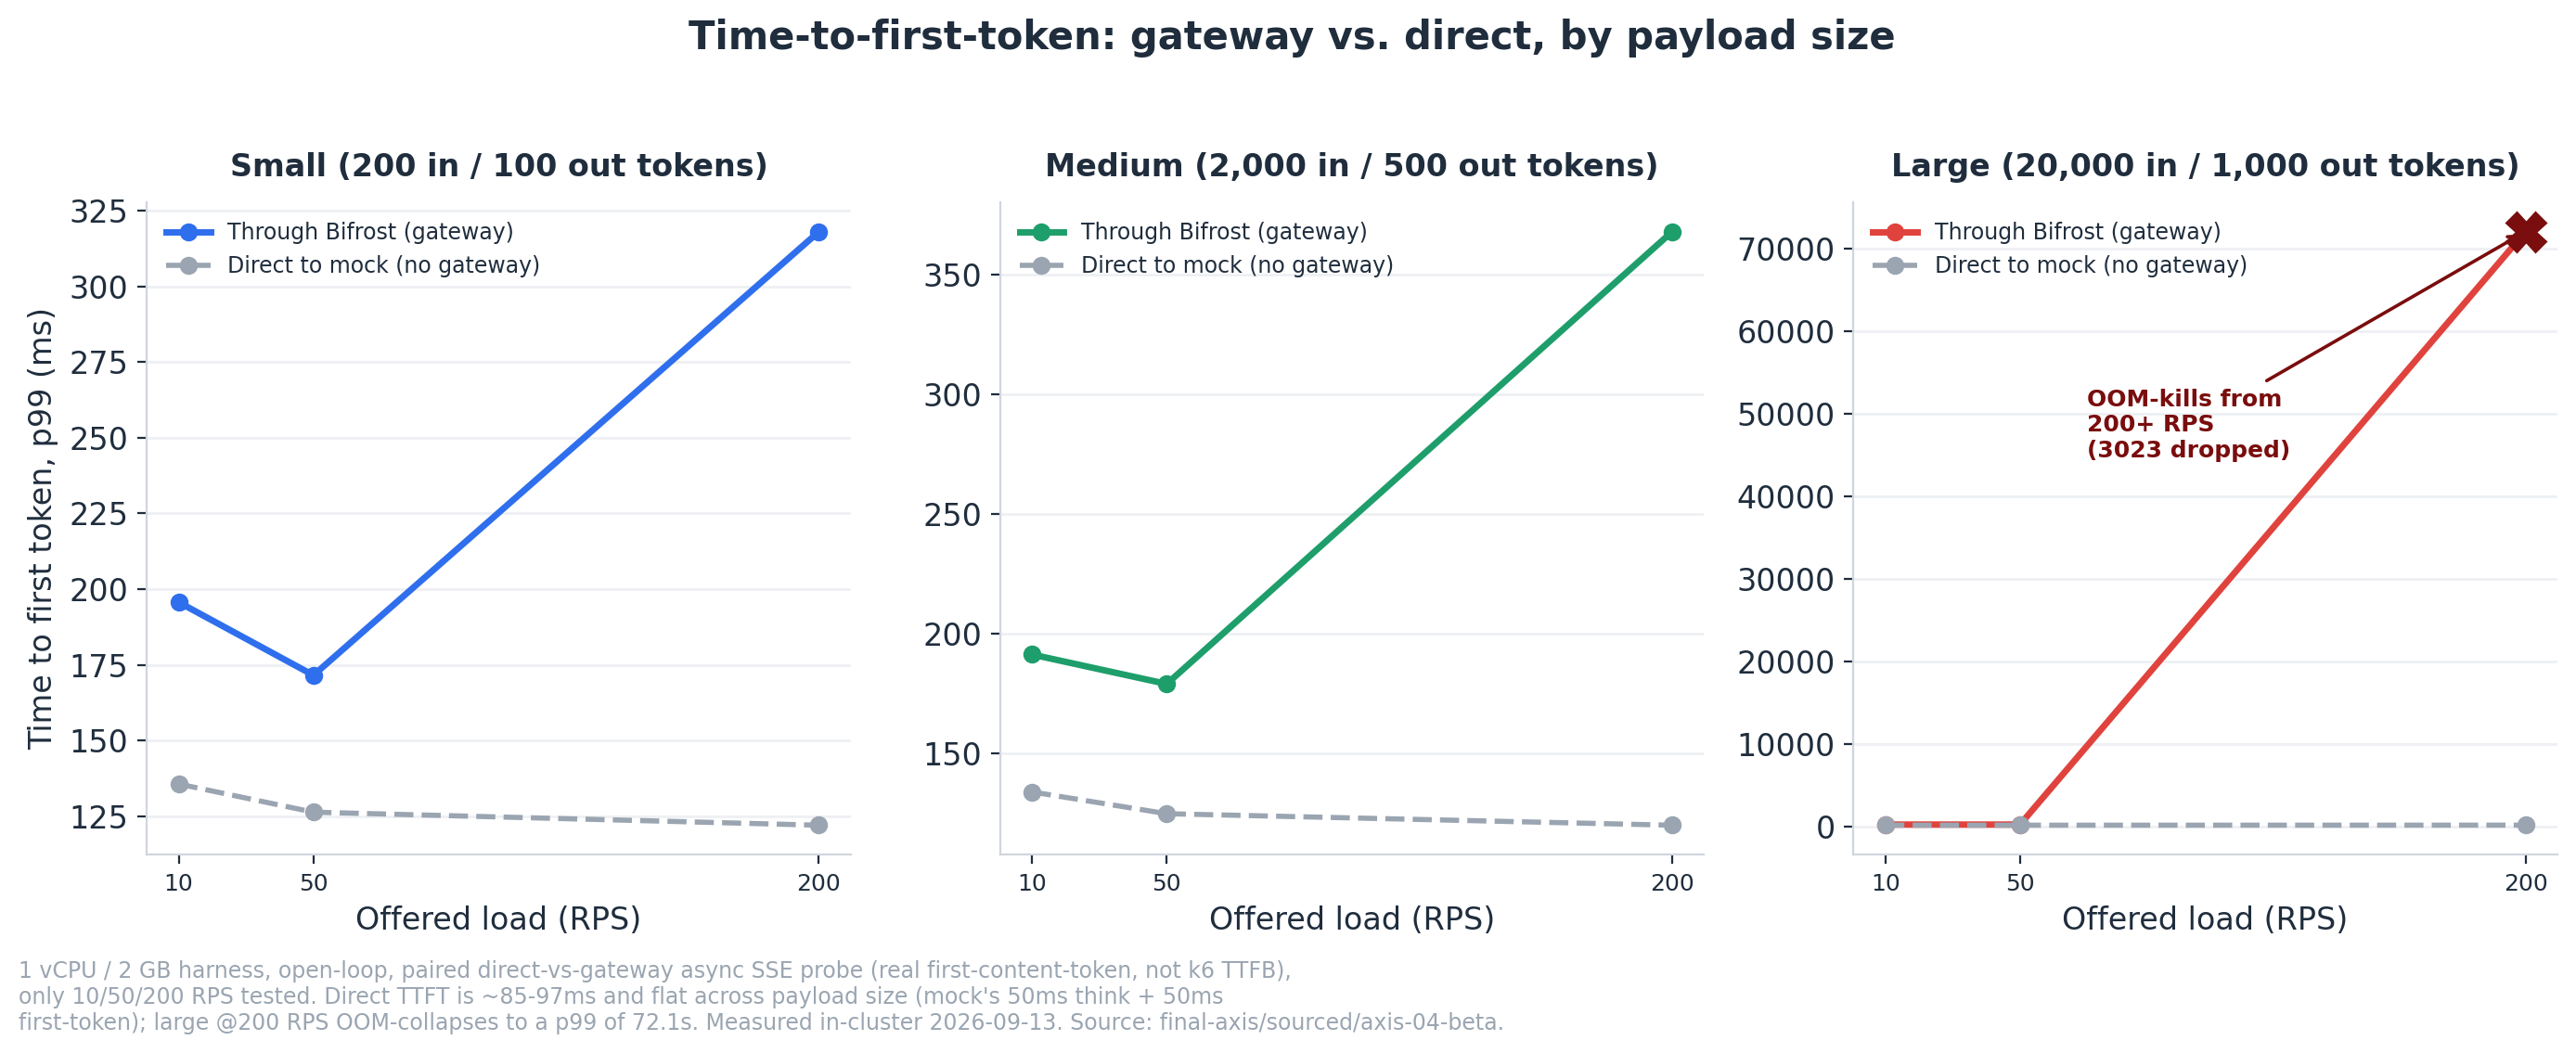
O TTFT direto é de ~85–97 ms e permanece constante nos três tamanhos de payload — confirmando que o tamanho da entrada não altera o tempo até o primeiro token, portanto tudo acima desse piso é o custo de inicialização de streaming por requisição do próprio Bifrost. Esse custo adicional é de ~27–46 ms e independente do tamanho a 10–50 RPS (grande a 10 RPS adiciona +46 ms, pequeno a 10 RPS adiciona +43 ms — mesma ordem, payload diferente). A 200 RPS, as medianas dos payloads pequenos e médios ainda se mantêm (+57 a +71 ms), mas a cauda dispara — o p99 adicionado atinge de +196 a +248 ms — e de 10% a 13% dos streams do gateway falham completamente, o mesmo gargalo de enfileiramento visível no gráfico de stream completo acima. O payload grande a 200 RPS não tem um problema de cauda, tem um colapso: apenas 128,8 dos 200 RPS oferecidos são atendidos, o TTFT p99 dispara para 72,1 segundos, e 3.023 de 12.001 streams falham — o limite de OOM, visto desta vez do lado do primeiro token em vez do lado da resposta completa.
E sob um pico deliberado de sobrecarga, os dois modos do Bifrost mantiveram a segurança de memória: o modo “blocking” atende a todos eventualmente (a requisição mais lenta esperou ~5 segundos), enquanto o modo “drop” falha rapidamente com um erro 503 limpo.
O teto para payloads grandes tem uma causa totalmente diferente da dos pequenos/médios. Não é a CPU — e a maneira mais clara de ver isso é observar a memória e a CPU separadamente, detalhadas por tamanho de payload e carga oferecida, e não apenas como um número de pico único por payload:
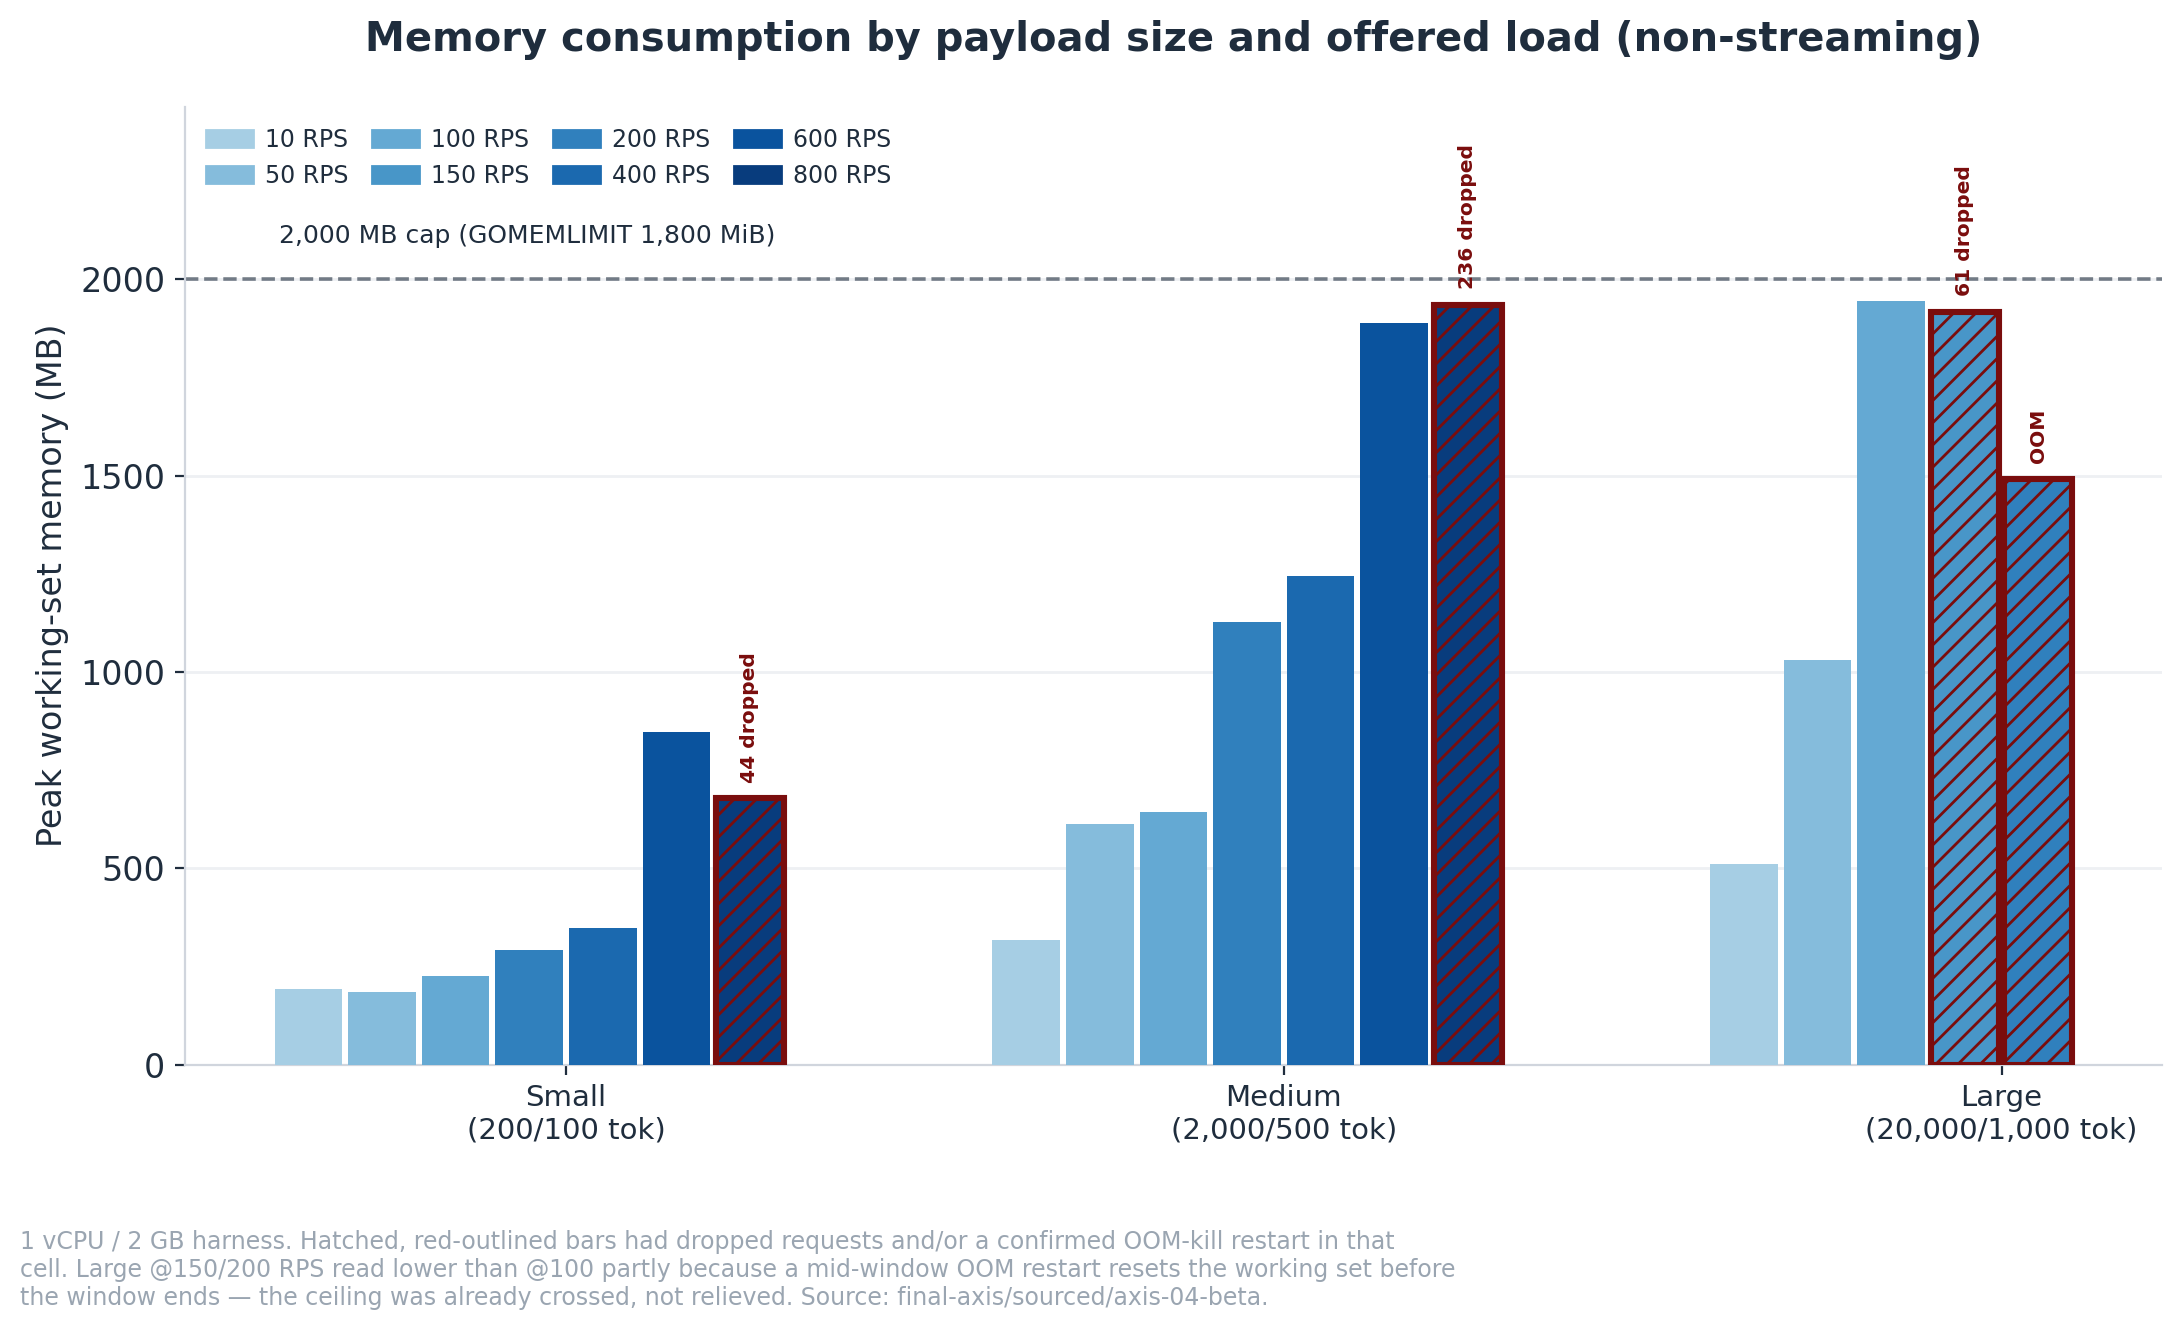
Payloads pequenos e médios sobem gradualmente e nunca chegam perto do limite de 2.000 MB, mesmo em seus maiores RPS testados (848 MB e 1.935 MB, respectivamente). O payload grande é diferente: ele já atinge 1.944 MB — 97% do limite — a 100 RPS, inteiros 50–700 RPS antes do seu “teto” medido. As barras contornadas e hachuradas em vermelho (grande a 150 e 200 RPS) apresentam valores menores do que a barra de 100 RPS, o que parece uma recuperação, mas não é — um OOM-kill no meio da janela reinicia o pod e reseta o contador do conjunto de trabalho antes do fim da janela de medição, de modo que essas barras subestimam o pico real, em vez de superestimá-lo.
A CPU mostra o cenário oposto, o que é exatamente o ponto central:
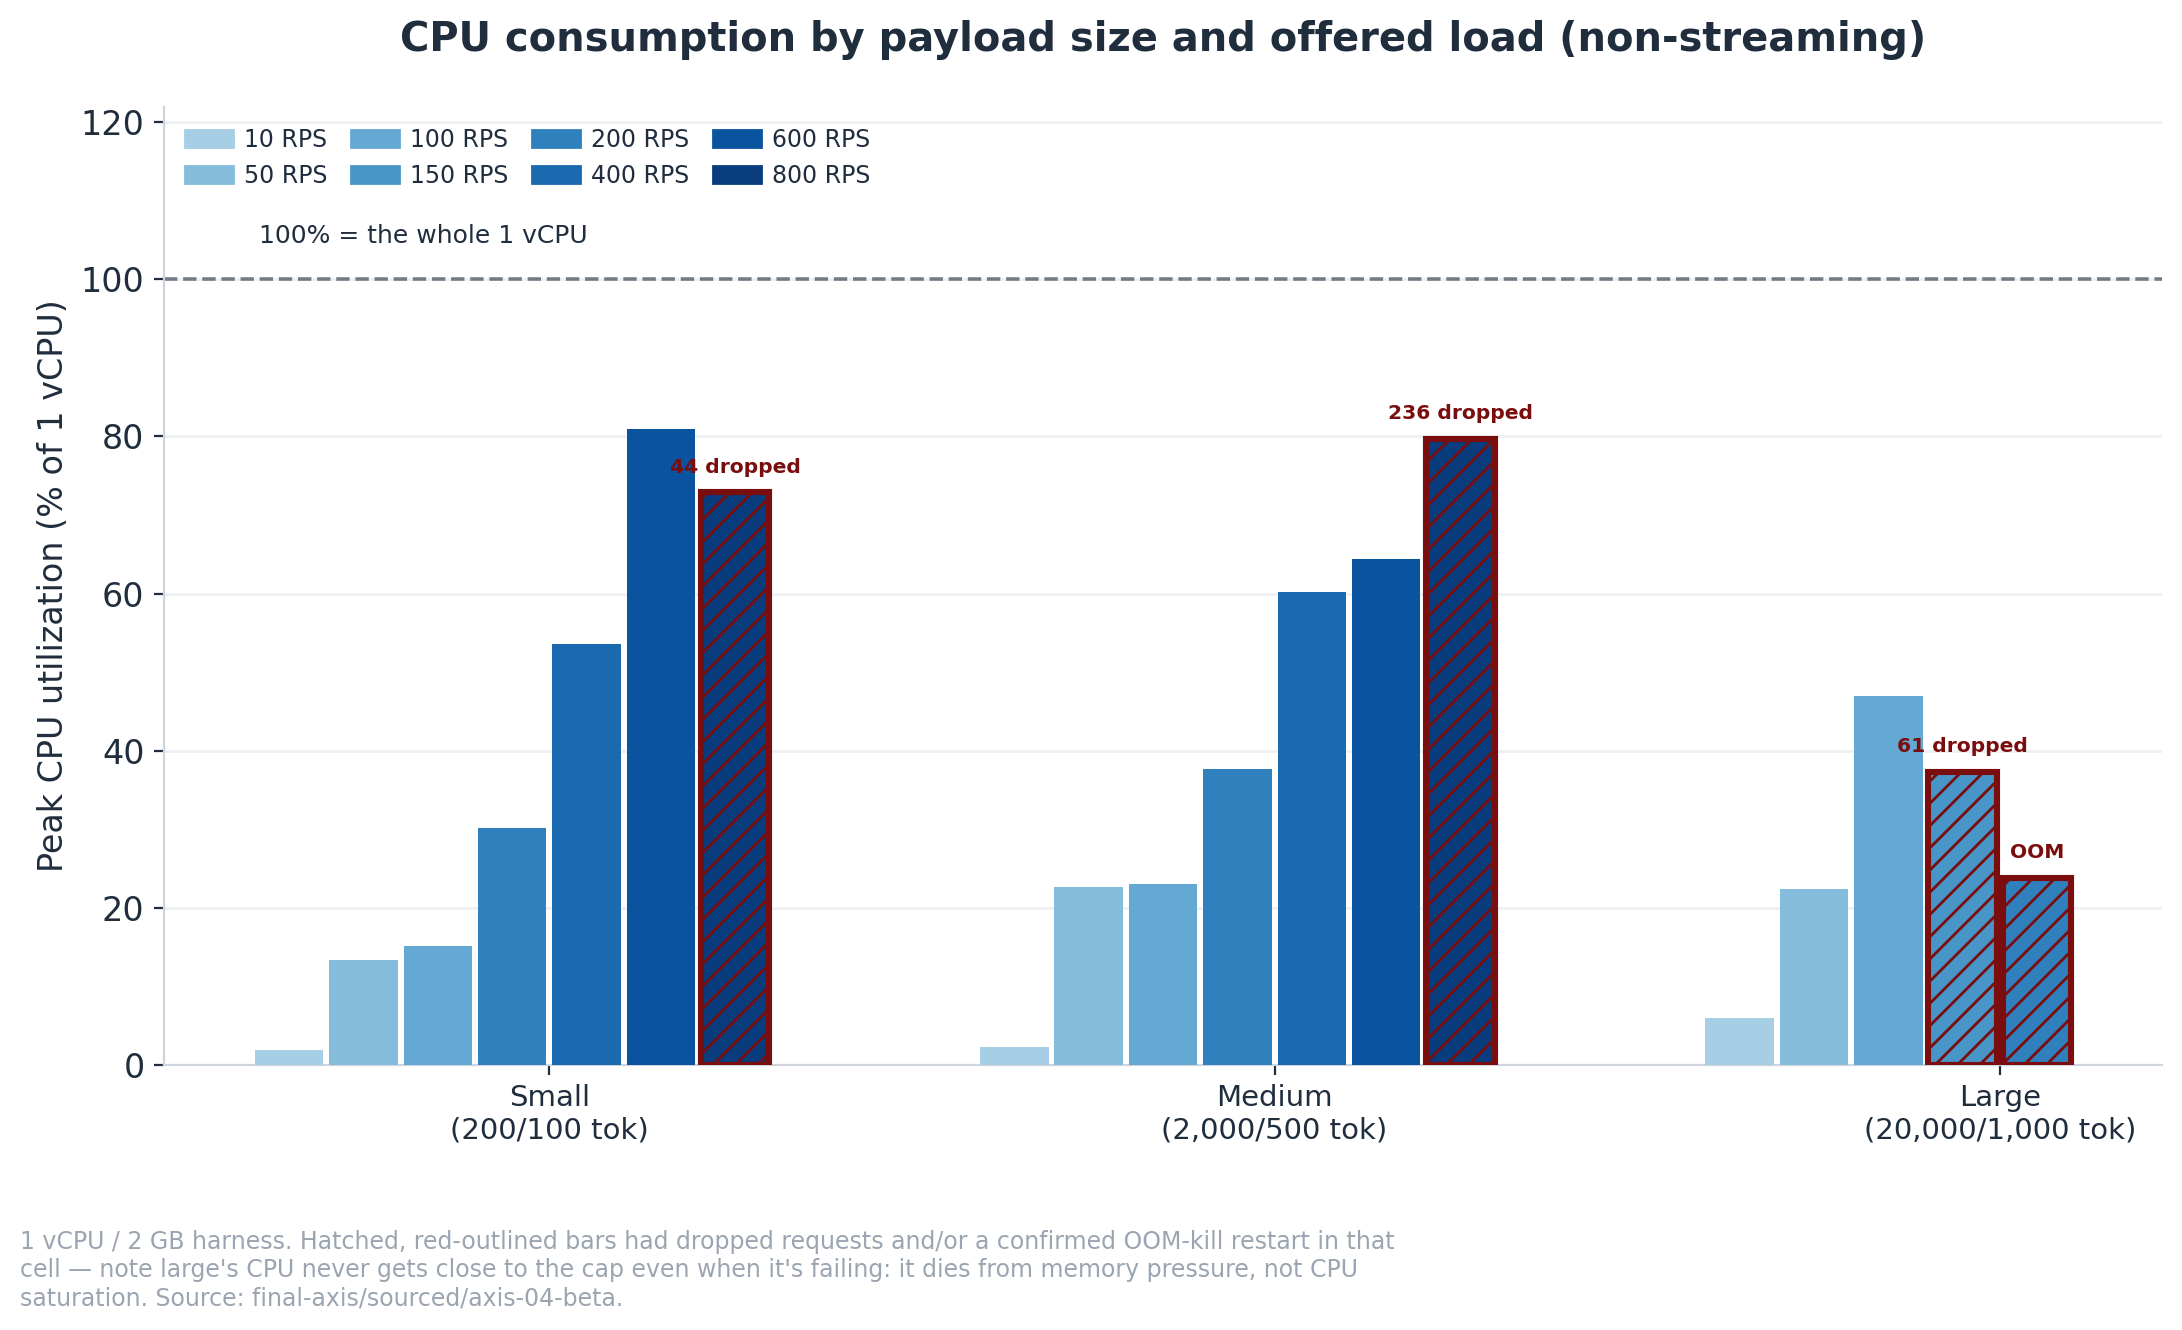
Payloads pequenos e médios sobem para a faixa de 73–80% em seus RPS mais altos — claramente limitados pela CPU, exigindo muito do único vCPU. O payload grande nunca faz isso: mesmo nas células onde está descartando requisições ativamente e sofrendo OOM-kill (contornadas e hachuradas em vermelho), o pico de CPU atinge no máximo 37% e 24%. O payload grande não está falhando porque a CPU esgotou sua capacidade — está falhando porque a memória esgotou, enquanto a CPU ainda tinha capacidade de sobra. Se a sua carga de trabalho envolve documentos longos, esse é o número que deve guiar seu planejamento, e não a contagem de vCPUs.
Um hit de correspondência exata transforma uma chamada de ~59 ms em ~4 ms. O caching semântico — capturar uma pergunta repetida com redação diferente — exige um custo real de embedding, mas ainda é duas vezes mais rápido do que uma chamada nova:
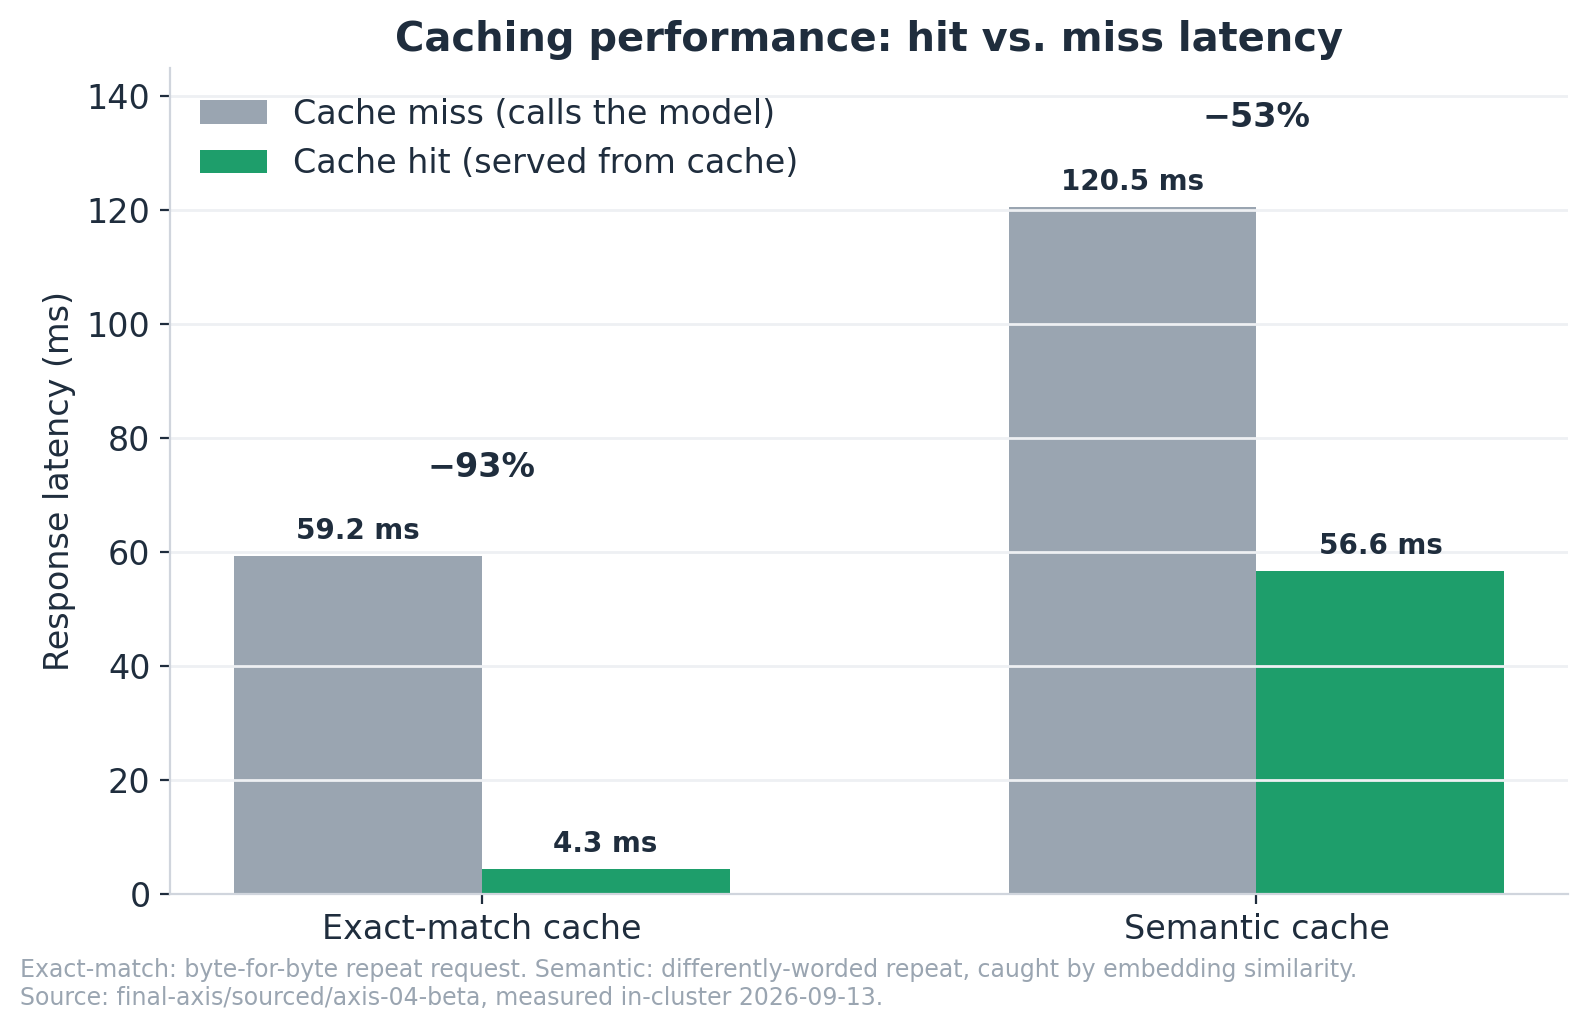
Nenhum dos dois resultados é surpreendente por si só — o caching deve ser mais rápido do que chamar o modelo, e realmente é. Os números aqui são apenas a medição prática de quão mais rápido ele é: 93% para um hit de correspondência exata e 53% para um hit semântico, após pago o custo do embedding.
Mais dois números antes de prosseguir: o cold start tem uma mediana de 8,7 segundos, sendo que 8,2 desses segundos são dedicados ao re-download obrigatório do catálogo a cada reinicialização em uma configuração de contêiner típica — algo corrigível com armazenamento persistente, mas não retestado de forma independente aqui.
Uma nota de transparência sobre os números acima: especificamente na célula de payload pequeno, identificamos e corrigimos um bug em nosso próprio ambiente de teste (uma interação de rede do algoritmo de Nagle que estava gerando ruído na nossa linha de base) — após a correção, o teto do payload pequeno do Bifrost na verdade subiu, de ~400 para ~600–800 RPS. Mencionamos isso porque é o tipo de detalhe fácil de errar ao realizar benchmarks de qualquer gateway, incluindo o Bifrost, e preferimos mostrar nosso processo a esconder a correção.
Em uma única máquina, o overhead do Bifrost é realmente baixo na mediana: 2–6 ms além de uma chamada de upstream de ~55 ms, estável entre diferentes tamanhos de payload e quase estável sob variação de carga. Essa é a versão defensável da alegação de “gateway mais rápido”, e ela tem seu valor — como proporção de uma chamada real de LLM, o valor é insignificante. O comportamento da cauda é diferente. O p99 adicionado é sensível à carga, atingindo de +41 a +75 ms nos limites que medimos, e os payloads grandes não desaceleram gradualmente, eles simplesmente param: sofrem OOM-kill a 150 RPS, descartando requisições. O caching funciona como anunciado (reduções de latência de 93% e 53%, medidos). O valor de 5.000 RPS informado pelo fornecedor descreve uma máquina maior e uma carga de trabalho diferente daquela executada pela maioria das equipes. Portanto, para um único nó: a velocidade mediana não é o problema — a latência de cauda sob carga e a margem de memória em tráfego denso de documentos é que são.
A questão mais complexa é o que acontece ao executar mais de um nó. Um gateway em produção precisa realizar auto-scaling (para cima e para baixo) e tolerar a queda de um pod sem que ninguém perceba. Na versão open source, é aí que surgem as dificuldades. As alterações de configuração não se propagam em tempo real entre as réplicas; o padrão documentado exige um arquivo de configuração compartilhado seguido de reinicialização. Assim, cada alteração de roteamento, rotação de chave ou atualização de orçamento se transforma em um rollout coordenado entre os pods do gateway, em vez de uma simples alteração de configuração. Somando a isso um painel de administração acessível a qualquer pessoa que consiga alcançá-lo até que a primeira conta de administrador seja criada, a versão open source é mais adequada para um nó único monitorado de perto, e não para um cluster.
O Bifrost Enterprise resolve boa parte dessa limitação: sua malha gRPC transmite alterações de configuração para todas as réplicas em segundos, sem necessidade de reinicialização. No entanto, mesmo a versão Enterprise continua sendo uma infraestrutura que você precisa implantar, dimensionar, atualizar e monitorar por conta própria. Adquirir a licença não transfere a carga operacional para terceiros.
Portanto, a decisão real não é se “o Bifrost é rápido?”, mas sim “quem vai gerenciá-lo?”. Uma equipe com dedicação exclusiva de platform/DevOps, ou com requisitos rígidos para manter tudo em ambiente próprio, pode operar o Bifrost com eficiência — idealmente na versão Enterprise, caso precise de mais de uma réplica. Já uma equipe enxuta, que precisa apenas de um gateway confiável à frente de suas chamadas de LLM, geralmente obterá mais valor de uma solução gerenciada do que de assumir a operação da infraestrutura do gateway.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


