



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
Se você está executando o Slack por meio de um agente no Opus, aqui está o número desconfortável. O Sonnet 4.6 com esforço alto, utilizando um arquivo de skill de 55 linhas, passou em 56 de 63 tarefas. Isso é 88,9%. O Opus 4.8 com esforço alto e sem skill também passou em 56 de 63. A execução do Sonnet custou $4,28. A do Opus custou $6,81. A tarefa mediana foi 12% mais rápida no Sonnet também.
Portanto, o movimento óbvio é dar ao Opus o mesmo arquivo e observá-lo disparar na frente. Nós fizemos isso. O Opus com a skill passou em 55 de 63. O Fable 5, que começou acima de 90%, terminou em 85,7%. Em um dos prompts, o Opus foi de 3 de 3 sem a skill para 0 de 3 com ela, e a falha não é sutil: ele listou os membros do canal, recebeu de volta os user ids e parou, porque o arquivo dizia “faça uma chamada e depois pare”. O Sonnet leu a mesma linha e continuou para buscar os nomes de qualquer maneira.
Esse é o formato de todo o resultado. Uma skill vale exatamente a lacuna que ela preenche. Em um modelo menor, a lacuna é ampla e um índice curto fecha a maior parte dela, por menos dinheiro do que o modelo maior custa sem nada. Em um modelo próximo do limite de capacidade, a lacuna é estreita, e uma regra escrita para o caso confuso é seguida de forma mais fiel justamente pelo modelo que menos precisava dela.
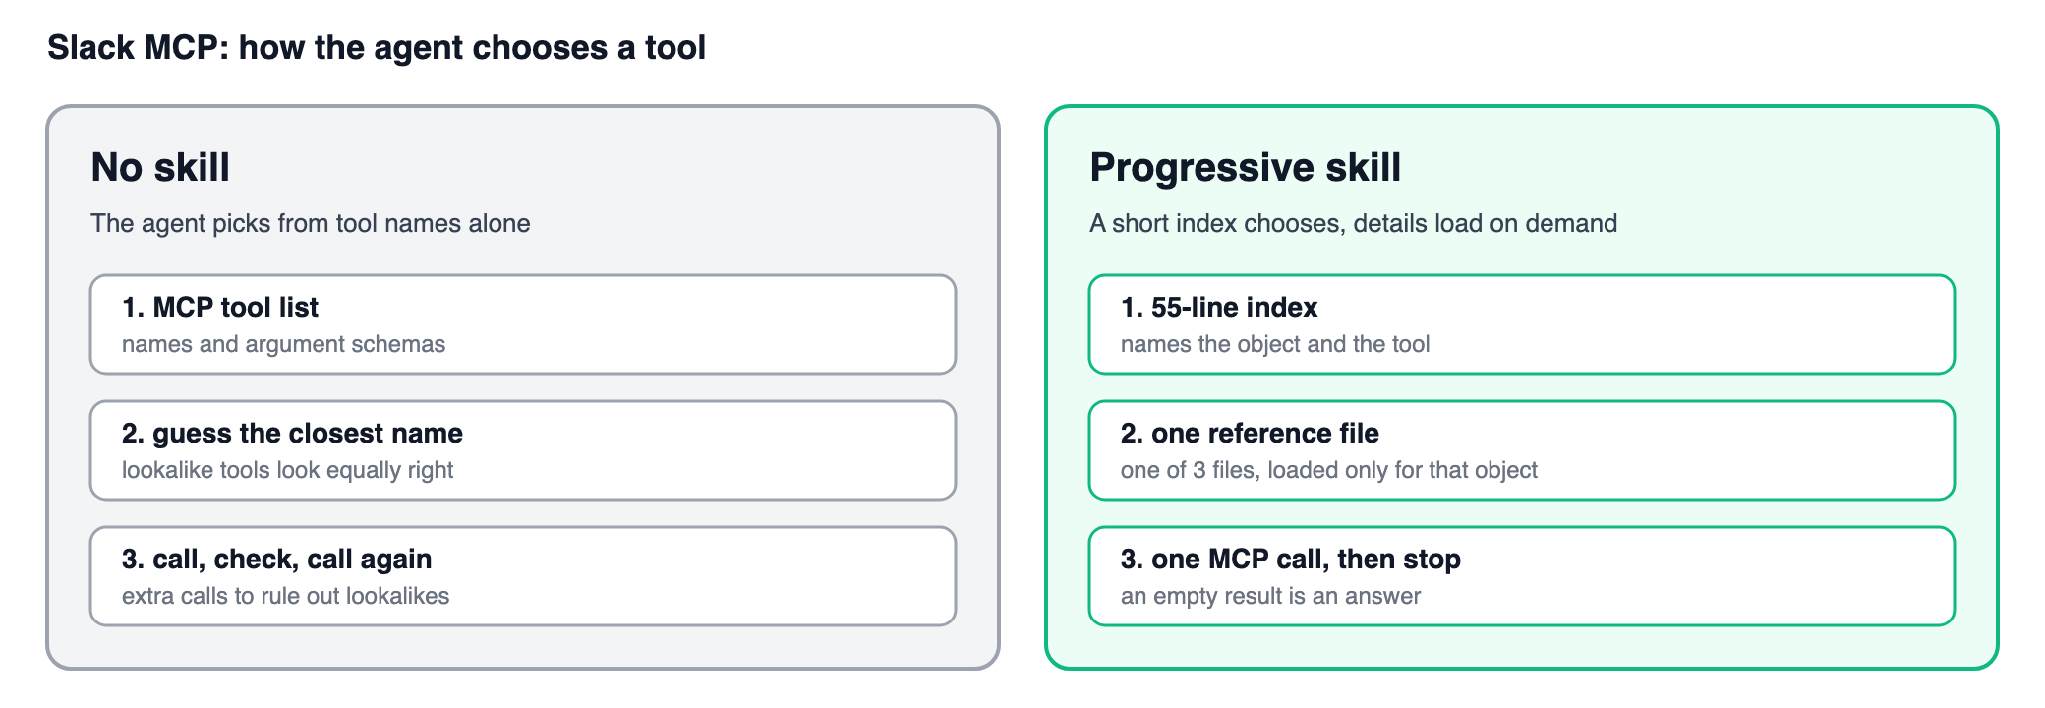
Assim que uma equipe vê uma skill aumentar a precisão em um servidor MCP, duas crenças tendem a surgir. A primeira é que a orientação não tem pontos negativos, então escreva regras amplas e deixe todos os modelos lerem. A segunda é que o modelo mais forte se beneficia mais, porque segue melhor as instruções. O Slack quebra ambas.
A primeira crença falha porque uma skill só ajuda onde o modelo estava deixando de fazer uma distinção. A maioria das ferramentas do Slack é fácil de diferenciar. Enviar, rascunhar e agendar são distintos nos nomes das ferramentas, e um modelo forte acertou isso quase todas as vezes sem nenhuma ajuda. Onde a lista de ferramentas já faz o trabalho pesado, uma skill não pode adicionar precisão. Ela só pode adicionar uma regra de que o modelo não precisava, e uma regra pode ser seguida bem até demais.
A segunda crença falha pelo mesmo motivo visto do outro ângulo. O modelo que segue melhor as instruções é o modelo com maior probabilidade de obedecer a “faça uma chamada e depois pare” no momento exato em que estava prestes a fazer algo útil. O Opus já tinha buscado os nomes dos membros por conta própria. O Fable já tinha passado pelo filtro de DM por conta própria. A skill não ensinou nada a nenhum dos dois. Ela entregou a eles uma linha geral curta, e eles a seguiram mais literalmente do que teriam feito por conta própria.
A questão financeira está inserida nisso. A pergunta não é se uma skill vale os tokens que consome. O agente com skill usou ligeiramente menos tokens de entrada e fez cerca de um terço a menos de chamadas, de modo que o arquivo se pagou apenas pelo custo. A pergunta é de qual modelo você precisa em primeiro lugar. Se um índice de 55 linhas permite que o Sonnet iguale o Opus, a skill não apenas economizou tokens na execução. Ela mudou qual modelo a carga de trabalho exige.
O exemplo. “Quem é membro do mcp-gateway?” A lista de membros retorna user ids. Uma resposta útil busca esses ids e fornece os nomes. Opus 4.8 com esforço alto, sem skill: passou em 3 de 3, listando membros e depois lendo perfis para responder com os nomes. Mesmo modelo, mesmo prompt, com a skill: passou em 0 de 3. Uma tentativa buscou o canal, listou membros duas vezes e parou. A resposta foram user ids sem nomes. Sonnet 4.6 com a mesma skill passou em 3 de 3 e concluiu a busca de nomes.
Os números. 21 tarefas do Slack, seis configurações do Claude, três execuções cada. Em todos os modelos, a precisão subiu de 83,3% para 86,5%. Em esforço alto, o Sonnet com a skill foi de 66,7% para 88,9%, a mesma pontuação do Opus sem skill, por $4,28 contra $6,81. O Opus com a skill ficou em 87,3%. Em esforço médio, o Sonnet subiu de 74,6% para 84,1% e o Opus permaneceu em 87,3%. O Fable foi de acima de 90% para 85,7% em ambas as configurações, uma queda de 3 ou 4 execuções em 63, portanto o tamanho da queda é incerto, mas as falhas específicas são reais. As chamadas de ferramentas por tarefa caíram de 2,52 para 1,71. O custo total do benchmark caiu de $46,10 para $44,01.
O aprendizado. Adeque a skill ao modelo e depois faça a poda. Uma skill ajuda onde o modelo estava perdendo uma distinção: uma funcionalidade que falta ao servidor, um escopo de busca, uma escrita que o usuário já especificou. Onde os nomes das ferramentas já deixam a escolha clara, um modelo forte chega lá sozinho, e uma regra ampla pode interromper um trabalho que ele teria terminado. Escreva cada regra de forma restrita contra uma confusão específica e teste qualquer nova regra no seu modelo mais forte antes de confiar nela.
Mesmo design do teste do Linear. Uma variável alterada.
As tarefas. 21 prompts do Slack criados em torno de escopo de busca, threads, rascunhos e agendamentos, canvases, listas, uploads, funcionalidades ausentes e consentimento. “O que nós decidimos?” pode ser uma busca por todo o workspace, as últimas mensagens em um canal ou as respostas dentro de uma única mensagem. “Envie isto” pode significar agora, um rascunho que alguém ainda precisa aprovar, ou uma mensagem que deve sair amanhã. “Redija isto” pode ser um canvas, uma lista ou um arquivo. Escolhemos as tarefas porque elas são confusas, tornando-as mais difíceis do que o tráfego diário comum do Slack.
Os dados. As respostas do Slack vieram de uma gravação estática congelada. Ambos os lados viram dados idênticos, e as operações de escrita nunca atingiram um workspace real.
Os modelos. Sonnet 4.6, Opus 4.8 e Fable 5, cada um com esforço médio e alto. Seis configurações, três execuções por tarefa, em um workspace limpo a cada vez. 378 execuções com a skill e 378 sem.
Os dois cenários.
A skill. Um índice SKILL.md de 55 linhas que o agente sempre lê. Ele lista os objetos, uma maneira curta de escolher entre eles, uma tabela de itens parecidos e o que o servidor não pode fazer. Três arquivos de referência — um para busca, um para escrita e outro para artefatos — contêm os detalhes dos argumentos. Em uma tarefa típica, o agente decide onde o conteúdo reside (um tópico sem local único é busca, mensagens recentes em uma conversa são histórico do canal, respostas em uma mensagem são uma thread), resolve nomes de canais para ids, abre o arquivo de referência daquela família se necessário e faz uma chamada, depois para.
A pontuação. Uma tarefa passava apenas se o agente escolhesse as ferramentas certas na ordem correta, respeitasse as regras de segurança e fornecesse uma resposta final correta. Um juiz separado Opus 4.8 avaliou a resposta sem saber se uma skill estava presente. Três execuções por tarefa é uma amostra pequena, duas das verificações de aprovação são julgadas por modelo, e a reprodução (replay) remove a latência real da API.
As tarefas, skills, regras de pontuação e etapas de reprodução estão no repositório público mcp-skillbench.
A precisão geral mudou pouco, de 83,3% para 86,5%. A variação interessante ocorre por modelo.
Por modelo, por nível de esforço.
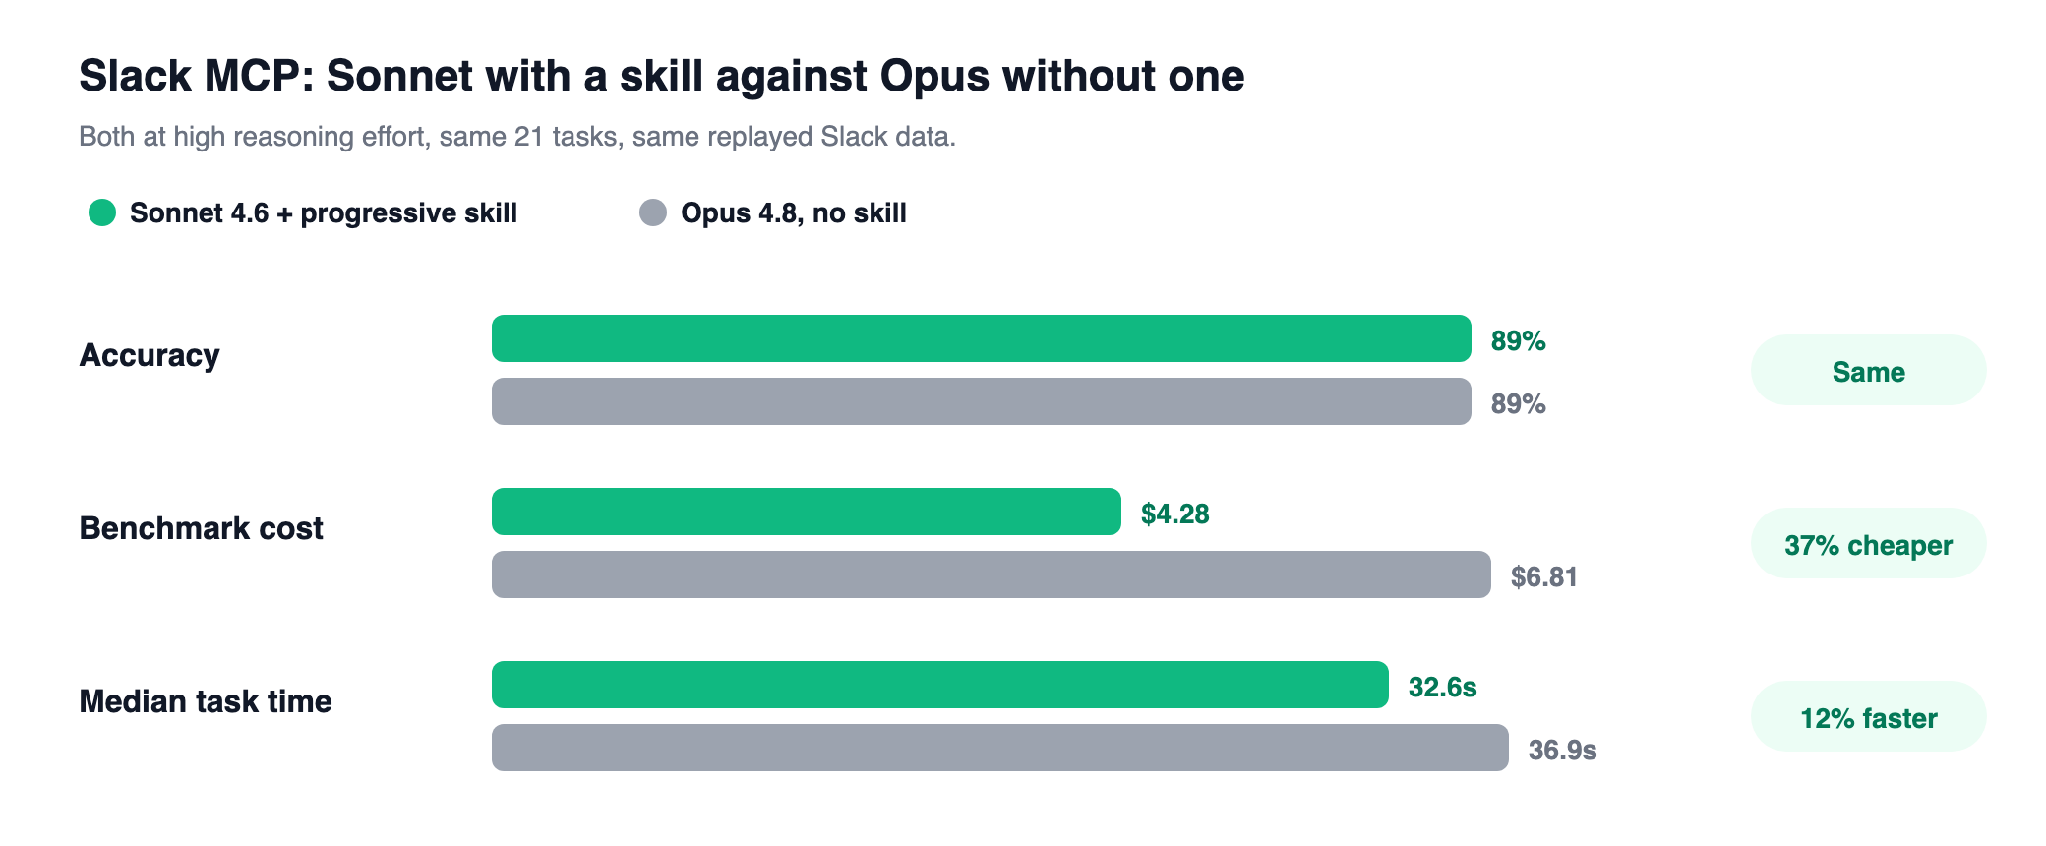
A média é o número errado a se lembrar. O Sonnet em esforço alto foi de 42 de 63 para 56 de 63, a pontuação que o Opus registrou sem skill, custando $4,28 contra $6,81 e com uma tarefa mediana de 32,6 segundos contra 36,9. O Opus ainda venceu na cauda mais lenta. A queda do Fable é de 3 ou 4 execuções em 63 por configuração, o que, perto do limite máximo, pode ser em parte ruído. As falhas específicas abaixo são sólidas. O tamanho exato da queda é menos certo.
Sem uma skill, o agente já era confiável nos pares óbvios. Enviar versus rascunho versus agendar, adicionar uma reação e listar seus próprios canais estavam corretos quase todas as vezes em ambos os cenários. Algumas tarefas foram diferentes, e é aí que o modelo menor ganhou terreno.
As linhas do índice por trás disso são curtas:
Um prompt, quatro execuções. “Quem é membro do mcp-gateway?” A lista de membros retorna user ids. Uma resposta útil busca esses ids e fornece os nomes. Esforço alto do início ao fim. A única mudança em cada linha é a skill.
O modelo menor ainda concluiu a busca de nomes. O modelo maior seguiu “faça uma chamada e depois pare” e interrompeu a tarefa.
Outros dois prompts mostram a mesma sobreposição, ambos no Fable em esforço alto, ambos caindo de 3 de 3 para 1 de 3. “Com a minha permissão, busque em canais privados e DMs por __mcp_skill_eval_no_match__.” A busca incluindo itens privados era a ferramenta certa em ambos os casos. Sem uma skill, o agente passou um filtro nomeando canais privados, DMs de grupo e DMs. O índice diz que essa busca “inclui canais privados e DMs”, e algumas execuções com skill levaram a frase ao pé da letra, deixaram o filtro de fora e depois disseram que as DMs tinham sido buscadas. E “Leia toda a discussão abaixo de [um link para uma mensagem]”. A primeira página contém apenas algumas das respostas, e os agentes frequentemente apresentavam essa página como a discussão completa. Isso era difícil de qualquer forma, e a skill piorou o cenário.
Em cada caso, o agente tinha a ferramenta certa ou estava a uma busca de distância de uma resposta completa. Ele então seguiu uma linha geral curta no índice de forma mais literal do que teria feito por conta própria.
O índice é pequeno e os arquivos de referência são carregados apenas quando necessário, então o agente com skill usou ligeiramente menos tokens de entrada do que o agente sem skill. As chamadas de ferramentas caíram cerca de um terço, de 2,52 por tarefa para 1,71, contra um caminho correto mais curto de 1,24. A maior parte dessa economia foi no Sonnet, cujas execuções sem skill tendiam a buscar, ler e buscar novamente. A mediana ficou um pouco mais rápida, de 37,6 segundos para 35,1, e os 5% mais lentos caíram de cerca de 75 segundos para cerca de 65. O custo do benchmark completo foi de $44,01 com a skill e $46,10 sem ela.
Dispense uma skill para leituras de rotina em um modelo forte. Se o agente executa no Opus ou Fable e busca principalmente em canais públicos e lê o histórico, a lista de ferramentas já faz o trabalho. Uma skill economizará algumas chamadas. Ela pode não aumentar a precisão e, em um modelo perto do teto de capacidade, pode custar alguns testes.
Adicione uma se um modelo menor estiver no caminho, ou se as tarefas envolverem escopo de busca, uma funcionalidade ausente ou uma escrita que o usuário já tenha especificado. O Sonnet em esforço alto, subindo de 66,7% para 88,9%, é o motivo pelo qual escrevemos uma. Nesse ponto, a skill não é um detalhe de engenharia de prompt. É a diferença entre precisar do Opus ou não.
Em seguida, faça a poda. Mantenha o índice focado na escolha, carregue os detalhes sob demanda e leia as tarefas que pioraram. Se uma regra interromper um trabalho que o modelo já estava fazendo, como buscar nomes após listar membros, restrinja a regra ou exclua-a. Uma skill mais curta é mais fácil de seguir. Isso inclui as vezes em que ela não deveria ter sido seguida.
Teste cada nova regra no seu modelo mais forte antes de confiar nela. O modelo menor é onde você vê o ganho. O modelo mais forte é onde você vê a sobreposição indevida.
Uma skill altera qual ferramenta do Slack é chamada. Ela não decide quem pode buscar em canais privados, qual token a chamada usa ou o que é registrado nos logs.
O TrueFoundry Skills Registry mantém uma skill como esta versionada e compartilhada. Uma skill reside em um repositório ao lado de prompts e modelos. O repositório decide quem pode descobri-la, editá-la e anexá-la, mantendo o histórico de versões e o log de auditoria. Cada publicação é uma versão numerada, portanto, quando você restrinja uma regra que causou uma regressão, todos os agentes recebem a mesma correção, e um agente pode ter sua versão fixada de volta caso uma nova publicação apresente comportamento inadequado. A mesma versão pode ser anexada a um agente da TrueFoundry ou puxada para o Claude Code e Cursor. Esta skill do Slack é um índice mais três arquivos de referência, sendo publicada como um pacote através da CLI ou via GitOps com o tfy apply.
O TrueFoundry MCP Gateway fica à frente do servidor Slack MCP. Ele gerencia autenticação, controle de acesso no nível da ferramenta e o rastreamento (trace) de cada chamada. O overhead é de cerca de 3 a 4 ms, processando mais de 350 requisições por segundo em uma única vCPU. Este benchmark usou uma reprodução local, portanto não diz respeito ao gateway. A skill escolhe a chamada. O gateway decide se essa chamada é permitida.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


