



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Deel 1 stelde de diagnose: tokenmaxxing is geen probleem van AI-gebruik; het is een control-plane probleem. Als ruwe tokens een doel op zich worden, zullen mensen optimaliseren voor ruwe tokens. Als gecontroleerde AI-hefboomwerking het operationele model wordt, kan het platform adoptie aanmoedigen en tegelijkertijd kosten, risico's en operationele ruis begrenzen. Dit deel maakt die architectuur concreet.
De stelling is eenvoudig. Elk AI-verzoek dat een enterprise-toepassing verlaat, is, of u het nu zo behandelt of niet, een runtime-gebeurtenis met consequenties voor kosten, veiligheid en audit. De plek met de hoogste hefboomwerking om controles aan die gebeurtenissen te koppelen, is de gateway — de laag die zich bevindt tussen elke toepassing en elke model- en tool-backend. Een dashboard dat stroomafwaarts is gebouwd, kan beschrijven wat er is gebeurd. Alleen de gateway kan beslissen wat er nu gebeurt.
Een dashboard meldt een probleem. Een gateway voorkomt het volgende. De onderstaande architectuur is wat dat onderscheid operationeel maakt.
Een gecontroleerd AI-verzoek heeft vier omhulsels nodig voordat het de toepassing verlaat. Zie dit als het OSI-model voor enterprise AI — elke laag heeft een specifieke verantwoordelijkheid en een specifieke failure mode wanneer deze ontbreekt.
Deze omhulsels moeten zich op het verzoekpad bevinden, niet in een rapport dat iemand op vrijdag leest. Een achteraf gebouwd dashboard kan een probleem beschrijven; alleen een omhulsel op het live verzoek kan de volgende call vormgeven. Dit is het architectonische principe dat een gecontroleerd AI-platform scheidt van een analytics-add-on.
De eerste implementatiestandaard is een strikt metadata-contract. Gebruik keys met string-waarden, stuur ze mee bij elk verzoek en maak ze verplicht in uw SDK-wrappers, interne client-libraries, bot-frameworks en agent-templates. De kosten van één ontbrekend veld duiken later op als een ontbrekende factuurregel, een niet-toewijsbare piek of een guardrail-gebeurtenis die niemand aan een eigenaar kan koppelen.
Tagging is het goedkoopste engineeringwerk in deze hele architectuur en het eerste dat breekt als teams het overslaan.
In de TrueFoundry-gateway reist dit mee als de X-TFY-METADATA header. Dezelfde key namespace voedt vervolgens alles stroomafwaarts: budgetten gelden per project, rate limits gelden per workflow, dashboards groeperen per team, traces koppelen aan tickets en finance verdeelt de uitgaven per kostenplaats. Er is geen tweede source of truth.

Het architectonische doel is niet om knoppen toe te voegen. Het is om een strakke mapping te behouden tussen elke realistische failure mode en de specifieke controle die deze voorkomt. Hier is de volledige taxonomie:
Als applicatiecode een specifiek providermodel noemt, bent u het vermogen kwijtgeraakt om te migreren, te testen, A/B-tests uit te voeren of te failoveren zonder codewijzigingen. Het juiste patroon is het blootstellen van logische functionaliteiten — namen zoals prod/engineering-assistant of prod/frontier-reasoning — en de gateway deze te laten oplossen naar fysieke targets op basis van metadata, prioriteit, gewicht of gemeten latentie.
In TrueFoundry is dit waar Virtual Models en de routing-configuratie voor dienen. Dezelfde regels gelden voor canary-rollouts, regionale voorkeur, on-prem-met-cloud-fallback en provider-specifieke prompt-overrides. Dit is de meest onderschatte functionaliteit in de governance-stack — het maakt compliance, kostenoptimalisatie en modelmigratie onzichtbaar voor applicatieontwikkelaars.
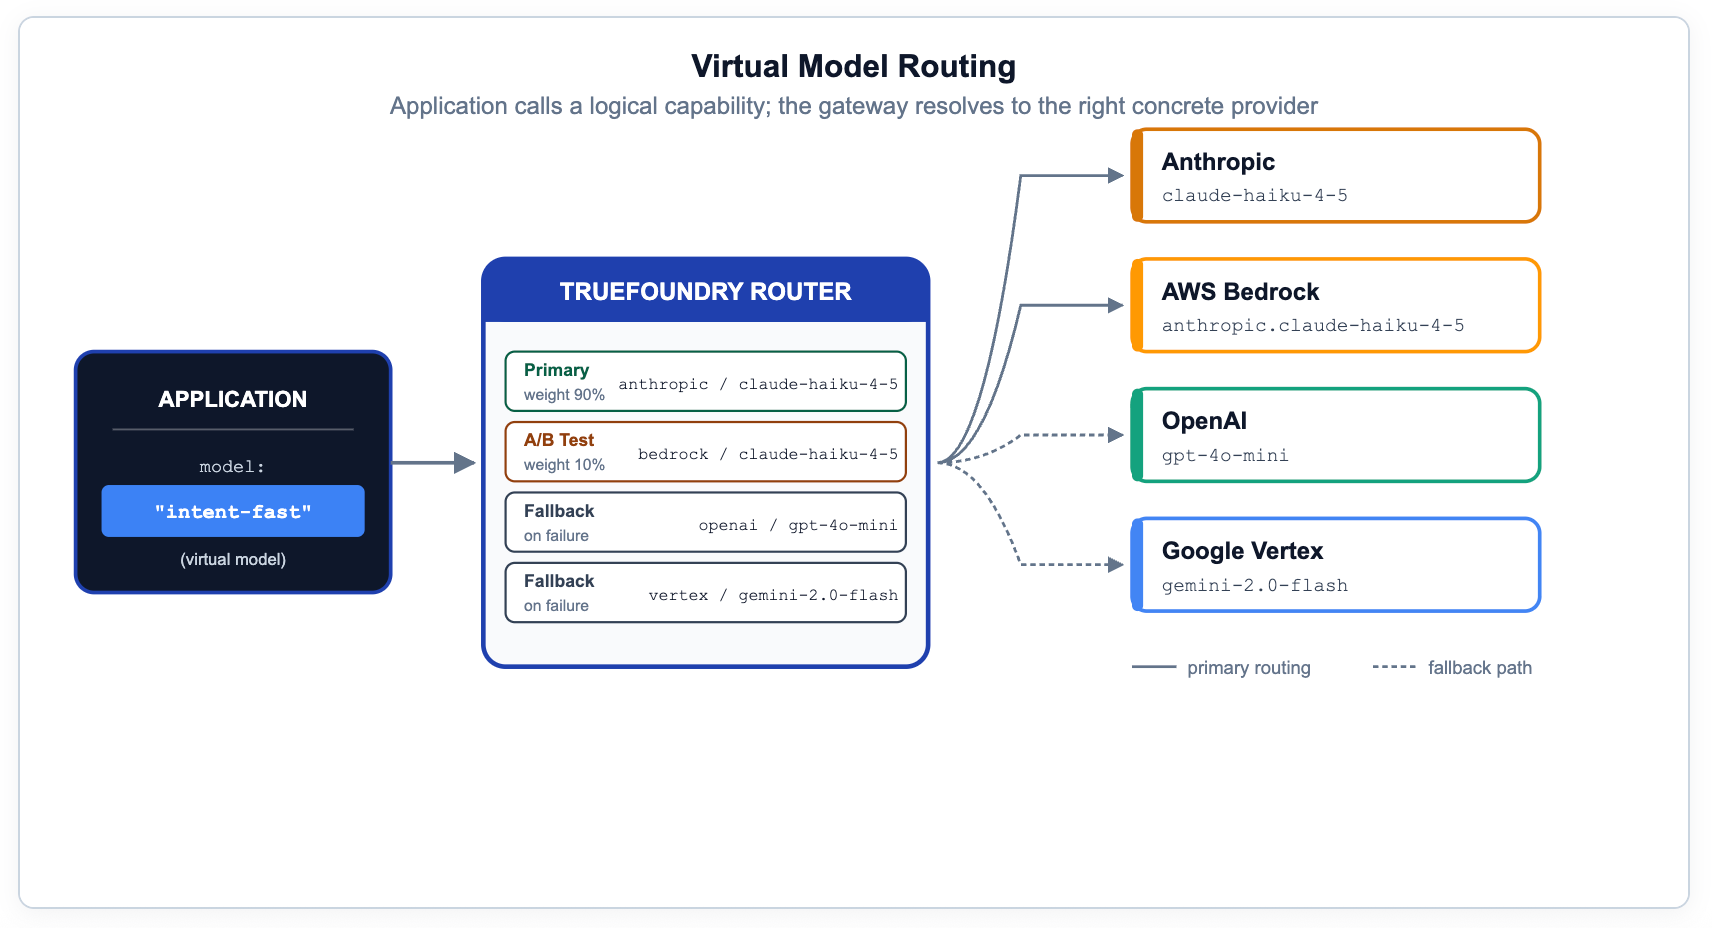
Routing-documentatie: truefoundry.com/docs/ai-gateway/load-balancing-overview
Zodra AI-toepassingen in productie gaan, verwerken ze echte gebruikersgegevens en nemen ze, in agentic setups, echte acties via tools. De veiligheidsperimeter is niet één enkel ding. Het zijn vier hooks, geplaatst op de vier momenten waarop de gateway kan ingrijpen voordat een verzoek schade veroorzaakt.
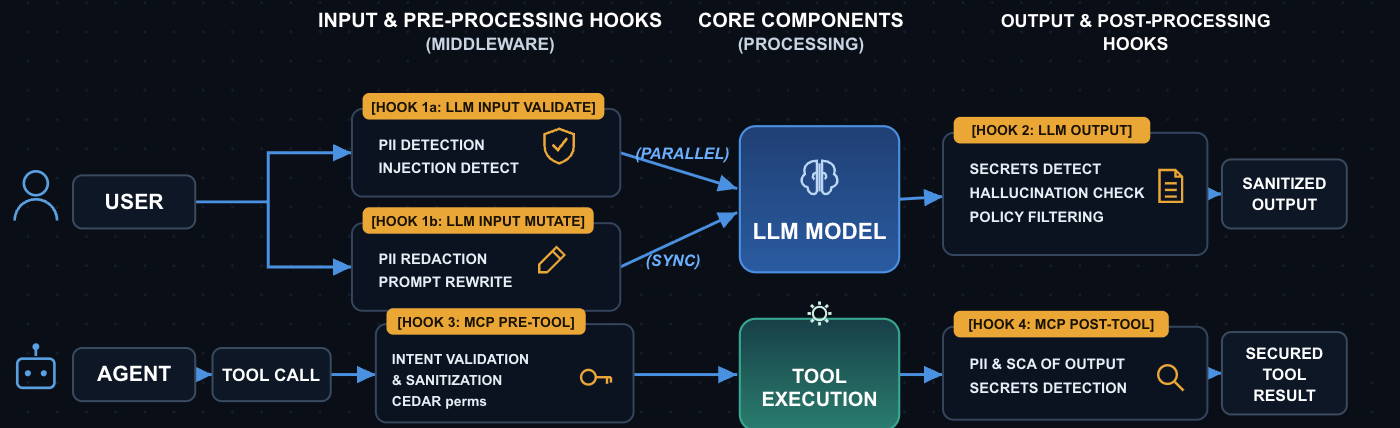
Rol guardrails uit in drie stappen: Audit → Enforce-but-ignore-on-error → Strict. De middelste instelling is degene die u zal redden op de dag dat een externe veiligheidsprovider uitval heeft.
Guardrails overzicht: truefoundry.com/docs/ai-gateway/guardrails-overview
PII/PHI-detectie: truefoundry.com/docs/ai-gateway/tfy-pii
Secrets-detectie: truefoundry.com/docs/ai-gateway/secrets-detection
Twee vragen overheersen de operatie zodra gecontroleerd AI-gebruik in productie is: 'waarom gedroeg dit verzoek zich op deze manier?' en 'komen de kosten die we betalen overeen met het werk dat we terugkrijgen?' Geen van beide is te beantwoorden via een grafiek met token-aantallen.
Het minimale oppervlak dat nodig is om ze te beantwoorden — en het oppervlak dat de gateway van TrueFoundry standaard biedt:
Analytics-documentatie: truefoundry.com/docs/ai-gateway/analytics
OpenTelemetry-export: truefoundry.com/docs/ai-gateway/export-opentelemetry-data
De vier bovenstaande omhulsels zijn ontworpen vanuit de gedachte van chat-achtige verzoeken: een toepassing stuurt een prompt, het model retourneert tekst. Moderne AI-workloads zijn die aanname voorbij. Agents roepen tools aan. Tools roepen andere tools aan. Één enkel gebruikersverzoek kan een agent-traject van 50 stappen voortbrengen dat een half dozijn MCP-servers raakt. Het kostenoppervlak, het veiligheidsoppervlak en het audit-oppervlak zijn allemaal verschoven van de prompt naar de tool-call.
Dit is waarom de TrueFoundry-gateway van nature zowel de LLM API als het Model Context Protocol (MCP) spreekt. Hetzelfde identiteitsomhulsel, dezelfde circuit breakers, dezelfde waarneembaarheidshooks zijn van toepassing op een tool-call als op een chat completion. OAuth 2.0-identiteit wordt geïnjecteerd in MCP tool-calls, zodat een agent handelt als een specifieke gebruiker, niet als een service-account, wanneer deze een database raadpleegt of een Jira-ticket aanmaakt. Met Virtual MCP-servers kunt u een logische 'finance-agent-server' samenstellen uit tools die verspreid zijn over drie echte MCP-servers, waarbij toegangscontrole en rate limits op de compositie worden toegepast.
Het Model Context Protocol is van belang voor de kosten, niet alleen voor de architectuur. TrueFoundry meldt tot 99% besparing op inferentie-tokens wanneer agents actieve tool-retrieval gebruiken in plaats van de context vol te proppen in prompts — en de overhead van tool-calls wordt gemeten op ongeveer 10 ms.
Het is verleidelijk om deze controles naar de applicatiecode te duwen: een wrapper hier, een Python-decorator daar, een helper-klasse in het agent-framework. Dat werkt totdat u drie applicatieteams hebt, twee modelproviders, één overname, een PCI-audit en een rate-limit-incident op een dinsdag.
Op dat moment ontdekt u dat u vier licht afwijkende control planes hebt gebouwd die het niet met elkaar eens zijn, en dat geen ervan een verzoek kan stoppen van een team dat de wrapper niet heeft geïmporteerd. De gateway bestaat om dezelfde reden als waarom API gateways een decennium geleden ontstonden: het is de enige plek waar elk verzoek, van elke toepassing, in elke omgeving, uniform kan worden geobserveerd en gevormd.
Het bezwaar tegen een gateway is altijd 'nog een extra hop in het verzoekpad.' De TrueFoundry AI Gateway voegt ongeveer 5 ms p50-overhead toe en verwerkt 350+ verzoeken per seconde op een enkele vCPU. Het bezwaar houdt geen stand bij het zien van de cijfers.
De gateway is ook de enige plek die het volledige oppervlak van de moderne AI-infrastructuur kan spreken: 1000+ LLM's over 19+ providers, plus de MCP-servers die uw agents aanroepen, plus de self-hosted modellen achter uw VPC. TrueFoundry werd genoemd in het Gartner-rapport '10 Best Practices for Optimizing Generative & Agentic AI Costs 2026' — omdat de enige manier waarop ondernemingen daadwerkelijk optimaliseren op dit oppervlak is door elk verzoek via één gecontroleerde laag te laten lopen.
Tokenmaxxing is een symptoom van onbeheerde AI-adoptie. De bovenstaande architectuur is de oplossing. Identiteit definieert wie het vraagt. Beleid definieert wat is toegestaan. Veiligheid definieert wat acceptabel is. Waarneembaarheid definieert wat er daadwerkelijk is gebeurd. Samen zetten ze ruwe token-activiteit om in een gecontroleerde levenscyclus van verzoeken — verantwoordelijk, nuttig, veilig en afstembaar.
Het doel is niet om het AI-gebruik kleiner te maken. Het doel is om elke regel ervan verklaarbaar te maken.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















