Blank white background with no objects or features visible.

EMEA, hallo! TrueFoundry breidt zijn aanwezigheid uit in Europa, het Midden-Oosten en Afrika. Lees meer. →

Wat is Ollama? Lokale LLM's in productie draaien voor teams

DoorAshish Dubey

Bijgewerkt: November 10, 2026

Gepubliceerd: November 9, 202615

⚡ TL;DR

Ollama is een open-source tool om grote taalmodellen (LLM's) lokaal uit te voeren met een eenvoudige, OpenAI-compatibele API. Het is uitstekend geschikt voor private, offline en goedkope inference op je eigen hardware. Wat het niet biedt, is de teamlaag: gedeeld toegangsbeheer, kostentoewijzing, guardrails en routing. Deze gids legt uit wat Ollama is, hoe het zich verhoudt tot vLLM en hoe je Ollama voor een heel team draait door het achter de AI Gateway van TrueFoundry te plaatsen.

Ollama maakte lokale modellen eenvoudig. Pull een model, voer één commando uit en je hebt een LLM dat antwoordt op localhost met een interface die er precies zo uitziet als de OpenAI API. Dat is perfect voor een ontwikkelaar op een laptop. De problemen beginnen wanneer een tweede team toegang wil, finance vraagt wie wat uitgeeft en security wil weten welke data naar welk model gaat. Geen van die vragen is waar Ollama voor gebouwd is, en dat is prima, want dat is het werk van een gateway, niet van een model runner.

Deze gids behandelt wat Ollama is, wanneer je het gebruikt in vergelijking met vLLM, en hoe je het voor teams draait zonder in te boeten op governance.

Wat is Ollama?

Ollama is een open-source runtime voor het uitvoeren van LLM's op je eigen infrastructuur, of dat nu een laptop, een on-premises GPU-box of een private cloud-instance is. Je downloadt een open-weight model zoals Llama, Mistral of Qwen, en Ollama serveert het lokaal achter een HTTP-endpoint. Cruciaal is dat dit endpoint een OpenAI-compatibele API gebruikt, zodat code die is geschreven voor de OpenAI SDK kan communiceren met een lokaal Ollama-model door alleen de base URL aan te passen.

Teams kiezen om een paar duidelijke redenen voor Ollama:

  • Privacy. Het model draait op hardware die je zelf beheert, dus prompts en outputs verlaten nooit je omgeving.
  • Offline en air-gapped gebruik. Geen afhankelijkheid van een gehoste provider of het openbare internet.
  • Kosten. Open-weight modellen op je eigen hardware voorkomen API-kosten per token.
  • Eenvoud. Een model operationeel krijgen vereist slechts één commando.

Ollama werkt het beste wanneer

  • Je snelle lokale inference wilt tijdens de ontwikkeling.
  • Je open-weight modellen draait op hardware die je bezit.
  • Data je omgeving niet mag verlaten om privacy- of compliance-redenen.
  • Je een OpenAI-compatibel endpoint nodig hebt zonder zwaardere serving-infrastructuur op te zetten.

Ollama vs vLLM: Welke moeten teams gebruiken?

De meest voorkomende vergelijking is Ollama versus vLLM, omdat beide OpenAI-compatibele API's bieden en beide open-weight modellen self-hosten. Ze zijn echter geoptimaliseerd voor verschillende doeleinden.

Ollama vLLM
Het beste voor Eenvoudige lokale inference, enkele machine, ontwikkeling Productionele serving met hoge throughput
Instelling Eén commando, minimale configuratie Meer configuratie, afgestemd op schaalbaarheid
Throughput Prima voor één persoon of een kleine belasting Hoge concurrency en batching voor veel gebruikers
API OpenAI-compatibel Standaard OpenAI-compatibel
Typisch gebruik Laptops, edge, private experimenten Productionele serving van modellen op grote schaal

De eerlijke samenvatting is dat Ollama de eenvoudigste manier is om een model voor één persoon te draaien, en vLLM is gebouwd om veel gelijktijdige gebruikers te bedienen met een hoge throughput. Veel teams gebruiken beide: Ollama voor lokale ontwikkeling en vLLM voor productie. Het goede nieuws is dat omdat beide OpenAI-compatibel zijn, wat je ook standaardiseert achter dezelfde gateway geplaatst kan worden, en je er zelfs tussen kunt routen.

Waar Ollama tekortschiet voor teams

Ollama doet zijn werk goed, maar het uitrollen voor een organisatie brengt tekortkomingen aan het licht die buiten de scope vallen.

  • Geen gedeeld toegangsbeheer. Een kaal Ollama-endpoint heeft geen ingebouwd idee van welk team of welke gebruiker welk model mag aanroepen.
  • Geen kostentoewijzing. Er is geen overzicht van het verbruik per team of per applicatie, omdat Ollama requests afhandelt zonder ze te meten op basis van de eigenaar.
  • Geen guardrails. Prompts en outputs worden niet gecontroleerd op PII, geheimen of injection-pogingen.
  • Geen routing of fallback. Als één model of box uitvalt, is er niets om naar uit te wijken (failover), en er is geen manier om verschillende requests naar verschillende modellen te sturen.
  • Gecentraliseerde vs. gefragmenteerde endpoints. Elke Ollama-instance is een eigen URL, waardoor applicaties endpoints hardcoden en hun portabiliteit verliezen.

Dit zijn precies de zaken waar een gateway voor is ontworpen, en het is de manier waarop je een lokale model runner omzet in infrastructuur voor teams.

Maak je lokale modellen gereed voor teams

Plaats Ollama en vLLM achter één AI Gateway met toegangsbeheer, kostentracking en guardrails, binnen je eigen VPC.

Hoe je Ollama voor teams draait met TrueFoundry

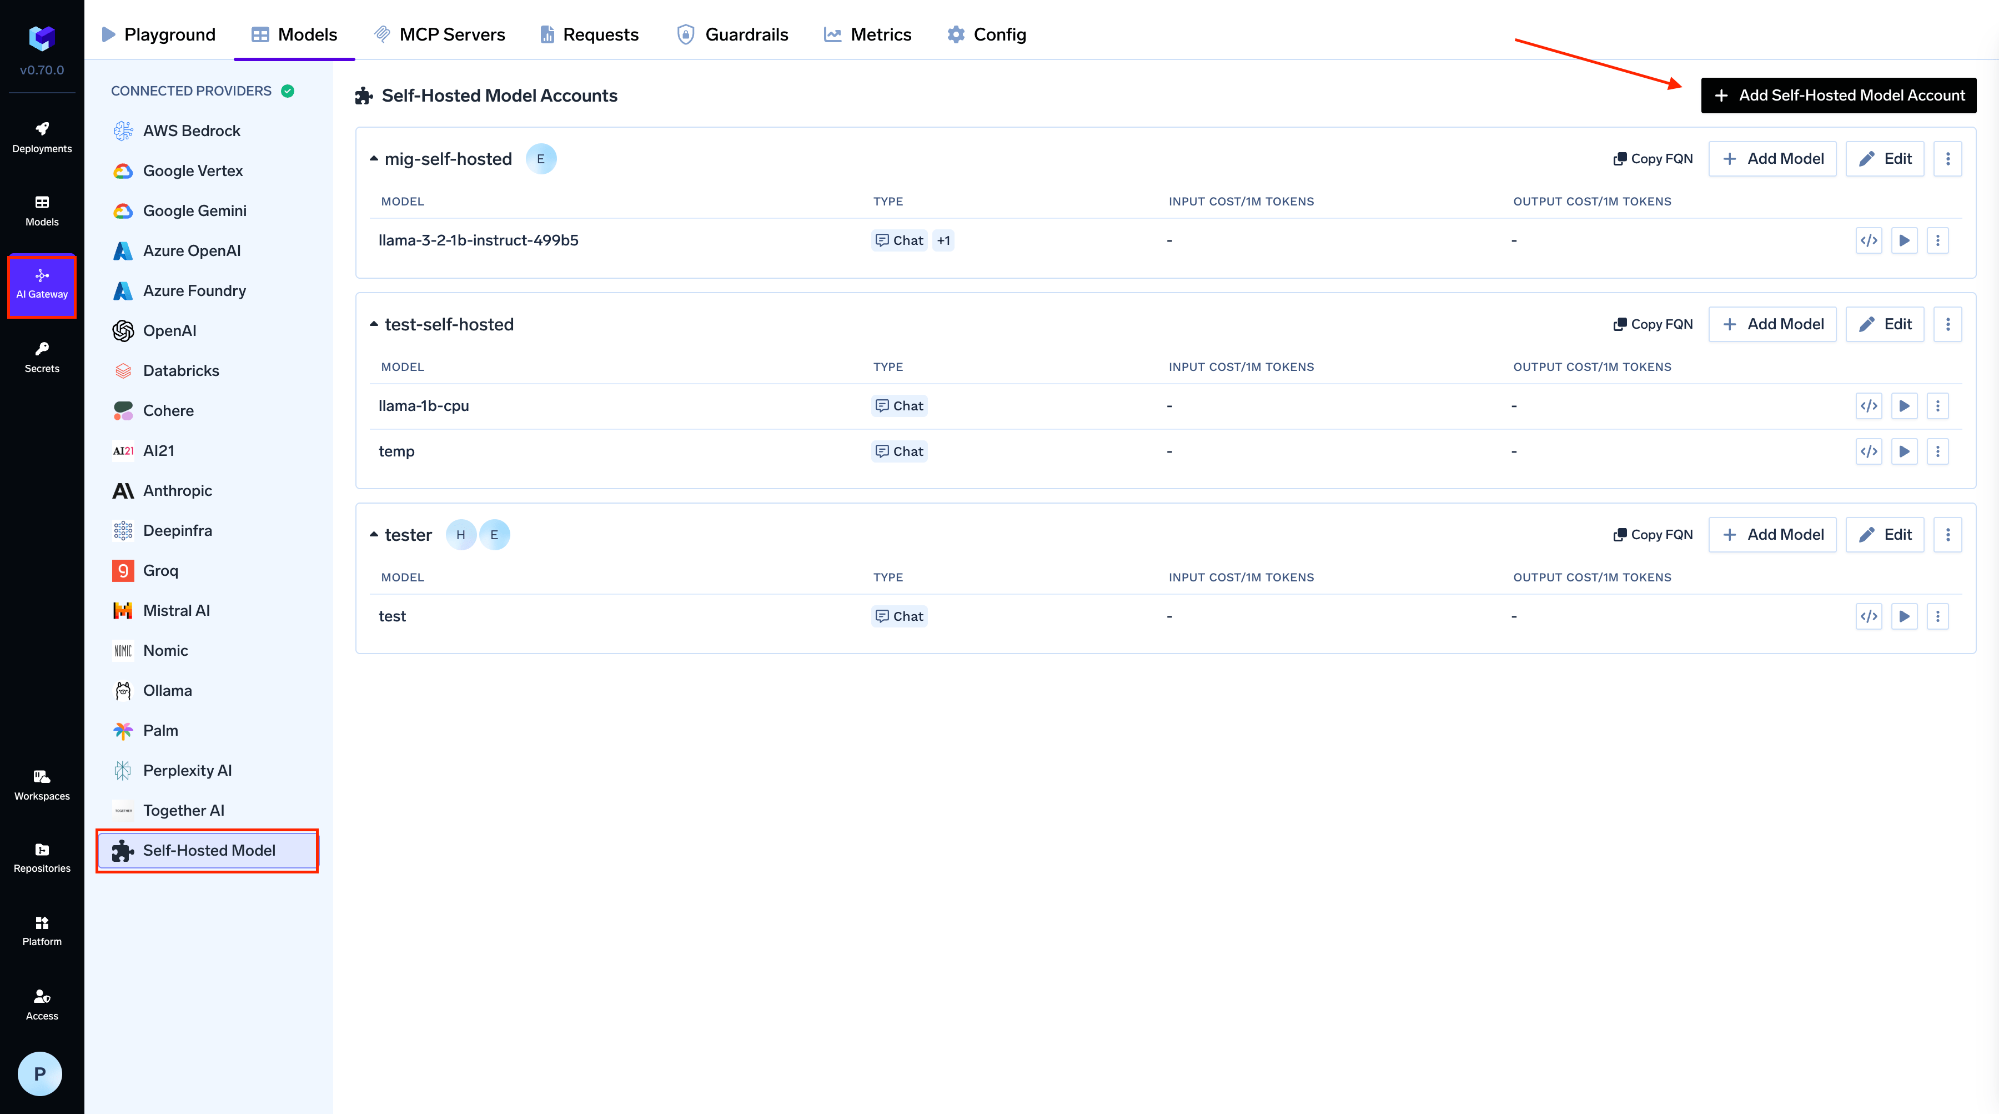
TrueFoundry behandelt een Ollama-server als een self-hosted model. Je verbindt het met de AI Gateway door de endpoint-URL en authenticatiegegevens op te geven. Zodra het is geregistreerd, verschijnt het in de modelcatalogus van de gateway naast cloudproviders, waarbij alle gateway-functies worden toegepast: routing, guardrails, rate limiting, kostentracking en observabiliteit. Ollama wordt hier expliciet ondersteund omdat het een OpenAI-compatibele API biedt, het formaat waar de gateway het beste mee werkt.

Adding a self-hosted model such as Ollama to the TrueFoundry AI Gateway
Productscreenshot, TrueFoundry-documentatie: een self-hosted model toevoegen.

Je registreert het model onder AI Gateway, daarna Models en vervolgens Self Hosted Models. Je geeft het een naam, een model-ID, de URL van je Ollama-server en het type model server, optioneel met authenticatie. Vanaf dat moment stoppen applicaties en agents met communiceren met een kaal localhost-endpoint en roepen ze in plaats daarvan de gateway aan via één uniforme API:

Die enkele verandering maakt Ollama bruikbaar voor een team:

  • Toegangsbeheer. Verleen specifieke gebruikers, teams of virtuele accounts toegang tot het door Ollama ondersteunde model, en niets anders.
  • Kostentracking en rate limits. Bekijk het verbruik per team en applicatie, en stel limieten in voordat de kosten oplopen.
  • Guardrails. Voer PII-, geheimen- en prompt-injection-checks uit op verkeer van en naar het lokale model.
  • Routing en fallback. Plaats Ollama en een gehost model achter één virtuele modelnaam, zodat je kunt uitwijken (failover) of verkeer kunt splitsen zonder de applicatiecode aan te raken.

Omdat de gateway provider-agnostisch en OpenAI-compatibel is voor meer dan 1.000 modellen, kun je een lokaal Ollama-model ook combineren met een vLLM-deployment en cloud-API's onder dezelfde interface. Dit sluit direct aan op portabiliteit van AI-agents. En aangezien TrueFoundry binnen je eigen VPC draait, blijft de privacy waarvoor je in de eerste plaats voor Ollama koos, end-to-end behouden.

Conclusie

Ollama is de snelste manier om een model lokaal te laten draaien, en qua privacy en kosten is het moeilijk te overtreffen. Het is simpelweg niet gebouwd als infrastructuur voor teams; dat is waar toegangsbeheer, kosteninzicht, guardrails en routing om de hoek komen kijken. Verbind Ollama als een self-hosted model met de AI Gateway en het behoudt zijn privacy en lage kosten, terwijl het alles krijgt wat een team nodig heeft om het in productie te laten draaien.

Ontdek hoe TrueFoundry van lokale modellen beheerde, team-ready infrastructuur maakt. Boek een demo of start gratis.

Probeer het nu.

Eén gateway voor al je modellen, MCP-servers en agents. Geen creditcard nodig.

Start gratis
Inhoudsopgave

Eén gateway voor elk LLM, elke agent en elke MCP-server

Boek een gesprek van 30 minuten met onze AI-expert

Demo aanvragen

De snelste manier om je AI te bouwen, beheren en schalen

Demo boeken
Samenvatten met
ChatGPT logo by OpenAI
Perplexity AI logo
Blurry red snowflake on white background, symmetrical frosty design with soft edges and abstract shape.

Ontdek meer

August 27, 2025
|
5 min leestijd

De On-Prem AI-markt in kaart gebracht: van chips tot control planes

TrueFoundry offers scalable alternatives for Vercel AI Gateway limitations
November 10, 2026
|
5 min leestijd

Vercel AI Review 2026: Wij hebben het getest, zodat jij dat niet hoeft te doen

Geen items gevonden.
November 10, 2026
|
5 min leestijd

Vendor lock-in voorkomen met de AI Gateway van TrueFoundry

Geen items gevonden.
November 10, 2026
|
5 min leestijd

TrueFoundry en de MCP-gatewayrevolutie: inzichten uit het Gartner-rapport van 2025

Geen items gevonden.
November 10, 2026
|
5 min leestijd

Gids voor MCP-authenticatie in Claude Code 2026

Geen items gevonden.
November 10, 2026
|
5 min leestijd

Portabiliteit van AI-agents: Wissel van model zonder je agents opnieuw te bouwen

Agentic AI
What is an LLM Router
November 10, 2026
|
5 min leestijd

Wat is een LLM Router? Een volledige gids

LLM Terminology
November 10, 2026
|
5 min leestijd

Toegangsbeheer voor AI Agents: Least-Privilege voor elke Agent

Geen items gevonden.
November 10, 2026
|
5 min leestijd

Guardrails voor AI Agents: Inspectie van Elke Tool Call en Model Hop

Geen items gevonden.

Recente blogs

Black left pointing arrow symbol on white background, directional indicator.

Veelgestelde vragen

What is Ollama?

Ollama is an open-source tool that runs large language models locally on your own hardware and serves them behind a simple, OpenAI-compatible HTTP API. Teams use it for private, offline, and low-cost inference with open-weight models such as Llama, Mistral, and Qwen.

What is the difference between Ollama and vLLM?

Ollama is optimized for easy local inference on a single machine, while vLLM is built for high-throughput production serving with high concurrency. Both expose OpenAI-compatible APIs, so many teams use Ollama for development and vLLM for production, and put both behind the same gateway.

Is Ollama safe to use for a team or in production?

The model runs on infrastructure you control, which is good for privacy, but a raw Ollama endpoint has no access control, cost attribution, or content guardrails. To use it safely across a team, put it behind a gateway that adds authentication, RBAC, rate limits, and PII and secrets inspection.

‍

How do I use Ollama with a whole team?

Connect the Ollama server to an AI Gateway as a self-hosted model by giving it a URL and auth. Applications then call the gateway's unified API instead of a raw endpoint, which adds shared access control, cost tracking, guardrails, and routing on top of Ollama.

What model-serving backends does TrueFoundry support?

Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.

Can I run this in my own VPC or on-prem?

Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so the local, private inference that Ollama gives you stays private across the whole stack.

Volg een korte producttour
Start producttour
Product Tour