



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Guardrails voor AI agents zijn mechanismen voor inhoudsinspectie die de daadwerkelijke payload van elke agent-interactie onderzoeken — de gebruikersprompt, de reactie van het model en de argumenten en resultaten van elke tool call — en actie ondernemen (toestaan, blokkeren of herschrijven) op basis van beleid.
Het helpt om twee vragen te scheiden die elke beheerde agent call moet beantwoorden:
Toegangsbeheer is de uitsmijter bij de deur; guardrails zijn de metaaldetector. Je hebt beide nodig. Een agent kan volledig geautoriseerd zijn om je Postgres MCP-server aan te roepen en toch misleid worden om een destructieve query te sturen — toegang zei ja, en alleen een guardrail op de tool-argumenten ziet wat de query daadwerkelijk is.
Guardrails zijn niet nieuw voor LLM-applicaties, maar agents veranderen het probleem op drie concrete manieren:
Op TrueFoundry worden guardrails afgedwongen bij de gateway op het agentic call-pad — de keten van gebruiker → app → agent → sub-agent → MCP tool calls. Elke beheerde hop passeert een interceptiepunt met een voor- en na-hook.
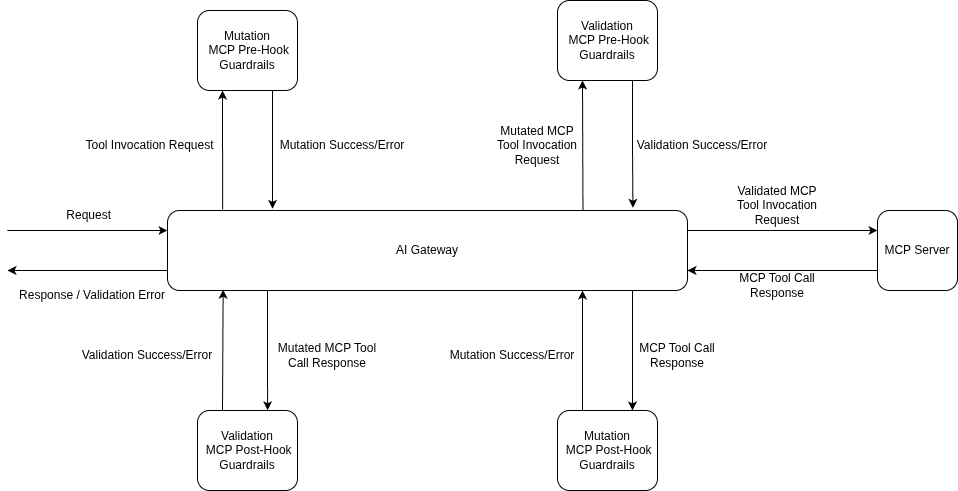
De volgorde is van belang voor kosten en impact. Een fout bij pre-tool betekent dat de tool nooit wordt uitgevoerd — de goedkoopst mogelijke fout. Een fout bij LLM-input annuleert het lopende modelverzoek voordat je ervoor betaalt. Omdat elke hop onafhankelijk wordt gecontroleerd, wordt een gecompromitteerd tool-resultaat bij hop drie onderschept op hop drie, en niet pas nadat het al is vertakt naar nog eens drie calls.
De waarde van het draaien van guardrails bij de MCP Gateway is dat elk echt agent-risico wordt gekoppeld aan een specifieke, ingebouwde controle. De ingebouwde guardrails van TrueFoundry draaien op door TrueFoundry beheerde infrastructuur — er hoeven geen API-sleutels van derden te worden geconfigureerd.
Naast de ingebouwde opties maakt de gateway verbinding met externe providers — Palo Alto Prisma AIRS, CrowdStrike AIDR, Cisco AI Defense, AWS Bedrock Guardrails, Google Model Armor, NVIDIA NeMo Guardrails, Guardrails AI en meer — en ondersteunt het volledig op maat gemaakte guardrails wanneer je logica nodig hebt die specifiek is voor jouw domein.
De guardrail voor prompt-injectie is specifiek gebouwd voor het agent-probleem: het analyseert de gebruikersprompt en eventuele document- of contextinhoud afzonderlijk, zodat een injectie die verborgen zit in een geretourneerde webpagina of ticket wordt opgemerkt, zelfs als het eigen bericht van de gebruiker schoon is.
Het toepassen van guardrails op agent-verkeer is een proces van drie stappen, en het cruciale is dat niets daarvan in je agent-code staat.
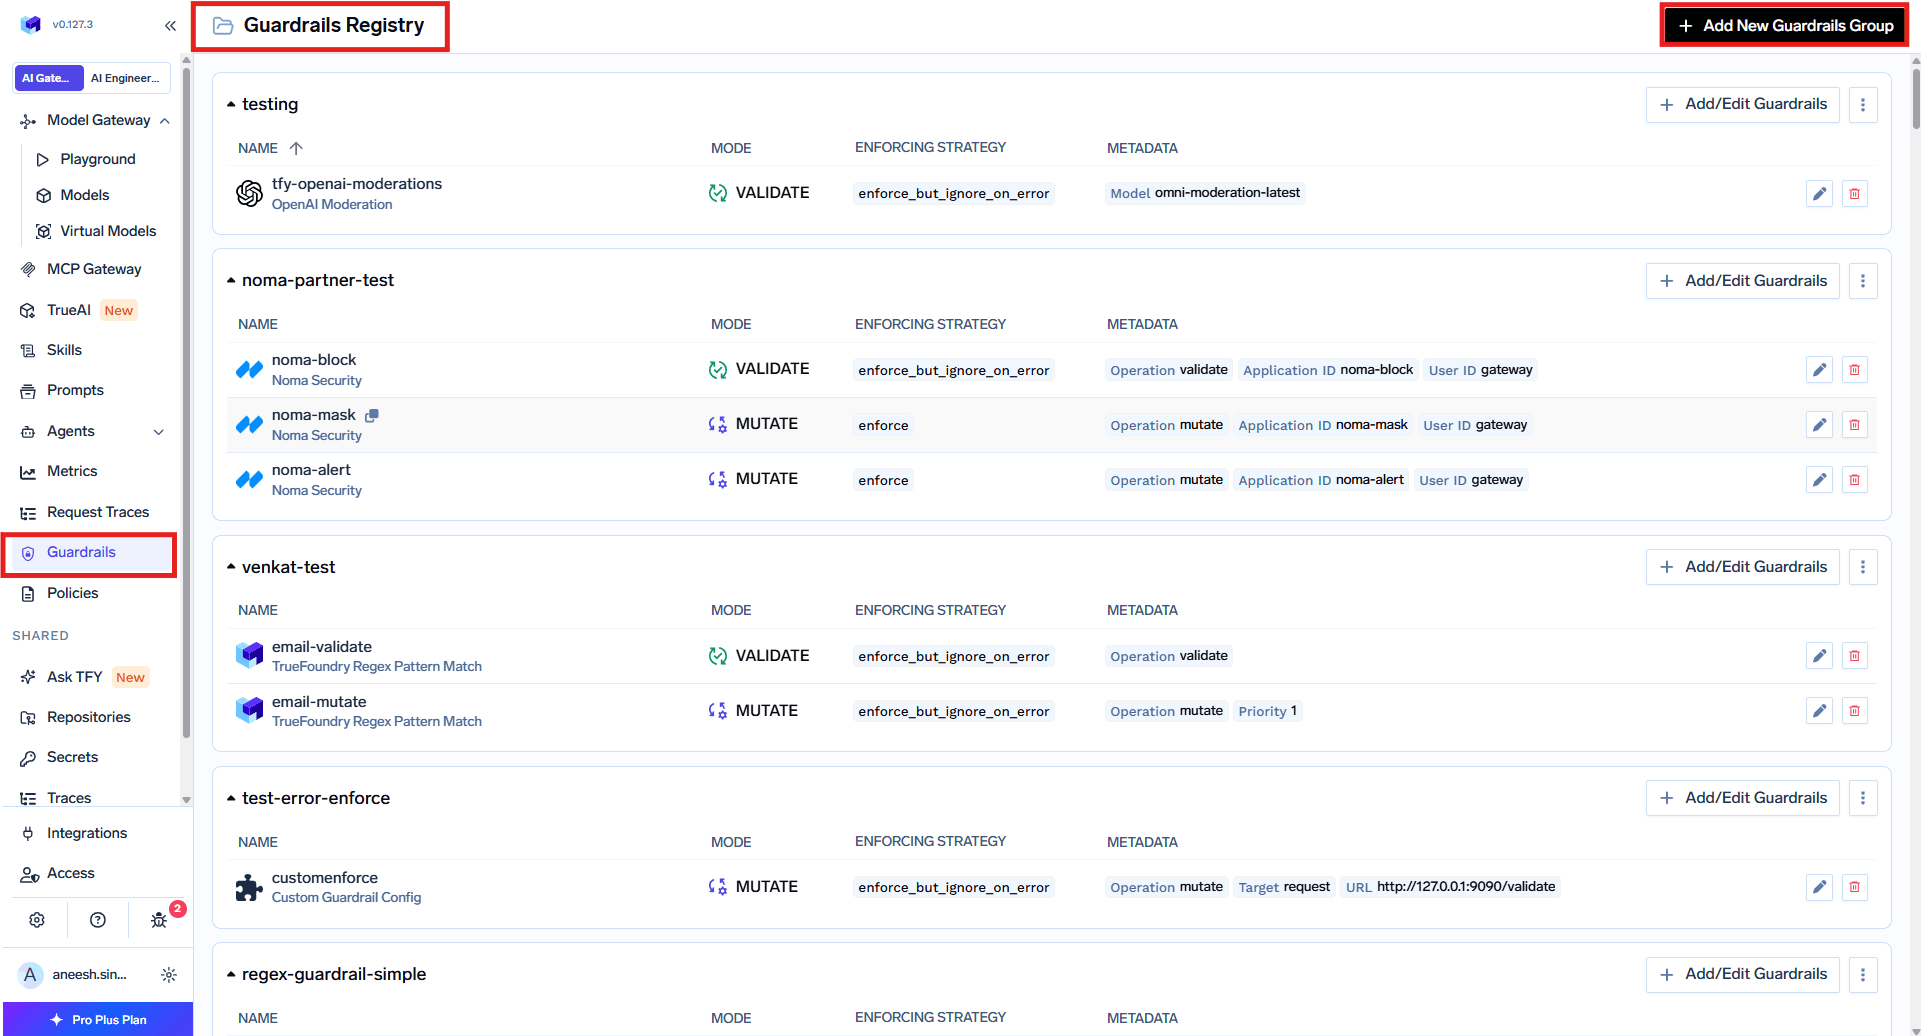
Maak in AI Gateway → Guardrails een guardrails-groep aan en voeg de integraties toe die je nodig hebt — ingebouwd, via een externe provider of op maat gemaakt. Een groep is ook de eenheid van toegangsbeheer: een Manager kan guardrails toevoegen, bewerken en verwijderen; een User kan ze alleen toepassen. Een veelvoorkomend patroon is één organisatiebrede groep die eigendom is van het platformteam, plus groepen per team voor productspecifieke controles.
Maak in AI Gateway → Policies → Guardrails regels aan die bepalen wanneer elke guardrail draait. Dit is wat het model schaalbaar maakt voor vloten van agents: regels zijn gekoppeld aan het doel (de modellen, MCP-servers en zelfs specifieke tools die worden aangeroepen) en het subject (gebruikers, teams of virtuele accounts). Omdat een regel geldt voor elke aanroeper van een bepaalde MCP-server of model, beschermt het elke agent die dat doel raakt — zonder configuratie per agent.
Elke regel combineert:
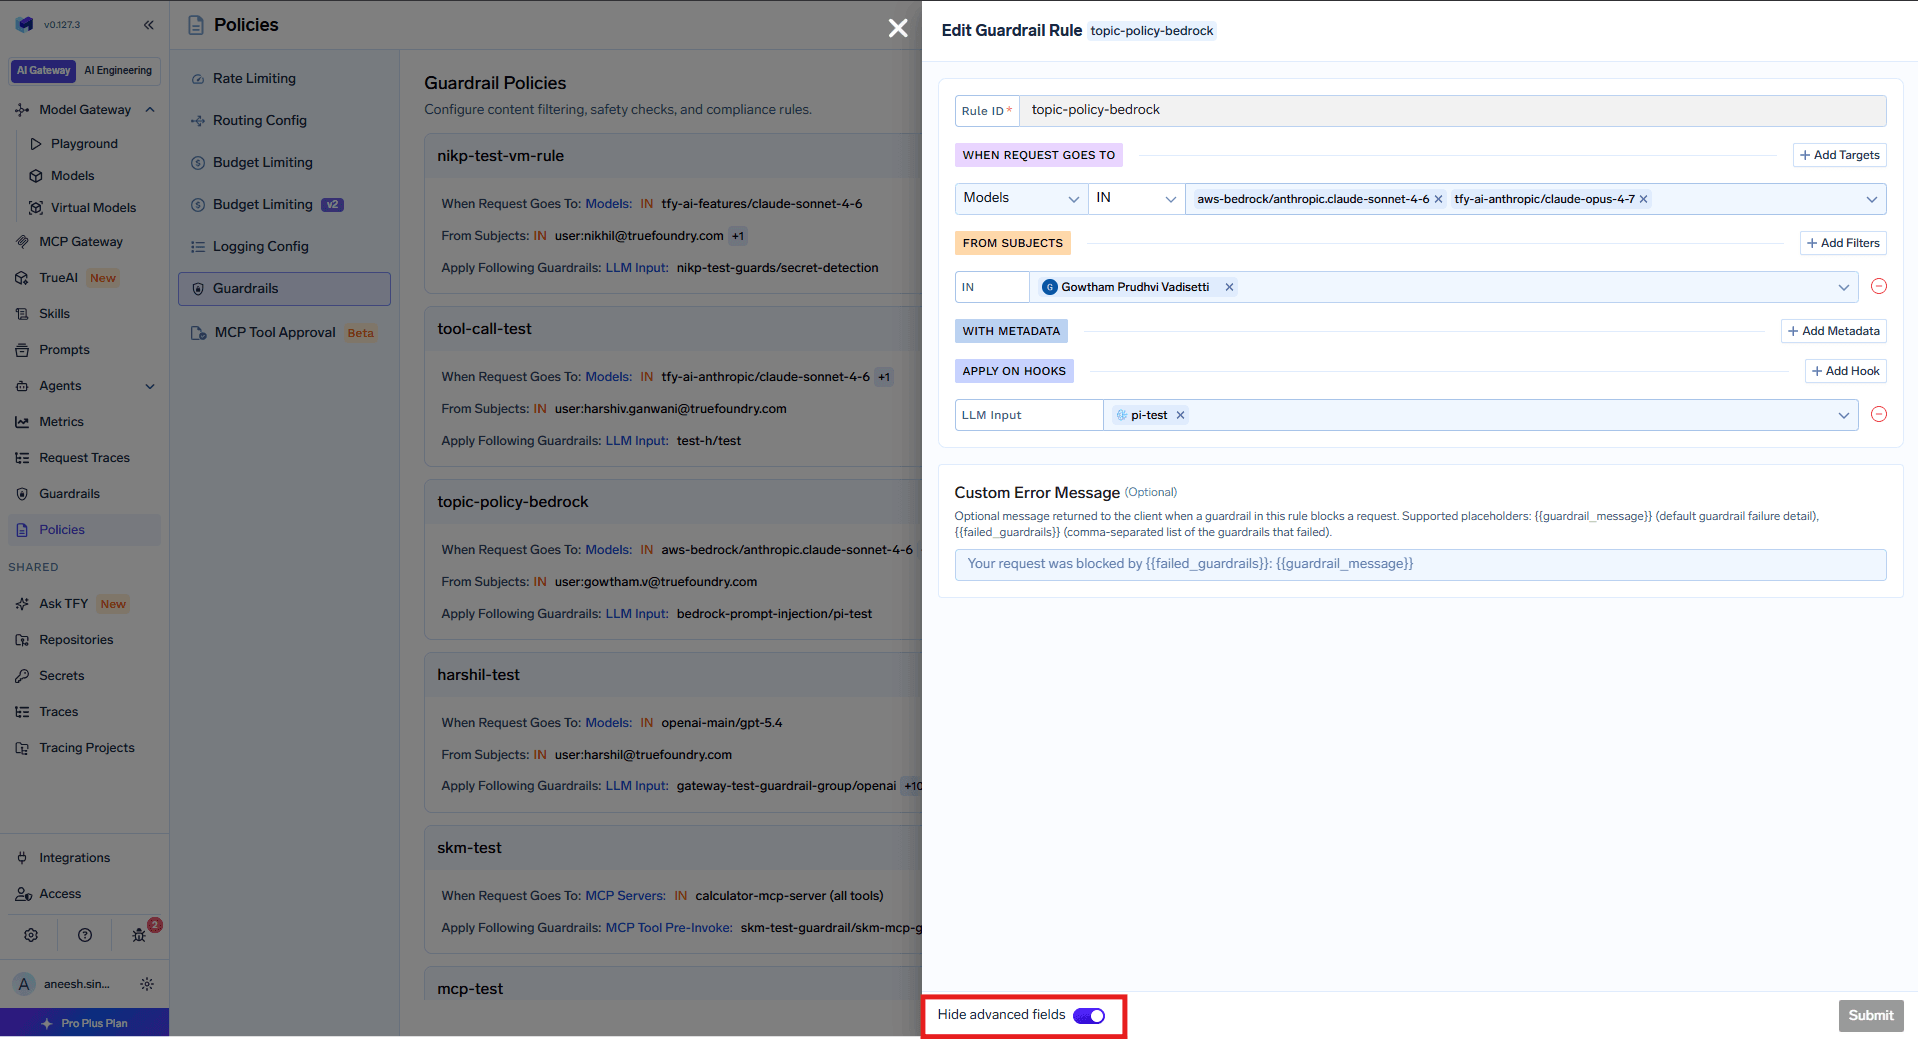
Alle overeenkomende regels worden geëvalueerd en hun guardrails worden samengevoegd per hook. Als Regel A PII-detectie toepast op LLM Input en Regel B prompt-injectiedetectie toepast op LLM Input, draaien ze allebei. Een regel zonder doel- of subjectvoorwaarden wordt een basislijn die geldt voor al het verkeer — nuttig voor een bedrijfsbrede controle op prompt-injectie bovenop al het andere.
Voor snelle tests of eenmalige calls kun je guardrails ook per verzoek doorgeven met de X-TFY-GUARDRAILS header, die beleidsregels volledig omzeilt:
Elk verzoek wordt getracet met de guardrails die hebben gedraaid en hun oordelen, zodat je de dekking kunt bevestigen voordat je erop vertrouwt. Dit is ook waar je valse positieven afstemt, wat voor agents belangrijker is dan voor chatbots: een geblokkeerde hop kan een hele keten laten mislukken.
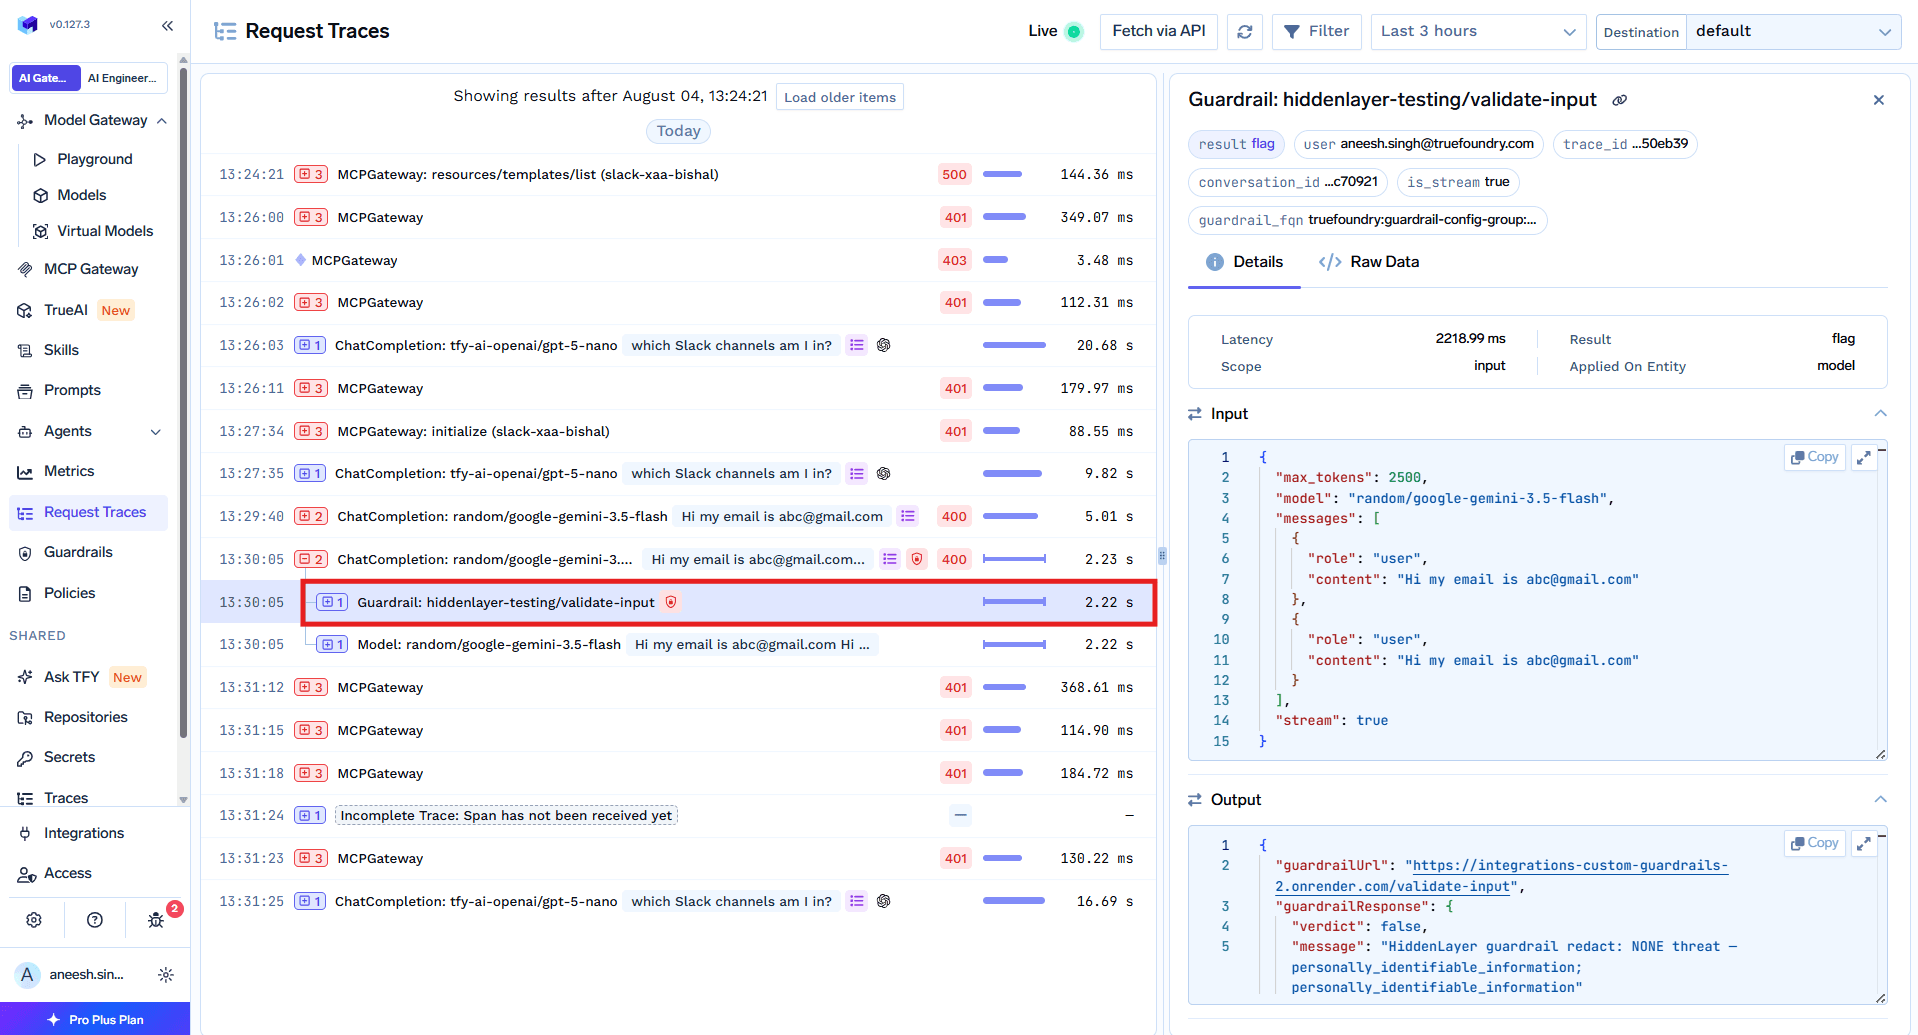
Gebruik voor de lancering de Playground om testprompts en tool calls af te vuren op alle vier de hooks en te zien wat er wordt opgevangen.
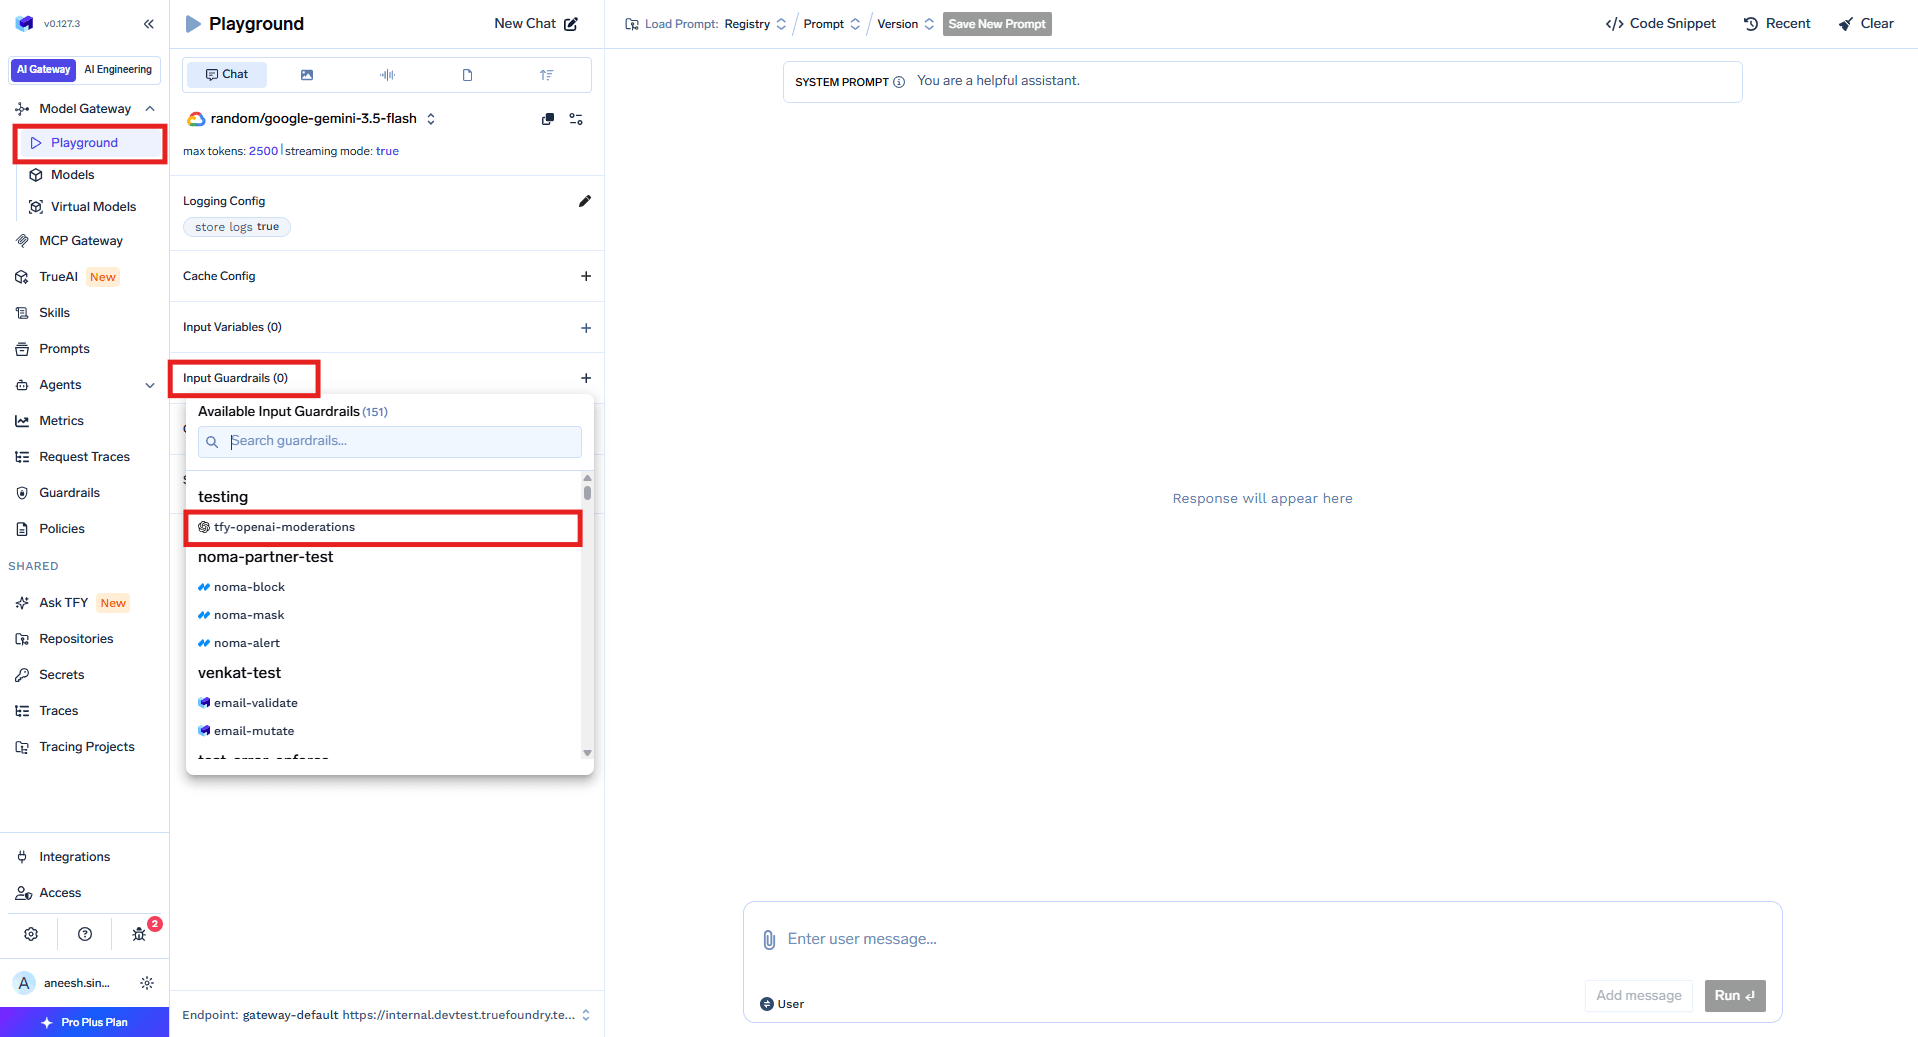
Twee instellingen bepalen hoe elke guardrail zich gedraagt.
Operationele modus:
Handhavingsstrategie:
Voor aangepaste logica implementeer je een guardrail als een HTTP-service en leest de gateway het responseresultaat: een HTTP 2xx betekent dat de guardrail is uitgevoerd, en de JSON-body bevat het resultaat — verdict: false om te weigeren, of een gewijzigde result-body om te herschrijven:
Aanbevolen uitrol voor agents: start elke nieuwe guardrail in Audit en bekijk traces om te zien wat het zou opvangen. Schakel over naar Enforce But Ignore On Error voor bescherming die een storing bij de provider overleeft. Bewaar volledig Enforce voor de controles waar je geen compromissen over kunt sluiten — PII, secrets, destructieve SQL. Omdat een enkele geblokkeerde hop een hele agent-keten kan breken, is eerst auditen niet optioneel.
Je zou kunnen proberen deze controles binnen elke agent te implementeren. De reden om dat niet te doen is dezelfde reden waarom een AI gateway beter is dan een API gateway voor dit verkeer: consistentie en dekking.
Het resultaat zijn guardrails die zich gedragen als infrastructuur: uniform toegepast, waarneembaar in elke trace en beheerd door het platformteam in plaats van verspreid over een dozijn agent-repositories.
Guardrails voor AI agents zorgen ervoor dat een autonoom systeem niet handelt op de verkeerde instructie — door elke prompt, output en tool call te inspecteren op injecties, PII, secrets en onveilige operaties voordat ze schade aanrichten. Het moeilijke deel is niet een enkele controle; het is ze consistent toepassen op elke agent, elk model en elke tool zonder de logica door je hele codebase te verspreiden. Ze afdwingen bij de gateway lost precies dat op: één set regels, gekoppeld aan doelen, die elke aanroeper dekt, waarneembaar in elke trace en draaiend binnen je eigen cloud.
Zie hoe TrueFoundry guardrails uitvoert over je agents, modellen en MCP-tools vanaf één controlepunt → Boek een demo of start gratis.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



AI agent guardrails are content-inspection controls that examine the prompts, model outputs, and tool-call arguments and results in an agent's workflow, then allow, block, or rewrite them based on policy. They stop unsafe content (injections, PII, secrets, destructive commands) from turning into unsafe actions — a distinct job from identity and access control, which only decides whether a call is permitted.
Op TrueFoundry draaien ze bij de AI Gateway op vier hooks - LLM-input, LLM-output, MCP pre-tool, en MCP post-tool. Elke stap wordt afzonderlijk geïnspecteerd, zodat een injectie in een toolresultaat of een destructief argument wordt opgevangen voordat het het model bereikt of de tool uitvoert.
Yes. The prompt-injection guardrail analyzes the user prompt and any document or context content separately, so an instruction hidden inside a returned web page, ticket, or database row is detected even when the user's own message is clean. It runs on the LLM input hook on every turn, because tool results re-enter the model's context continuously.
Register guardrails in AI Gateway → Guardrails, then create policies in AI Gateway → Policies → Guardrails that attach them by target (models, MCP servers, specific tools) and subject (users, teams, virtual accounts). Because rules key on the target, every agent that calls a governed model or tool is covered automatically — no per-agent changes.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP en Agents Register met toegangscontrole op toolniveau, zodat agents van LangGraph, CrewAI, AutoGen, of een aangepast framework centraal kunnen worden gereguleerd.



Het laatste nieuws, artikelen en bronnen in je inbox



















