September 18, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Portabiliteit van AI-agents is de eigenschap dat de logica van een agent hetzelfde blijft, terwijl het onderliggende model kan veranderen. De agent verwijst naar een model op basis van de naam en aanroept een stabiele interface. Welke provider het verzoek daadwerkelijk afhandelt en welke inloggegevens worden gebruikt, bevindt zich volledig buiten de agent.
Vergelijk dat met het gebruikelijke vertrekpunt. Een agent is geschreven tegen de specifieke SDK van een provider, de API-sleutel van de provider staat in de omgeving van de agent en de modelnaam is verspreid over de code. Elk van deze elementen is een draad die de agent aan één leverancier bindt. Portabiliteit ontstaat wanneer je al deze drie draden doorsnijdt.
Het voordeel is praktisch: je kunt een nieuwer model in gebruik nemen op de dag dat het uitkomt, terugvallen op een tweede provider wanneer de eerste een storing heeft, goedkope verzoeken naar een kleiner model routeren en zowel zelfgehoste als commerciële modellen achter dezelfde interface houden. Niets daarvan zou het aanraken van de agent mogen vereisen.
Voor een chatbot die één reactie per interactie geeft, is het wisselen van model vaak al een aanpassing van één regel. Agents verhogen de moeilijkheidsgraad om een paar noemenswaardige redenen, omdat deze bepalen waaraan een goede portabiliteitslaag moet voldoen.
Een portabiliteitslaag die alleen een model-string vervangt, maar de inloggegevens, routering en fallbacks in de agent laat zitten, heeft de agent niet echt draagbaar gemaakt. Het heeft het probleem alleen maar verplaatst.
De aanpak van TrueFoundry is om modeltoegang eenmalig te beheren bij de AI Gateway, en elke agent op naam naar modellen te laten verwijzen. De gateway bewaart de inloggegevens van de provider, handhaaft de toegangsregels en routeert het verkeer. Agents erven dit allemaal.
Elk model, of het nu gaat om OpenAI, Anthropic, Azure OpenAI, Google Vertex, AWS Bedrock, Databricks, Together AI of iets wat je zelf host, bevindt zich achter één enkele OpenAI-compatibele API. Je verwijst je code één keer naar de gateway en wisselt van model door de modelnaam in het verzoek te wijzigen. Dezelfde URL, dezelfde inloggegevens.
De code van de agent is op geen enkele wezenlijke manier veranderd. De inloggegevens zijn niet veranderd. De enige aanpassing is de modelnaam, en zelfs die kan worden geabstraheerd, wat het volgende onderdeel is.
In de Agent Harness van TrueFoundry is het model een selectie in de builder, geen waarde in de code. Je kiest een willekeurig model dat voor jou is ingeschakeld in de gateway. Wisselen is een wijziging met één klik, zonder codewijzigingen en zonder nieuwe inloggegevens.
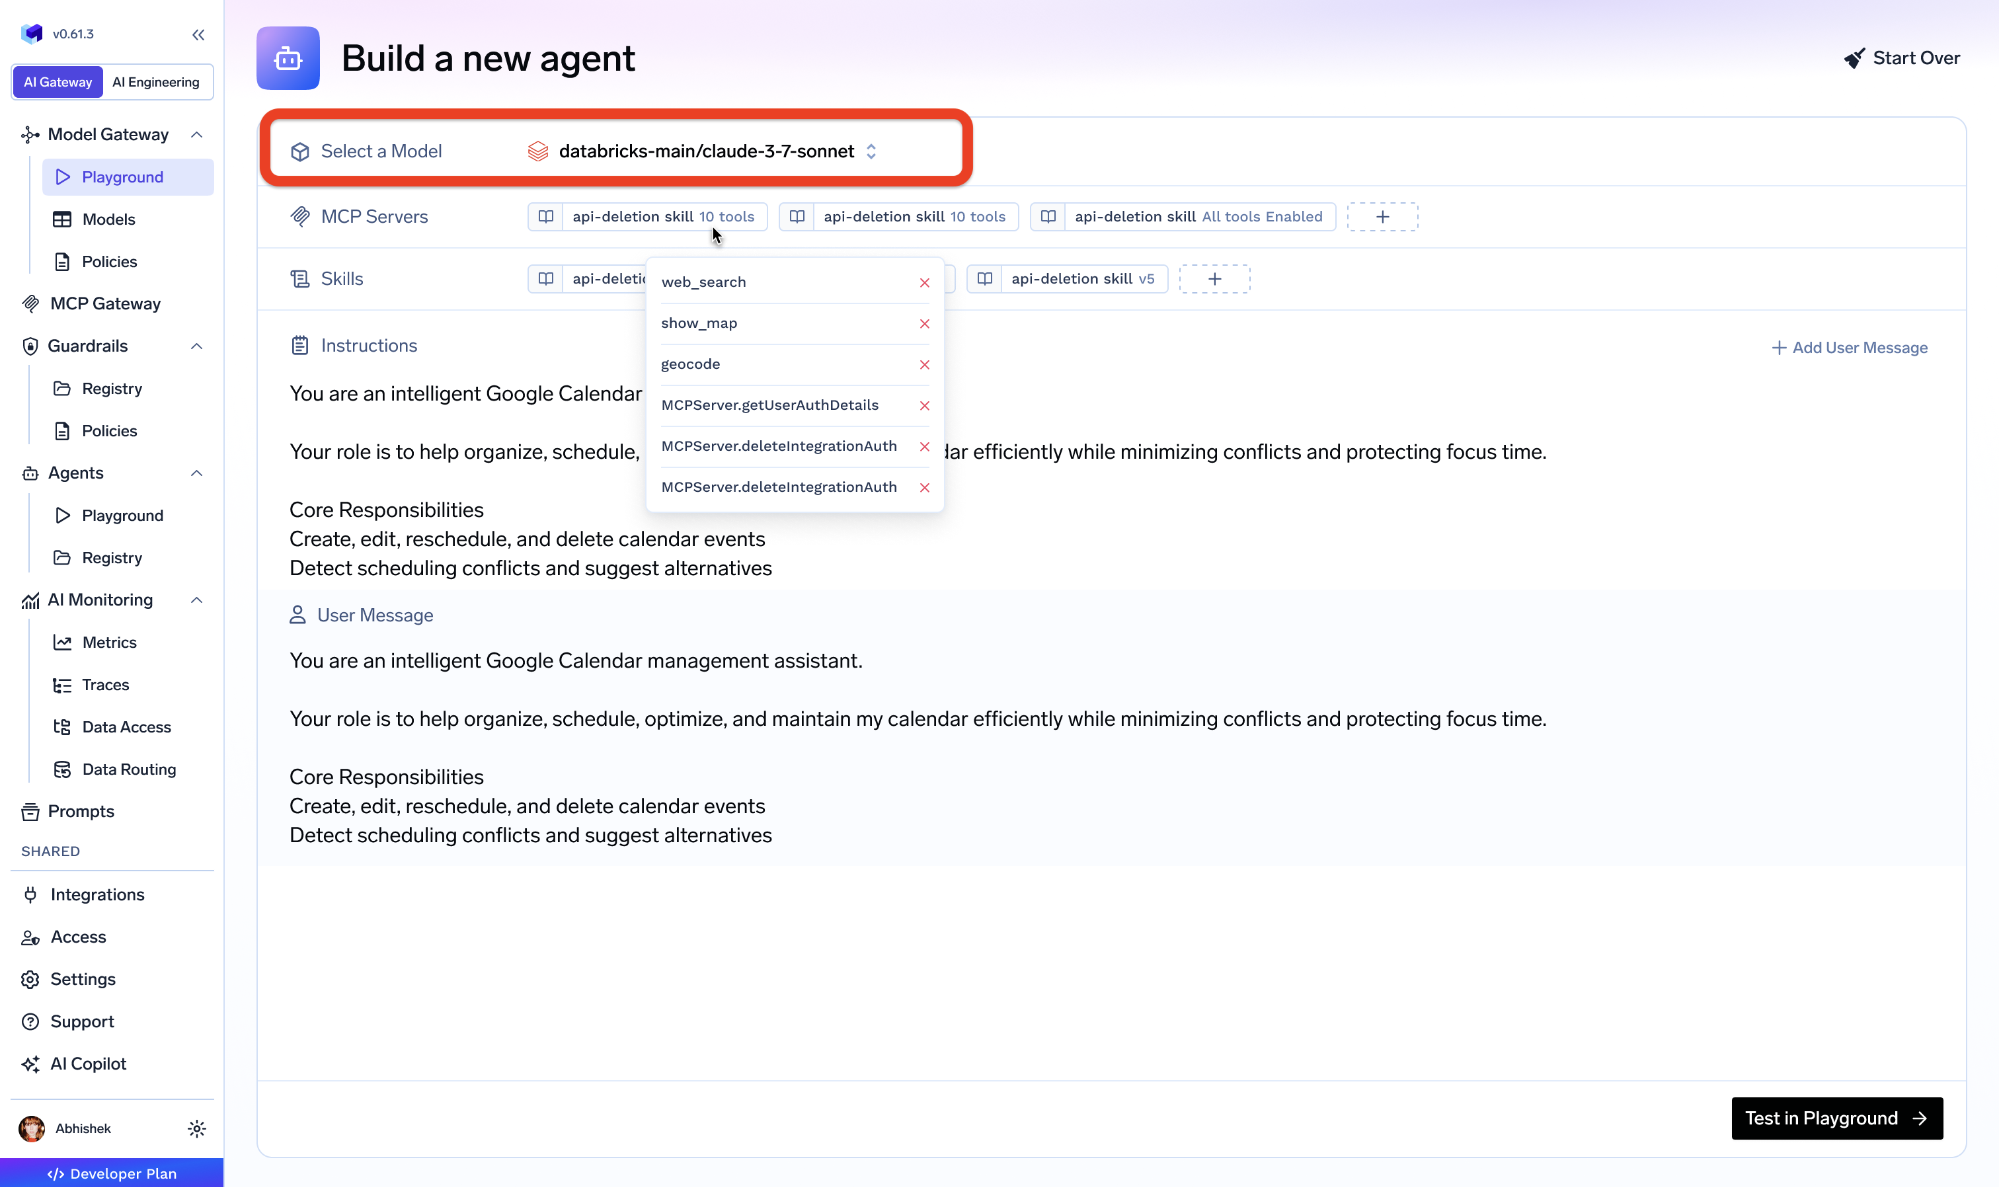
Het verschil met andere beheerde agent-producten is de plek waar inloggegevens zich bevinden. Bij verschillende daarvan geef je API-sleutels van providers op wanneer je een agent maakt, of registreer je ze per werkruimte. In TrueFoundry wordt modeltoegang één keer beheerd op het gateway-niveau en verwijzen agents simpelweg naar modelnamen.
Omdat het beheer plaatsvindt in de gateway, kan een platformteam een nieuwe provider toevoegen, een sleutel roteren of een beleid wijzigen zonder dat iemand een agentdefinitie hoeft aan te raken. Dat is portabiliteit op het niveau van de hele vloot, niet alleen voor één agent.
Portabiliteit gaat niet alleen over handmatige wissels. Met een virtueel model kan een agent één stabiele naam aanroepen, terwijl de gateway beslist welk echt model elk verzoek afhandelt. Dit gebeurt op basis van gewicht, prioriteit, latentie of complexiteit, met ingebouwde herpogingen en fallbacks tussen providers. Als een provider een foutmelding geeft of een time-out heeft, valt het verzoek automatisch terug op de volgende kandidaat. Zo zorgt een storing bij één leverancier er niet voor dat je agents uitvallen.
Auto Routing gaat nog een stap verder door elk verzoek te classificeren als eenvoudig, gemiddeld of complex en het naar het goedkoopste model te sturen dat het kan afhandelen. In de benchmarks van TrueFoundry verlaagde dit de kosten met 50 tot 70 procent, terwijl ongeveer 98 procent van de kwaliteit behouden bleef. De agent roept nog steeds één modelnaam aan. De portabiliteit is wat van dit alles een configuratiebeslissing maakt in plaats van een herstructurering.
De strategische reden om om portabiliteit te geven is onderhandelingspositie en flexibiliteit. Wanneer het overstappen van een provider een aanpassing van één regel is, zit je nooit vast aan een model dat duurder of trager is geworden, of simpelweg is ingehaald. Je kunt een vergelijkingstest uitvoeren tussen twee modellen op echt agent-verkeer, een percentage van de verzoeken naar de uitdager verplaatsen met op gewicht gebaseerde routering, en deze promoveren wanneer deze wint, dit alles zonder een migratieproject.
Het zorgt er ook voor dat zelfgehoste modellen volwaardig blijven meedoen. Omdat de gateway open-weight modellen op back-ends zoals vLLM op dezelfde manier presenteert als commerciële API's, kan een agent schakelen tussen een gehost grensverleggend model en een model dat in je eigen cluster draait, zonder het verschil te merken. Die keuzevrijheid is moeilijk terug te krijgen als agents eenmaal hardgekoppeld zijn aan één leverancier. Daarom is het inbouwen van portabiliteit vanaf het begin belangrijker dan het op het eerste gezicht lijkt. Het sluit naadloos aan bij agent-identiteit en toegangsbeheer: de agent blijft dezelfde entiteit met dezelfde rechten, ongeacht welk model de aanvraag verwerkt.
De gateway doet dit allemaal direct in de verwerkingsketen zonder de knelpunt te worden. Het voegt slechts ongeveer 3 tot 4 ms aan vertraging toe en ondersteunt meer dan 350 RPS op een enkele vCPU over meer dan 1.000 modellen.
Portabiliteit van AI-agents verandert de voortdurende stroom van model-releases van een risico in een voordeel. Wanneer het model achter een agent een naam is die de gateway afhandelt, en niet een SDK en een sleutel die in de code zijn ingebakken, kun je het beste model van de maand in gebruik nemen, terugvallen op andere providers tijdens een storing en goedkoop verkeer naar kleinere modellen routeren, allemaal zonder iets opnieuw te bouwen. Dat is wat een vloot agents flexibel houdt in plaats van star.
Bekijk hoe TrueFoundry je agents laat wisselen tussen meer dan 1.000 modellen vanuit één beheeromgeving. Plan een demo of start gratis.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



AI agent portability is the ability to change the model behind an agent without rewriting the agent. The agent refers to a model by name and calls a stable interface, while the provider, credentials, and routing live outside it. On TrueFoundry that interface is one OpenAI-compatible API fronting 1,000+ models.
Nee. Omdat de AI Gateway providercredentials bewaart en een uniforme API biedt, is wisselen van model een wijziging van één regel in de modelnaam, of een één-klik-wijziging in de Agent Harness-builder. Er zijn geen nieuwe sleutels om te bedraden en geen SDK om te verwisselen.
Wanneer overstappen naar een ander model een configuratiewijziging is in plaats van een herbouw, kunt u nieuwere of goedkopere modellen adopteren zodra ze uitkomen, bake-offs draaien op live verkeer, en self-hosted modellen achter dezelfde interface houden. De kosten van wisselen blijven laag, zodat geen enkele provider u door traagheid kan vastzetten.
Yes. Virtual models support priority, weight, latency, and complexity-based routing with retries and cross-provider fallbacks, so if one provider errors or times out the request moves to the next candidate without the agent doing anything.
More than 1,000, through a single OpenAI-compatible API. You switch models by changing the model name in the request, while keeping the URL and credentials the same.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, hybrid, or across multiple clouds, and no data leaves your domain. This is the main reason regulated enterprises choose it over SaaS-only gateways.



Het laatste nieuws, artikelen en bronnen in je inbox