Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
De On-Prem AI-markt in kaart gebracht: van chips tot control planes
Nu ondernemingen GenAI naar productie brengen, herontdekken velen de voordelen van on‑premise implementaties—of het nu is om cloudkosten te drukken, te voldoen aan strenge compliance-eisen of om een ultra-lage latency te leveren. Maar een on‑premise AI stack is geen los apparaat dat u in een rack kunt hangen en kunt vergeten. Het is een gelaagd ecosysteem van hardware, orchestratie, dataplatforms en serving frameworks die allemaal in harmonie moeten samenwerken.
Deze gids doorloopt elke laag van de moderne on‑prem AI stack en toont de waardepropositie van elk onderdeel.
Waarom On‑Premise AI terrein wint
Ondernemingen in de financiële sector, gezondheidszorg, industrie en overheid worden geconfronteerd met strengere regelgeving rond datasoevereiniteit, stijgende cloudrekeningen en prestatie-SLA's waaraan de publieke cloud niet altijd kan voldoen. Samen vormen deze lagen het fundament van een on-premise AI-platform dat ondernemingen onafhankelijk van de beperkingen van de publieke cloud kunnen schalen, beheren en exploiteren.
Datacontrole & Compliance: Houd gevoelige data volledig achter uw firewall. Wanneer data naar een publieke cloud worden gestuurd, kunnen de exacte fysieke locatie en het juridische rechtsgebied waaronder deze vallen onduidelijk worden. Dit zorgt voor aanzienlijke compliancerisico's en bemoeilijkt audits. Een on-premise inrichting stelt een organisatie in staat om de gehele AI stack af te stemmen op deze regelgeving. Dit biedt een verdedigbaar kader dat voldoet aan wettelijke normen en de complexiteit van grensoverschrijdende gegevensoverdracht vermijdt.
Prestaties & Latency: Plaats compute en opslag op dezelfde locatie voor real-time inference. Door data lokaal te verwerken, kan on-premise AI een aanzienlijk lagere en, nog belangrijker, voorspelbaardere latency bieden. Deze consistente prestaties met een hoge doorvoer zijn essentieel voor toepassingen die onmiddellijke, cross-modale besluitvorming vereisen, zoals het analyseren van een stroom sensordata terwijl deze wordt vergeleken met historische gegevens. Dit prestatievoordeel strekt zich ook uit tot de integratie met bestaande bedrijfssystemen. On-premise oplossingen kunnen, dankzij hun flexibiliteit en aanpasbaarheid, vaak eenvoudiger en betrouwbaarder worden geïntegreerd met legacy-databases, ERP-systemen en andere operationele technologie die mogelijk niet compatibel is met gestandaardiseerde cloudomgevingen.
Voorspelbaarheid van kosten: Stap over van variabele pay-as-you-go-tarieven naar vaste infrastructuurinvesteringen. Verborgen kosten voor datatransfers (egress), API-calls, opslagschaling en schommelende computeprijzen kunnen de initiële voordelen van een lage CapEx snel tenietdoen, wat volgens sommige analyses leidt tot "pure verspilling" van cloud-uitgaven. In tegenstelling daartoe biedt een on-premise implementatie, ondanks de hoge initiële kosten, voorspelbare en beheersbare OpEx op de lange termijn. Voor organisaties met een continu AI-gebruik blijkt een on-premise infrastructuur over een periode van drie tot vijf jaar vaak de meest kosteneffectieve optie te zijn.
Maatwerkintegratie: Naadloos verbinden met legacy-systemen, edge-apparaten of eigen proprietary hardware.
Het in-house bouwen en beheren van deze stack brengt echter kapitaaluitgaven, gespecialiseerde talentvereisten en doorlopende onderhoudskosten met zich mee.
Wat is een moderne On‑Premise AI Stack?
Een moderne on-premise AI stack is een complex, meerlaags systeem waarin elk onderdeel een cruciale rol speelt. Het is geen monolithische entiteit, maar een onderling afhankelijk ecosysteem van hardware en software dat is ontworpen om robuuste, schalingsbereite en efficiënte AI-mogelijkheden te leveren. Om deze stack te begrijpen, is een ontleding laag voor laag nodig, van de fysieke infrastructuur die de pure rekenkracht levert tot de hoogwaardige platforms die de AI-workflow mogelijk maken.
Elke laag moet zo worden ontworpen dat het gebruik wordt gemaximaliseerd, de betrouwbaarheid wordt gewaarborgd en een naadloze schaling mogelijk is—zonder dat u vastzit aan één enkele leverancier.
Hardware & Fysieke Infrastructuur
Dit is het fundament van de gehele AI stack, de fysieke manifestatie van rekenkracht. Het omvat de compute engines die de berekeningen uitvoeren, de opslagsystemen die de enorme datasets bevatten en de netwerkstructuur die alles met elkaar verbindt. De prestaties en beperkingen van deze laag bepalen het potentieel van alle volgende lagen.
Compute Engines
GPU's: Oorspronkelijk ontworpen voor het renderen van 3D-afbeeldingen, zijn GPU's de werkpaarden van de AI-revolutie geworden vanwege hun massaal parallelle architectuur. NVIDIA heeft een dominante positie in deze markt opgebouwd met zijn datacenter-GPU's, zoals de A100, H100 en de aankomende B200-serie. Deze chips, uitgerust met duizenden gespecialiseerde kernen (bijv. Tensor Cores), kunnen prestaties voor AI-training leveren die tot 20 keer sneller zijn dan traditionele CPU's. Ze zijn de huidige de facto standaard voor het bouwen van hoogwaardige on-premise AI-trainingsclusters.
CPU's: Terwijl GPU's het zware werk van parallelle verwerking voor hun rekening nemen, blijven CPU's essentiële onderdelen van de AI-server. Ze beheren de algehele systeemoperaties, verwerken seriële verwerkingstaken en orchestreren de datastroom van en naar de GPU's. De nieuwste generatie multi-core CPU's van Intel en AMD biedt de nodige general-purpose rekenkracht om de gespecialiseerde versnellers te ondersteunen.
ASIC's/TPU's: De opkomende en ontregelende trend in AI-compute is de opkomst van Application-Specific Integrated Circuits (ASIC's). Dit zijn chips die vanaf de basis zijn ontworpen voor één enkel doel: het uitvoeren van AI-workloads. Google's Tensor Processing Units (TPU's) zijn hier een goed voorbeeld van, geoptimaliseerd voor de matrixoperaties die het hart vormen van neurale netwerken. Op de on-premise markt daagt een nieuwe klasse startups het GPU-monopolie uit met gespecialiseerde ASIC's. Bedrijven zoals Groq ontwikkelen chips voor ultra-lage latency inference, terwijl SambaNova Systems en Cerebras vernieuwende architecturen creëren (respectievelijk Reconfigurable Dataflow Units en Wafer-Scale Engines) die een betere TCO en energie-efficiëntie beloven voor grootschalige training en inference. Deze gespecialiseerde versnellers vertegenwoordigen de toekomst van AI-hardware en bieden een pad voorbij de energie- en kostenbeperkingen van algemene GPU's.
Enterprise Servers & Opslag
High-Performance Servers: Führende enterprise hardwareleveranciers zoals Hewlett Packard Enterprise (HPE) met zijn ProLiant- en Apollo-lijnen, Dell Technologies met zijn PowerEdge-servers, Supermicro, en IBM met zijn Power Systems, leveren het serverchassis voor on-premise AI. Dit zijn geen standaardservers; ze zijn specifiek gebouwd om meerdere krachtige GPU's te accommoderen, enorme hoeveelheden snel geheugen (RAM) te bieden en geavanceerde koeloplossingen te bevatten om de warmteafgifte van de versnellers op te vangen.
High‑Performance Opslag: AI wordt gevoed door data, en de opslaglaag moet snelle, gelijktijdige toegang bieden tot enorme datasets zonder een bottleneck te vormen. Dit vereist een stap verder dan traditionele opslag. High-performance, low-latency opslagoplossingen zoals NVMe (Non-Volatile Memory Express) SSD's en gedistribueerde bestandssystemen zijn essentieel. De data zelf worden doorgaans georganiseerd in data lakes voor de opslag van grote hoeveelheden ruwe, ongestructureerde data (afbeeldingen, tekst, logs) en data warehouses voor gestructureerde, analyseklare data. Een kritiek opkomend onderdeel, vooral voor generatieve AI, is de vector database, die is geoptimaliseerd voor het opslaan en bevragen van de hoogdimensionale vector embeddings die ongestructureerde data vertegenwoordigen.
High‑Speed Netwerken
InfiniBand & RDMA netwerken leveren tot 400 Gbps aan low‑latency doorvoer, wat ervoor zorgt dat GPU's continu van data worden voorzien tijdens gedistribueerde training of parallelle inference. De netwerklaag is het "zenuwstelsel" van het AI-datacenter, verantwoordelijk voor de naadloze overdracht van data tussen de opslagsystemen en de compute-nodes. Voor grootschalige AI, met name gedistribueerde training waarbij één enkel model wordt getraind over honderden of duizenden GPU's, is standaard Ethernet-netwerken onvoldoende en kan het een grote prestatie-bottleneck worden. Om te voorkomen dat krachtige GPU's nietsdoen terwijl ze op data wachten, vertrouwen on-premise AI-clusters op netwerken met hoge bandbreedte en lage latency. Technologieën zoals InfiniBand en RDMA (Remote Direct Memory Access) zijn cruciaal. InfiniBand kan bijvoorbeeld een doorvoer tot 400 gigabit per seconde ondersteunen, wat garandeert dat data tussen servers en opslag verplaatst kunnen worden met de snelheid die nodig is om de compute engines volledig bezet te houden. Deze snelle interconnectie is een onmisbaar onderdeel van elke serieuze on-premise AI-infrastructuur.
De Orchestratie- en Beheerslaag
Bovenop de fysieke hardware bevindt zich de orchestratie- en beheerslaag, die bestaat uit de software die de onderliggende resources abstraheert, partitioneert en beheert. Deze laag transformeert een starre verzameling fysieke servers in een flexibel, schaalbaar en efficiënt platform voor het ontwikkelen en uitvoeren van AI-toepassingen.
De rol van Virtualisatie en Containerisatie
De basistechnologieën voor resourcebeheer zijn virtualisatie en containerisatie. Ze maken een efficiënte partitionering en isolatie van workloads mogelijk.
Virtual Machines (VM's): Virtualisatie is al decennia lang een vast onderdeel van het datacenter. Een hypervisor creëert meerdere virtuele machines op een enkele fysieke server, elk met een eigen volledig besturingssysteem. Hoewel robuust en goed begrepen, hebben VM's een grotere resource-footprint en tragere opstarttijden vergeleken met containers. Ze blijven echter relevant, vooral voor het moderniseren van legacy-applicaties naast nieuwe AI-workloads. Platforms zoals IBM Fusion en Vates VMS zijn specifiek ontworpen om een geïntegreerd on-premise platform te bieden dat zowel VM's als containers kan beheren, vaak met functies zoals directe GPU-toegang.
Containers (bijv. Docker): Containerisatie is de moderne, lichtgewicht benadering van workload-isolatie. Een container verpakt een applicatie en al haar afhankelijkheden (bibliotheken, configuratiebestanden) in één enkele, overdraagbare eenheid die de kernel van het host-besturingssysteem deelt. Dit resulteert in een veel kleinere footprint, snellere opstarttijden en grotere resource-efficiëntie dan VM's. Voor AI betekent dit dat een model en de specifieke omgeving ervan kunnen worden ingekapseld in een onveranderlijk (immutable) container-image. Dit image kan vervolgens consistent worden ingezet op de laptop van een ontwikkelaar, een testserver en het productiecluster, waardoor het probleem "op mijn machine werkte het wel" verdwijnt en de reproduceerbaarheid wordt gewaarborgd.
Kubernetes: Het besturingssysteem voor het AI-datacenter
Waar Docker het containerformaat biedt, levert Kubernetes het beheer op schaal. Kubernetes is een open-source platform dat de uitrol, schaling, netwerkinrichting en het beheer van gecontaineriseerde applicaties over een cluster van machines automatiseert. Het is de onbetwiste standaard geworden voor container-orchestratie en is de motor achter de meeste moderne cloud-native applicaties, of deze nu in de publieke cloud of on-premise draaien.
Voor on-premise AI is Kubernetes de cruciale verbinding tussen de applicatielaag en de hardware. Enterprise-grade Kubernetes-distributies zoals Red Hat OpenShift zijn specifiek ontworpen voor on-premise en hybride cloud-implementaties en bieden de beveiliging, het beheer en de ondersteuning die bedrijven eisen.
De voordelen van het gebruik van Kubernetes voor AI-workloads zijn enorm:
Geautomatiseerde schaling en load balancing: Kubernetes kan het aantal containerreplica's automatisch opschalen of afschalen op basis van de rekenvraag en de inference-verzoeken over deze replica's verdelen, wat zorgt voor een hoge beschikbaarheid en optimale prestaties.
Resourcebeheer en scheduling: Kubernetes beschikt over GPU-bewuste scheduling-mogelijkheden, waardoor het AI-workloads intelligent kan plaatsen op nodes waar de benodigde versnellingshardware beschikbaar is. Zo wordt het gebruik van deze kostbare middelen gemaximaliseerd.
Veerkracht en zelfherstel (self-healing): Als een container of node uitvalt, kan Kubernetes deze automatisch herstarten of opnieuw inplannen op een gezonde node. Dit biedt de veerkracht die nodig is voor langdurige modeltrainingsjobs en missiekritieke inference-services.
In essentie biedt Kubernetes het dynamische, geautomatiseerde en veerkrachtige besturingssysteem voor het on-premise AI-datacenter.
Data & ML Enablement
Dataplatforms & Governance
Dit is de hoogste softwarelaag van de stack, die de gespecialiseerde tools en platforms bevat die data scientists en machine learning engineers gebruiken om de end-to-end AI-levenscyclus uit te voeren. Deze laag maakt gebruik van de onderliggende hardware en orchestratie om data te beheren en om AI-modellen te bouwen, trainen, uit te rollen en te monitoren.
De Data Fabric (Dataplatforms)
Voordat een model kan worden gebouwd, moeten de data worden beheerd. Dataplatforms bieden een geïntegreerde omgeving voor de gehele datalevenscyclus, van ingestie en verwerking tot opslag en governance.
Cloudera Data Platform (CDP): Als een dominante speler in het on-premise en hybride datalandschap is Cloudera geëvolueerd vanuit zijn roots in het Hadoop-ecosysteem tot een uitgebreid enterprise dataplatform. Het CDP Private Cloud-aanbod is specifiek ontworpen om on-premise te draaien, meestal bovenop een Kubernetes-cluster zoals Red Hat OpenShift. Het biedt een geïntegreerde, open data lakehouse-architectuur die zowel gestructureerde als ongestructureerde data op petabyte-schaal kan verwerken. Cruciaal voor enterprise AI is de integratie van robuuste, gecentraliseerde beveiliging via Apache Ranger en een geïntegreerd governance- en metadata-framework genaamd Shared Data Experience (SDX). Dit garandeert dat consistente beveiligingsregels worden toegepast op alle data en analyses in de hybride omgeving.
Databricks en hybride connectiviteit: Hoewel Databricks voornamelijk een cloud-native platform is, zorgt de prominentie ervan binnen het AI-domein ervoor dat veel organisaties oplossingen bouwen om hun on-premise databronnen, zoals een Cloudera-cluster, te verbinden met hun Databricks-omgeving. Deze realiteit onderstreept het hybride karakter van moderne enterprise AI, waarbij de 'datazwaartekracht' het vaak noodzakelijk maakt om grote datasets on-premise te houden, terwijl cloud-gebaseerde tools worden ingezet voor specifieke analyses of samenwerkingstaken.
MLOps & Experimentatie
MLOps (Machine Learning Operations) is een reeks praktijken die erop gericht is om machine learning-modellen betrouwbaar en efficiënt in productie te nemen en te onderhouden. MLOps-platforms zijn de tools die deze praktijken mogelijk maken, door de gehele ML-levenscyclus te automatiseren en de kloof te dichten tussen data science (het bouwen van modellen) en IT-operations (het uitvoeren ervan in productie).
Belangrijke functies van een MLOps-platform zijn onder meer: het bijhouden van experimenten (het vastleggen van alle parameters, metrieken en artefacten), modelversiebeheer en -registratie, het bouwen van geautomatiseerde CI/CD-pipelines (Continuous Integration/Continuous Deployment) voor modellen, het beheren van de uitrol en het monitoren van modelprestaties op problemen zoals data drift.
De markt voor on-premise MLOps biedt een mix van krachtige open-source en commerciële platforms:
Open-Source:MLflow is een leidend open-source MLOps-platform dat breed wordt toegepast vanwege zijn flexibiliteit, framework-agnostische benadering en uitgebreide functies voor het bijhouden van experimenten en modelbeheer. Het stelt teams in staat robuuste MLOps-workflows te bouwen zonder vendor lock-in.
Commerciële platforms: End-to-end beheerde platforms zoals DataRobot en Iguazio (overgenomen door McKinsey) bieden allesomvattende oplossingen die de gehele levenscyclus dekken, vaak met de nadruk op gebruiksgemak, automatisering en enterprise-grade ondersteuning.
Vul de platformkeuze aan met TrueFoundry’s AI Gateway RBAC, guardrails en budgetten om ervoor te zorgen dat het beleid naadloos wordt gehandhaafd over teams en modellen heen.
Serving & Schalen van AI in Productie
Zodra een model is getraind en gevalideerd, moet het worden uitgerold naar een productie-omgeving waar het invoerdata kan ontvangen en voorspellingen kan terugsturen—een proces dat inference wordt genoemd. Model serving is een gespecialiseerde taak die software vereist die is geoptimaliseerd voor een hoge doorvoer en een lage latency.
NVIDIA Triton Inference Server: Een hoogwaardige, open-source inference-server van NVIDIA. De belangrijkste sterkten zijn het vermogen om modellen van vrijwel elk framework (TensorFlow, PyTorch, ONNX, enz.) uit te voeren en de capaciteit voor gelijktijdige modeluitvoering. Hierdoor kunnen meerdere modellen of meerdere instanties van hetzelfde model op één GPU draaien, wat de benutting van de hardware maximaliseert.
KServe: Een standaard voor model serving op Kubernetes. KServe biedt een schaalbaar en uitbreidbaar platform voor het uitrollen van modellen. Opvallende kenmerken zijn onder meer serverless inference-mogelijkheden (met autoscaling die pods tot nul kan terugschalen wanneer ze niet worden gebruikt, wat resources bespaart) en een "InferenceGraph" die geavanceerde uitrolstrategieën zoals canary-releases, A/B-testen en model-ensembles ondersteunt.
Seldon Core: Nog een krachtig, open-source model serving-platform voor Kubernetes. Seldon Core staat ook bekend om zijn robuuste ondersteuning van geavanceerde uitrolpatronen, waaronder A/B-testen, canary-deployments en multi-armed bandits (MAB's). Dit maakt het een sterke keuze voor organisaties die modellen in productie rigoureus moeten testen en optimaliseren.
Andere frameworks: Het ecosysteem omvat ook andere krachtige open-source tools zoals Haystack, een framework voor het bouwen van complexe agentic- en RAG-pipelines, en Ray, een gedistribueerde compute engine die vaak wordt gebruikt als de ruggengraat voor het trainen en serven van grootschalige AI-toepassingen.
TrueFoundry werkt als een gateway/control plane boven deze servers, zodat u kunt combineren (Triton voor CV-modellen, vLLM voor LLM's, KServe voor serverless edges) terwijl u één consistente interface-, beleids- en telemetrielaag behoudt.
De Applicatie- en Controlelaag: AI Gateway en MCP
De lagen die tot nu toe zijn beschreven, bieden het fundament voor het bouwen en uitvoeren van AI-modellen. Om deze modellen echter veilig en efficiënt toegankelijk te maken voor eindgebruikersapplicaties en om complexe, agentic workflows mogelijk te maken, is een laatste softwarelaag vereist: de Applicatie- en Controlelaag. Deze laag fungeert als het centrale zenuwstelsel voor alle AI-interacties en biedt governance, beveiliging en een gestandaardiseerde interface voor communicatie. Het bestaat uit twee kritieke, opkomende onderdelen: de AI Gateway en het Model Context Protocol (MCP).
De AI Gateway: Een Gecentraliseerd Control Plane
Een AI Gateway is gespecialiseerde middleware die dient als een enkel, gecentraliseerd controlepunt voor al het AI-gerelateerde verkeer tussen applicaties en de onderliggende AI-modellen. Geïmplementeerd binnen de on-premise omgeving, vaak op Kubernetes, biedt het een kritieke set functies om AI op ondernemingsschaal te beheren.
Geïntegreerde toegang en intelligente routing: De gateway biedt één consistent API-eindpunt voor ontwikkelaars. Dit neemt de complexiteit weg van de interactie met meerdere verschillende modellen (bijv. een mix van ge-finetunede open-source modellen en gespecialiseerde commerciële modellen). Het kan routering uitvoeren op basis van context, waarbij verzoeken worden doorgestuurd naar het meest geschikte model op basis van factoren zoals kosten, prestatie-eisen of de specifieke use-case, wat zowel de efficiëntie als de resultaten optimaliseert.
Robuuste beveiliging en governance: Voor on-premise AI is beveiliging van het hoogste belang. De AI Gateway fungeert als een punt waar beleid wordt afgedwongen (policy enforcement point), gecombineerd met de enterprise-beveiligingsarchitectuur om authenticatie, autorisatie en rolgebaseerde toegangscontrole (RBAC) te beheren. Het inspecteert zowel inkomende prompts als uitgaande antwoorden in real-time om prompt-injection-aanvallen en het lekken van gevoelige informatie zoals persoonlijk identificeerbare informatie (PII) te voorkomen. Dit waarborgt compliance met regelgeving zoals de AVG (GDPR) en HIPAA.
Uitgebreide observability en kostenbeheersing: De gateway biedt een geïntegreerd dashboard voor het monitoren van alle AI-interacties, waarbij sleutelmetrieken zoals latency, foutpercentages en token-gebruik worden bijgehouden. Deze gecentraliseerde observability is cruciaal voor probleemoplossing en prestatie-optimalisatie. Bovendien maakt het een gedetailleerde kostenbeheersing mogelijk door het afdwingen van op tokens gebaseerde rate limiting en gebruiksbudgetten. Dit voorkomt onverwacht hoge kosten en maakt een nauwkeurige doorberekening naar verschillende bedrijfseenheden mogelijk.
Het Model Context Protocol (MCP): De universele taal voor AI-agents
Waar de AI Gateway de stroom van verzoeken beheert, is het Model Context Protocol (MCP) een open standaard die een revolutie teweegbrengt in wat die verzoeken kunnen doen. MCP biedt een gestandaardiseerde manier voor AI-modellen om externe tools, data en services te ontdekken en ermee te interageren. Hierdoor veranderen ze van geïsoleerde "breinen" in bekwame, geïntegreerde agents.
Een gestandaardiseerde interface voor tools: In plaats van voor elke integratie kwetsbare maatwerkcode te bouwen, stelt MCP bedrijfssystemen (zoals databases, CRM's of interne API's) in staat om hun mogelijkheden bekend te maken via een lichtgewicht "MCP-server". De AI-toepassing, die fungeert als een "MCP-host", kan deze servers vervolgens bevragen om te begrijpen welke tools beschikbaar zijn en hoe deze moeten worden gebruikt. Zo wordt een plug-and-play ecosysteem voor AI-agents gecreëerd.
On-Premise Agentic AI mogelijk maken: Een belangrijk voordeel van MCP is dat het een open, controleerbaar protocol is dat volledig binnen de firewall van een organisatie kan worden geïmplementeerd. Dit stelt ondernemingen in staat om krachtige, autonome AI-agents te bouwen die veilig kunnen interageren met eigen interne systemen, zonder dat gevoelige data worden blootgesteld aan externe diensten.
Vendor Lock-in Voorkomen: Omdat MCP een model-agnostische standaard is die wordt ondersteund door grote spelers als Anthropic, OpenAI en Microsoft, ontkoppelt het het AI-model van de toolintegraties. Dit geeft enterprises de flexibiliteit om het onderliggende LLM te vervangen—bijvoorbeeld door over te stappen van een commerciële API naar een zelfgehost, fine-tuned model—zonder dat de volledige integratiestack opnieuw moet worden gebouwd, waardoor de technologische souvereiniteit behouden blijft.
Samen vormen de AI Gateway en MCP een krachtige controle- en applicatielaag die on-premise AI niet alleen mogelijk maakt, maar ook veilig, beheersbaar en echt geïntegreerd in de structuur van de enterprise.
De MCP Gateway van TrueFoundry combineert beide: governance en observability voor elk verzoek, plus veilige, geauditeerde tool-calling via MCP, zodat agents kunnen ageren op uw interne systemen zonder dat gegevens uw netwerk verlaten.
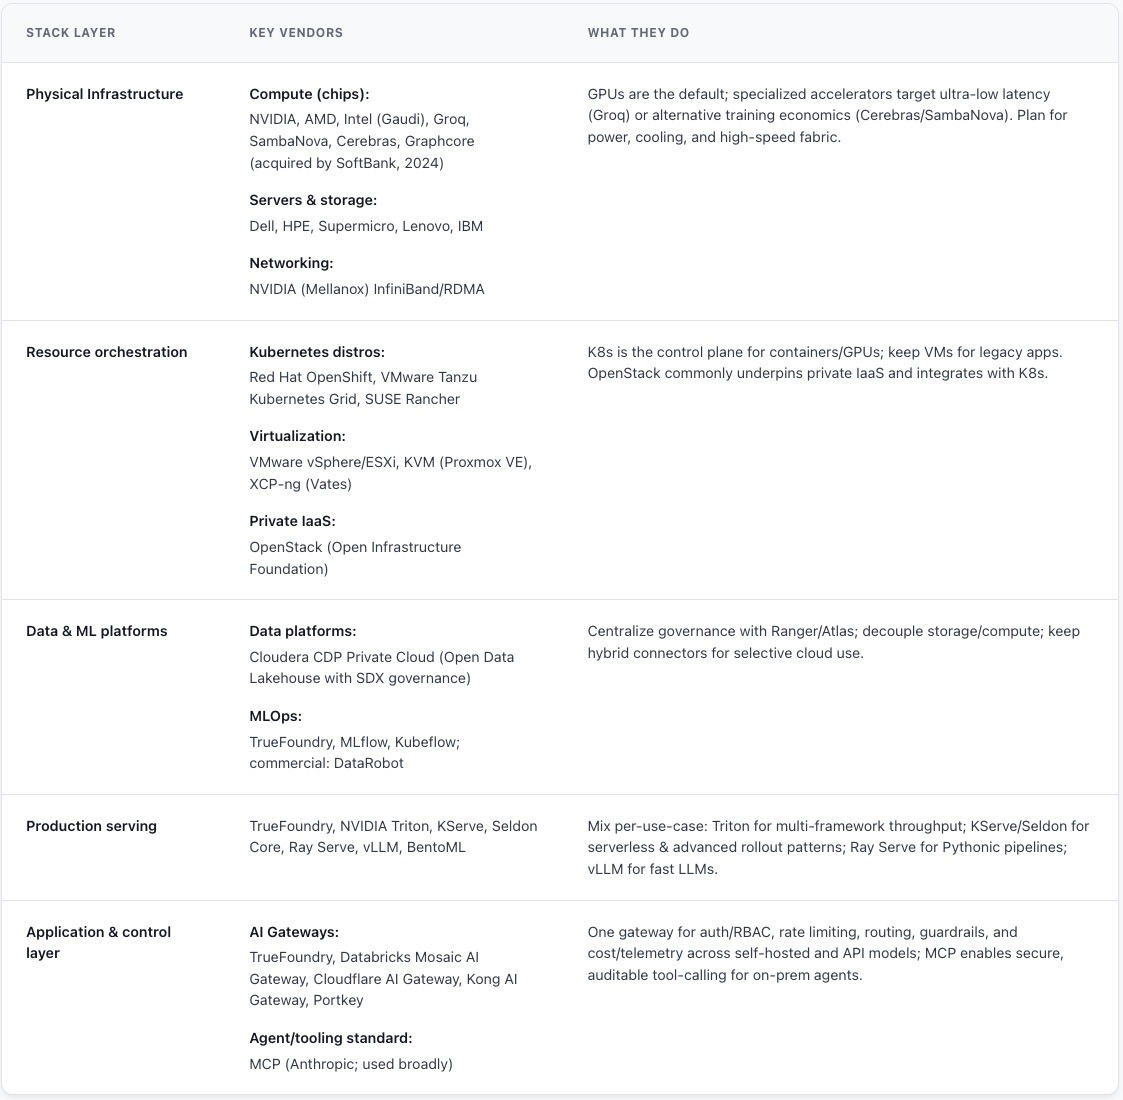
Vendor Mapping over de On-Premise AI Stack
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting