



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Nu de adoptie van machine learning in alle sectoren blijft versnellen, is de behoefte aan robuuste, schaalbare en geautomatiseerde ML-pipelines groter dan ooit. In 2026 zijn MLOps-platformen essentieel geworden voor het operationaliseren van AI, van modeltraining en deployment tot monitoring en governance.
Deze platformen stroomlijnen de volledige levenscyclus, waardoor teams complexiteit beter beheren, reproduceerbaarheid waarborgen en de time-to-value versnellen. Of u nu een startup bent die een eerste model schaalt of een onderneming die er honderden uitrolt, het kiezen van het juiste MLOps-platform is cruciaal.
In deze gids verkennen we wat MLOps inhoudt, waarom het belangrijk is en welke de beste MLOps-tools van 2026 zijn.
MLOps (Machine Learning Operations) is een discipline die de principes van machine learning, DevOps en data engineering combineert om de ontwikkeling, deployment, monitoring en het onderhoud van betrouwbare ML-systemen op schaal mogelijk te maken. Het zorgt ervoor dat modellen die in experimentele omgevingen zijn gebouwd, veilig en efficiënt kunnen worden overgezet naar productie, waar ze consistent moeten presteren, zich moeten aanpassen aan veranderingen en verantwoording moeten blijven afleggen.
Traditionele DevOps-workflows richten zich op versiebeheer, CI/CD-pipelines, geautomatiseerd testen en systeembetrouwbaarheid. MLOps erft deze principes, maar breidt ze uit om de unieke uitdagingen van machine learning aan te pakken: het beheren van voortdurend veranderende data, het hertrainen van modellen om drift op te vangen, het evalueren van niet-deterministische resultaten en het behouden van reproduceerbaarheid over verschillende modeliteraties.
Naarmate machine learning verschuift van experimenten naar implementatie op ondernemingsschaal, zijn MLOps-tools essentieel geworden om consistentie, betrouwbaarheid en snelheid in de gehele modellevenscyclus te garanderen. Zonder een gecentraliseerde MLOps-oplossing eindigen teams vaak met gefragmenteerde tools, handmatige processen en inconsistente workflows die innovatie vertragen en operationele risico's met zich meebrengen.
MLOps-platformen lossen deze uitdagingen op door een geünificeerde interface te bieden voor het beheren van datapipelines, trainingsworkflows, modeltracking, deployment en monitoring, allemaal op één plek. Deze consolidatie maakt nauwere samenwerking mogelijk tussen data scientists, ML engineers en DevOps-teams, waardoor overdrachtsproblemen verminderen en de reproduceerbaarheid tussen omgevingen verbetert.
Bij het selecteren van MLOps-tools in 2026 is het belangrijk om niet alleen naar functionaliteiten te kijken, maar ook naar hoe goed het platform uw ML-workflow ondersteunt, meeschaalt met uw infrastructuur en aansluit bij de operationele doelen van uw team. Hieronder vindt u enkele essentiële criteria om te overwegen:
Een ideaal MLOps-platform moet de volledige machine learning-levenscyclus dekken, van dataversiebeheer en training tot deployment en monitoring. Gefragmenteerde toolchains kunnen leiden tot inefficiëntie en inconsistenties tussen teams. Platformen die deze fasen groeperen in één enkele workflow helpen de reproduceerbaarheid te verbeteren, overdrachtsmomenten te verminderen en iteraties te versnellen.
Wanneer ML-workloads schalen, moet het platform meegroeien. Een goede MLOps-oplossing moet alles ondersteunen, van lokale experimenten tot gedistribueerde training over meerdere GPU's of nodes. Het moet ook flexibiliteit bieden bij de uitrol door cloud-native, on-premise en hybride omgevingen te ondersteunen, zonder dat u vastzit aan een specifieke stack.
Gebruiksvriendelijkheid wordt vaak over het hoofd gezien, maar is cruciaal. Een sterk platform biedt overzichtelijke interfaces (zowel UI als CLI), samen met uitgebreide SDK's die integreren met populaire frameworks zoals PyTorch, TensorFlow en Hugging Face. Een platform dat intuïtief werkt voor zowel data scientists als ML engineers bevordert een betere samenwerking en een snellere onboarding.
MLOps staat niet op zichzelf. Uw platform moet naadloos integreren met bestaande systemen voor opslag (zoals S3 of GCS), CI/CD-tools (zoals GitHub Actions of Jenkins), observabiliteitsplatformen (zoals Prometheus of Grafana) en modelregistries. Een sterke integratie zorgt voor een soepele stroom van data en modellen door uw gehele pipeline.
Voor organisaties die in gereguleerde omgevingen werken, zijn governance-functionaliteiten onmisbaar. Het platform moet role-based access control (RBAC), audit logs en lineage tracking ondersteunen. Naleving van standaarden zoals SOC 2, HIPAA of GDPR helpt de privacy van data, het vertrouwen en de haalbaarheid op lange termijn binnen ondernemingen te waarborgen.
Het MLOps-landschap in 2026 is rijk aan platformen die inspelen op verschillende behoeften, van lichtgewicht experimenttracking tot modeldeployment en monitoring op ondernemingsniveau. Hieronder staan de 25 beste MLOps-tools die teams helpen hun ML-workflows te stroomlijnen, infrastructuur te optimaliseren en modellen op schaal te operationaliseren. Elk platform heeft zijn eigen sterke punten, afhankelijk van uw tech stack, teamvolwassenheid en bedrijfsdoelen.
TrueFoundry is een modern MLOps- en LLMOps-platform gebouwd voor teams die machine learning- en generatieve AI-modellen in productie willen deployen, schalen en monitoren. Het abstraheert infrastructuurcomplexiteit en biedt tegelijkertijd volledige controle, waardoor teams in enkele minuten kunnen overstappen van experimenten naar deployment.
In tegenstelling tot traditionele systemen is TrueFoundry geoptimaliseerd voor prestaties, ontwikkelaarsproductiviteit en GenAI-first workflows, inclusief ondersteuning voor agents, RAG-pipelines en geavanceerde tracing. De beveilging op ondernemingsniveau en het modulaire ontwerp maken het een van de beste MLOps-tools, geschikt voor organisaties van elke omvang.
Belangrijkste kenmerken:
Het beste voor:
AI-gestuurde teams die op LLM gebaseerde producten bouwen, vooral waar prestaties, beveiliging en observabiliteit cruciaal zijn. Uitstekend geschikt voor snel bewegende teams of ondernemingen die schaalbare GenAI-deployment nodig hebben. Bekijk hier enkele van de beste LLM gateway-tools.
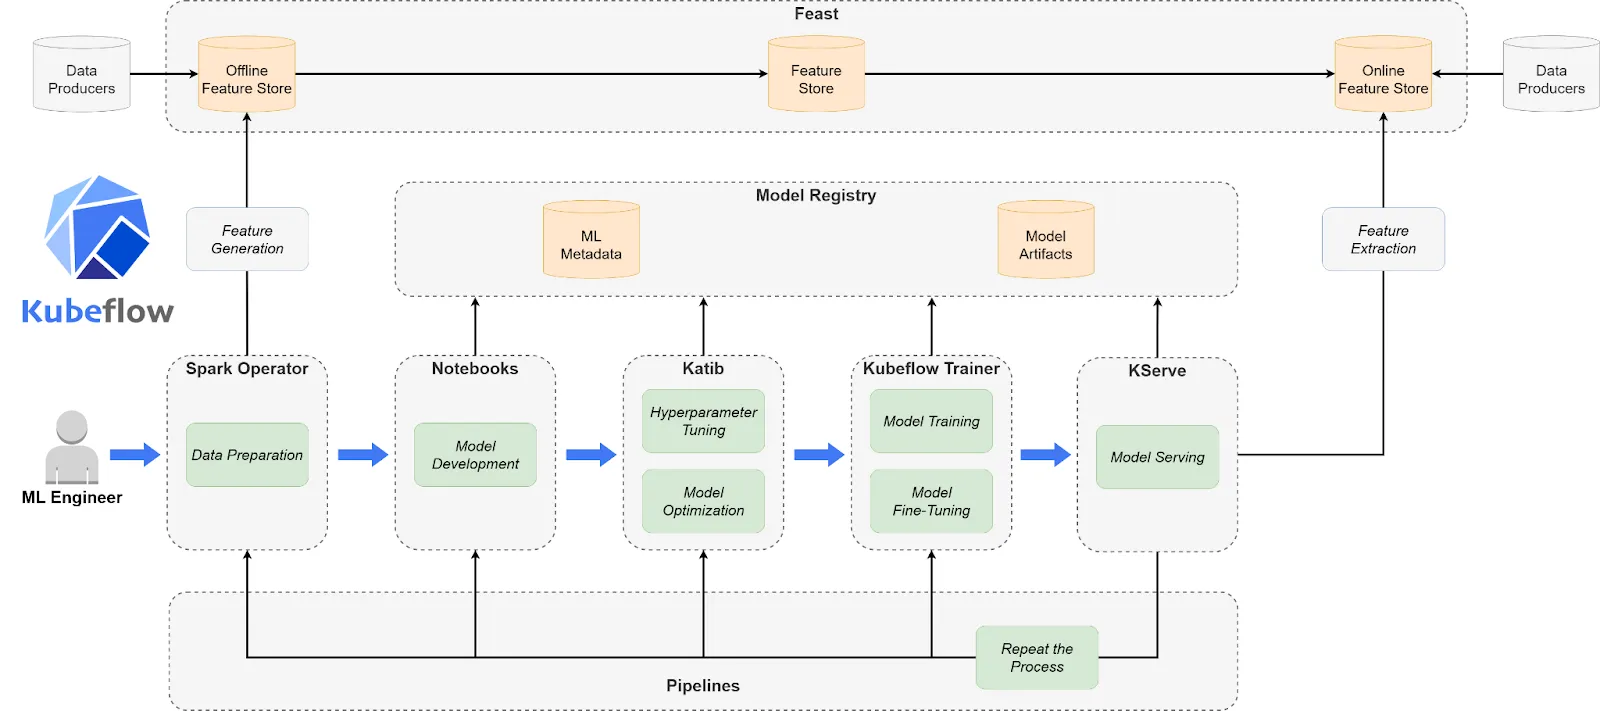
Kubeflow is een Kubernetes-native, open-source en een van de beste MLOps-tools voor het bouwen en beheren van overdraagbare, samenstelbare ML-workflows. Het biedt de flexibiliteit om training, tuning en serving te orkestreren met vertrouwde Kubernetes-abstracties. Hoewel krachtig, vereist Kubeflow diepgaande kennis van infrastructuur en is het niet ideaal voor teams zonder toegewijde DevOps-ondersteuning. Het blinkt uit wanneer aangepaste, schaalbare en veilige ML-pipelines noodzakelijk zijn.
Belangrijkste kenmerken:
Het beste voor:
Teams met sterke Kubernetes-expertise die hun MLOps-workflows volledig willen aanpassen en beheren, met name in gereguleerde of hybride cloudomgevingen.
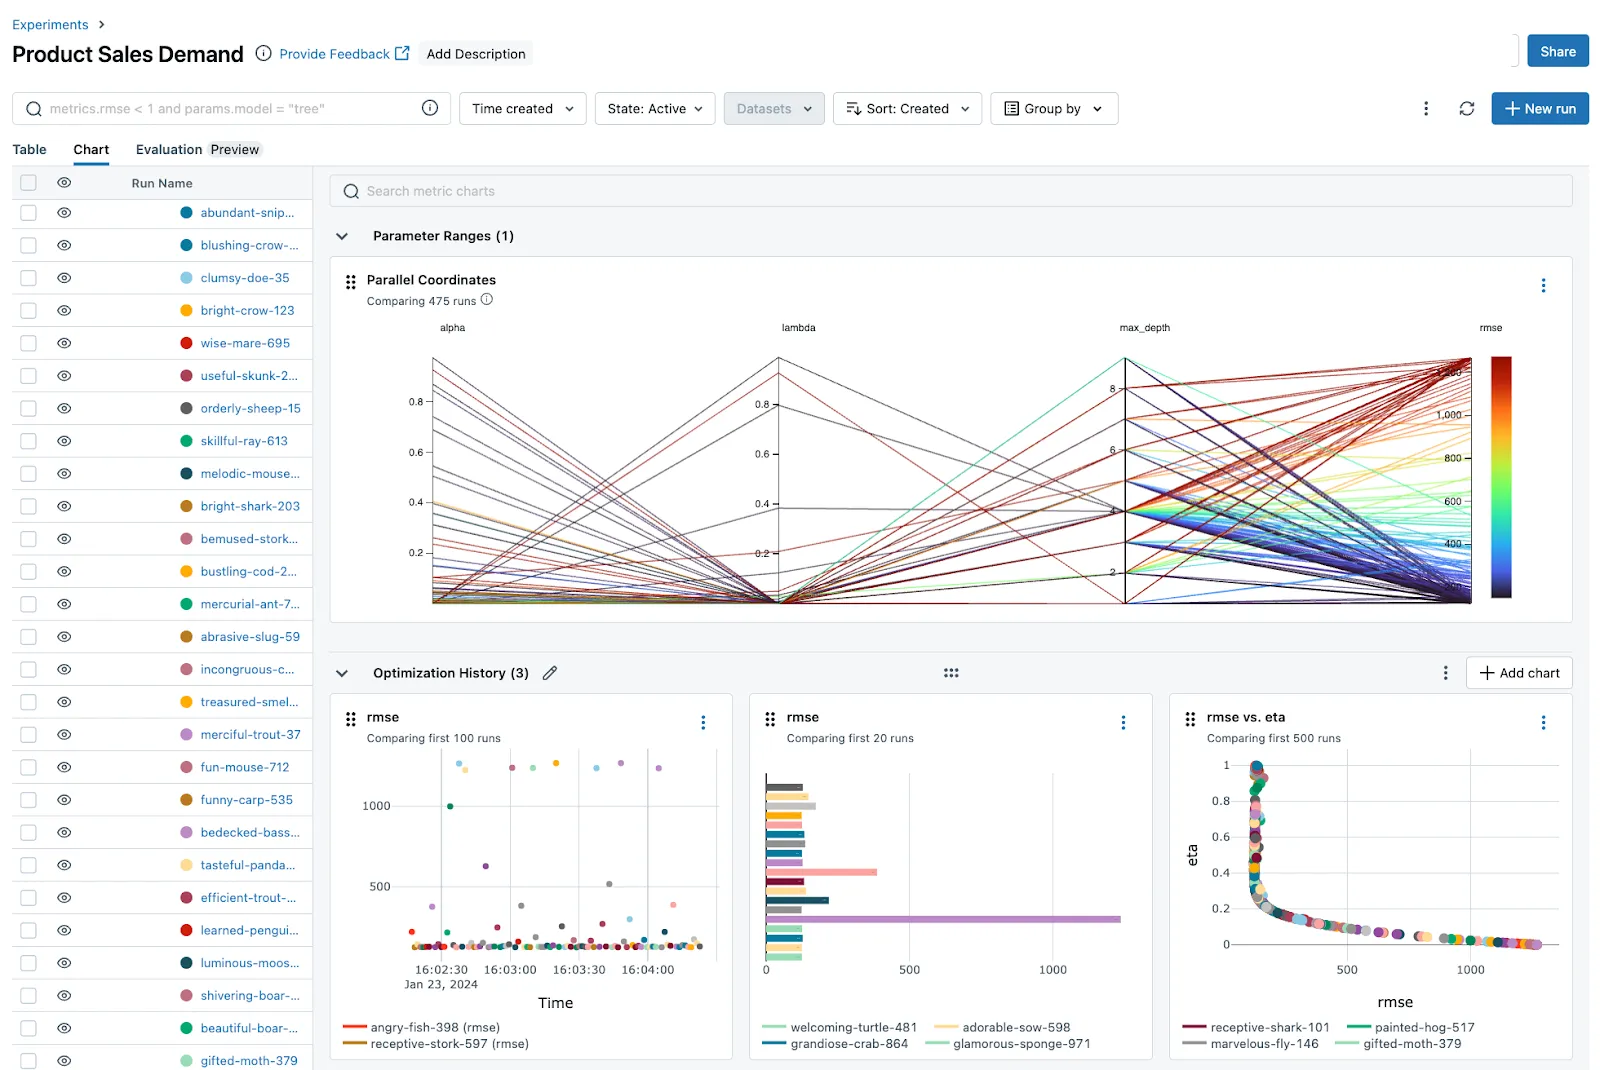
MLflow is een lichtgewicht, open-source MLOps-platform gemaakt door Databricks, gericht op het beheren van ML-experimenten en modelversiebeheer. Dankzij de modulaire componenten kunnen teams tracking, registry en deployment integreren in hun bestaande workflows.
Deze MLOps-tool is ideaal voor kleinere teams of organisaties die flexibiliteit willen zonder de overhead van een volledige infrastructuur of Kubernetes.
Belangrijkste kenmerken:
Het beste voor:
ML-teams die op zoek zijn naar lichtgewicht, aanpasbare tooling voor het volgen van experimenten, het delen van modellen en het beheren van versies, zonder afhankelijk te zijn van een grootschalig platform.
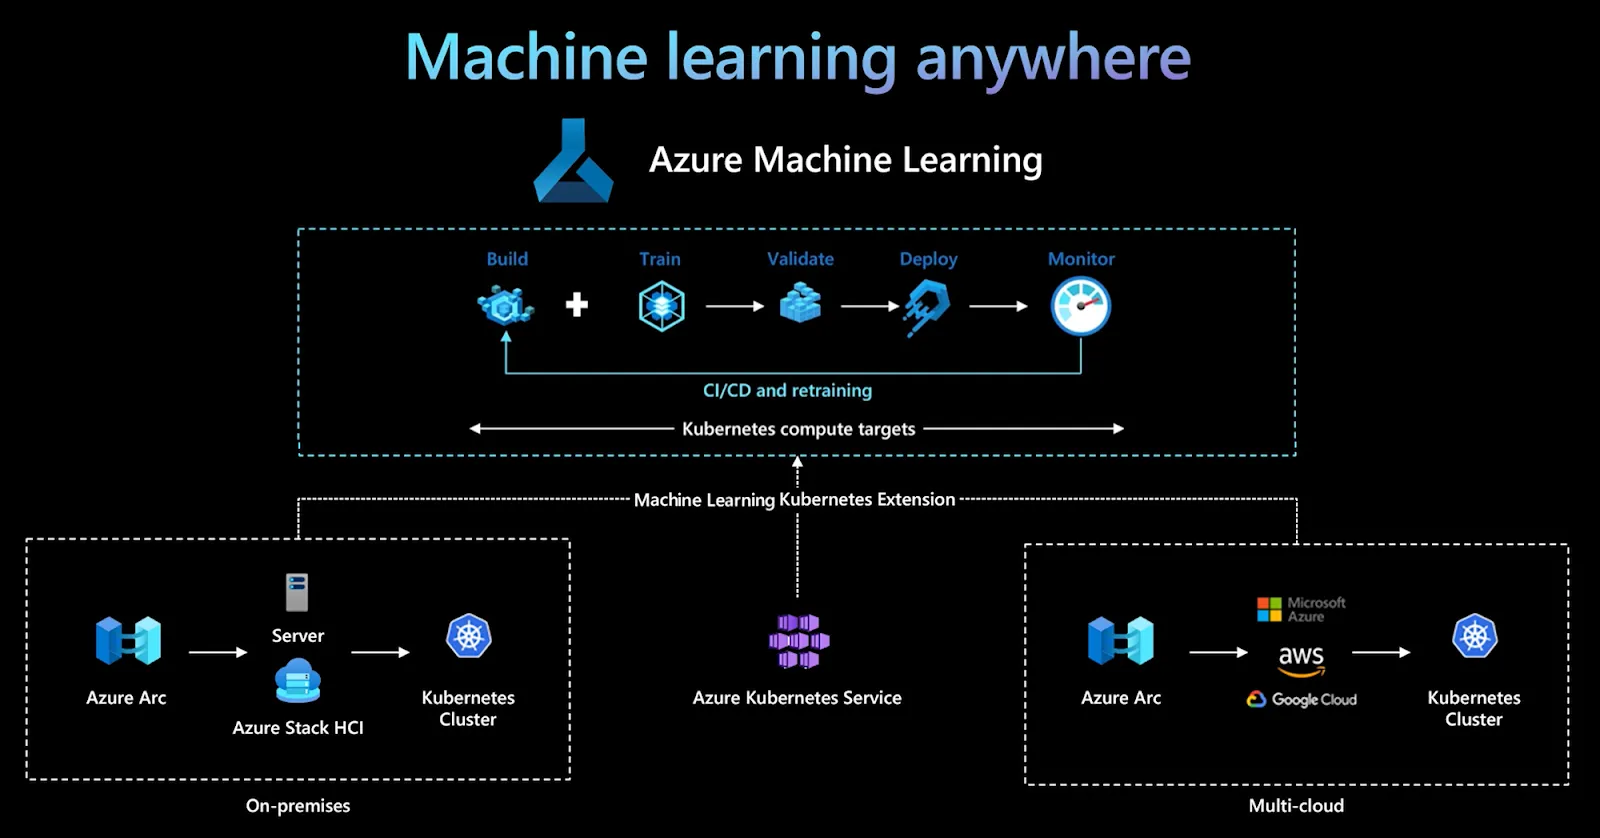
Azure Machine Learning is het volledig beheerde MLOps-platform van Microsoft, ontworpen voor het bouwen, trainen, deployen en monitoren van machine learning-modellen op ondernemingsschaal. Het integreert nauw met het Azure-ecosysteem en biedt een krachtige suite aan tools voor modelbeheer, AutoML en verantwoorde AI. Azure ML is ideal voor organisaties die al investeren in de cloud van Microsoft en zoeken naar beveiliging, schaalbaarheid en compliance.
Belangrijkste kenmerken:
Het beste voor:
Ondernemingen die werken op Microsoft Azure en een zeer veilige, schaalbare en volledig geïntegreerde MLOps-platform nodig hebben met ingebouwde enterprise compliance.
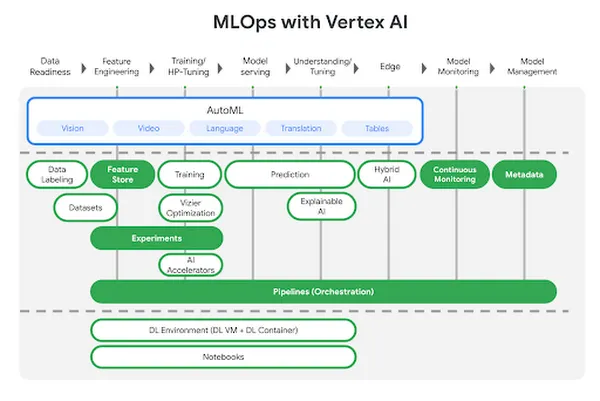
Vertex AI is het geünificeerde platform van Google Cloud voor ML-ontwikkeling, waarin AutoML en aangepaste modeltraining worden gecombineerd in één interface. Het abstraheert de infrastructuur en biedt tevens geavanceerde diensten zoals feature stores, pipelines en experimenttracking.
Gebouwd voor schaalbaarheid en integratie met het Google-ecosysteem, is deze MLOps-tool geoptimaliseerd voor ML-deployments op productieniveau en datagestuurde workflows.
Belangrijkste kenmerken:
Het beste voor:
Teams die machine learning bouwen en schalen op Google Cloud en een beheerd, schaalbaar MLOps-platform willen met volledige data- en deploymentintegratie.
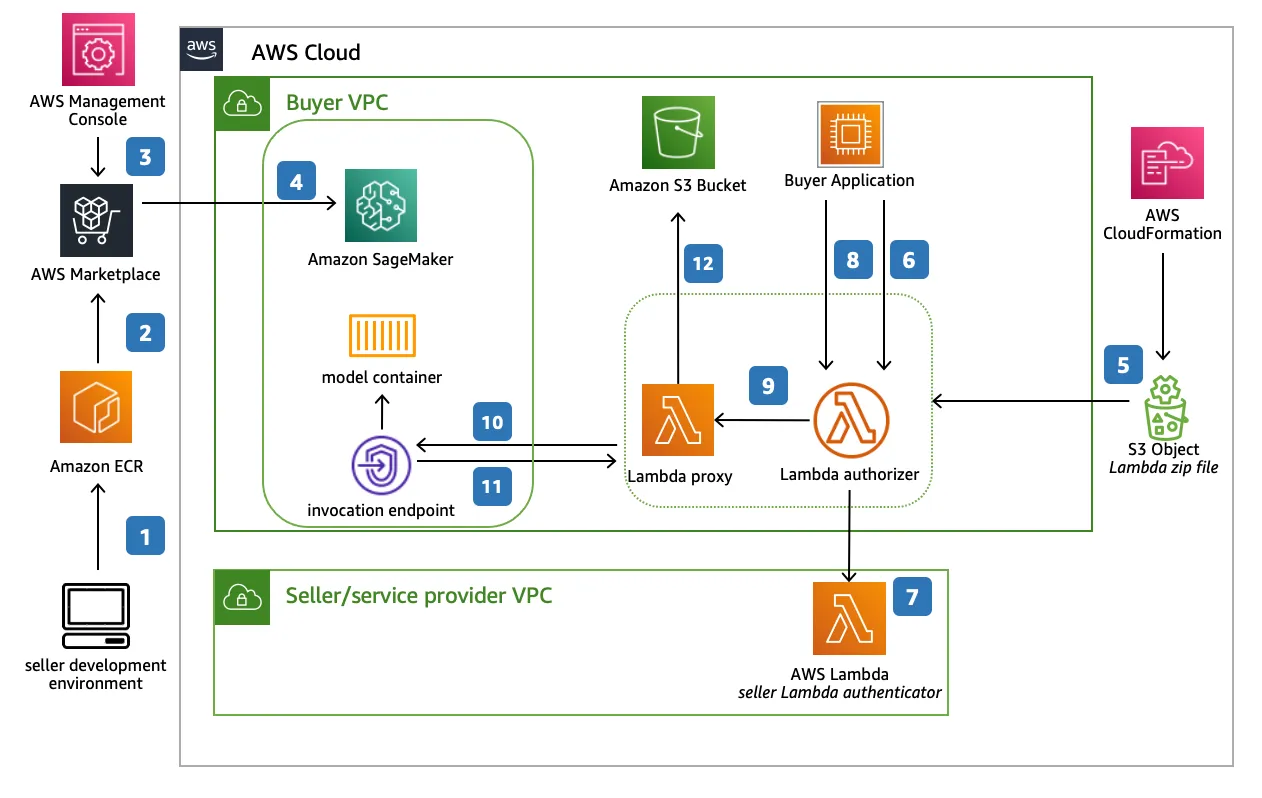
Amazon SageMaker is het vlaggenschip MLOps-platform van AWS dat alles biedt van datavoorbereiding tot realtime modeldeployment. Bekend om zijn brede functionaliteit, ondersteunt SageMaker aangepaste modelontwikkeling, AutoML, modelhosting en geavanceerde monitoringtools. Het is nauw geïntegreerd met het AWS-ecosysteem, wat het een logische keuze maakt voor cloud-native ondernemingen.
Belangrijkste kenmerken:
Het beste voor:
Organisaties die AWS al gebruiken voor infrastructuur en een robuust, schaalbaar MLOps-platform nodig hebben met diepe integratie en ondersteuning voor de volledige levenscyclus.
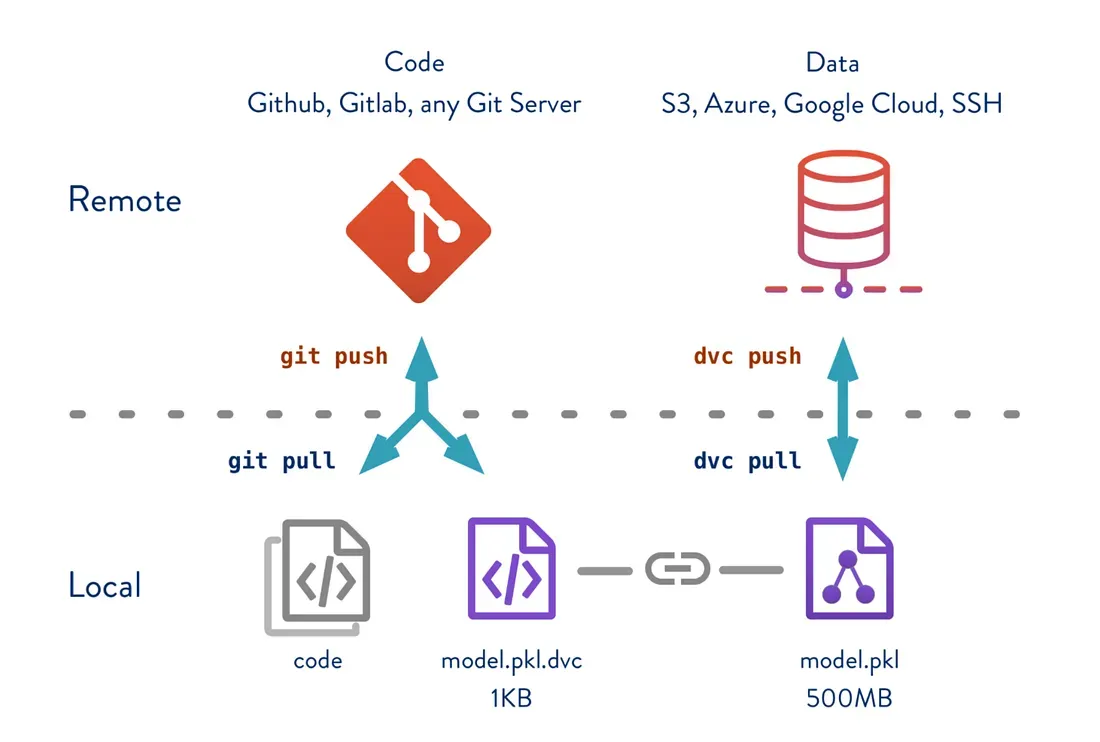
DVC is een open-sourcetool die versiebeheer naar machine learning-projecten brengt door datasets, modellen en experimenten te volgen — vergelijkbaar met hoe Git code beheert. Het streeft er niet naar om een full-stack MLOps-platform te zijn, maar richt zich in plaats daarvan op reproduceerbaarheid, samenwerking en modeltracking via Git-compatibele workflows. DVC integreert naadloos in bestaande pipelines en geeft ML-professionals meer controle over experimentbeheer.
Belangrijkste kenmerken:
Het beste voor:
Teams die op zoek zijn naar lichtgewicht, code-first MLOps-functionaliteiten die gericht zijn op reproduceerbaarheid, op Git gebaseerde workflows en experimentbeheer — vooral in onderzoek en iteratieve ML-projecten.
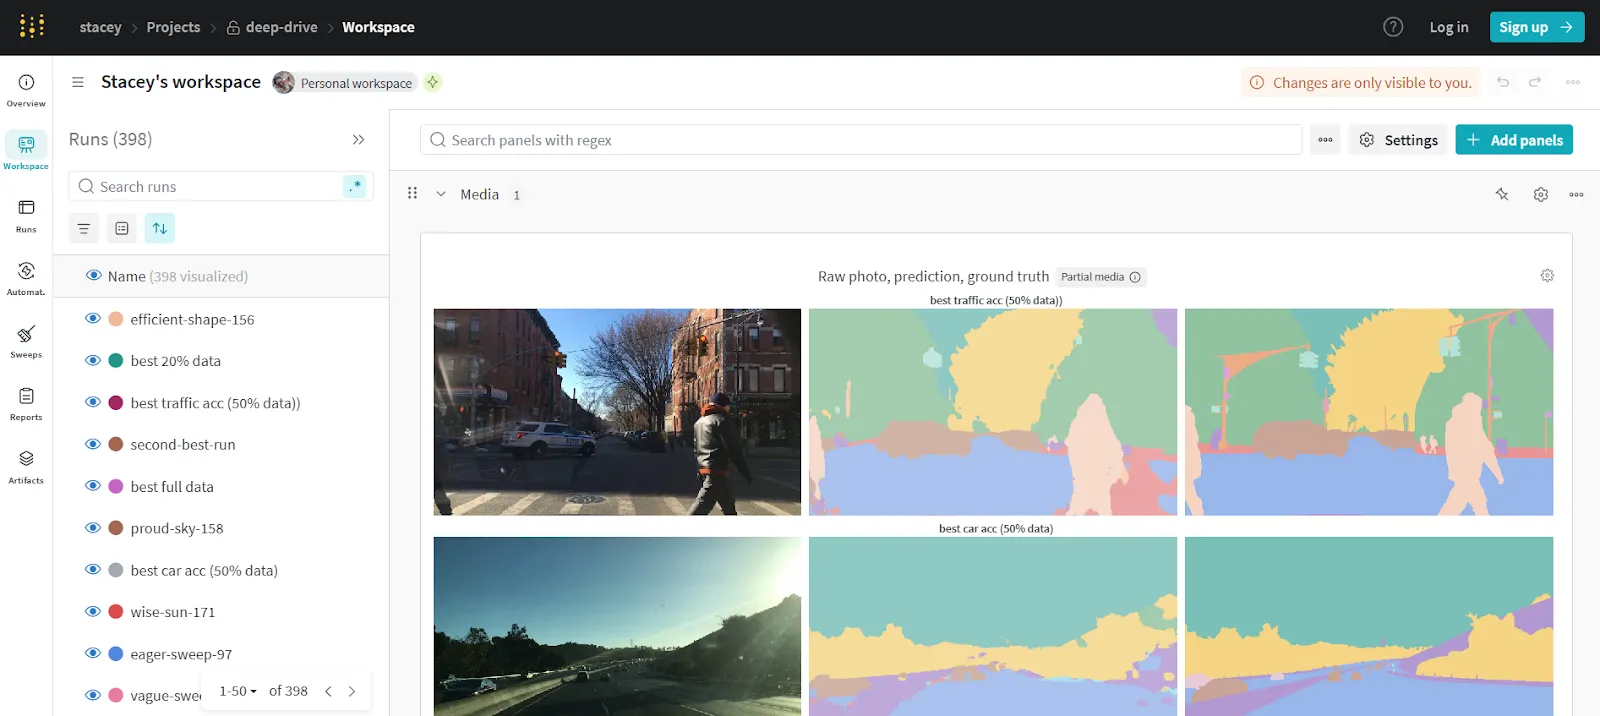
Weights & Biases (W&B) is een van de beste MLOps-tools voor experimenttracking, samenwerking en modelvisualisatie. Het wordt breed toegepast in zowel onderzoeks- als productieomgevingen en biedt eenvoudige integratie met de meeste ML-frameworks. W&B richt zich op observabiliteit, wat realtime inzicht geeft in trainingsprestaties, hyperparameter tuning en systeemmetrieken.
Belangrijkste kenmerken:
Het beste voor:
ML-teams die gericht zijn op snelle iteratie, visualisatie en samenwerking. Ideal voor onderzoeksgedreven omgevingen en teams die beter inzicht willen in trainingsprestaties.
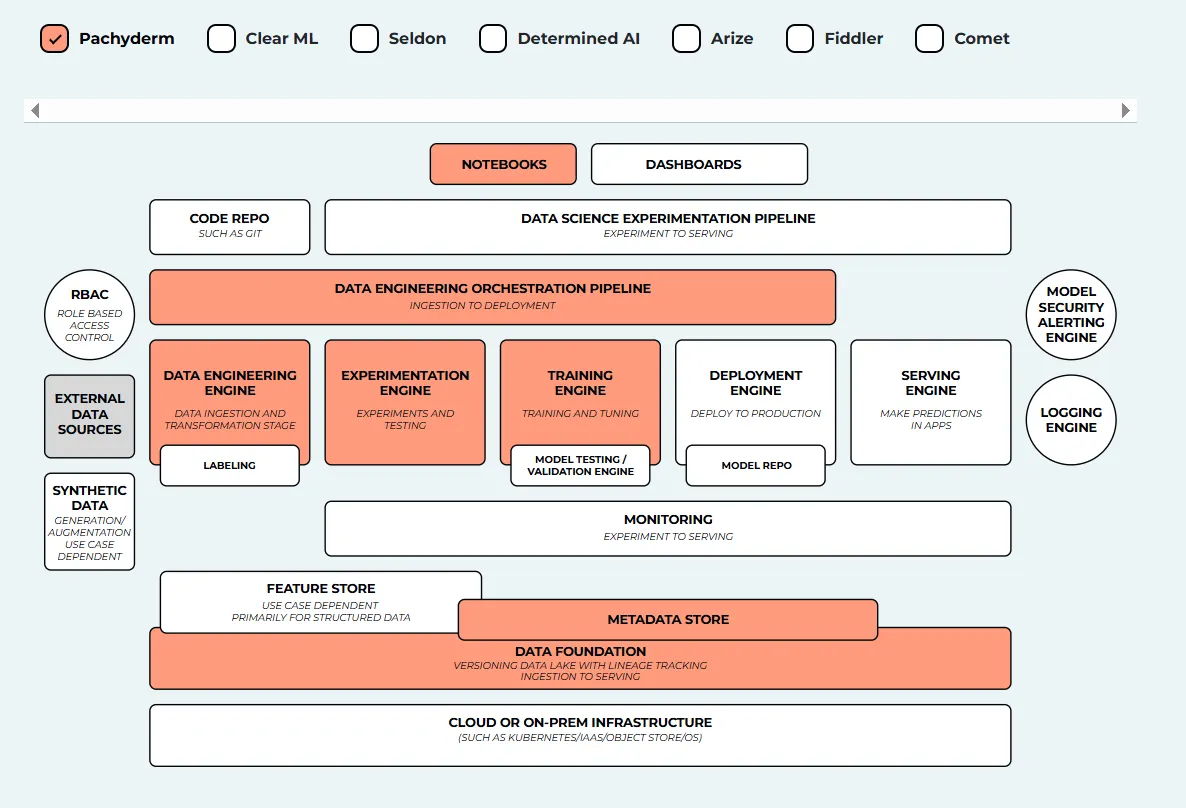
Pachyderm is een open-source data science-platform gebouwd voor data lineage, versiebeheer en reproduceerbare pipelines. In tegenstelling tot traditionele MLOps-tools gebruikt Pachyderm een Git-achtige aanpak voor data, waardoor het zeer geschikt is voor teams die complexe data-afhankelijkheden of gereguleerde omgevingen beheren. Het combineert containerisatie met orkestratie van datapipelines om gecertificeerde, traceerbare workflows te garanderen.
Belangrijkste kenmerken:
Het beste voor:
Teams in gereguleerde sectoren of dataintensieve workflows die sterk versiebeheer en lineage tracking nodig hebben voor compliance, reproduceerbaarheid en schaal.
Allegro AI is een MLOps-platform dat specifiek is ontworpen voor het beheren van deep learning-workflows op schaal — met name in computer vision- en edge AI-omgevingen. Het richt zich op het verbeteren van de reproduceerbaarheid, samenwerking en traceerbaarheid gedurende de AI-levenscyclus.
Met sterke mogelijkheden op het gebied van datasetbeheer, modelversiebeheer en experimenttracking biedt deze MLOps-tool een veilige, end-to-end infrastructuur voor teams die hoogwaardige modellen bouwen en inzetten in productie- of gereguleerde omgevingen.
Belangrijkste kenmerken:
Het beste voor:
Teams die werken aan computer vision, deep learning of edge deployment-toepassingen — vooral in sectoren zoals automotive, productie, gezondheidszorg of defensie, waar traceerbaarheid en controle over data en modellen essentieel zijn.
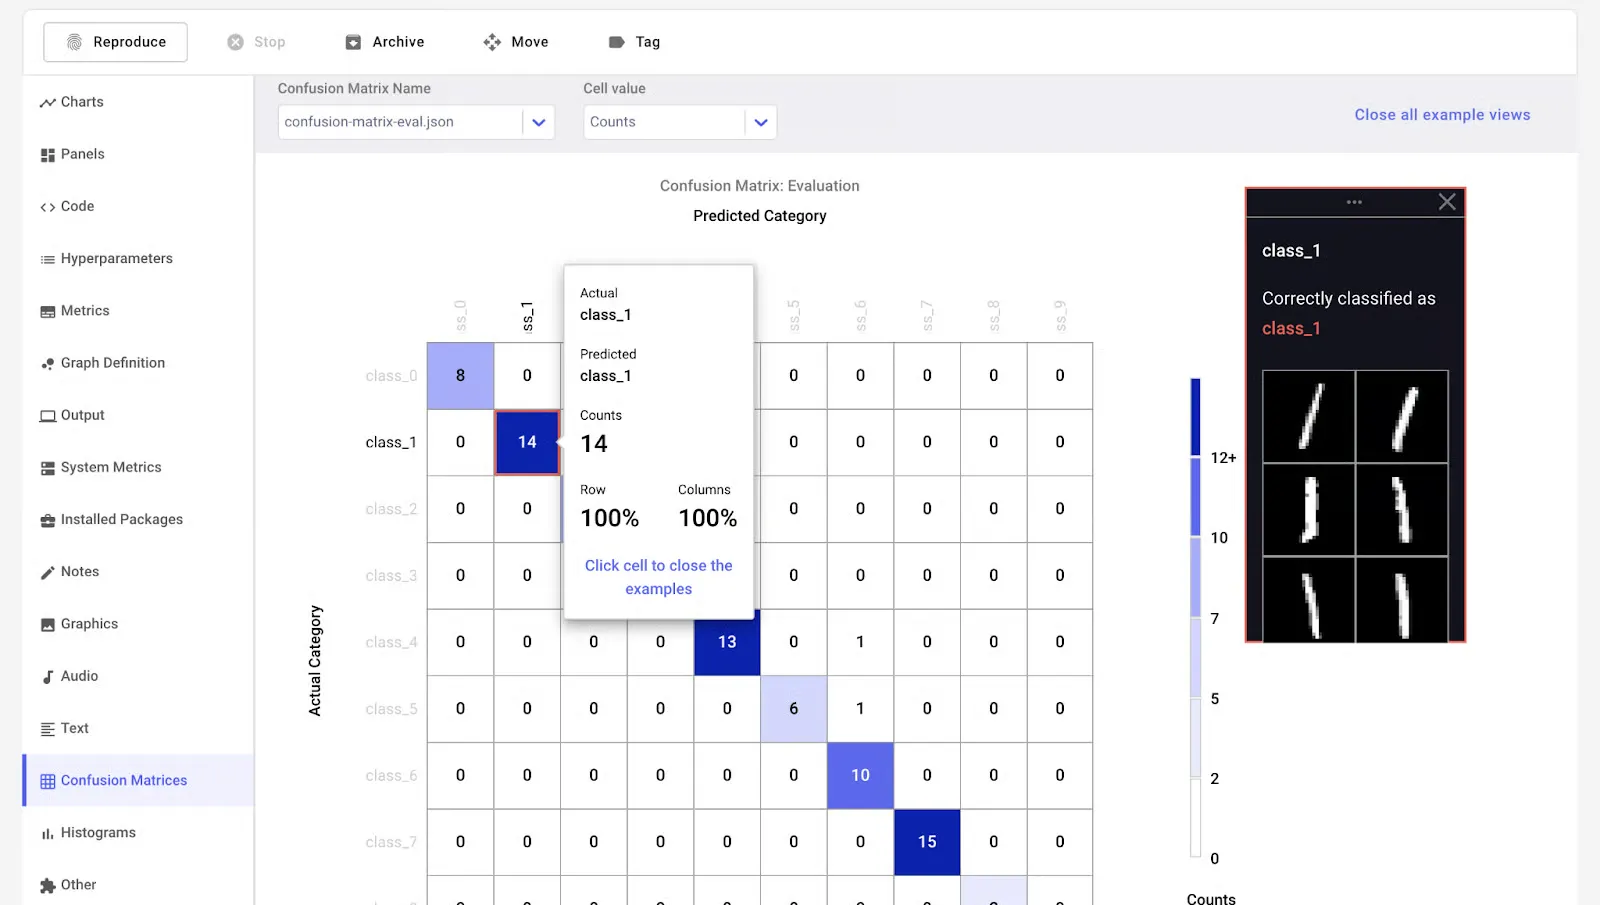
Comet ML is een machine learning-platform ontworpen om u te helpen bij het monitoren, analyseren en verfijnen van modellen en experimenten. Het werkt naadloos samen met populaire bibliotheken zoals Scikit-learn, PyTorch, TensorFlow en Hugging Face.
De Comet MLOps-tool maakt het eenvoudig om resultaten van experimenten te verkennen en te vergelijken, terwijl het ook rijke visualisaties biedt voor datasamples, waaronder afbeeldingen, audio, tekst en gestructureerde tabellen.
Belangrijkste kenmerken:
Het beste voor:
Het beste voor data scientists, machine learning engineers en teams die een eenvoudige manier zoeken om experimenten te volgen, resultaten te vergelijken en modelprestaties te verbeteren.
Prefect is een moderne tool voor workflow-orkestratie, ontworpen om datapipelines over toepassingen heen te monitoren, te coördineren en te beheren. Het is een open-source, lichtgewicht oplossing die is gebouwd om end-to-end machine learning- en data-workflows te ondersteunen.
U kunt de Prefect Orion UI of Prefect Cloud gebruiken voor het beheren en visualizeren van workflows. Prefect Orion UI is een open-source, lokaal gehoste orkestratie-engine en API-server die inzicht geeft in lokale workflow-runs en systeemactiviteit.
Prefect Cloud daarentegen is een gehoste service waarmee u flows, runs en deployments kunt visualizeren, terwijl u tevens accounts, werkruimten en teamsamenwerking beheert.
Belangrijkste kenmerken:
Het beste voor:
Data engineers, ML engineers en teams die betrouwbare workflow-orkestratie, inzicht in pipelines en schaalbare samenwerking nodig hebben voor data- en machine learning-projecten.
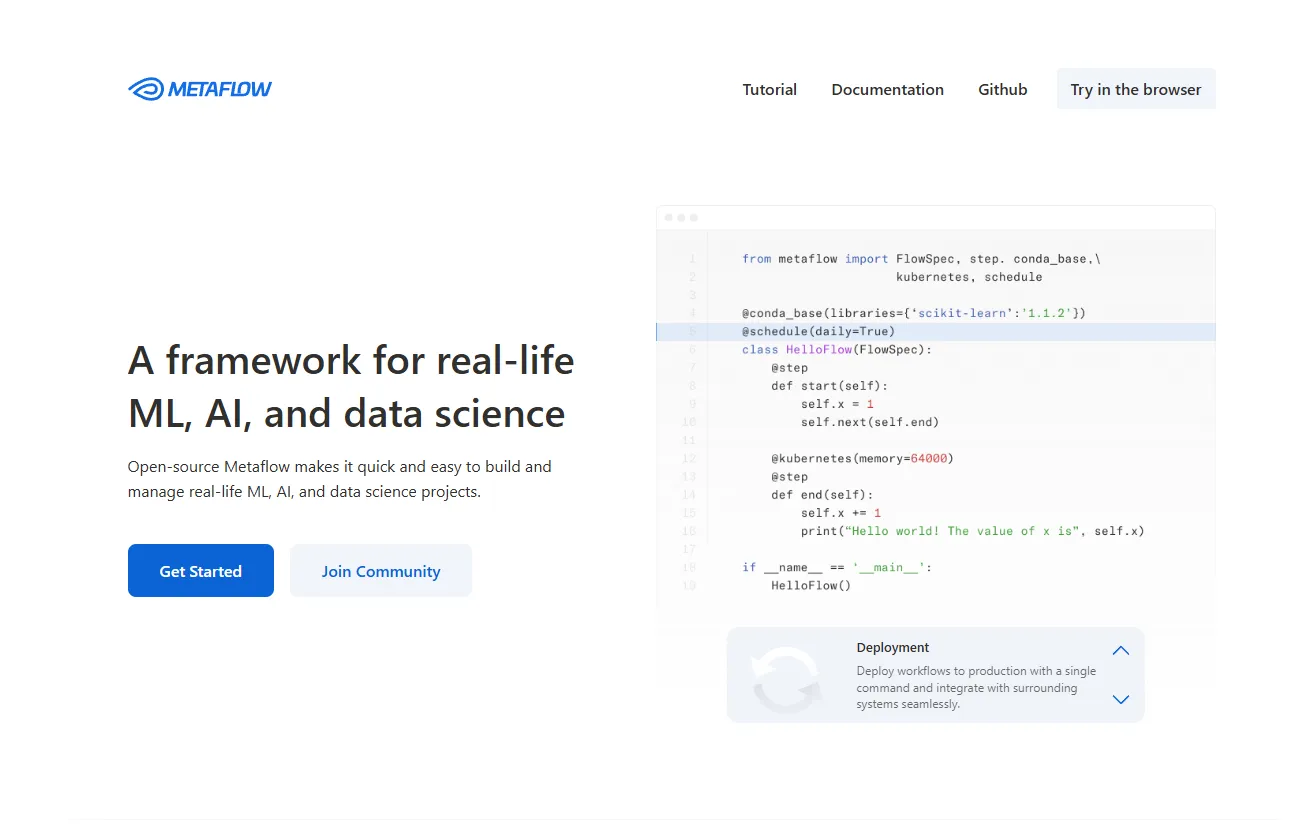
Metaflow is een workflowbeheertool voor data science en machine learning die het bouwen, uitvoeren en deployen van modellen vereenvoudigt. Deze MLOps-tool helpt teams pipelines op schaal te beheren, terwijl experimenttracking, dataversiebeheer en productie-deployment automatisch worden afgehandeld.
Belangrijkste kenmerken:
Het beste voor:
Data scientists en ML-teams die een eenvoudige, schaalbare workflowtool willen die orkestratie, tracking en deployment afhandelt en tegelijkertijd de MLOps-overhead minimaliseert.
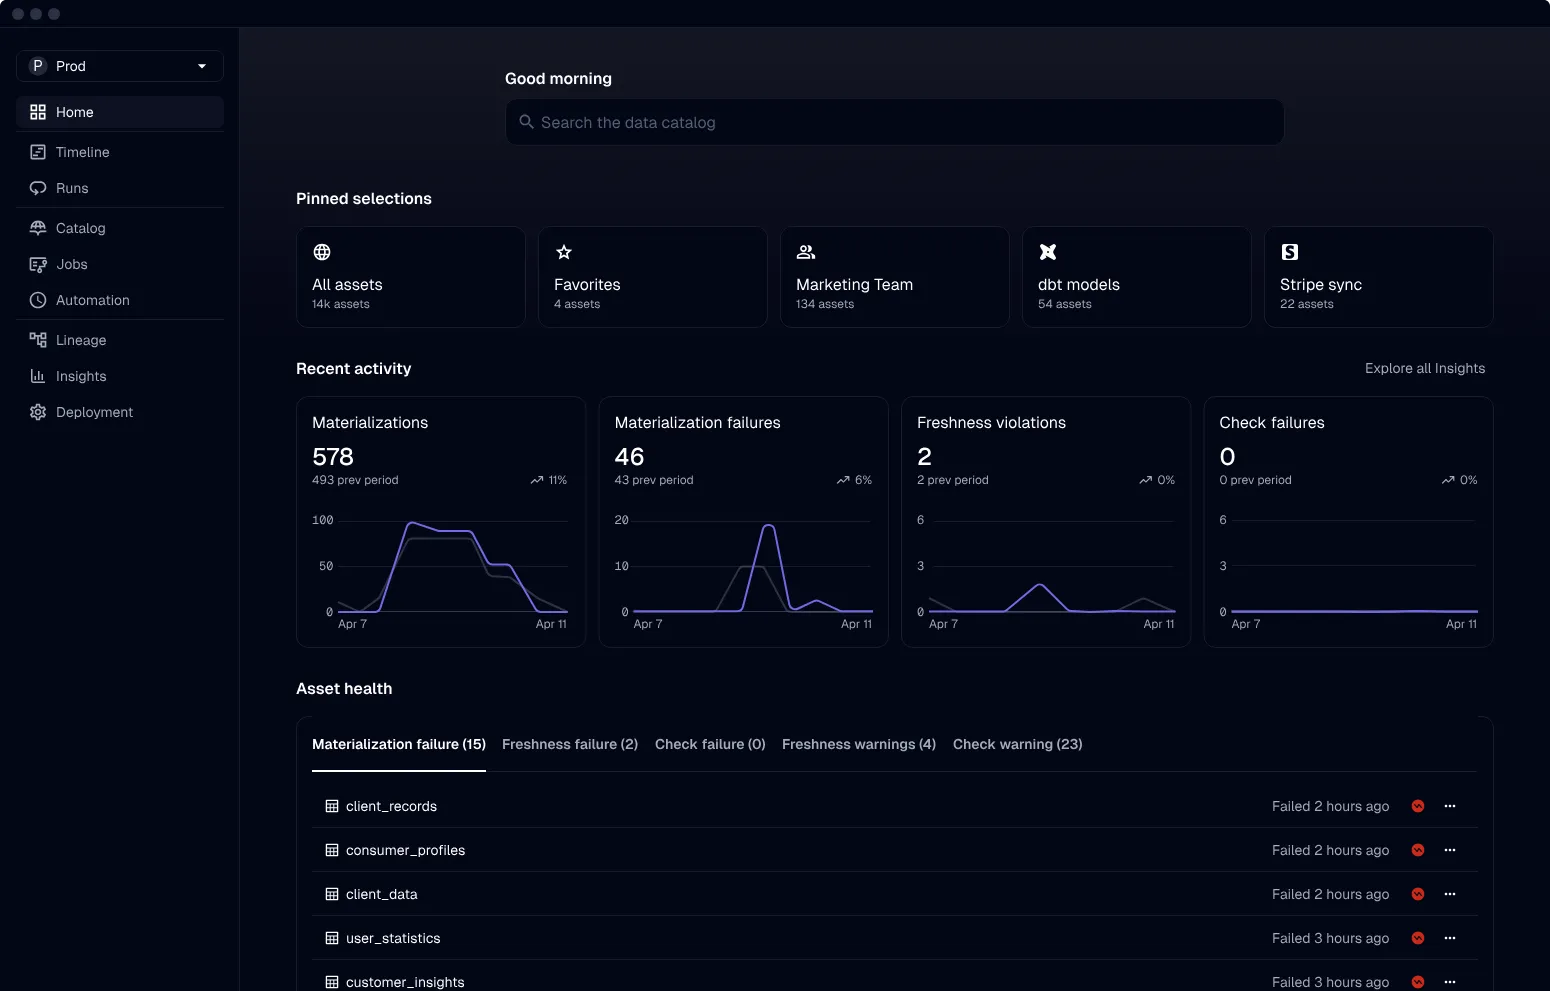
Dagster is een cloud-native orkestratieplatform dat datateams helpt complexe datapipelines efficiënt te definiëren, uit te voeren en te monitoren. Het richt zich op betrouwbaarheid, observabiliteit en een moderne ontwikkelervaring voor het beheren van data-workflows.
Belangrijkste kenmerken:
Het beste voor:
Data-engineers en datateams die behoefte hebben aan betrouwbare, testbare en meetbare datapipeline-orchestratie met sterke integratieondersteuning en een moderne ontwikkelworkflow.
Kedro is een op Python gebaseerde tool voor workflow-orchestratie die helpt bij het bouwen van reproduceerbare, onderhoudbare en modulaire data science-projecten. Het brengt best practices uit de software-engineering, zoals modulariteit, scheiding van taken en versiebeheer, naar machine learning-workflows.
Belangrijkste kenmerken:
Het beste voor:
Data scientists en teams die gestructureerde, onderhoudbare en reproduceerbare data science-workflows willen met behulp van best practices uit de software-engineering.
TruEra is een platform dat gericht is op het verbeteren van de kwaliteit van machine learning-modellen door middel van testen, uitlegbaarheid en oorzaak-analyse. Deze MLOps-tool helpt teams bij het debuggen van modellen, het begrijpen van prestatieproblemen en het waarborgen van eerlijkheid gedurende de gehele ML-levenscyclus.
Belangrijkste kenmerken:
Het beste voor:
ML-engineers, data scientists en organisaties die diepere modelinzichten, eerlijkheidscontroles en betrouwbare prestatiemonitoring gedurende de modellevenscyclus nodig hebben.
BentoML is een Python-first platform dat het uitrollen, serveren en monitoren van machine learning-modellen in productie vereenvoudigt. Het helpt teams ML-applicaties sneller op te leveren met schaalbare, hoogwaardige model-serving.
Belangrijkste kenmerken:
Het beste voor:
ML-engineers en teams die een snelle, schaalbare en betrouwbare manier nodig hebben om machine learning-modellen in productie-omgevingen uit te rollen en te beheren.
Evidently AI is een open-source Python-bibliotheek voor het monitoren van machine learning-modellen tijdens ontwikkeling, validatie en productie. Het helpt de data- en modelkwaliteit te waarborgen door drift, prestatieproblemen en andere potentiële problemen te detecteren.
Het beste voor:
Best for:
Data scientists en ML-engineers die betrouwbare modelmonitoring, driftdetectie en prestatiedetectie nodig hebben gedurende de gehele ML-levenscyclus.
DagsHub is een samenwerkingsplatform voor machine learning-projecten dat teams helpt bij het bijhouden, versieren en beheren van data, modellen, experimenten, pipelines en code op één plek. Het wordt vaak omschreven als "GitHub voor machine learning" en biedt tools om de end-to-end ML-workflow te stroomlijnen.
Belangrijkste kenmerken:
Het beste voor:
ML-teams en organisaties die een samenwerkingsgerichte, via versiebeheer gestuurde omgeving nodig hebben om de volledige machine learning-levenscyclus te beheren met sterke integratie- en reproduceerbaarheidsondersteuning.
Het Iguazio MLOps Platform is een end-to-end oplossing die de gehele machine learning-levenscyclus automatiseert, van dataingestie en -preparatie tot training, uitrol en productiemonitoring. Deze MLOps-tool biedt zowel een open-source framework (MLRun) als een volledig beheerd platform, met flexibele uitrol in cloud-, hybride of on-premise omgevingen.
Belangrijkste kenmerken:
Het beste voor:
Grote ondernemingen en gereguleerde sectoren (bijv. gezondheidszorg, financiën) die een flexibel, schaalbaar en beheerd MLOps-platform nodig hebben met sterke automatisering en controle over uitrol.
Qdrant is een open-source vector-database en similarity search-engine waarmee u vector-embeddings kunt opslaan, beheren en bevragen via een productieklare service en een eenvoudige API. Het is ontworpen voor hoogwaardige semantische zoekopdrachten en AI-gestuurde applicaties.
Belangrijkste kenmerken:
Het beste voor:
Ontwikkelaars en ML-teams die semantic search, aanbevelingssystemen en AI-applicaties bouwen die snelle, schaalbare vectorzoekopdrachten en filtering vereisen.
LakeFS is een open-source systeem voor data-versiebeheer dat Git-achtige bewerkingen naar object storage brengt, waardoor teams datalakes kunnen beheren met dezelfde workflows die voor code worden gebruikt. Het maakt schaalbaar, betrouwbaar data-versiebeheer mogelijk voor grootschalige data-omgevingen.
Belangrijkste kenmerken:
Het beste voor:
Data-engineers en organisaties die grote datalakes beheren en behoefte hebben aan betrouwbaar versiebeheer, veilige experimenten en reproduceerbare data-workflows op schaal.
Fiddler AI is een platform voor modelmonitoring en uitlegbaarheid dat teams helpt machine learning-modellen in productie te begrijpen, te debuggen en te volgen. Het biedt duidelijke inzichten in modelgedrag, prestaties en datakwaliteit via een intuïtieve interface.
Belangrijkste kenmerken:
Het beste voor:
ML-engineers, data scientists en organisaties die transparante modelmonitoring, uitlegbaarheid en proactieve waarschuwingen nodig hebben om betrouwbare ML-productiesystemen te onderhouden.
Ray is een framework voor gedistribueerde berekeningen dat ontwikkelaars helpt AI- en Python-applicaties eenvoudig te schalen. Het biedt een flexibele runtime en een reeks AI-bibliotheken voor het bouwen, trainen en uitrollen van machine learning-systemen op schaal.
Belangrijkste kenmerken:
Het beste voor:
Ontwikkelaars, ML-engineers en AI-teams die een flexibel, hoogwaardig framework nodig hebben om training, dataverwerking en model-serving te schalen over gedistribueerde omgevingen.
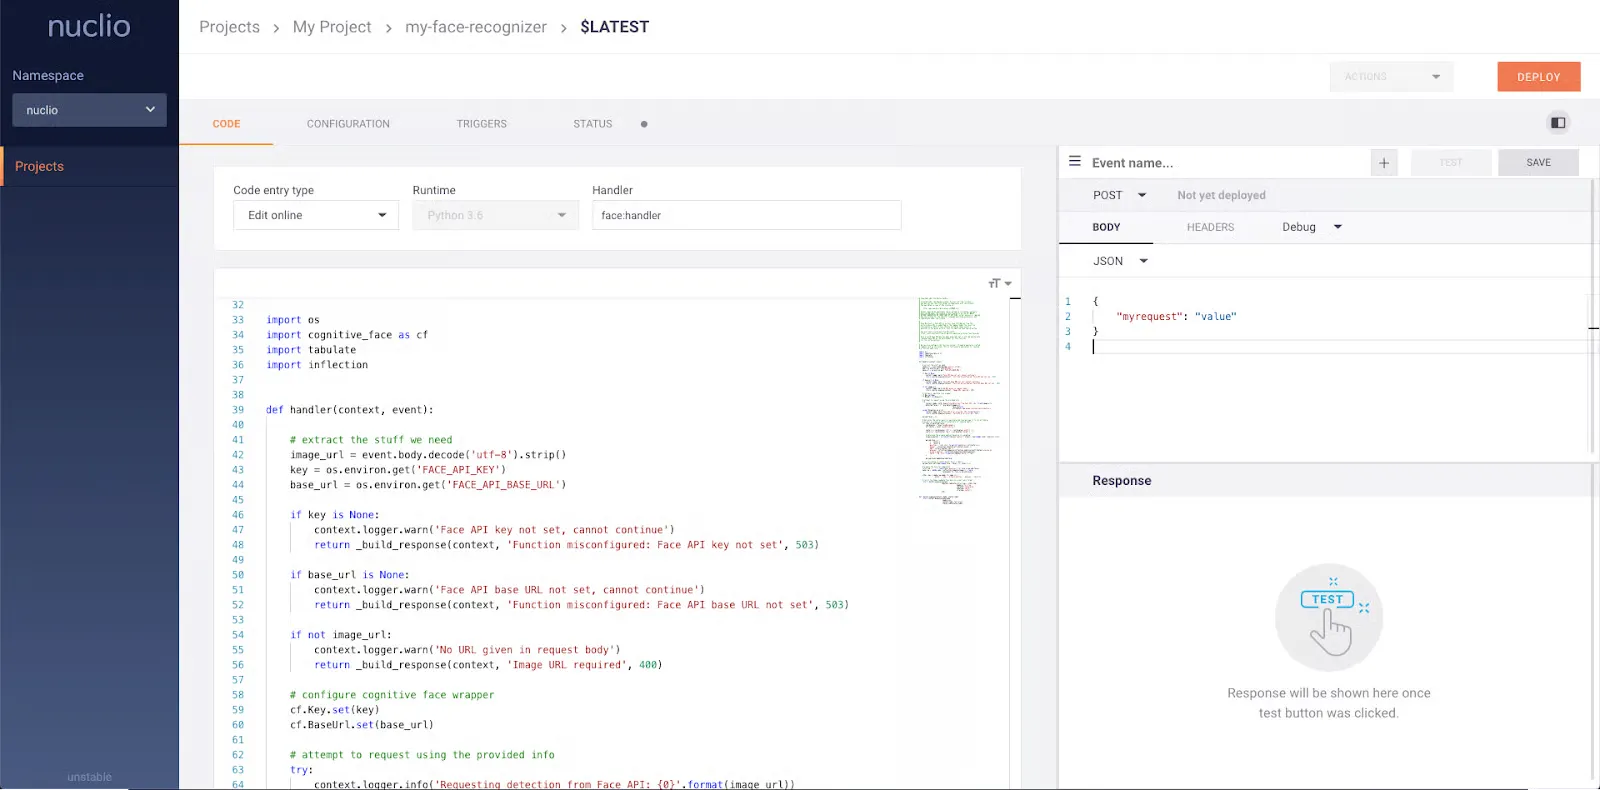
Nuclio is een serverloos high-performance framework ontworpen voor data-, I/O- en rekenintensieve workloads. Het maakt realtime verwerking mogelijk zonder serverbeheer en integreert goed met data science-tools en ML-platforms.
Belangrijkste kenmerken:
Het beste voor:
Organisaties en ML-teams die een serverloos, hoogwaardig platform nodig hebben voor realtime dataverwerking, streaming en schaalbare AI-workloads in cloud- en edge-omgevingen.
De beste MLOps-tools helpen organisaties de end-to-end machine learning-levenscyclus efficiënter te beheren. Ze brengen automatisering, samenwerking en betrouwbaarheid naar het bouwen, uitrollen en onderhouden van ML-systemen.
MLOps-tools automatiseren repetitieve taken zoals datapreparatie, experiment-tracking en pipeline-orchestratie. Hiermee kunnen teams sneller itereren, handmatige fouten verminderen en modellen sneller van idee naar productie brengen.
Deze tools bieden gedeelde werkruimten, assets met versies en duidelijke documentatie, waardoor het voor data scientists, engineers en belanghebbenden eenvoudiger wordt om samen te werken, wijzigingen te beoordelen en inzichten tussen teams te delen.
Met ingebouwde monitoring, testen en validatie helpen MLOps-tools bij het detecteren van problemen zoals datadrift, bias en prestatieverslechtering. Dit zorgt ervoor dat modellen nauwkeurig, betrouwbaar en afgestemd blijven op de bedrijfsdoelen.
MLOps-platforms houden versies bij van data, code, modellen en experimenten, waardoor teams resultaten kunnen reproduceren, wijzigingen kunnen auditen en consistentie in verschillende omgevingen kunnen behouden.
Ze vereenvoudigen het uitrollen van modellen naar productie door middel van automatisering, CI/CD-pipelines en schaalbare infrastructuur, waardoor organisaties efficiënt kunnen omgaan met toenemende workloads en zich kunnen aanpassen aan veranderende eisen.
MLOps is geëvolueerd van een nichepraktijk tot een fundamenteel onderdeel van moderne machine learning-workflows. In 2026 vragen organisaties zich niet langer af of ze MLOps nodig hebben, maar vragen ze zich af welk platform het beste aansluit bij hun doelen, infrastructuur en schaal.
Zoals we hebben gezien, biedt het landschap alles van lichtgewicht, modulaire tools zoals MLflow en DVC tot volledig beheerde enterprise-oplossingen zoals Azure ML, Vertex AI en SageMaker.
Voor teams die gericht zijn op GenAI, fine-tuning en realtime inferentie, bieden nieuwere platforms zoals TrueFoundry geavanceerde mogelijkheden die zijn gebouwd voor moderne AI-uitdagingen.
MLOps is niet beter dan DevOps; het is een uitbreiding van DevOps die is afgestemd op machine learning. Waar DevOps zich richt op softwarelevering en infrastructuurautomatisering, voegt MLOps mogelijkheden toe voor databeheer, experiment-tracking, modelmonitoring en reproduceerbaarheid, ter adressering van de unieke uitdagingen bij het bouwen, uitrollen en onderhouden van ML-systemen in productie.
De beste MLOps-tools voor ondernemingen zijn tools die ontwikkelsnelheid balanceren met strikte infrastructuurgovernance. Hoewel grote cloudproviders brede diensten aanbieden, is TrueFoundry vaak de ideale keuze voor teams die datasoevereiniteit en multi-cloud flexibiliteit vereisen. Het biedt een geïntegreerd control plane dat native binnen uw private VPC draait, waardoor u de gehele levenscyclus, van training tot uitrol, kunt automatiseren zonder in te leveren op beveiliging of infrastructuurcontrole.
Docker is een fundamentele technologie voor containerisatie, waardoor het een cruciaal onderdeel is van de MLOps-toolstack. Het zorgt ervoor dat modellen consistent draaien in ontwikkel- en productie-omgevingen, hoewel het geen taken op hoger niveau zoals modelmonitoring of versiebeheer beheert. TrueFoundry vereenvoudigt het containerisatieproces door automatisch Docker-images te bouwen en deze te orchestreren op Kubernetes, zodat data scientists code kunnen uitrollen zonder DevOps-experts te hoeven worden.
TrueFoundry werkt als een ontwikkelaar-gerichte abstractielaag die bovenop uw bestaande cloudinfrastructuur ligt. Het maakt rechtstreeks verbinding met uw Kubernetes-clusters en automatiseert complexe taken zoals resource provisioning, CI/CD en model-serving. Door één enkele interface te bieden voor het beheren van experimenten en productieworkloads, verkort het de uitroltijden van weken naar minuten, terwijl de kosten worden verlaagd door geautomatiseerde GPU-optimalisatie en ondersteuning voor spot-instances.
Er is niet één cloud het beste voor MLOps; de juiste keuze hangt af van uw behoeften, tools en budget. AWS, Azure en Google Cloud bieden allemaal sterke MLOps-diensten, waaronder geautomatiseerde pipelines, schaalbare training en modelmonitoring. Teams maken hun keuze vaak op basis van bestaande infrastructuur, compliance-vereisten en integratie met hun data-ecosysteem.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























