August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het is geen overdrijving om te zeggen dat elk bedrijf naarmate het groeit meer verkeer moet verwerken, meer data moet verwerken en meer klanten moet ondersteunen. Ze moeten vaak hun infrastructuur opschalen om de toenemende vraag bij te houden. Dit geldt ook als uw bedrijf te maken heeft met seizoensgebondenheid. Denk aan een e-commerce website die tijdens de feestdagen, zoals op Black Friday of Cyber Monday, enorm veel verkeer verwerkt. Het verkeer op de website kan tijdens deze drukke periodes drastisch toenemen. De website kan problemen krijgen met trage laadtijden en gebruikers frustreren als deze de toegenomen vraag niet kan verwerken. Als gevolg hiervan kan het bedrijf te maken krijgen met omzetverlies en een verslechtering van de reputatie.
Eén manier om dit probleem aan te pakken is door het aantal servers in de infrastructuur handmatig te verhogen om het toegenomen verkeer op te vangen. Handmatig op- en afschaalproces kan echter tijdrovend, foutgevoelig en moeilijk te beheren zijn. Dit is waar cluster autoscaling om de hoek komt kijken. Cluster autoscaling past automatisch het aantal servers in de infrastructuur aan op basis van bepaalde voorwaarden, zoals CPU-gebruik, geheugengebruik of inkomende requests. Dit betekent dat de infrastructuur kan opschalen of afschalen op basis van de actuele vraag, zonder handmatige tussenkomst.
In deze blogpost verkennen we wat cluster autoscaling is, waarom het nodig is en hoe het kan worden geïmplementeerd bij verschillende cloud providers.
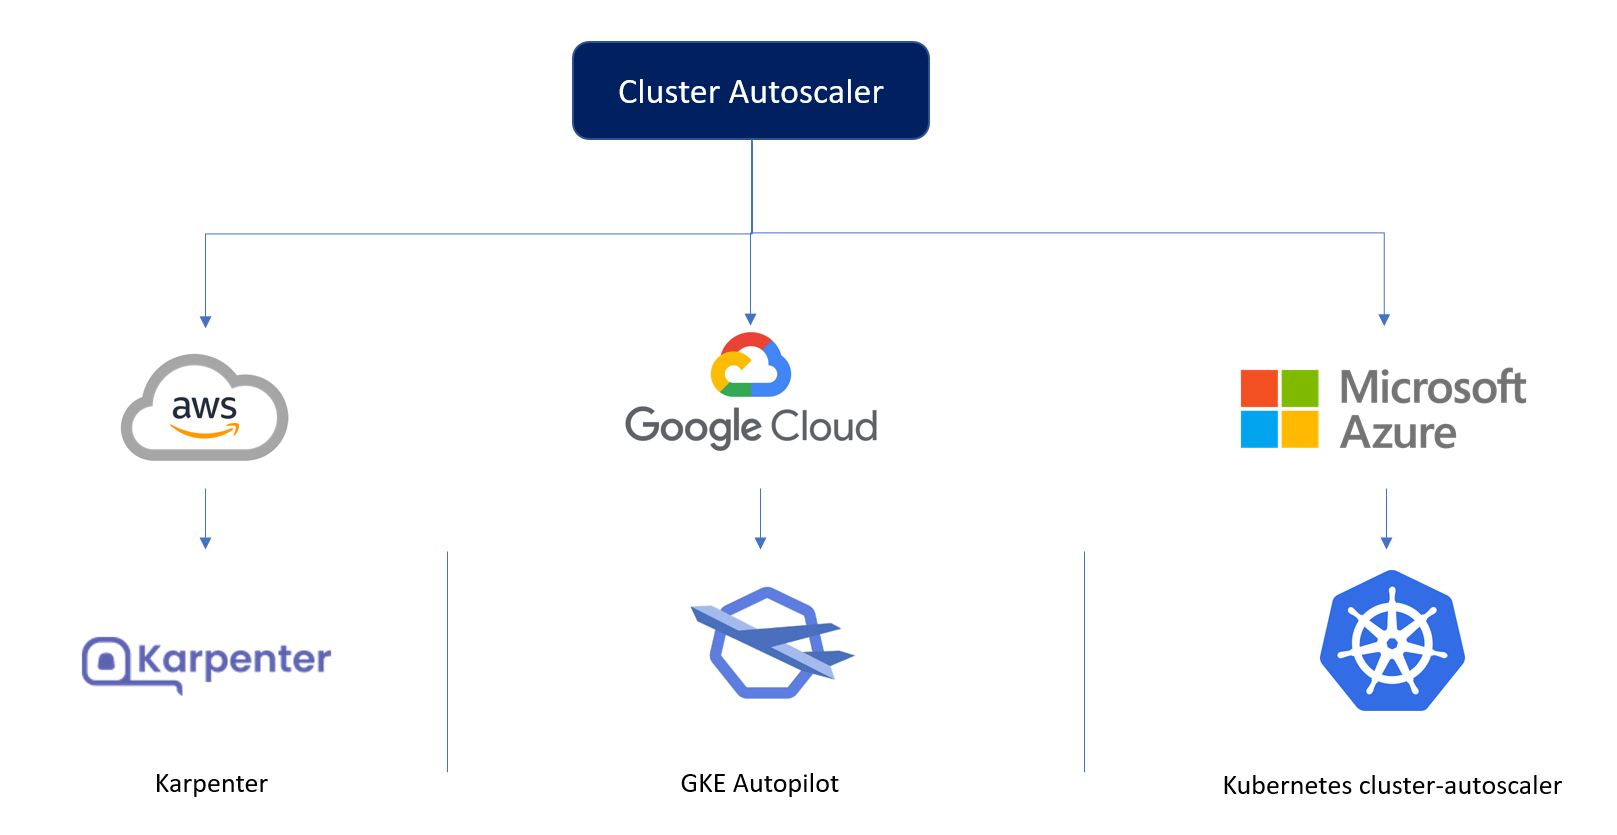
Om ons cluster correct te laten presteren op alle grote cloud providers, moeten we de manier waarop we de cluster nodes schalen aanpassen.
💡
Op AWS gebruiken we Karpenter, dat met minimale configuratie de goedkoopste en meest efficiënte node kan kiezen voor de inkomende pod requests.
💡
Op GCP vertrouwen we op GKE Autopilot, wat ons voorziet van een beheerd cluster dat kan op- en afschalen afhankelijk van de requests.
💡
Er zijn geen ad-hoc oplossingen op Azure, en we gebruiken de Kubernetes cluster-autoscaler, die minder geoptimaliseerd is dan Karpenter en meer configuratie vereist dan autopilot.
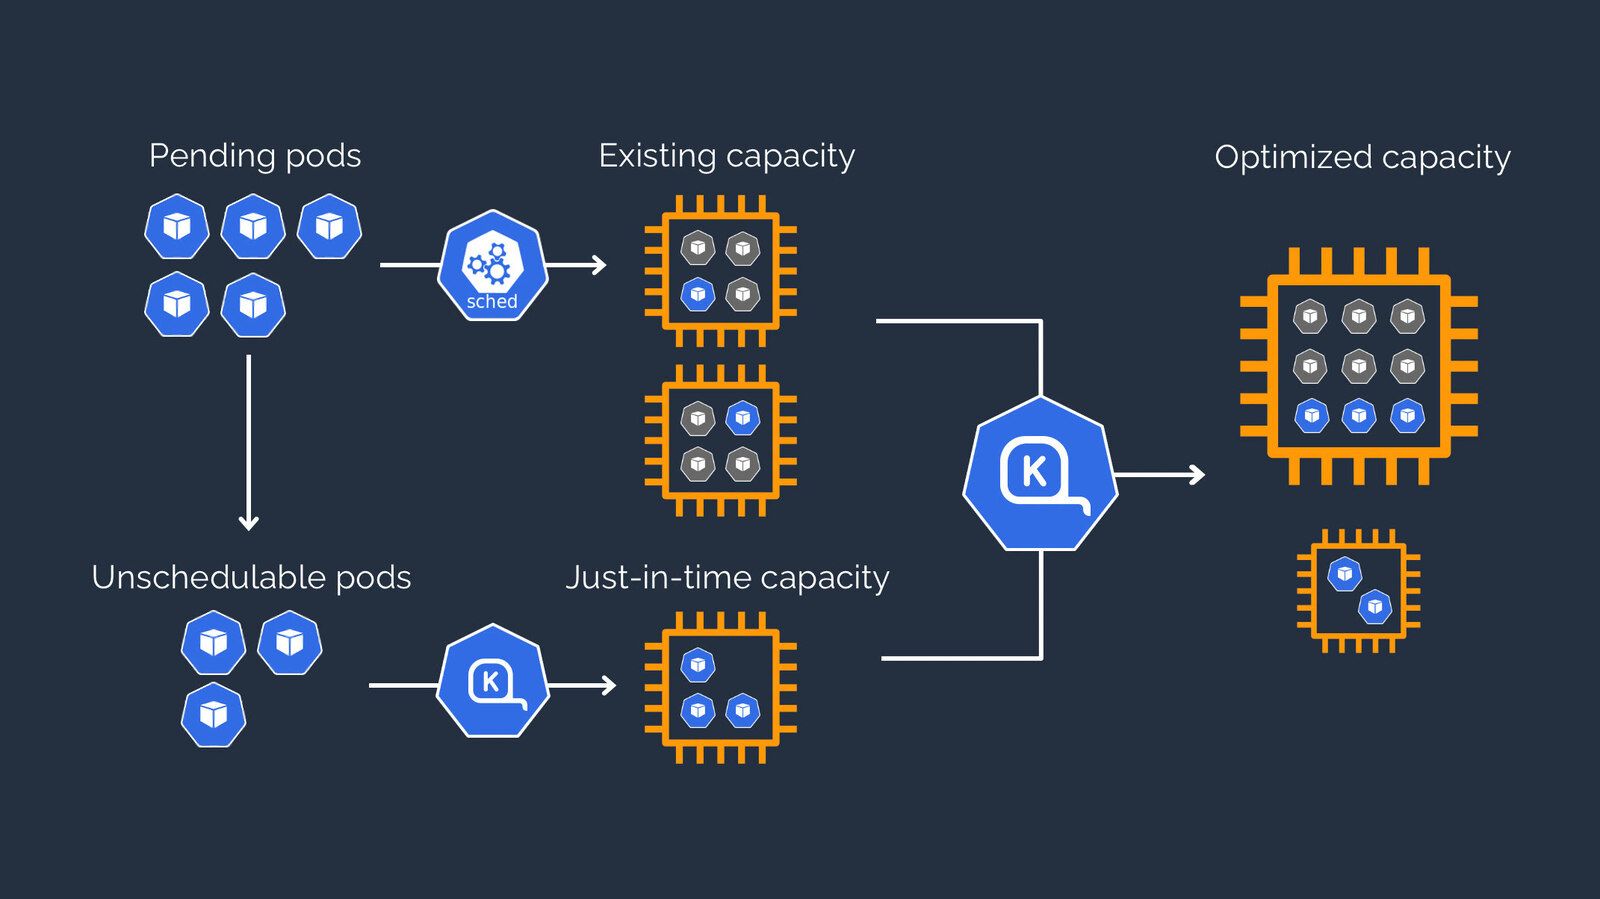
Karpenter observeert de geaggregeerde resource requests van niet-ingeplande pods en neemt beslissingen om nodes te starten en te beëindigen om zo de scheduling latencies en infrastructuurkosten te minimaliseren.
Maar helaas werkt Karpenter alleen op AWS.
Autopilot is een beheerde dienst die machine learning-algoritmen gebruikt om het optimale aantal nodes voor het cluster te bepalen op basis van de huidige workload. Het biedt ook functies zoals automatische upgrades en patches, waardoor het gemakkelijker wordt om veilige clusters te onderhouden en tegelijkertijd cloud scalability te ondersteunen.
Naast autoscaling biedt Cluster Autopilot ook andere voordelen, zoals een beter resourcegebruik en kostenbesparingen door over-provisioning van resources te voorkomen. Het biedt ook een meer hands-off benadering van clusterbeheer, aangezien alle autoscaling-operaties door de dienst worden afgehandeld.
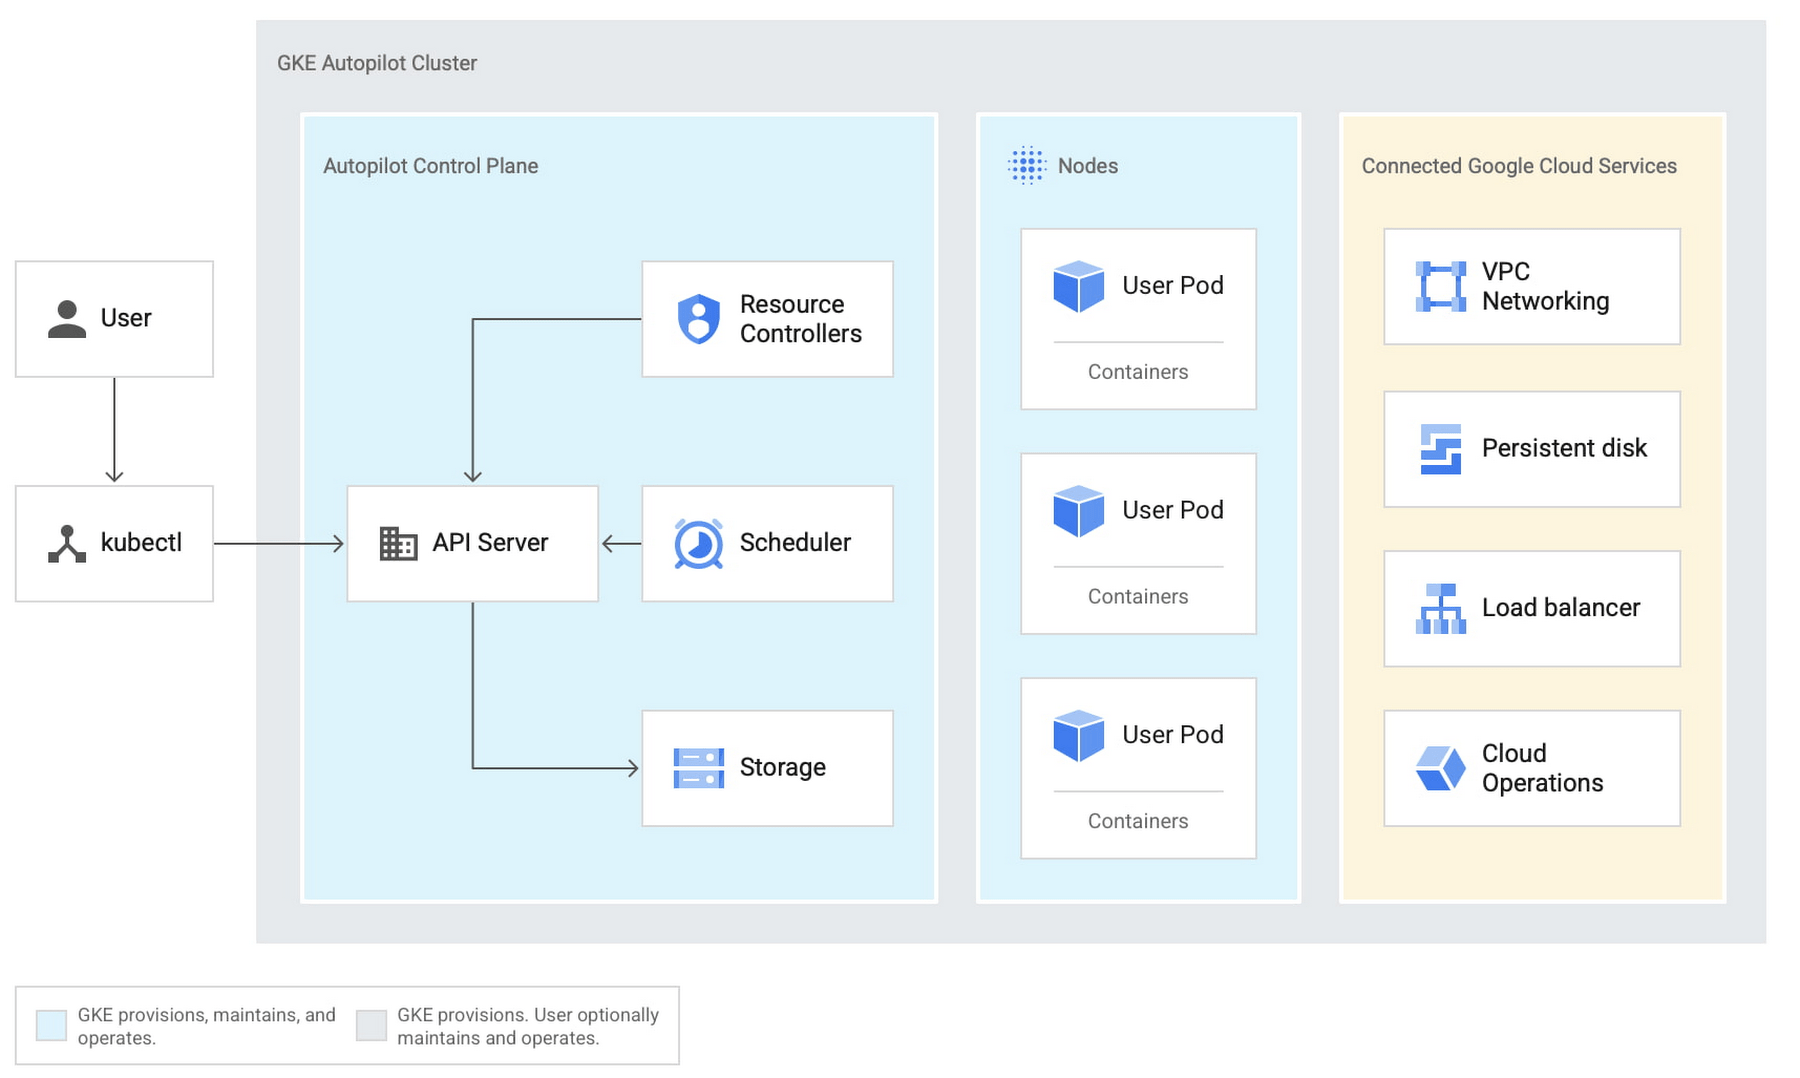
Er is geen beheerd aanbod op Azure cloud zoals GKE Autopilot of een aangepaste benadering van autoscaling zoals Karpenter; daarom vertrouwen we op cluster-autoscaler.
Kubernetes Cluster Autoscaler is een open-source tool die het automatisch schalen van Kubernetes-clusters mogelijk maakt. Het draait als een pod binnen het cluster en monitort het resourcegebruik van het cluster, waarbij het aantal nodes wordt aangepast dat nodig is om te voldoen aan de behoeften van de applicaties die erin draaien. Dit helpt bij het optimaliseren van het resourcegebruik en het verlagen van de kosten door over-provisioning van resources te voorkomen wanneer de vraag laag is. Cluster Autoscaler vereist handmatige configuratie van node groups en types.
Deze blog behandelt details over Kubernetes Autoscaling.
TrueFoundry is een ML Deployment PaaS over Kubernetes om developer workflows te versnellen en hen tegelijkertijd volledige flexibiliteit te bieden bij het testen en deployen van modellen, met behoud van volledige beveiliging en controle voor het Infra-team. Via ons platform stellen we Machine Learning-teams in staat om binnen 15 minuten modellen te deployen en te monitoren met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om binnen enkele seconden te rollbacken - waardoor ze kosten besparen en Modellen sneller in productie kunnen nemen, wat leidt tot echte zakelijke waarde.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox