



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De uitgaven aan enterprise LLM API's verdubbelden in zes maanden tijd van $ 3,5 miljard eind 2024 naar $ 8,4 miljard medio 2025, zonder enige tekenen van vertraging. Gartner voorspelt $ 2,52 biljoen aan wereldwijde AI-uitgaven voor 2026, een stijging van 44% op jaarbasis.
De ironie is dat tokenprijzen nog nooit zo laag zijn geweest. Modellen uit de GPT-4-klasse kosten een fractie van wat ze achttien maanden geleden kosten. De factuur explodeert omdat het gebruikte volume sneller groeit dan de prijzen dalen, gedreven door agentic workflows die 10 tot 100 keer meer tokens per sessie verbruiken dan een chatbot ooit deed, en door de proliferatie van LLM-aanroepen over productfuncties heen die teams hebben gebouwd zonder enige kostendiscipline.
Praktijkaudits brengen een ongemakkelijke waarheid aan het licht: 40-60% van de tokenbudgetten in productie-LLM-toepassingen is pure verspilling. Overtollige aanroepen voor identieke prompts. Vlaggenschipmodellen die taken uitvoeren die een fractie van hun kosten even goed zou kunnen afhandelen. Geen rate limits op ontwikkelaars- of CI-pipelines. Geen budgetplafonds die ingrijpen voordat de maandelijkse factuur binnenkomt. Geen zicht op welk team, welke functie of welke use case de uitgaven drijft.
De optimalisatietechnieken bestaan al: semantische caching, intelligente model-routing, hiërarchische budgetlimieten, on-premise/cloud-fallback-ketens. Het probleem is dat u geen van deze technieken op schaal kunt implementeren zonder een gecentraliseerde controlelaag. Zonder iets tussen uw toepassingen en uw modelproviders, bevindt elke optimalisatie zich in de applicatiecode, gedupliceerd over elk team, zonder governance en zonder observability.
Een AI Gateway is die controlelaag. Deze gids legt uit waarom en laat precies zien hoe TrueFoundry's AI Gateway — vermeld in Gartner's 2026 Best Practices for Optimizing Generative & Agentic AI Costs — elke kostenhefboom op infrastructuurniveau implementeert, onafhankelijk van wat een individueel team in zijn toepassing doet.
De meeste organisaties benaderen LLM-kostenoptimalisatie op dezelfde manier als API-kostenbeheer vijf jaar geleden: elk team is verantwoordelijk voor zijn eigen gebruik, providers sturen maandelijkse facturen en iemand binnen engineering kijkt periodiek naar het totaal en schrikt.
Deze aanpak kent vier structurele faalmodi voor LLM-workloads:
1. Geen attributie. Wanneer uw OpenAI-factuur binnenkomt, ziet u het totale tokengebruik van uw gehele organisatie. U ziet niet welke toepassing, welk team, welke functie of welke gebruiker dat gebruik heeft veroorzaakt. U kunt niks onderzoeken. U kunt geen kosten toewijzen. U kunt niet identificeren welke 20% van de use cases 80% van de uitgaven veroorzaakt — hoewel dat 80/20-patroon vrijwel zeker in uw gegevens aanwezig is.
2. Geen preventie. Kostenanomalieën in LLM-workloads treden snel op. Een bug die een agent in een oneindige lus brengt, kan binnen enkele minuten duizenden dollars verbruiken. Een ontwikkelaar die een nieuwe functie test met een contextzware prompt, kan in één middag een maandbudget opmaken. Zonder rate limits en budgetplafonds op de infrastructuurlaag worden deze gebeurtenissen ontdekt op de maandelijkse factuur, niet wanneer ze plaatsvinden.
3. Geen hefboomwerking. De meest impactvolle kostenoptimalisaties — semantische caching, model-routing, on-premise/cloud-fallback-ketens — werken het beste op infrastructuurniveau waar ze gelijktijdig op alle toepassingen kunnen worden toegepast. Als u ze in individuele toepassingen implementeert, bouwt elk team dezelfde infrastructuur opnieuw op, met inconsistente dekking en zonder gedeelde cache-hits tussen toepassingen.
4. Geen modelflexibiliteit. Wanneer u vanuit applicatiecode rechtstreeks naar providers routet, vereist het wisselen van modellen codewijzigingen in elke toepassing. Deze wrijving voorkomt dat teams goedkopere modellen adopteren zodra deze beschikbaar komen, en maakt het voor een platformteam onmogelijk om organisatiebreed een model-tierbeleid af te dwingen.
De AI Gateway lost alle vier de faalmodi op door het centrale handhavingspunt te worden voor elke LLM-aanroep in uw organisatie. Routeer alles via de gateway en u krijgt attributie, preventie, hefboomwerking en flexibiliteit — centraal, zonder aan de applicatiecode te komen.

U kunt niet optimaliseren wat u niet kunt zien. Het eerste resultaat van het routen van al het LLM-verkeer via een gateway is een volledig, toewijsbaar en opvraagbaar overzicht van elke modelaanroep — per gebruiker, team, virtueel account, toepassing en model.
TrueFoundry's AI Gateway houdt automatisch de kosten per verzoek bij met behulp van een open-source prijscatalogus die up-to-date blijft met de door providers gepubliceerde tarieven, inclusief gestaffelde prijzen (bijv. Gemini 2.5 Pro's afwijkende tarieven boven 200K tokens) en regiospecifieke prijzen (bijv. AWS Bedrock Nova Lite's tarieven per regio). Voor modellen met op maat gemaakte contracten of afgestemde prijzen kunt u met de configuratie Private Cost exacte tarieven per token instellen die doorvloeien naar alle dashboards.
Het resultaat: een live dashboard dat de kosten laat zien, uitgesplitst naar team, gebruiker, virtueel account, model en toepassing — filterbaar op elke metadata-tag die u meestuurt in de X-TFY-METADATA header. Tag elk verzoek met project_id, feature, customer_id of environment en uw kostendashboards segmenteren automatisch op die dimensies.
Zie de TrueFoundry kostentracking-documentatie voor de installatie.
Dit is de belangrijkste controle om in te zetten. Voordat u de uitgaven optimaliseert, moet u catastrofale uitgaven voorkomen. Budgetlimieten en rate limits op gateway-niveau zijn de stroomonderbrekers die uitschakelen voordat de factuur binnenkomt.
TrueFoundry's budgetbeperking is hiërarchisch — regels stapelen en combineren:
Rate limiting bij de TrueFoundry gateway richt zich op drie verschillende scenario's:
Hier liggen de grootste kostenbesparingen. Onderzoek toont consistent aan dat 60-80% van de enterprise LLM-kosten afkomstig is van 20-30% van de use cases, en dat die concentratie bijna altijd bestaat uit taken met een hoog volume en lage complexiteit waarvoor een frontier-model zwaar overgespecificeerd is.
RouteLLM (gepubliceerd op ICLR 2025) toonde aan dat een goed getrainde complexiteits-router 95% van de GPT-4-prestaties kan behalen terwijl slechts 14-26% van de verzoeken naar het dure model wordt gerouteerd — een kostenreductie van 75-85% op gerouteerde workloads. De besparingen zijn mogelijk zonder in te leveren op kwaliteit. De voorwaarde is een routinglaag.
TrueFoundry's Virtual Models implementeren drie routingstrategieën die rechtstreeks aansluiten op scenario's voor kostenoptimalisatie:
Het patroon met on-premise als primaire optie en cloud als fallback is de routingconfiguratie met de hoogste ROI voor bedrijven met een GPU-infrastructuur:
Het verkeer blijft op uw GPU's (nul marginale kosten) totdat de capaciteit is uitgeput, waarna het automatisch uitwijkt naar Bedrock. De cloud-API wordt een capaciteitsbuffer, niet de standaard. Zie de TrueFoundry load balancing-documentatie voor alle configuratie-opties.
Routing kan ook worden beperkt op basis van metadata — routeer ontwikkelomgevingen naar een goedkoper modelniveau en productie naar het premium model, zonder enige wijziging in de applicatiecode:
Caching is de meest directe hefboom voor kostenreductie voor workloads met enige vorm van query-herhaling. Herhaalde of semantisch vergelijkbare prompts retourneren direct gecachte antwoorden — nul verbruikte tokens, nul providerkosten en een aanzienlijk lagere latentie.
TrueFoundry AI Gateway ondersteunt twee caching-modi:
Exact Match Caching slaat antwoorden op en retourneert deze voor byte-identieke prompts. Zonder false positives — dezelfde prompt retourneert altijd hetzelfde gecachte antwoord. Hit rates zijn afhankelijk van de workload; het beste voor API-gestuurde, gestructureerde prompts waar de parameters consistent zijn.
Semantic Caching gebruikt embedding-similariteit om prompts te matchen die hetzelfde betekenen, zelfs als ze anders zijn geformuleerd. Een vraag over "hoe kan ik mijn wachtwoord opnieuw instellen" en "ik ben mijn wachtwoord vergeten, wat moet ik doen?" retourneren hetzelfde gecachte antwoord. Typische kostenreductie: 30–50% voor klantenservice-, FAQ- en documentatieworkloads met herhalende querypatronen. Zie de TrueFoundry-gids voor semantische caching voor details over de implementatie en het afstemmen van de drempelwaarde voor similariteit.
Beide modi ondersteunen instelbaar beleid voor de vervaldatum van de cache en handmatige invalidatie — zodat gecachte antwoorden actueel blijven voor tijdgevoelige gegevens, terwijl statische inhoud voor onbepaalde tijd wordt gecacht.
Provider-native prompt caching staat naast caching op gateway-niveau als een aanvullende hefboom. Anthropic's Claude API prompt caching verlaagt de kosten voor inputtokens met maximaal 90% op gecachte prefixes, met een verbetering van 13–31% in de time-to-first-token. Dit werkt op provider-niveau — de gateway routeert naar het juiste eindpunt en de provider past automatisch prompt caching toe voor ondersteunde modellen.
Elk verzoek dat door de gateway wordt verwerkt, wordt automatisch getagd met:
X-TFY-METADATA (project_id, feature, customer_id, environment)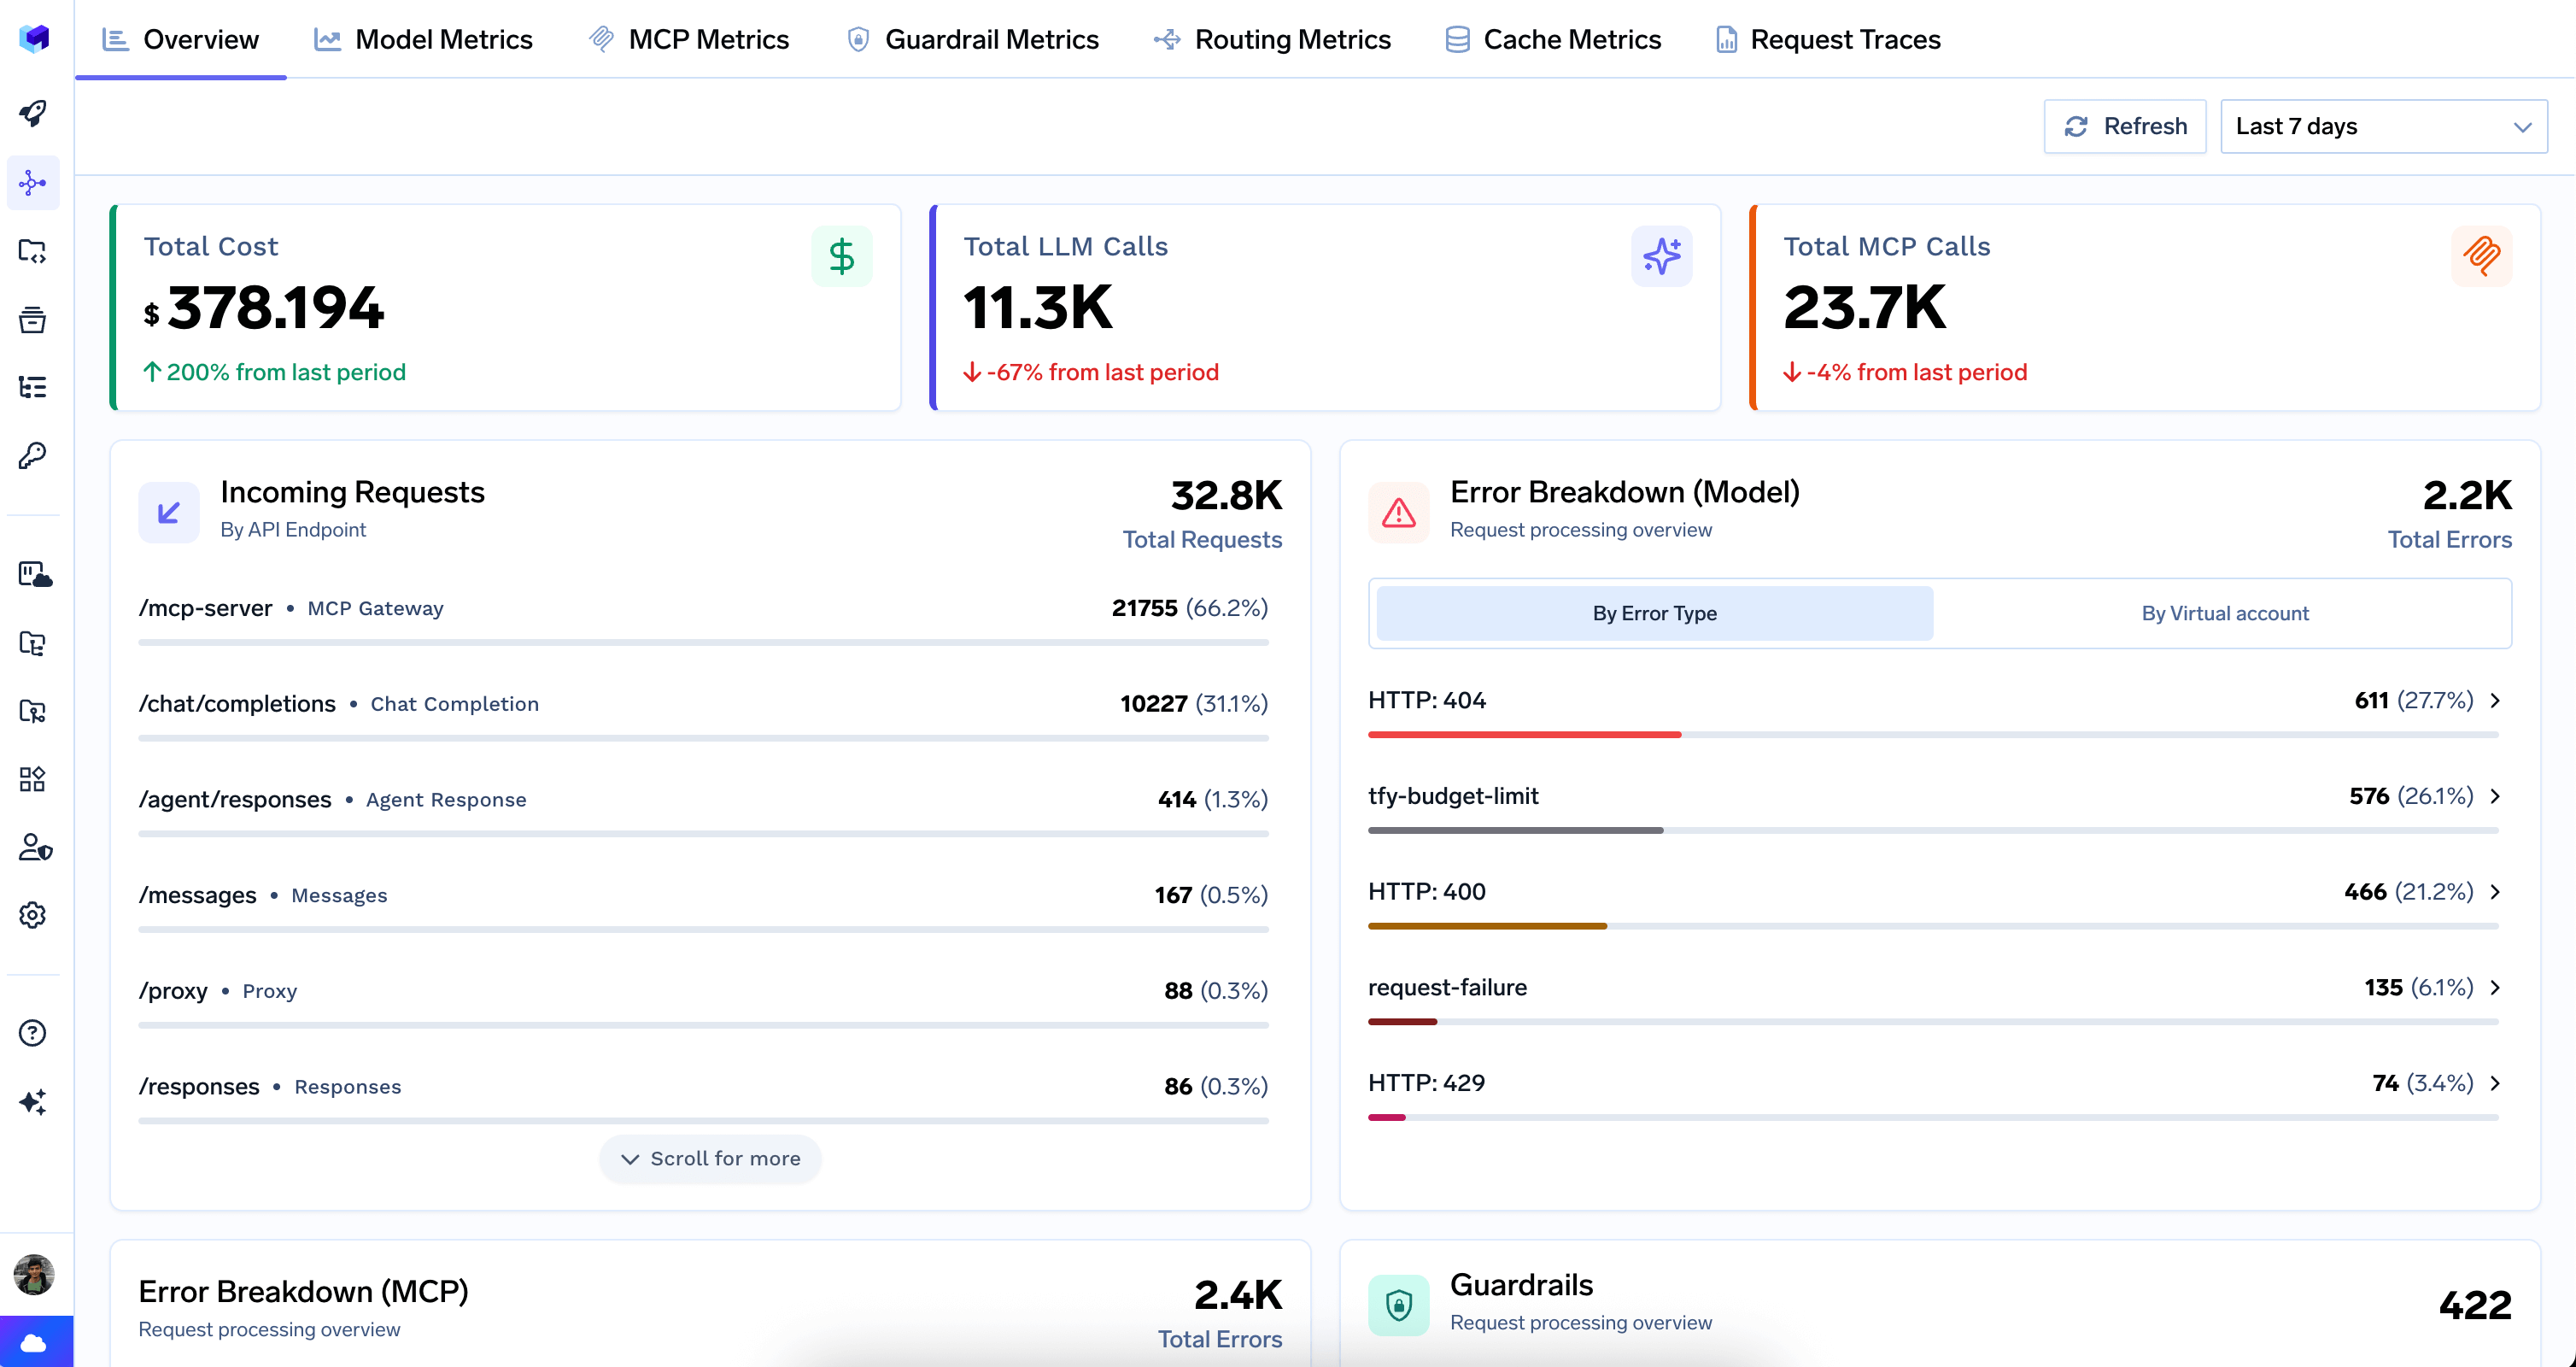
Het analytics dashboard toont dit alles met vooraf gebouwde weergaven, gegroepeerd op gebruikers, virtuele accounts, teams en configuraties. Het tabblad met routing-statistieken laat zien welke budgetlimieten en rate limits worden bereikt, en door wie, zodat u precies weet welk team het budget opmaakt voordat de maand om is, en niet achteraf.
Alle traces kunnen via OpenTelemetry worden geëxporteerd naar elk SIEM- of observability-platform — Grafana, Datadog, Splunk of uw bestaande stack — wat aangepaste dashboards, geautomatiseerde waarschuwingen en integratie met uw bestaande FinOps-tools mogelijk maakt.
TrueFoundry's engine voor budgetbeperking evalueert meerdere regels per verzoek, waarbij de meest restrictieve overeenkomende regel van kracht wordt. Regels zijn geordend en combineerbaar:
Praktische configuratie: Dagelijkse plafonds per ontwikkelaar met team-overrides
Leden van het ML-team matchen eerst regel 1 ($ 100/dag). Alle andere ontwikkelaars vallen onder regel 2 ($ 10/dag). Beide regels worden geëvalueerd voor tracking, maar de eerste match bepaalt het besluit om toe te staan of te blokkeren.
Een veiligheidsnet op modelniveau toevoegen
Individuele gebruikers blijven binnen $ 10/dag. Maar zelfs als elke gebruiker binnen zijn limiet blijft, worden de totale GPT-4-uitgaven organisatiebreed geplafonneerd op $ 500/maand — wat voorkomt dat veel gebruikers die individueel binnen hun limiet blijven, gezamenlijk uw modelbudget uitputten.
Zie de TrueFoundry budgetbeperking-documentatie voor het volledige regelschema.

Rate limits kunnen verder worden beperkt dan alleen op gebruiker en team — gericht op specifieke omgevingen, modellen of toepassingen:
Dit maximeert het GPT-4-gebruik in de ontwikkelomgeving op 1.000 verzoeken/dag zonder het productieverkeer te beïnvloeden. CI/CD-pipelines die LLM's aanroepen tijdens het testen — een veelvoorkomende bron van onverwachte kosten — worden beperkt zonder de CI-configuratie aan te raken.
Zie de TrueFoundry rate limiting-documentatie voor alle configuratie-opties.
Fallbacks zijn niet alleen functies voor betrouwbaarheid — het zijn mechanismen voor kostenbeheersing. Automatische failover bij 429-antwoorden (rate limit) van een provider betekent dat u niet betaalt voor retries of mislukte verzoeken.
De fallback-keten van de gateway handelt de volgende scenario's automatisch af:
TrueFoundry load balancing en fallbacks beheert alle drie de routingstrategieën (prioriteit, gewicht, latentie) met retry-configuratie per doel — zodat u geen retry-logica hoeft te implementeren in elke toepassing.
Exacte besparingen hangen af van de samenstelling van uw workload, maar dit kader geeft een indicatie van de mogelijkheden:
Een realistisch gecombineerd scenario: Een engineering-organisatie van 500 personen met $ 150K/maand aan LLM API-uitgaven. Semantische caching met een hit rate van 40% bespaart 20% in totaal. Het routen van ontwikkelomgevingen naar goedkopere modellen bespaart 15%. On-premise als primaire optie voor 60% van het verkeer bespaart nog eens 25%. Gecombineerd: 60% reductie, oftewel een besparing van $ 90K/maand. Tegen de prijzen van TrueFoundry Gateway wordt de ROI gemeten in dagen, niet in kwartalen.
Week 1 — Zichtbaarheid eerst. Routeer al het LLM-verkeer via TrueFoundry AI Gateway. Schakel kostentracking in met openbare prijzen. Tag elk verzoek met uw attributie-metadata (team, project_id, environment). Na één week weet u precies waar uw geld naartoe gaat. Dit alleen al verandert het gesprek van "onze AI-factuur is hoog" naar "de documentanalyse-pipeline in team X veroorzaakt 40% van de kosten."
Week 2 — Preventie. Configureer budgetlimieten en rate limits op basis van de inzichten uit week 1. Stel een maximum in voor het dagelijkse verbruik per ontwikkelaar. Voeg omgevingsgebaseerde rate limits toe voor dev/staging. Stel een maandelijks plafond op modelniveau in voor uw duurste model. Deze controles voorkomen het volgende incident. Ze optimaliseren niet — ze beschermen.
Week 3 — Routing. Maak Virtual Models die omgevingsgebaseerde routing implementeren (dev → goedkoper model, prod → premium model) en provider-prioriteitsketens. Als u beschikt over on-premise GPU-capaciteit, configureer dan routing op basis van prioriteit met cloud-fallback. Hier worden de aanzienlijke besparingen gerealiseerd.
Week 4+ — Caching en verfijning. Schakel semantische caching in voor workloads met herhalende patronen. Stem de drempelwaarden voor similariteit af. Bekijk het dashboard met routing-statistieken om te begrijpen welke budget- en rate limits het vaakst worden bereikt en pas deze aan. De analyticslaag laat u zien waar u zich vervolgens op moet richten.
Elk team krijgt zijn eigen virtuele account met onafhankelijke budget-tracking. Het platformteam stelt organisatiebrede modelplafonds en standaard rate limits in. Individuele teamleiders kunnen de kostenopbouw van hun team zien zonder toegang tot de gegevens van andere teams.
Belangrijkste configuratie: Projectgebaseerde budgetten met metadata + wekelijkse plafonds voor virtuele accounts + maandelijkse plafonds op modelniveau als organisatiebrede veiligheidsnetten.
Zie de TrueFoundry AI Gateway analytics voor de installatie van dashboards op teamniveau.
Klantgerichte AI-producten hebben gebruiks-tracking per klant nodig om doorberekening of gestaffelde facturering te implementeren. Tag elk verzoek met customer_id in metadata. De gateway houdt de kosten per customer_id automatisch bij. Stel rate limits per klant in die overeenkomen met de abonnementsniveaus.
Belangrijkste configuratie: Op metadata gebaseerde budgetregels per customer_id + rate limits afgestemd op klantniveau. Dit geeft u nauwkeurige gegevens voor uw facturatiepipeline zonder dat u een aangepaste meetinfrastructuur hoeft te bouwen.
Agentic workloads vormen het duurste LLM-patroon. Een enkele agenttaak kan duizenden tokens verbruiken over tientallen modelaanroepen. Budgetplafonds zijn niet optioneel voor agentic workloads — ze zijn het primaire veiligheidsmechanisme.
Routeer al het agentic verkeer via de gateway met behulp van ANTHROPIC_BASE_URL (of gelijkwaardig). Stel virtuele sleutels per agent-identiteit in met dagelijkse budgetlimieten. Configureer on-premise/cloud-fallback-ketens zodat langdurig draaiende agents bij voorkeur goedkopere on-premise capaciteit gebruiken voor routineuze subtaken.
Zie de TrueFoundry Claude Code-integratiegids voor de configuratie van agentic deployments.
De afwezigheid van een gateway is op zichzelf al een kostenpost. Het komt op vier manieren tot uiting:
Incident cost. Een agentic loop zonder rate limits, een developer die context-zware prompts test, een bug die redundante API calls genereert — deze gebeurtenissen komen voor. De vraag is of ze worden gestopt bij $50 of pas worden ontdekt bij $5.000 op de maandelijkse factuur.
Optimization lag. Zonder gecentraliseerde routing bouwt elk team dat goedkopere model fallbacks of caching wil implementeren dit onafhankelijk van elkaar. Platform-level optimalisaties die één engineer één week zouden kosten, vergen in plaats daarvan zes maanden aan gefragmenteerde inspanningen over meerdere teams heen.
Attribution gap. Wanneer u kosten niet kunt toeschrijven aan teams, applicaties of functies, kunt u niemand verantwoordelijk houden voor AI spend en kunt u niet de optimalisatiedoelen met de hoogste impact identificeren.
Compliance exposure. In gereguleerde sectoren of multi-tenant producten is het onvermogen om kosten en gebruiksattributie per klant of per team aan te tonen niet alleen een financieel probleem - het is een governance- en factuurnauwkeurigheidsprobleem.
LLM cost optimization is de verzameling strategieën en controls die verlagen wat organisaties betalen voor large language model API calls, terwijl de outputkwaliteit behouden blijft. Het is nu belangrijk omdat de enterprise LLM API-uitgaven in zes maanden tijd zijn verdubbeld en naar verwachting eind 2026 $15 miljard zullen bereiken, gedreven door agentic workloads die veel meer tokens verbruiken dan traditionele chatbot-implementaties. Zonder systematische cost optimization is 40–60% van die uitgaven pure verspilling: redundante calls, te zware modellen voor eenvoudige taken, geen caching en geen budget controls.
U kunt individuele optimalisaties implementeren in de applicatiecode, maar u zult tegen drie problemen aanlopen: elk team bouwt dezelfde infrastructuur op een inconsistente manier; u heeft geen gecentraliseerde zichtbaarheid om te weten waar u zich op moet richten; en optimalisaties zijn slechts zo goed als de minst onderhouden applicatie in uw stack. Een AI gateway past cost controls universeel en centraal toe op elke applicatie tegelijkertijd, zonder dat individuele teams iets hoeven te implementeren. Één routing regel in de gateway vervangt honderden codewijzigingen in tientallen applicaties.
Semantic caching verlaagt de kosten doorgaans met 30–50% voor workloads met een hoge query-herhaling - klantenservice, FAQ-systemen, documentatiesearch, classificatie-pipelines. De besparingen ontstaan door het retourneren van gecachete antwoorden (nul provider-kosten, vrijwel nul latency) voor query's die semantisch vergelijkbaar zijn met eerder beantwoorde vragen. Hit rates hangen sterk af van workloadpatronen; workloads met diverse, unieke query's behalen lagere hit rates. Zie de TrueFoundry semantic caching guide voor handleidingen over workloadbeoordeling en het afstellen van drempelwaarden.
Model routing stuurt elke LLM request naar het meest kostenefficiënte model op basis van complexiteit, team, omgeving of andere criteria. Onderzoek (RouteLLM, ICLR 2025) toonde aan dat het routen van slechts 14–26% van de requests naar een frontier model, terwijl de rest wordt afgehandeld door een goedkoper model, 95% van de prestaties van het frontier model behaalt tegen 75–85% lagere kosten. In de praktijk is voor enterprises met GPU-infrastructuur de meest waardevolle vorm een on-prem primary / cloud fallback routing — het verkeer blijft op uw GPU's (vrijwel nul marginale kosten) en schaalt alleen uit naar cloud API's wanneer de capaciteit is uitgeput. TrueFoundry's Virtual Models implementeren alle drie de routingstrategieën (prioriteit, gewicht, latency) zonder codewijzigingen in applicaties.
TrueFoundry's budget limiting is hiërarchisch en regelgebaseerd. U definieert regels die specificeren op wie ze van toepassing zijn (een gebruiker, team, virtueel account, model of metadatawaarde), een budgetbedrag en tijdsbestek (bijv. $10/dag per gebruiker), en of de limiet individueel of gedeeld is. Meerdere regels kunnen worden gestapeld — een developer kan zowel een individuele limiet van $10/dag hebben als bijdragen aan een GPT-4 limiet van $500/maand op organisatie-niveau. Wanneer een van de toepasselijke limieten wordt overschreden, blokkeert de gateway het request en retourneert een foutmelding voordat het tokenverbruik plaatsvindt. Alerts kunnen worden geconfigureerd om af te gaan voordat de limiet wordt bereikt.
Het LLM-kostenprobleem is een infrastructuurprobleem, geen applicatieprobleem. Het kan niet worden opgelost door individuele teams te vragen efficiënter te zijn met hun prompts of hun eigen rate limits te implementeren. Het vereist een gecentraliseerde controlelaag die cost governance toepast op elke LLM call voordat het token wordt verbruikt, niet nadat de factuur binnenkomt.
Een AI gateway is die laag. Het maakt kosten inzichtelijk (attributie), maakt verspilling onmogelijk (budget limits en rate controls), maakt dure modellen de uitzondering (intelligent routing) en maakt herhaalde berekeningen gratis (caching). Elk van deze voordelen is onafhankelijk beschikbaar; gecombineerd leveren ze routinematig 50–80% kostenreductie op bij productie LLM workloads.
TrueFoundry's AI Gateway implementeert alle vier de pijlers in één enkel platform, erkend door Gartner voor agentic AI cost optimization in 2026. Met een overhead van minder dan 4ms en 350+ RPS op 1 vCPU voegt de gateway geen merkbare latency toe, terwijl alle essentiële cost controls worden toegevoegd.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















