


April 16, 2024
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
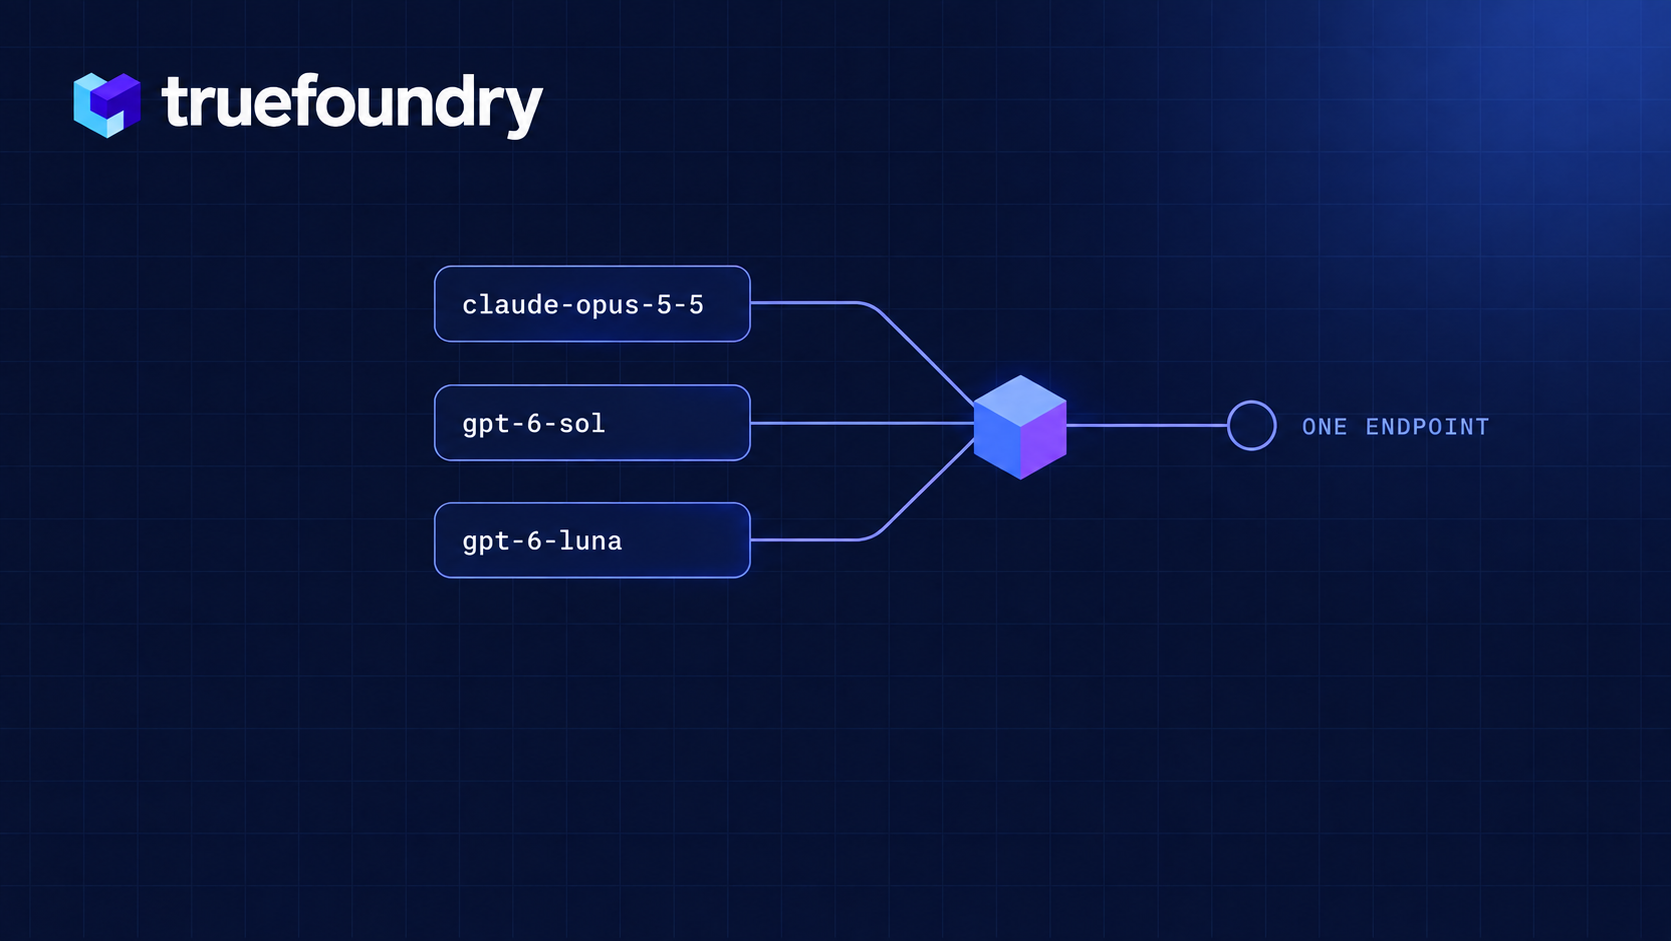
Claude Opus 5.5, GPT-6 Sol en GPT-6 Luna zijn nu live op TrueFoundry AI Gateway
Dinsdag was een drukke dag voor iedereen die professioneel LLM-verkeer beheert. Anthropic bracht Claude Opus 5.5 uit, en enkele minuten later lanceerde OpenAI GPT-6 Sol en GPT-6 Luna, twee voordeligere broertjes van GPT-6 Astra.
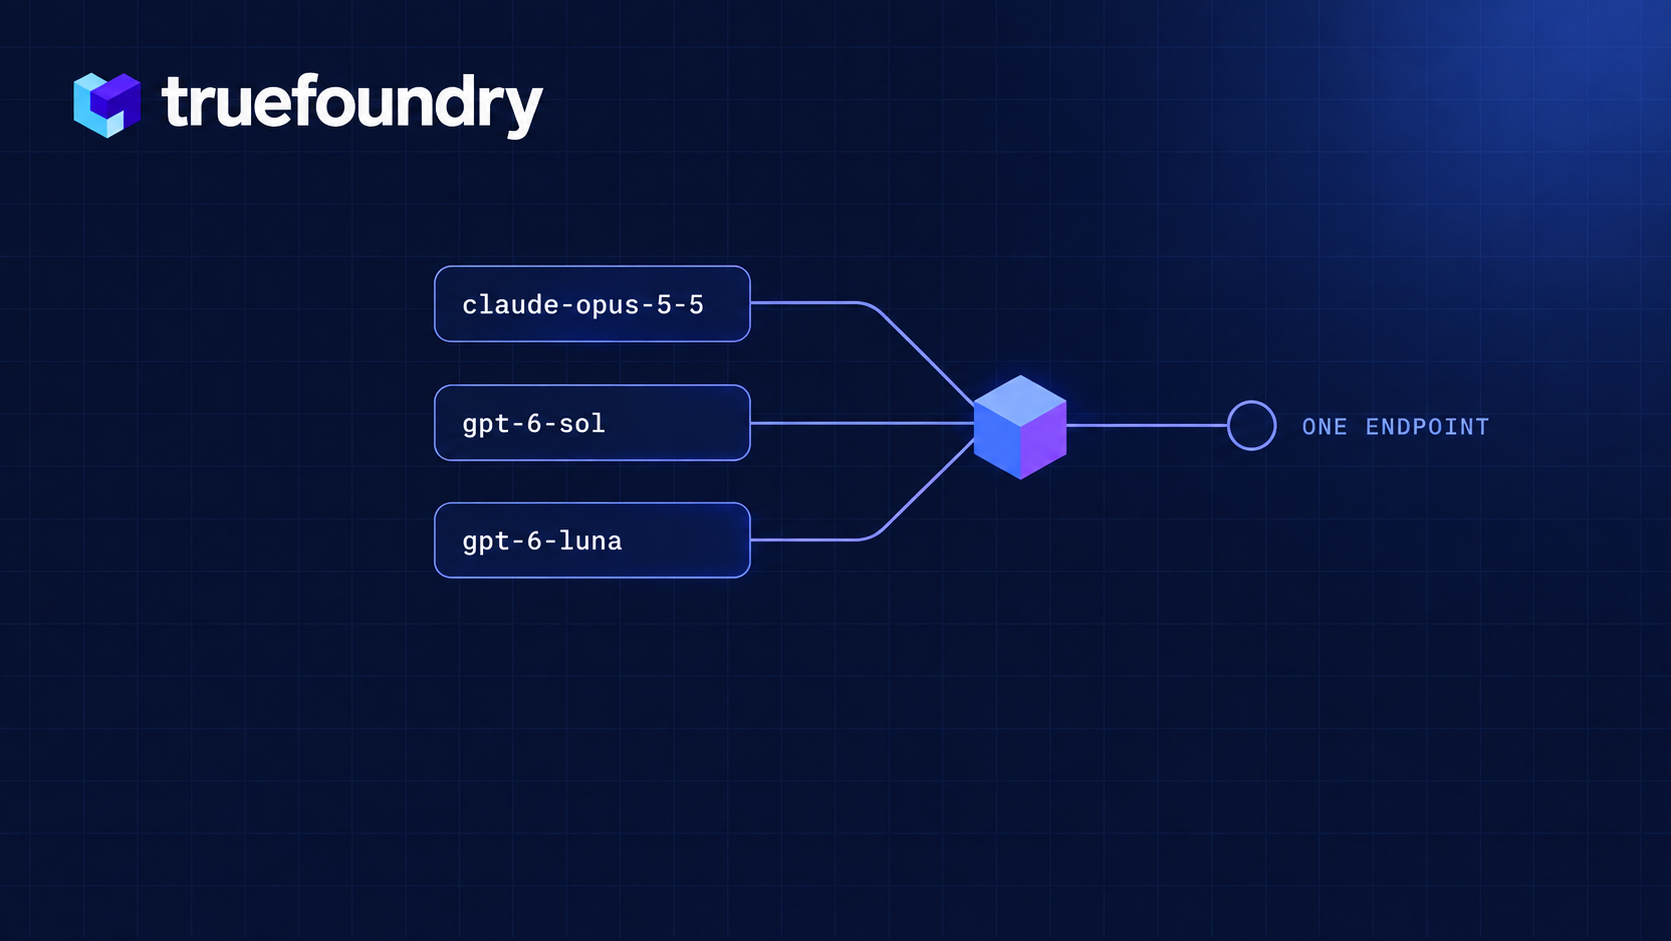
Alle drie staan ze nu in de TrueFoundry AI Gateway-modelcatalogus, compleet met prijzen, contextlimieten en functionaliteiten. Je roept ze aan via hetzelfde OpenAI-compatibele endpoint dat je voor alles gebruikt. Geen nieuwe SDK, geen afzonderlijke integratie, geen wachten op een gateway-release. Wijzig de model-string en je gebruikt het nieuwe model.
Probeer ze op de TrueFoundry AI Gateway →
Het standpunt van Anthropic is dat Opus 5.5 op het niveau van Claude Fable 5.1 presteert voor het meeste werk, maar tegen Opus-prijzen. De belangrijkste punten voor een productiebudget:
Sol en Luna zijn getraind met dezelfde methoden als GPT-6 Astra (die op 3 september verscheen tegen $ 10 / $ 50) en vervolgens geoptimaliseerd voor kosten. OpenAI richt Sol op terugkerend coderings- en agent-werk, en Luna op routinetaken met een hoog volume, zoals extractie en samenvatten.
Plaats de modellen van september naast elkaar en de spreiding is niet te negeren: Luna op $ 0,10 per miljoen input-tokens, Sol op $ 2, Opus 5.5 op $ 4, Astra op $ 10. Een verschil van een factor honderd tussen de goedkoopste en de duurste optie, van twee leveranciers, op twee verschillende native API's.
Dat verschil is hét argument tegen het kiezen van één standaardmodel waar alles naartoe wordt gestuurd. Het meeste productieverkeer bestaat uit veel eenvoudige verzoeken en een paar moeilijke. Stuur het eenvoudige merendeel naar Luna en de moeilijke tail naar Opus 5.5, en de totale rekening ziet er heel anders uit dan een volledige Opus-factuur. Dat werkt alleen als het wisselen van model een configuratiewijziging is in plaats van een codewijziging – en dat is precies waar de AI Gateway voor dient.
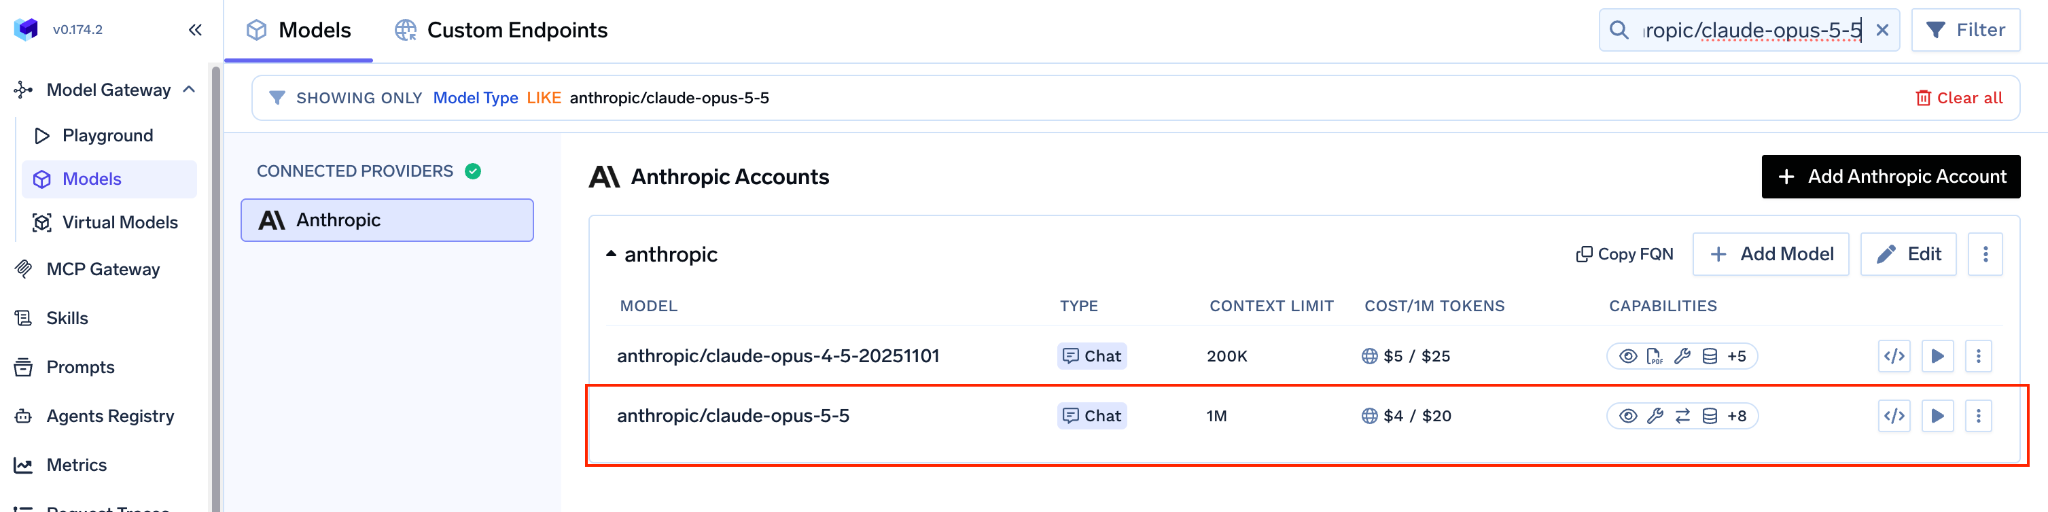
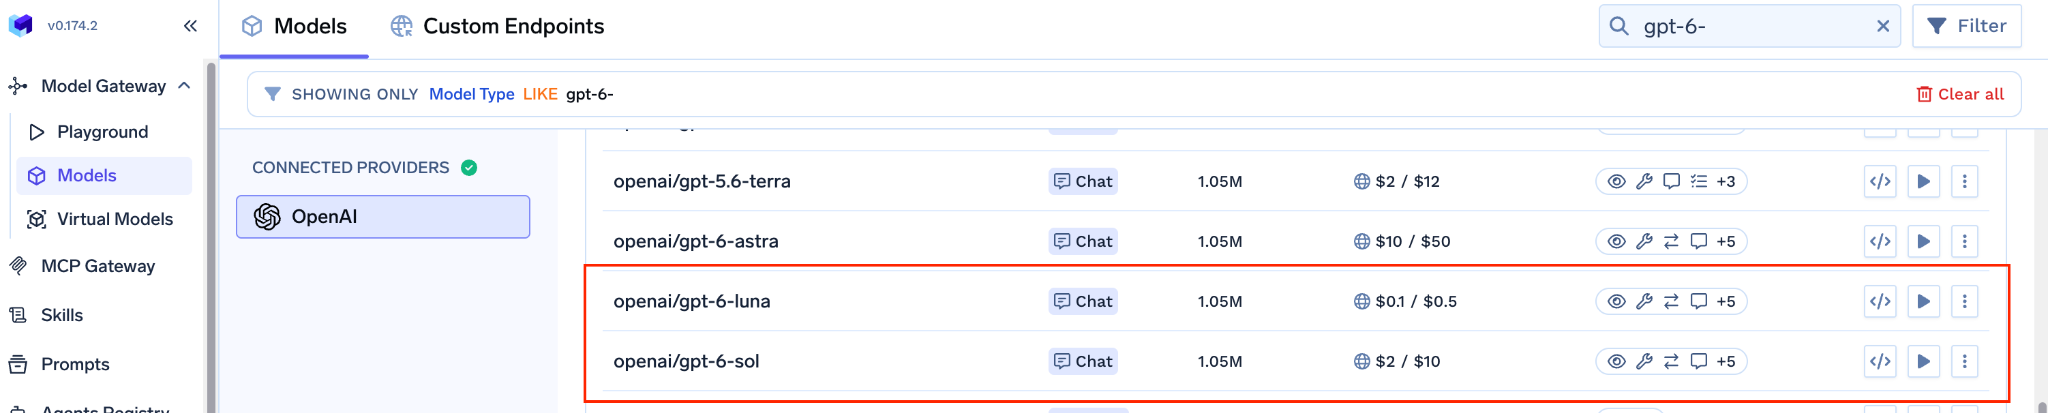
Ga in de gateway naar Models → jouw Anthropic-account → Models Selection, zoek naar claude-opus-5-5 en vink deze aan. De prijzen worden direct getoond ($ 4 input / $ 20 output per 1M tokens) omdat deze rechtstreeks uit de catalogus komen. Stel vervolgens Access Control in, zodat een model in deze prijsklasse vanaf dag één aan de juiste teams en virtuele sleutels is toegewezen.
Herhaal dit in je OpenAI-account voor gpt-6-sol en gpt-6-luna.
Als je deze modellen via een cloudprovider gebruikt, ondersteunt de catalogus ook die routes:
Zie je een model nog niet in je lijst staan? Met + Add Model onderaan de lijst voeg je deze handmatig toe. De gateway ondersteunt elk tekstmodel dat Anthropic en OpenAI publiceren.
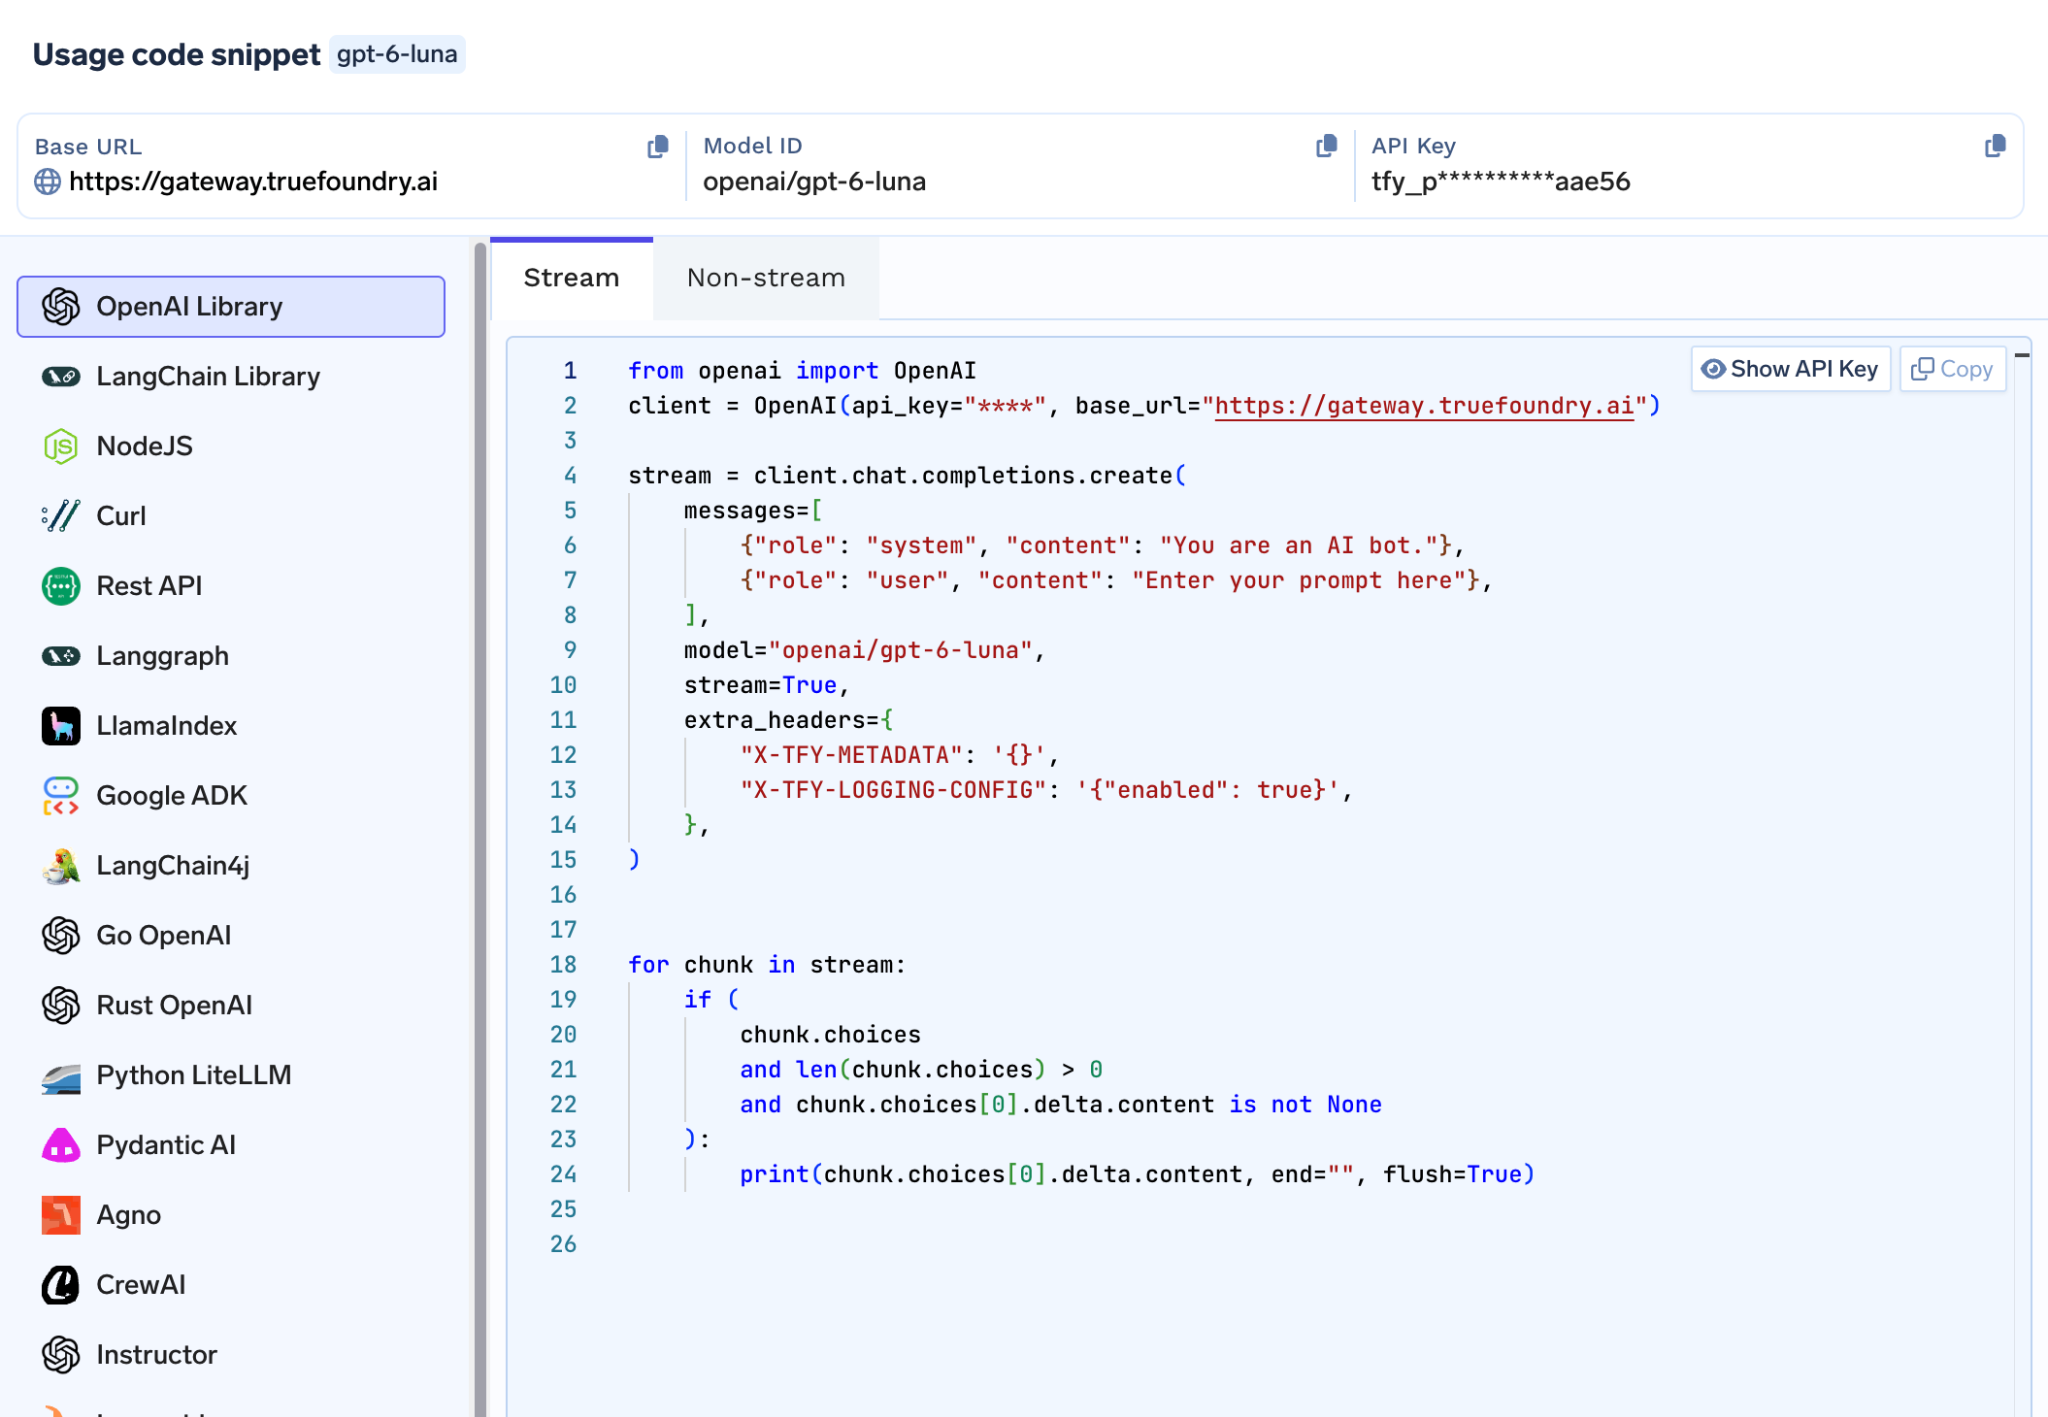
Open de Playground, kies een model en kopieer het gegenereerde fragment in de SDK die je gebruikt (OpenAI SDK, LangChain, Node.js, cURL en andere). De OpenAI Python-versie:
Model-ID's gebruiken een namespace zoals <jouw-provider-account>/<model>, dus anthropic-prod/claude-opus-5-5 en openai-prod/gpt-6-luna zijn met één regel code onderling te verwisselen. De X-TFY-METADATA-header tagt elke aanroep, zodat de uitgaven per team of per functionaliteit zichtbaar zijn in de metrics-weergave.
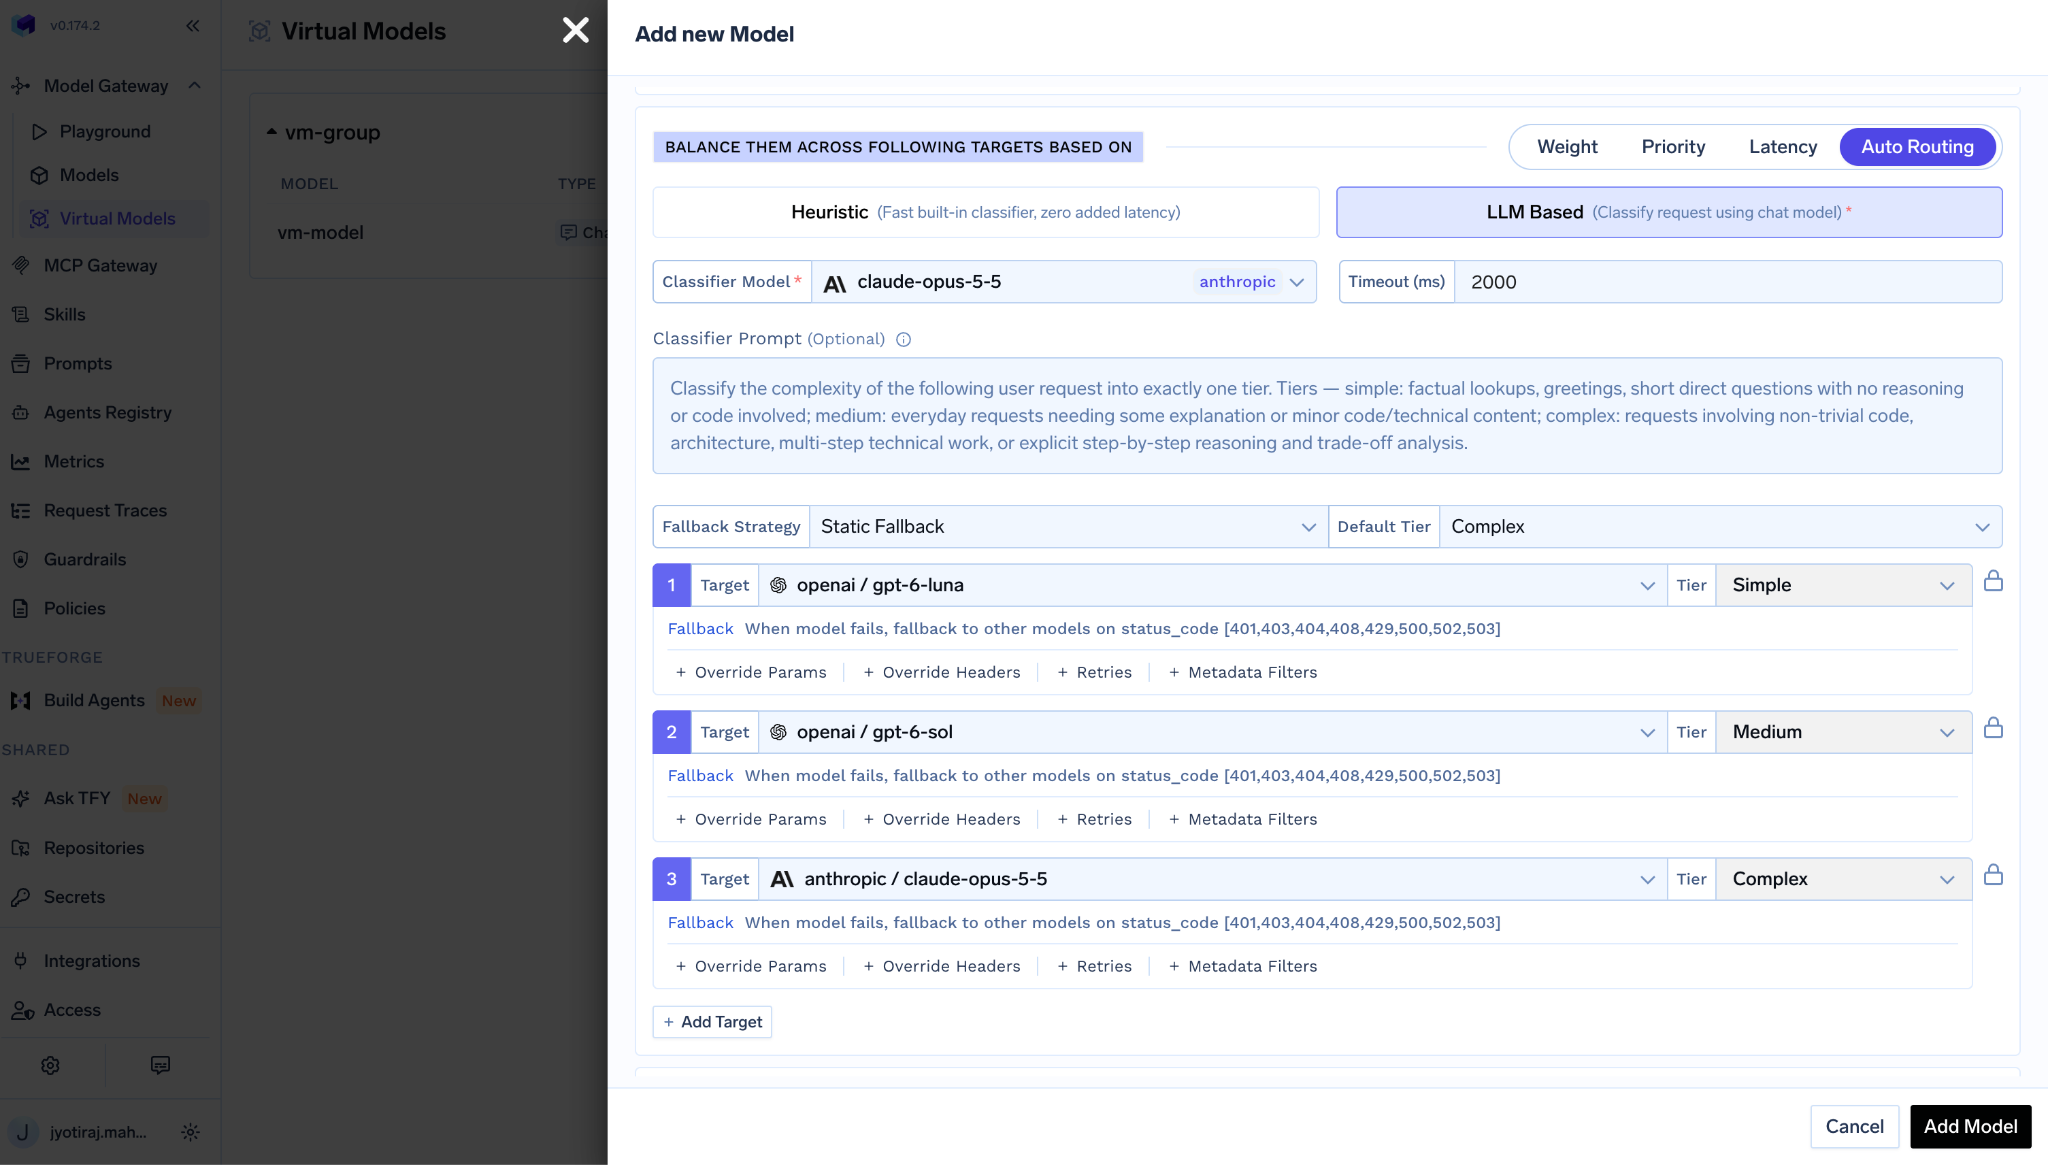
Maak een virtual model aan en kies Auto Routing. De gateway classificeert elk verzoek als eenvoudig, gemiddeld of complex en stuurt het naar het doel dat je aan die categorie hebt toegewezen. Luna voor eenvoudig, Sol voor gemiddeld en Opus 5.5 voor complex is een verstandige uitgangspositie. In onze benchmarks verlaagde dit type routing de kosten met 50-70% bij behoud van ongeveer 98% van de kwaliteit. Voeg Opus 5 of Astra toe als fallback-doel. Je toepassing roept in de hele code slechts één modelnaam aan.
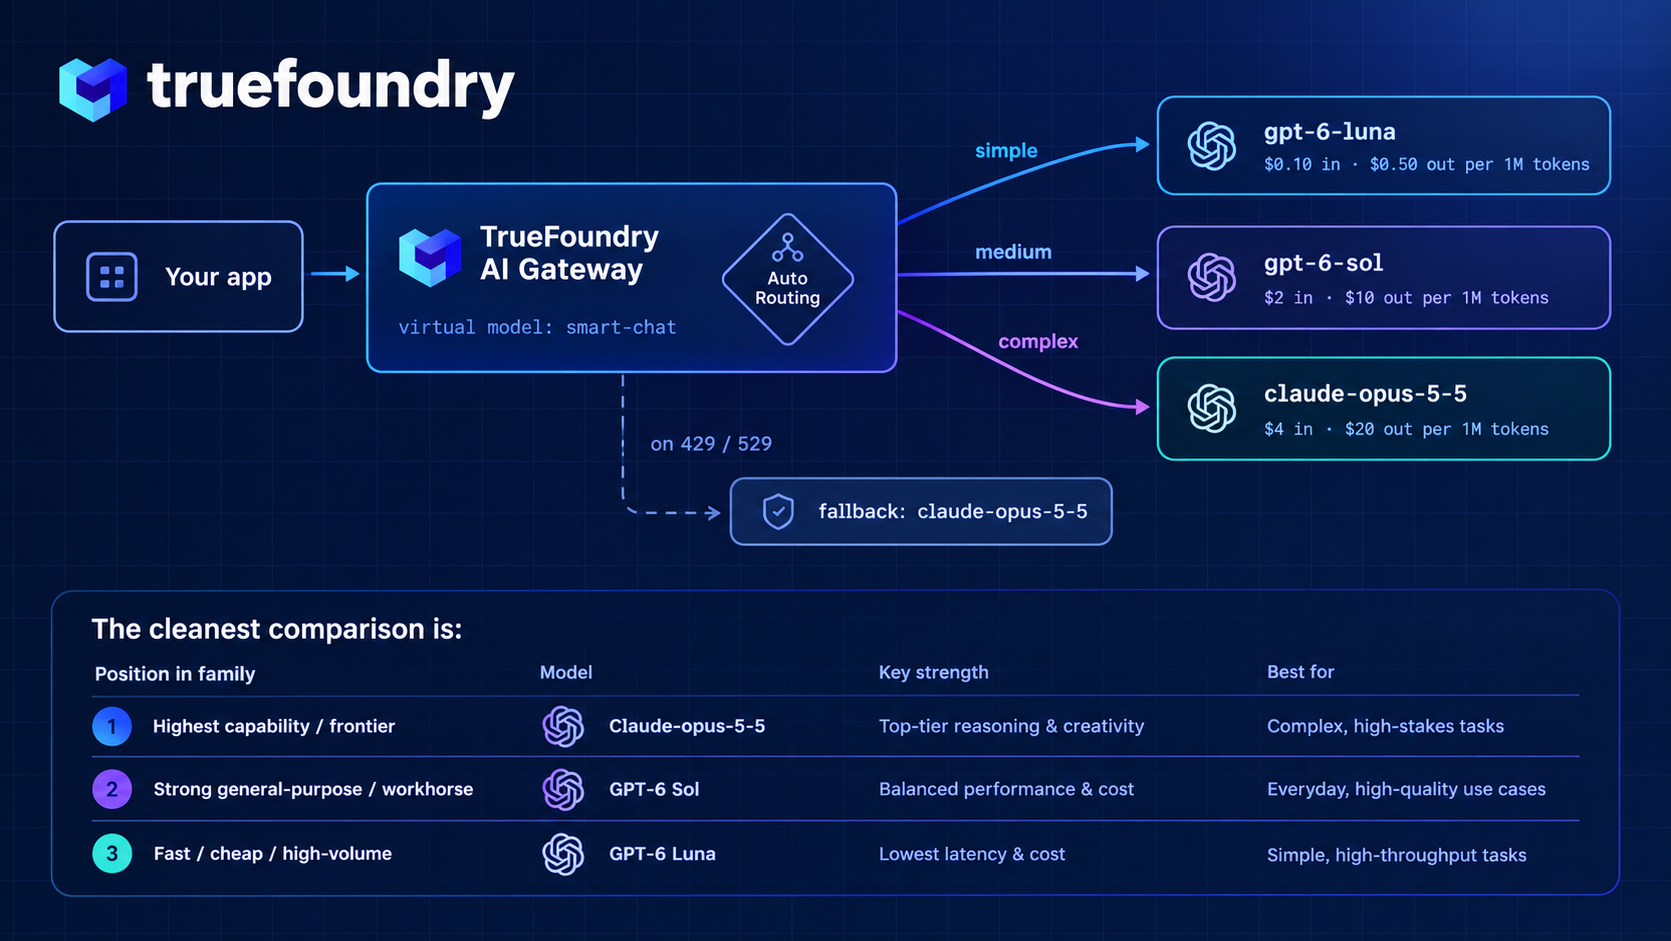
Opus 5.5 is het model dat je kiest wanneer de taak ingewikkeld is en de prijs van Fable niet te verantwoorden was. Sol en Luna kies je wanneer het helemaal niet ingewikkeld is. Door ze allemaal via TrueFoundry te laten draaien, blijft de keuze welk model wordt ingezet in de gateway-configuratie, waar je dit op dinsdagmiddag kunt aanpassen zonder een nieuwe deployment.
Probeer Claude Opus 5.5, GPT-6 Sol en GPT-6 Luna op de TrueFoundry AI Gateway →
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























