


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Smallest AIのText-to-Speech(TTS)およびSpeech-to-Text(STT)モデルは、ネイティブパススルーを介してTrueFoundry AI Gatewayと統合されます。リクエストは、バッチ合成および書き起こし(文字起こし)用にSmallest AIのRESTエンドポイントに送られ、チャンク化された音声出力およびリアルタイム書き起こし用に対応するServer-Sent Events(SSE)ストリームおよびWebSocketエンドポイントに送信されます。GatewayはクレデンシャルストアからSmallest AIのBearerトークンを置換し、アクセス制御を適用してOpenTelemetryスパンを出力した上で、リクエストをプロキシするかWebSocketをアップグレードします。
本記事では、TTSおよびSTTファミリーにわたるSmallest AIのAPIサーフェスについて解説します。また、GatewayプレーンがOpenAI非互換の音声エンドポイントに対してネイティブパススルーパスをどのように処理するかについても説明します。
Smallest AIは2つのモデルファミリーを提供しています。LightningはText-to-Speechファミリーであり、PulseはSpeech-to-Textファミリーです。どちらもバッチ利用のためのRESTエンドポイントおよびストリーミング利用のためのWebSocketエンドポイントとして動作します。
Lightning v3.1は、公表値で最初の音声出力までの時間(Time to first audio)が100 ms未満である44 kHzのTTSモデルです。ヒンディー語、タミル語、テルグ語、マラヤーラム語、カンナダ語、マラーティー語、グジャラート語などの強力なインディック言語(インド系言語)のカバー率に加え、英語、スペイン語、フランス語、ドイツ語、イタリア語、ポルトガル語、スウェーデン語、オランダ語を含む15言語をサポートしています。このモデルは、トークンごとではなく言語セグメント全体を並列生成する非自己回帰型(Non-autoregressive)アーキテクチャを採用しています。これにより、この低遅延特性が実現され、1 GB未満のVRAMでモデルを実行できるため、規制の厳しい環境でのオンプレミスデプロイが実用的になります。
このモデルは、3つのエンドポイント形式を通じて公開されています。
PulseはSTTに対応するモデルです。2つの形式で動作します。POST /waves/v1/pulse/get_textは事前録音された音声をバッチで処理します。WSS /waves/v1/pulse/get_textはライブストリーミング書き起こしを処理します。ストリーミングエンドポイントは、8000、16000、22050、24000、44100、または48000 Hzの音声フレームを受け付け、デフォルトのエンコーディングはlinear16です。36言語に対応し、language=multiによるコードスイッチング(言語の切り替え)が有効化されています。
Gatewayの背後に配置される統合にとって関心深いPulseストリーミングプロトコルの機能は、インラインのコンテンツコントロールです。redact_pii=trueは、確定した文字起こしデータがSmallest AIを離れる前に、個人識別情報(PII)を削除します。redact_pci=trueは、カード番号、CVVコード、郵便番号、口座番号を含むクレジットカード情報(PCI)を削除します。diarize=trueは話者分離(Diarization)を有効にします。keywordsはカンマ区切りのフレーズリストを受け取り、オプションの強調値を使用して製品名や医薬品名などのドメイン固有の用語の認識率を向上させます。itn_normalize=trueは逆テキスト正規化(ITN)を有効にし、確定した文字起こしデータ内の話された数字、日付、通貨を書面形式に変換します。これらのマスキング(Redaction)パラメータは、事後に下流のガードレールで文字起こしデータをスクラブするのではなく、プライバシー保護の適用をモデル層に押し出すため重要です。
コンカレンシーモデル。Smallest AIは、システムを構築する前に理解しておくべきユニークなコンカレンシーモデルを備えています。1つのコンカレンシーユニットは、任意の時点で処理できる1つのアクティブなTTSリクエストに対応します。TTSでは、1コンカレンシーユニットあたり最大3つのWebSocket接続を確立できます。したがって、3つのコンカレンシーユニットを持つテナントは9つのWebSocket接続を開いたままにすることができますが、同時にアクティブな生成を行えるのはそのうちの3つだけです。コンカレンシー制限に達している間にいずれかの接続を介して送信された追加のリクエストは、キューイングされずにエラーで拒否されます。これは典型的な1分あたりのトークン数(TPM)や1分あたりのリクエスト数(RPM)モデルとは異なり、Gatewayのレートリミッターをどのように設定すべきかに影響を与えます。STTの場合、1コンカレンシーユニットは1つのWebSocket接続となります。


TrueFoundry AI GatewayはHonoフレームワーク上に構築されており、ステートレスなポッドのフリートとして動作します。1 vCPUと1 GB RAMを備えた単一のポッドで、約3 msの追加遅延で250以上のRPSを処理します。コントロールプレーンはPostgreSQLとClickHouseで構成を管理し、NATS経由でGatewayポッドに更新を伝播します。Gatewayポッドはその構成をメモリにキャッシュするため、リクエストパスは認証、認可、ルーティングの決定のために外部呼び出しを行いません。
OpenAI互換プロバイダーの場合、Gatewayはアダプター内でインバウンドのOpenAIフォーマットとプロバイダーのネイティブフォーマット間の変換を行います。Smallest AIの場合、OpenAI Audio APIにはSmallest AIのvoice_id、pronunciation_dicts、session_idパラメータに相当するものがなく、Lightningのチャンク化された音声出力を配信するWebSocketストリーミングプロトコルに相当するものもないため、この変換は適合しません。したがって、Gatewayはネイティブパススルーを介してSmallest AIを提供します。
Smallest AIリクエストがGatewayポッドに到達すると、転送前パイプラインはチャット補完(Chat completions)と同じチェックを実行します。リクエストで提示されたJWTは、外部認証の呼び出しなしで、キャッシュされたIdP公開鍵に対して検証されます。認可は、ユーザーとモデルのインメモリマップに対してチェックされます。モデル識別子(lightning-v3.1またはpulse)は、設定されたSmallest AIアカウントに解決されます。インバウンドのAuthorizationヘッダーが削除され、クレデンシャルストアから取得したBearerトークンに置き換えられます。転送されるURLは https://api.smallest.ai/... となり、一致するパスとメソッドが保持されます。ボディは変更されずにストリーミングされます。WebSocketエンドポイントの場合、GatewayはSmallest AIのWebSocket URLに対してHTTP Upgradeハンドシェイクを実行します。アップグレードが成功した後、Gatewayは2つのWebSocket接続(クライアントとの接続およびSmallest AIとの接続)を保持し、ペイロードを解釈することなく両方向にフレームをプロキシします。X-External-Session-IdおよびX-External-Request-Idエコーヘッダーは、そのまま呼び出し元に通過します。
リクエストが完了すると、Gatewayは所要時間、ステータス、解決されたモデル名、およびコストメタデータを含むスパンをNATSにパブリッシュします。OTELエクスポーターは非同期パスから読み取り、gRPCまたはHTTP経由で設定されたバックエンドにスパンを転送します。アグリゲーターサービスは、ユーザーごと、チームごと、モデルごとにコストデータを集計します。

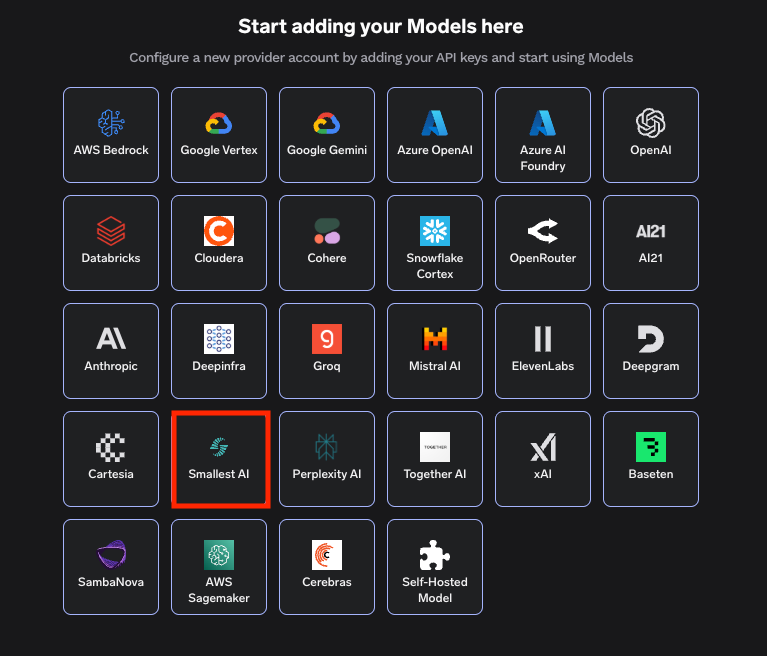
TrueFoundry AI GatewayにSmallest AIを追加するには、ダッシュボードで3つのステップを実行します。AI Gateway、Modelsの順に移動し、Smallest AIを選択します。一意のアカウント名とSmallest AIのBearerトークンを入力してアカウントを追加します。トークンはコントロールプレーンに暗号化されて保存され、Gatewayポッドに直接露出することはありません。オプションでコラボレーターを追加し、どのアカウントを介してルーティングできるユーザーやチームをコントロールします。次に、Add Modelをクリックし、表示名、モデルID、モデルタイプを指定して1つ以上のモデルを登録します。モデルIDは、Smallest AIのモデル識別子(lightning-v3.1、lightning-v2、またはpulse)と正確に一致する必要があります。
推論には、Smallest AI Python SDKまたは任意のHTTPクライアントを使用し、ベースURLをGateway URLに置き換えます。Pythonクライアントは以下のようになります。
パスを変更し、レスポンスをストリームとして読み取ることで、SSEエンドポイントに対しても同じ形式が機能します。WebSocketエンドポイントは、wssスキームでGateway URLを指向させることにより、任意の標準WebSocketクライアントを通じて動作します。TrueFoundryが発行したJWTが、Authorizationヘッダー内のSmallest AI Bearerトークンに置き換わります。GatewayはURLパスおよびX-External-Session-IdやX-External-Request-Id相関ヘッダーを含むレスポンス形式を保持するため、Smallest AIクライアントは、Smallest AIと直接通信している場合と同じレスポンスペイロードとヘッダーを確認できます。
エンドツーエンドのデータフローはシンプルです。クライアントは、Smallest AI Python SDKまたは一般的なHTTP/WebSocketクライアントのいずれかを使用して、Gateway URLに対してHTTPリクエストまたはWebSocketを開きます。Gatewayポッドは、キャッシュされたIdP公開鍵に対してJWTを認証し、モデル識別子を設定されたSmallest AIアカウントに解決します。インバウンドの認証ヘッダーを削除し、クレデンシャルストアからのBearerトークンに置き換えます。リクエストを https://api.smallest.ai に転送するか、WebSocketを対応する wss:// URLにアップグレードします。WebSocketセッションの場合、いずれかの側が接続を閉じるまで両方向のフレームをブリッジします。完了後、GatewayはNATSにスパンをパブリッシュし、これがOTELエクスポーターとコストアグリゲーターに送られます。
必要とされない部分が非常に重要です。Smallest AI SDKのフォークは不要です。境界で情報が失われるようなOpenAI Audio形式とSmallest AIのvoice_idおよびpronunciation_dictsパラメータ間の変換レイヤーは存在しません。チャットトラフィックのパイプラインとは別に音声トラフィック用のシャドートレースパイプラインが存在することもありません。アプリケーションコードやKubernetesシークレット全体に分散されるサービスごとのBearerトークンもありません。ストリーミングエンドポイントにアクセス制御を適用するために、Gatewayと一緒にデプロイしなければならない個別のWebSocketターミネーターも存在しません。PulseのPIIおよびPCIマスキングパラメータはGatewayをそのまま通過するため、プライバシー保護の適用は、下流のガードレールに分散されるのではなく、Smallest AIのマスキングパイプラインが実行されるモデル層に維持されます。
アーキテクチャ上の原則は、プロトコルセマンティクスとガバナンスセマンティクスの分離です。Lightningのチャンク化された音声ストリーミングとPulseのインラインマスキング付きストリーミング文字起こしは、他のプロバイダーに汎用化されない音声ドメインの意味を持っています。ガバナンス層(認証、認可、クレデンシャル注入、可観測性、コスト集計、チーム境界でのレート制限)はプロバイダーに依存せず、ペイロードを検査することなく任意のHTTPまたはWebSocketオリジンの前で動作します。ネイティブパススルーは、2番目を適用しながら1番目を保持します。その結果、Smallest AIのフル機能サーフェス(Lightningの15言語カバー率、インディック音声、PulseのPCIマスキング、明示的なコンカレンシーモデル)をクライアントが利用できるようになり、同時にAI Gatewayの残りの部分がチャットトラフィックに対して提供する運用保証が、同じGatewayポッド上、同じコントロールプレーン、同じトレースおよびコストバックエンドで音声トラフィックにも適用されます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























