


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
完全一致(Exact-Match)キャッシュは、過去30年間にわたり適切なデフォルトであり続けてきました。しかし、LLMにおいては不適切なデフォルトです。なぜなら、テキストは意図の表面的な現れに過ぎず、意図そのものではないからです。セマンティックキャッシュの役割は、その下にある本質をキャッシュすることにあります。
従来のAPIキャッシュはハッシュテーブルです。リクエストがハッシュ化され、レスポンスがそのハッシュに関連付けられ、次にバイトレベルで完全に同一のリクエストが来ると、キャッシュされた値が返されます。ハッシュがリクエストに関する重要な情報をすべて捉えているため、このモデルは決定論的なAPIに対して正しく機能します。コール内には、そのバイトデータに含まれていない情報が存在しないからです。
LLMワークロードは、この前提を根底から覆します。カスタマーサポートのフローにおいて、3人のユーザーが異なる表現で同じ質問をするケースを考えてみましょう。
ユーザーのトラフィック · 60秒のウィンドウ
-- ユーザー A: 「パスワードの再設定方法を教えてください。」
-- ユーザー B: 「パスワードを忘れました。どうすればいいですか?」
-- ユーザー C: 「パスワード再設定ページはどこにありますか?」
SHA-256キャッシュにとって、これらは3つの異なるキー、3つのキャッシュミス、そして3回のプロバイダー呼び出しとなります。しかしモデルにとって、意図は同一であり、返されるべきレスポンスも同一です。生テキストをハッシュ化するキャッシュは、誤ったキャッシュというわけではありません。意味の異なるレイヤーに対して適用されているキャッシュなのです。テキストは意図を表現する際に情報が欠落しやすい媒体であり、同じ意図でも多様な表現が存在します。そのため、完全一致キャッシュは本質ではなく表面的なテキストをキーにしてしまいます。
このギャップは無視できないほど大きなものです。バイト単位で一致するリクエストにしかヒットしないキャッシュは、意図にヒットするキャッシュが捉えられる呼び出しのごく一部しかカバーできません。このギャップを埋めることこそが、セマンティックキャッシュの目的です。
プロダクション環境に対応したセマンティックキャッシュは、単に埋め込みを行って検索するだけでは不十分です。ポリシーの境界を強制し(異なるシステムプロンプトが衝突しないようにする)、テナントの分離を維持し、「左腕が痛む」と「右腕が痛む」を混同しないようにする必要があります。TrueFoundry gatewayは、これら4つの関心事を単一のホットパスに集約する4段階のパイプラインを実行します。
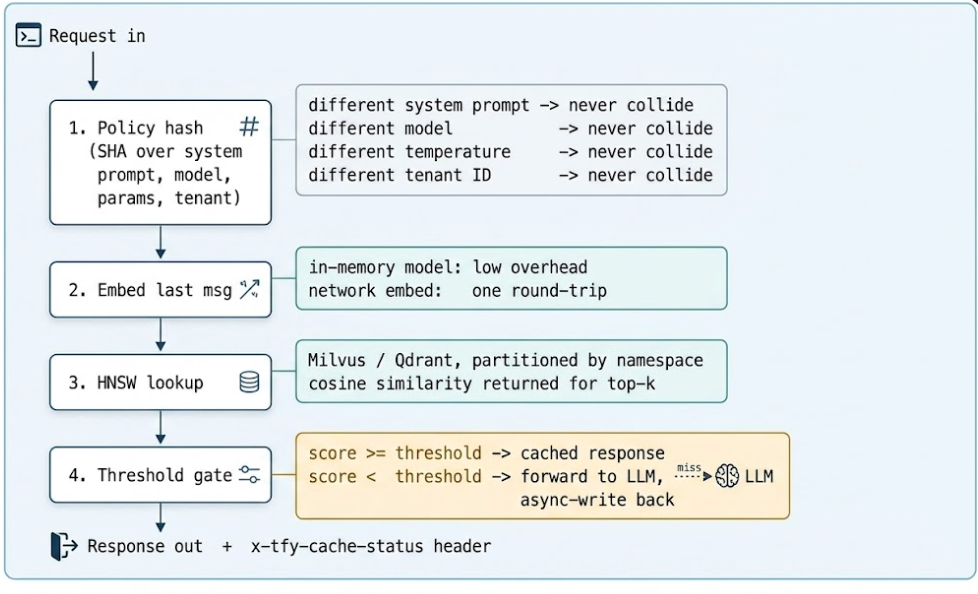
細かな注意点として、セマンティックに比較されるのは最後のメッセージのみです。モデル名、temperature、過去のメッセージ、システムプロンプト、テナントIDなど、その他の要素はすべて厳密にハッシュ化されます。これらのいずれかが一致しない場合、ユーザーの直近の発言が単語単位で同一であっても、キャッシュはそれらのリクエストを別物として扱います。これが正しいデフォルトの動作です。事前ロードされた会話コンテキストは、多くのエンジニアが予想する以上に意味を変化させるため、キャッシュはそれらを安易に統合しないよう安全側に倒す必要があります。
埋め込みベクトルは、MiniLMで384次元、BGE-baseで768次元、text-embedding-3-smallで1536次元という高次元空間に存在します。このような幾何学空間では、ユークリッド距離はベクトルの大きさに左右されやすく、その大きさの多くはノイズとなります。意味的な内容を保持しているのはベクトルの方向です。余弦類似度(Cosine similarity)は、2つのベクトル間の角度のコサインを計算することで大きさを正規化します。スケールに依存しないため、長さに関わらず同じ方向を指す2つのベクトルのスコアは1.0になります。
現代のセマンティックキャッシュはすべて余弦類似度を使用しています。ユークリッド距離を検討するのは、使用する埋め込みモデルが最初から単位正規化されたベクトルを出力する場合のみですが、その場合でも2つの指標は定数を除いて等価であり、余弦類似度の方が概念として理解しやすいことに変わりありません。実用的なワークロードにおいて、ユークリッド距離が最適な解となるケースは存在しません。
単純な最近傍探索はO(N)の計算量を持ち、すべてのクエリをすべてのキャッシュ済みベクトルと比較します。エントリー数が100万件に達すると、計算コストが許容できなくなります。HNSW(Hierarchical Navigable Small World)は、各ノードが少数の近い隣接ノードと接続する階層型グラフを構築し、上層ほどリンクが疎になります。クエリは最上層からスタートし、最も近いマッチに向かってグリーディに探索を進め、階層を降りながら処理を繰り返します。この検索ではO(log N)のノードを訪問します。これは近似検索ですが、厳密検索に対して通常95〜99%の再現率を維持しつつ、計算コストを数桁削減できます。MilvusとQdrantはどちらもHNSWを備えており、TrueFoundryはデプロイ時に構成されたいずれかのデータベースを使用します。
セマンティックキャッシュは計算リソースと引き換えにレイテンシとプロバイダーコストを削減するため、埋め込みモデルの選定はシステムにおいて最も重大な決断となります。実質的な選択肢は2つあります。
マネージドモデル(OpenAIのtext-embedding-3-small、Cohere、Voyageなど)は、箱出しで強力なドメイン横断的な意味理解を提供します。ただしコストとして、リクエストごとにネットワークの往復が発生し、キャッシュによるレイテンシ削減効果を直接相殺してしまいます。TrueFoundry SaaSでは、text-embedding-3-small(1536次元)がデフォルトとなっており、ユーザーによる変更はできません。これはマネージドティアにおける意図的な選択であり、すべての呼び出しに対して十分安価に償却できる実績のあるベースラインを提供するためです。
インメモリの代替案(BGE-micro:384次元、all-MiniLM-L6-v2:384次元など)は、gatewayプロセス内部で動作し、ネットワーク依存を完全に排除して、リクエストパスから埋め込み処理の往復時間をなくします。オンプレミスティアでは、埋め込みモデルはダッシュボード(Controls → Settings → Semantic Cache)から設定可能であり、この設定はgateway全体に適用されます。コーディングアシスタント、技術ドキュメント、カスタマーサポートフローなどの社内向けワークロードでは、ドメイン固有のボキャブラリーに基づいて小型のローカルモデルをファインチューニングすることが、スタック全体で最も投資対効果(ROI)が高い施策となります。「k8s」と「Kubernetes」は、ほぼ同一のベクトルに埋め込まれるべきです。汎用モデルはこれらを類似語として扱いますが、ファインチューニングされたモデルは同義語として扱います。これによりヒット率が大きく向上します。
次元数に関する実用的な観察結果があります。より高次元の埋め込み(1536次元)は多くのセマンティック情報を保持しますが、インデックス作成と検索のコストが高くなります。1536次元のHNSWは、384次元と比較して約4倍のメモリと2倍の検索時間を消費します。大半のキャッシュワークロードにおいて、ファインチューニングされた384次元モデルに対する1536次元の僅かな再現率の向上は、運用上のコスト削減効果と比較すると微小なものです。まずは384次元から開始し、実際のトラフィックでの精度と再現率の計測結果によって正当化された場合にのみ、次元数を上げるようにしてください。
表1 — 埋め込みモデルは、セマンティックキャッシュがレイテンシの短縮につながるか、それとも相殺されるかを左右する調整弁です。プロダクション環境においては、インメモリの経路こそが投資回収を実現する手段となります。
類似度の閾値は、コスト削減とリスクのバランスをとるスライダーです。閾値を下げるとヒット率が上がりコストが下がりますが、誤判定(false hit)が発生して、古くなった回答や文脈にそぐわない誤った回答を返すリスクも高まります。この設定はリクエスト内のx-tfy-cache-configで指定します。
HTTP · リクエストヘッダー
TrueFoundryが推奨する初期値は0.9であり、不適切なキャッシュヒットの許容度に応じた範囲を設定します。
表2 — 閾値の範囲。万人に共通する「正解」の値は存在しません。適切な閾値とは、対象ドメインにおける誤判定のコストに見合った値のことです。
医療トリアージの思考実験は、この危険性を具体的に表しています。「左腕が痛む」と「右腕が痛む」は、汎用的な埋め込み空間において0.91のスコアを記録することがあります。閾値を0.90に設定している場合、キャッシュは物理的に反対の2つの状態に対して全く同じアドバイスを返してしまうことになります。一般的なFAQボットであれば0.88でも完全に安全かもしれませんが、医療トリアージにおいては致命的な誤りとなります。閾値はグローバルなハイパーパラメータではなく、誤った回答の「リスクコスト」をワークロードごとにエンコードしたものです。
閾値を選択することは、独自のトラフィックに合わせた精度/再現率曲線上の1点を選択することを意味します。以下は、カスタマーサポートのワークロードにおける典型的な曲線の例です。実際の曲線は左右にシフトする可能性がありますが、形状は同様になります。
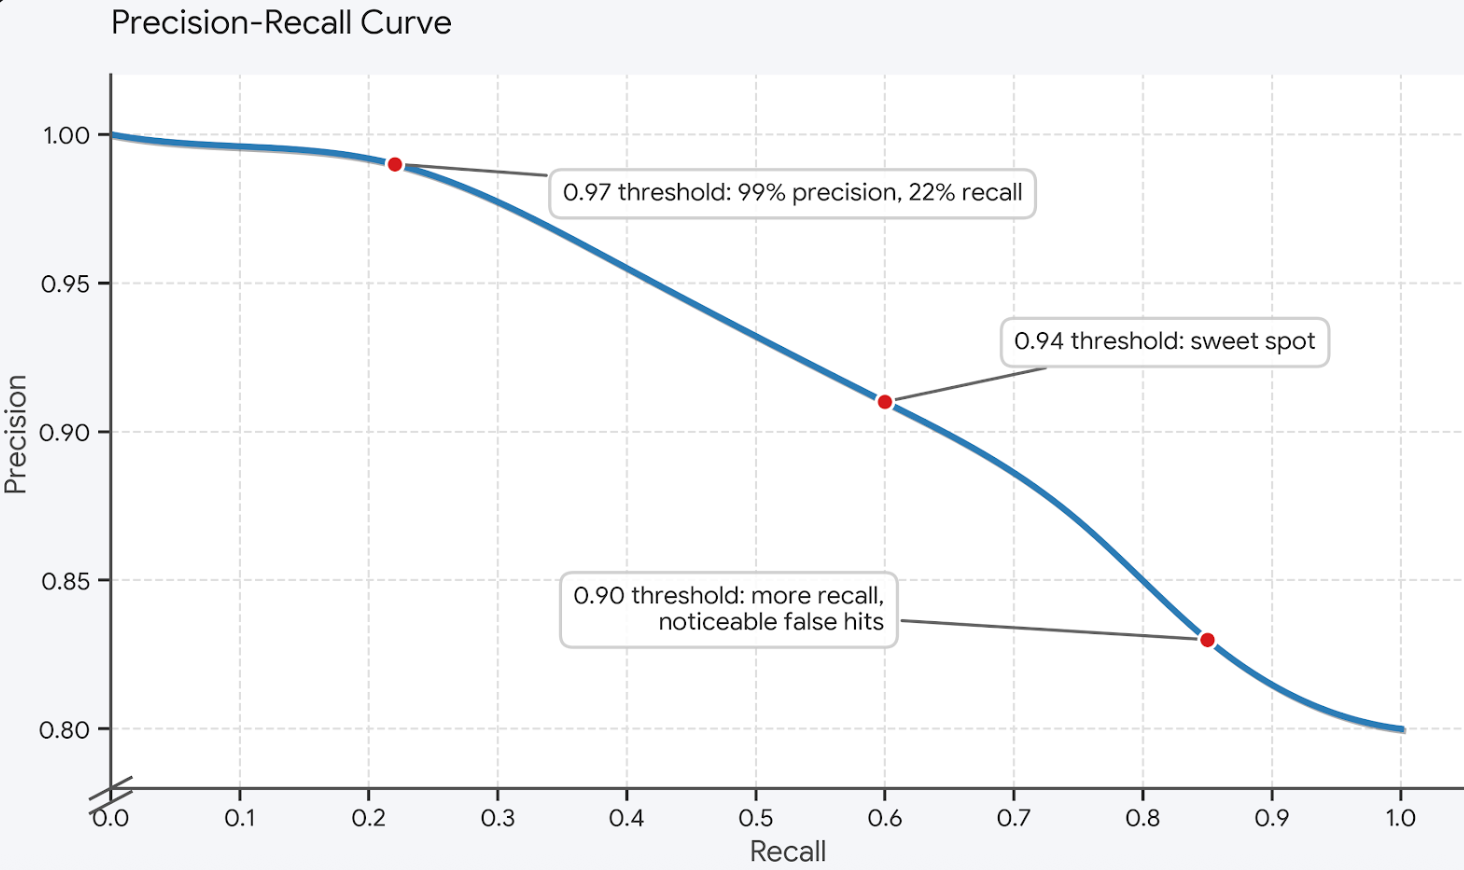
動作点を決定するための適切なアプローチは「シャドーモード」の運用です。一定の期間(通常は1週間)、キャッシュは類似度を計算し、実際にキャッシュされたレスポンスを返すことなく、各閾値で何がマッチしたかをログに記録します。エンジニアはそのログをレビューし、実際のトラフィックに対して上記の曲線をプロットした上で、ワークロードが許容できるレベルまで誤判定を抑えられる閾値を選択します。閾値は不変の定数ではなく、ワークロードごとに調整すべきノブであり、その調整用データは合成クエリではなくプロダクションのトラフィックから取得しなければなりません。
gatewayはレスポンスごとに、このループのデバッグを容易にする3つのヘッダーを返します:x-tfy-cache-status(hit / miss / error)、x-tfy-cache-similarity-score(ヒット時のコサインスコア)、およびx-tfy-cached-trace-id(そのエントリーを生成したオリジナルのリクエストのトレースID)。3つ目のヘッダーは最も頻繁に使用することになるもので、キャッシュされた回答をそれが生成された元の会話まで遡って追跡できます。これは、誤キャッシュのトラブルシューティングにおける唯一の手法です。
前提となる事実が変わった場合、セマンティック類似度は危険なものとなります。「今日の金利は?」という昨日のクエリと今日のクエリは、意味的には同一ですが、事実としては異なります。キャッシュは、1.0の類似度スコアとともに先月の数字を誤って返してしまう可能性があります。
ワークロードには、それぞれに適したTTLの設定が必要です。静的なドキュメントアシスタントの場合、前提となる事実はドキュメントであり、それが更新されるのはリリース周期に合わせられるため、数日単位の長いTTLを安全に設定できます。RAGアプリケーションでは、ドキュメントハッシュによる無効化メカニズムを使用します。ソースドキュメントが変更されると、それから派生したすべてのキャッシュエントリーが自動的にパージされます。時間的な鮮度が求められる事実(金利、価格、スケジュールなど)には短く厳格なTTLを設定し、日を跨いで統合されないようにします。このようなデータに対しては、セマンティックキャッシュ自体が不適切なツールである場合が多く、完全一致キャッシュを使用するか、キャッシュを一切使用しない構成へと切り替える必要があります。
セマンティックキャッシュが不得意な領域について、正しく認識しておくことが重要です。時間の経過とともに変化すべき情報は、どの閾値であってもキャッシュに適していません。判断の基準として「人間が古さに気づくような回答であれば、キャッシュにとっても古い」と考えるとよいでしょう。
運用上で明示的に対策すべきハザードとして、「キャッシュスタンプード(Cache Stampede)」が挙げられます。人気のあるクエリの期限が切れ、同じ秒数内に1,000件の同一リクエストが到着した場合、単純なキャッシュの実装では1,000件すべてをLLMに通過させ、その1,000件すべてが結果を書き戻そうとします。TrueFoundry gatewayはシングルフライト(Single-Flight)セマンティクスを使用します。キャッシュミスした最初の1つのリクエストがキーごとのロックを取得し、LLMの呼び出し中に到着した後続の同一リクエストは、その1つのレスポンスの完了を待って結果を再利用します。書き込み処理は非同期で行われるため(レスポンスはクライアントに即座に返され、ベクトルの保存はバックグラウンドでMilvus/Qdrantにコミットされます)、キャッシュの書き込み処理がリクエストパスのレイテンシに影響を与えることはありません。
B2BのSaaS環境において、テナントAがテナントB向けに生成されたキャッシュレスポンスを受け取ることは、単なるバグではなくセキュリティインシデント(情報漏洩)に該当します。キャッシュアーキテクチャは、事後的なフィルタリングではなく、構造的にそのような事態を防止する設計になっていなければなりません。
TrueFoundryは2つのレベルでキャッシュエントリーを分離しており、ユーザーは最初のレベルについて意識する必要はありません。
ほとんどのチームにとってはレベル1で十分です。レベル2は、1つのバーチャルアカウントから複数のダウンストリームエンドユーザーに展開するケース(自社顧客に代わってLLMリクエストをプロキシするSaaSなど)で、データ保持の誓約に従って顧客ごとのキャッシュ管理が必要とされる際に活用されます。いずれの場合も、データが漏洩するような共有のベクトルプールは存在しません。この実装により、SOC 2やHIPAAの監査要件をクリアすることができます。
AnthropicとOpenAIは、いずれもプロンプト側のキャッシュ機能を提供しています。プロバイダーはシステムプロンプトのプレフィックスをハッシュ化し、キャッシュヒット時に内部状態を再利用することで、キャッシュされた入力トークンの利用料を割り引きます。これは本稿で解説してきたレイヤーとは異なるものであり、両者は相互に補完し合います。
プロバイダーのプロンプトキャッシュは、最初のトークンが出力されるまでの時間(TTFT)を短縮し、キャッシュされた入力トークンのコストを下げますが、モデルは依然として新しい生成処理を実行します。一方、gatewayのセマンティックキャッシュは、モデルの呼び出し自体を完全に排除します。一方の恩恵を受ける多くのチームは両方の恩恵を受けることができ、gateway側のキャッシュの方がより大きな効果をもたらします。ヒット時には桁違いのレイテンシ削減と完全なコスト排除を実現でき、プロバイダーに依存することなく組織内でデバッグ、監査、チューニングが可能なレイヤーとなります。プロバイダーのキャッシュはブラックボックスですが、gatewayのキャッシュは自社の管理下に置くことができます。
分散システムにおける古い知見として、「キャッシュは、それが捉えるように設計された意味のレイヤーにおいてのみ正当性を保持する」というものがあります。ページキャッシュが機能するのは、ページが正当性の単位だからです。クエリキャッシュが機能するのは、同一のクエリが同一の結果を生み出すからです。テキストをハッシュ化するLLMキャッシュは、誤った意味のレイヤーでキャッシュを行っており、その不整合はヒットすべき場面でのキャッシュミスという形で表面化します。
セマンティックキャッシュとは、キャッシュキーをテキストから「意図」へと移行させる取り組みです。意図は文字列よりも抽象的なオブジェクトであるため、より多くのインフラ(埋め込みモデル、ベクトルインデックス、閾値)を必要とします。しかし、これはLLMのワークロードにとって適切な抽象化であり、キャッシュレイヤーが意味のレイヤーと一致すれば、コスト削減は単なる最適化ではなく、最初からあるべき正しいアーキテクチャのように感じられるようになります。
いいえ、必要ありません。セマンティックキャッシュは完全一致の機能を完全に包含しています。完全一致とは、単に余弦類似度が1.0の状態を指します。TrueFoundryでキャッシュタイプをsemanticに設定した場合でも、完全一致のヒットが返されます。2つのレイヤーを別々に運用することは、無効化処理を複雑にする無駄なインフラ重複であり、gatewayはこれらを単一のレイヤーとして処理します。
大半のリクエストがキャッシュミスするワークロードにおいて、ネットワークホスト型の埋め込みモデルを使用している場合にのみ、そのリスクが生じます。gatewayノード上で軽量なインメモリモデルを実行する最大の目的は、埋め込みコストを抑え、キャッシュヒット時の利点を消してしまわないようにすることです。SaaSティアでは、デフォルトの埋め込みモデルとしてtext-embedding-3-smallが使用され、約1回のネットワーク往復が追加されます。これは自前で埋め込みインフラを運用しないためのコストとして整理されます。
少なくとも1週間はシャドーモードで運用してください。実際のトラフィックに対してどのような結果が返されるかを確認せずに、閾値を本番環境に適用しないでください。同じ質問であっても、テストデータと本番データではスコアが僅かに異なる場合があり、これを見落とすと大きなトラブルにつながります。ログの取得とJupyter notebookでの検証を行えば、この問題は完全に回避できます。
キャッシュの判定は、モデルの呼び出しが始まる前の段階で事前に実行されます。キャッシュヒット時には、ストリーミングの遅延なしに即座にレスポンスが返されます。キャッシュミス時には、ストリーミングレスポンスが非同期でキャプチャされ、呼び出しが完了した後にキャッシュへコミットされます。そのため、ストリーミングとキャッシュの間でトレードオフを意識する必要はありません。
gatewayはフォールバック処理を行い、すべてのリクエストをLLMプロバイダーへ転送します。キャッシュミスのコストはキャッシュが存在しない場合と同じになり、システム全体が停止することはありません。運用上のシグナルとしては、レスポンスのx-tfy-cache-status: errorヘッダーのみとなり、これに対してダッシュボードのアラートを設定しておく必要があります。リクエストパスの信頼性は、キャッシュレイヤーの可用性よりも優先されます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























