


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Anthropicは2024年11月にModel Context Protocol(MCP)を発表しました。それから1年以内に、ほぼすべてのAPIツールベンダーやいくつかの独立系ジェネレーターが、OpenAPI仕様(spec)を動作可能なMCPサーバーへと機械的に変換する手法を提供し始めました。基本的なマッピングの大部分はシンプルで明確です。パスはツール名になり、パラメーターは入力スキーマになり、成功レスポンスは出力スキーマになります。興味深いのは、ページネーション、マルチパートアップロード、Webhook、ストリーミングレスポンスといった、マッピングで情報が欠損する部分や、生成されたサーバーが実際に利用可能かどうかを左右する運用上のコンポーネント(認証のインジェクション、スキーマ検証、説明文の品質)です。本記事では、変換アルゴリズムの全容と、単純に変換できない特定のパターンについて詳しく解説します。
Northwind社でのある火曜日の出来事。 ロジスティクス・プラットフォームチームでインテグレーションリードを務めるPriyaは、「shipment-tracking-svcをルーティング最適化エージェントから呼び出せるようにする」というチケットを受け取りました。このサービスには47個のRESTエンドポイントがあり、維持管理されているOpenAPI 3.1 spec、OAuth2認証、カーソルベースのページネーション、2個のWebhookエンドポイント、およびトラックのライブテレメトリー用のストリーミングエンドポイントを備えています。エージェントのMCPツールボックスには現在、他の3つのサービスにわたる12個のツールが登録されていますが、これらはそれぞれ約1週間かけて手動でコーディングされたものです。そのペースで47個のエンドポイントに対応しようとすると、開発期間の大半を費やすことになってしまいます。
OpenAPI specには、パス、パラメーター、スキーマ、レスポンス形状、さらには操作ごとのOAuth2スコープに至るまで、すでに機械読取可能な形式でサービスが定義されています。彼女がこれまで行ってきた手動のコーディングは、specにまだ含まれていない情報を新しく追加していたわけではありません。その作業の大半は、明確に定義された少数のエッジケースに対応しながら、あるスキーマ言語から別のスキーマ言語へ翻訳することでした。そのような作業は開発期間を費やすべきものではなく、ビルドステップに委ねるべきものです。
本記事では、正しくマッピングできる要素、できない要素、そして生成されたサーバーを実際に使用可能にする運用上のコンポーネント(認証、検証、説明文の品質)を含む変換アルゴリズムについて解説します。
変換処理では、OpenAPIドキュメントを走査し、(パス, メソッド)のペアごとに1つのMCPツールを出力します。ペアごとに、ツール名、説明文、入力スキーマ、および(ターゲットMCPリビジョンがサポートしている場合は)出力スキーマの4つの項目を算出します。
ツール名。 specの作成者が提供している場合は、operationIdを優先します。operationIdは慣習的な識別子であり、通常は可読性を考慮して選択されています。存在しない場合は、メソッドとパスから合成します。メソッド名を小文字にし、英数字以外の文字をアンダースコアに置換したパスを末尾に追加し、重複するアンダースコアを縮小します。GET /users/{user_id}/reposはget_users_user_id_reposになります。合成された形式は文法的には正しいものの冗長になりがちなため、operationIdが存在する場合は常にそれが優先されます。
ツールの説明文。 summary、description、メソッド+パスから生成されたスタブの順で優先して使用します。一見重要ではなさそうなこのフィールドが、なぜ予想以上に重要であるかについては第6章で解説します。
入力スキーマ。 パスパラメーター、クエリパラメーター、およびリクエストボディのスキーマを単一のJSON Schemaオブジェクトに統合し、適切なrequired/optionalのフラグを設定します。詳細は第2章で解説します。
出力スキーマ。 application/jsonに対する最初の2xxレスポンスに定義されているスキーマです。その他のコンテンツタイプや2xx以外のレスポンスは表現されません。詳細は第3章で解説します。
YAML — OpenAPIパスアイテム(shipment-tracking-svcからの抜粋)
JSON — 生成されたMCPツール
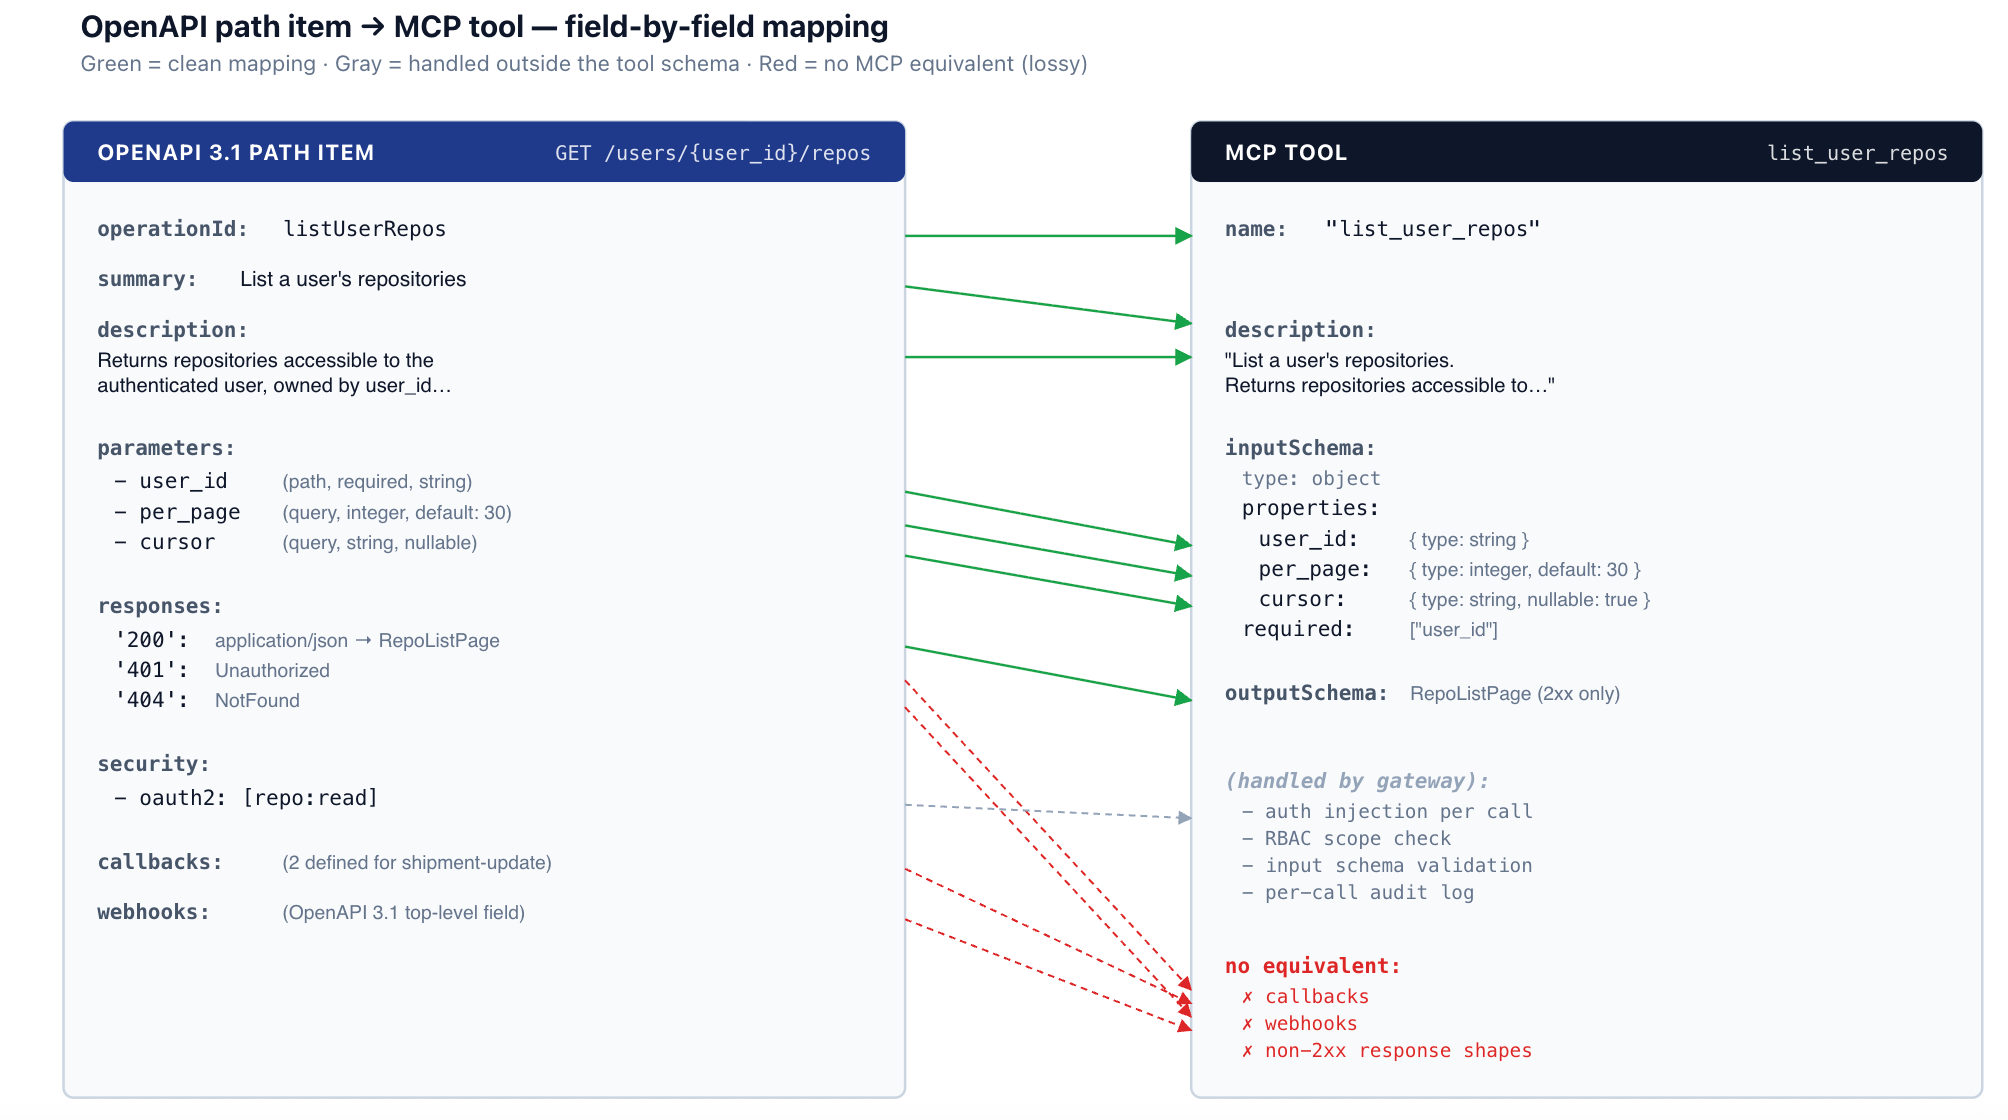
パスパラメーターは常に必須であり、入力スキーマ内の必須エントリーになります。クエリパラメーターは明示的に必須と指定されていない限りオプションとなり、デフォルト値が存在する場合はそれが引き継がれます。ヘッダーは通常、エージェント向けの入力からは除外されます(エージェントがContent-Typeを選択すべきではないため)。ただし、意味のある情報を保持するヘッダー(X-Org-Id、X-Idempotency-Keyなど)は明示的な例外とされます。
application/jsonのリクエストボディは、入力スキーマ内のネストされたオブジェクトにマッピングされます。リクエストボディ全体が1つの構造化された引数となり、通常はボディスキーマの$refにちなんで命名されます(したがって、#/components/schemas/CreateRepoRequestを参照するリクエストボディは、"create_repo_request"プロパティになります)。OpenAPIのリクエストボディはすでにJSON Schemaであり、入力スキーマもJSON Schemaであるため、この変換は実質的にコピー処理となり、最も明確なケースとなります。
multipart/form-dataおよびapplication/x-www-form-urlencodedは、部分的にサポートされるケースです。MCPツールはJSON引数を受け取るため、生成されたサーバーは転送前にJSONを適切なボディ形式に再シリアライズする必要があります。マルチパートを使用する最も一般的な理由であるバイナリファイルのアップロードには、完全に対応する機能が存在しません。MCPはbase64エンコードされた文字列を渡すことができますが、ほとんどのAPIはマルチパートのエンドポイントでそれを受け入れません。バイナリのアップロードに対する現実的な解決策は、生成されたツールではなく手動でコーディングされたツールを使用することです。
ツールの出力スキーマとして公開されるのは成功レスポンスのみです(かつ、ターゲットMCPリビジョンがoutputSchemaをサポートしている場合に限られます。このフィールドは2025-06-18のspecリビジョンで追加されたため、それより古いランタイムでは無視されます)。変換処理では、application/jsonコンテンツに対する最初の2xxレスポンス(200、201、202)を選択します。その他のコンテンツタイプは公開されず、2xx以外のレスポンスは代替の出力形状としてではなく、ツールエラーとしてエージェントに返されます。
これには微細な影響があります。エージェントに見えるのは成功パスのレスポンス形状のみであり、構造化されたエラーレスポンス形状は見えません。これはほとんどの場合適切な挙動ですが(エージェントがエラーレスポンスのスキーマに基づいて計画を立てることは実用的ではないため)、エラー処理が型定義されたものではなく、汎用的なもの(HTTPステータスコードとメッセージ)にならざるを得ないことを意味します。詳細な構造化エラー(検証の詳細、部分的な成功のレスポンス)を持つAPIの場合、この処理によって情報が失われます。
また、ここでページネーションの不整合が最初に発生します。ページネーションされた一覧表示エンドポイントの出力スキーマは、概念的なリスト全体の結果ではなく、単一ページのレスポンス形状になります。ツールを呼び出すエージェントが得られるのはリスト全体ではなく1つのページのみであり、これが次のセクションの課題へとつながります。
REST APIはページネーションを行います。一方、MCPツールはプロトコルの設計上、単一の結果を返します。これらを調和させることが、変換における最も困難な判断となります。現実的な選択肢は3つあり、それぞれトレードオフが異なります。
ほとんどのジェネレーター(TrueFoundryのものを含む)は、デフォルトで選択肢 (a) を採用しています。これを機能させるためのポイントは、第6章で説明する説明文の品質です。ツールの説明文には、カーソルパラメーターの名前を指定し、「さらに取得するにはnext_cursorを指定して再呼び出しする」という指示を記載して、ページネーションのルールを明示的に記述する必要があります。これがないと、エージェントはほぼ確実に1ページ目だけを取得してタスクを終了してしまいます。
選択肢 (b) が適しているのは、エージェントがリスト全体を確実に必要とする、限定された小さなデータセット(50行の設定テーブル、固定されたリージョンリストなど)のみであり、それ以外のほぼすべてのケースでは不適切です。選択肢 (c) は、ページ移動の仕様が複雑な領域(カーソルの有効期限、スナップショット分離など)で採用され、ツールの表面積が大きくなるリスクを払ってでも明確に分離する価値がある場合に有効です。
生成されたMCPサーバーは、基盤となるAPIに対してHTTPリクエストを発行します。これらのリクエストには認証情報が必要です。アーキテクチャ上のルールとして、生成されたサーバー自体は認証情報を保持しません。認証情報はゲートウェイに存在し、呼び出し時にゲートウェイによって注入されます。
一連の流れは以下の通りです。
shipment-tracking-svcに対するツール呼び出しの認証インジェクションチェーン
これは、本シリーズの以前の記事で紹介したゲートウェイパターンを、特定の種類のMCPサーバーに適用したものです。この分離により、生成されたサーバーはステートレスかつ使い捨て可能なものになります。サーバーは純粋な変換処理のみを行い、認証情報、RBAC、監査ログ、およびレート制限は上位のレイヤーで処理されます。
自動生成された説明文は、文法的には正しくても、意味の面では非常に不十分です。"Get users user id repos" は、OpenAPI specにsummaryやdescriptionが存在しない場合に、GET /users/{user_id}/reposに対してジェネレーターが生成する文字列です。実際には、エージェントはこのような説明文からツールを適切に選択できない傾向があります。間違ったツールを選択したり、不適切な引数を入力したり、適切であったはずのツールをスキップしたりします。この影響は、似たような形状のエンドポイントが複数存在し、モデルが違いを識別するために説明文に依存せざるを得ないツールセットにおいて特に顕著になります。
パイプラインによる変換処理は、以下の3つのステップによって改善できます。
第一に、OpenAPIのsummaryフィールドとdescriptionフィールドを優先して使用します。優れたspec作成者はこれらを適切に記述しており、これらを使用するコストはかかりません。
第二に、summaryが存在しないか役に立たない場合は、LLMによる拡張処理を適用します。パス、メソッド、パラメーター、レスポンススキーマ、および任意のドキュメント文字列をコストの低いモデルに渡し、エージェントに適した説明文の生成を要求します。「認証されたユーザーがアクセス可能で、指定されたユーザーIDが所有するすべてのリポジトリを取得します。デフォルトで1ページあたり30件ずつページネーションされます。リポジトリ名、所有者、主要言語、最終更新タイムスタンプを含むリポジトリのメタデータを返します。」Claude Haiku 4.5の料金体系(入力1,000,000トークンあたり約1ドル、出力1,000,000トークンあたり5ドル)では、この拡張処理のコストはツール1つあたり約0.0005ドルであり、specが変更されたときにのみ実行すれば済みます。
第三に、不透明な引数については説明文に具体例を含めます。フォーマット文字列、IDの命名規則、およびEnum値は、多くの場合、曖昧さをなくすために具体例を必要とします。「user_idは数値のユーザーID(例: '12345')であり、ユーザー名ではありません。」
これを怠った場合のコストは、エージェントが実行されるたびに発生します。正しく設定するためのコストは生成時に1度だけ支払われ、それ以降のすべてのツール呼び出しにわたって減価償却されます。
自動生成を行う場合、specの品質がそのまま変換後の品質になります。実際に発生する一般的な問題は、概ね以下の順序で顕在化します。
これらはいずれも変換処理のバグではなく、specのバグが変換処理によって忠実に反映された結果です。現実的な解決策は、OpenAPIからMCPへの生成処理を「specの品質を強制的に向上させる手段」として捉えることです。十分にメンテナンスされていないspecを初めて再生成すると、品質の低いMCPサーバーが生成されますが、これは通常すぐに判明するため、specを修正するための十分な動機になります。この変換処理によって、OpenAPIドキュメントを単体で社内利用しているだけでは気づきにくいspecの品質が視覚化されます。
大規模なAPIに対して、1つのエンドポイントを1つのツールに単純変換すると、ツールリスト自体が問題になります。500個のエンドポイントを持つAPIからは500個のツールを持つMCPサーバーが生成されます。そのツールリストをエージェントのコンテキストに読み込むと、エージェントが有用な処理を開始する前に数万トークンを消費してしまい、利用可能なツール数が増加するにつれてモデルのツール選択精度が低下することが報告されています。Priyaが変換しているshipment-tracking-svcには47個のエンドポイントがあり、これは管理可能な範囲ですが、大規模なパブリックREST API(Stripe、GitHub、AWSなど)を丸ごと生成した場合はそうはいきません。
通常、以下の4つの実用的な戦略を組み合わせて対応します。
登録時のオペレーターレベルでのフィルタリング。 ほとんどのジェネレーター(TrueFoundryのものや、OpenAPIのx-mcp拡張機能を使用するopenapi-mcp-generator CLIなど)では、オペレーターが公開するエンドポイントを選択できます。「spec内のすべてを公開する」というデフォルト設定は、数十個を超えるエンドポイントが存在する場合には推奨されません。
タグベースのグルーピング。 OpenAPIのタグは論理的なグループにマッピングされます。ゲートウェイはタグセットごとに1つのMCPサーバーを公開できます(読み取り専用操作用の"shipment-tracking-reads"、破壊的属性を持つ操作用の"shipment-tracking-admin"など)。これはツールごとのRBACと自然に組み合わさり、読み取りを行うエージェントには読み取り用のサーバーのみが表示されます。
バーチャルMCPサーバー(TrueFoundryのパターン、他でも類似の概念が存在)。 複数の物理MCPサーバーにまたがる厳選されたツールのサブセットを集約する論理サーバーです。エージェントには、すべてのバックエンドの全ツールの集合ではなく、特定のタスクに特化した小規模なツールリスト(Stripe、社内請求書サービス、CRMから抽出された12個のツールを公開する"billing-agent-tools"など)が表示されます。
動的ディスカバリー。 エージェントは最初に完全なツールリストを読み込みません。代わりに、ゲートウェイは説明文に基づいてツールを検索またはフィルタリングできるメタツールを公開し、タスクに関連するサブセットのみを返します。これは実装や推論の設計がより複雑になりますが(エージェント自身が検索に対してスマートである必要があるため)、どのような静的フィルタリング戦略よりも大規模なスケールに対応できます。
適切な組み合わせはユースケースによって異なります。チームごとに特化したエージェントプラットフォームでは、通常、オペレーターフィルタリングとバーチャルMCPサーバーが使用され、動的ディスカバリーは回避されます。プラットフォーム全体のツールセットにわたって動作することが期待される汎用エージェントでは、静的な抽出だけでは十分にサイズを小さくできないため、最終的に動的ディスカバリーが必要になります。
OpenAPIで定義可能であっても、MCPにおいて完全に一致する代替機能が存在しない機能のリストです。
これらすべてに共通する現実的なパターンとして、OpenAPIの機能に対応するMCP機能が存在しない場合、変換処理は問題のあるツールを無言で生成するのではなく、そのエンドポイントを除外すべきです。本番環境で使用されるほとんどのジェネレーター(TrueFoundryのものを含む)は、変換時にこれらにフラグを立て、影響を受ける操作をスキップするか手動でコーディングするかについて、オペレーターに明示的なアクションを求めます。
生成されたMCPサーバーへのすべてのツール呼び出しは、ゲートウェイを通過します。ゲートウェイは、サーバーに転送する前に入力スキーマに対して呼び出し引数を検証し、型の不一致(数値が必要な場所に文字列が指定された場合)、必須フィールドの欠落(エージェントが必須のパスパラメーターを省略した場合)、Enum違反(エージェントがEnumセットに含まれない値を渡した場合)の3種のエラーを早期に検知します。
検証エラーは、基盤となるAPIからの生のエラー(400)としてではなく、エージェントが解釈可能な構造化された形式で返されます。
JSON — 不正なツール呼び出しに対してエージェントに返される検証エラー
なぜ生成されたサーバー内ではなく、ゲートウェイで処理するのでしょうか?理由は2つあります。第一に、一貫性です。自動生成されたものであれ手動でコーディングされたものであれ、すべてのMCPサーバーが同じ検証挙動を取得できます。第二に、ゲートウェイは生成されたコードを変更することなく、検証ポリシー(厳密 vs 寛容、カスタムエラーフォーマット)を適用できます。生成されたサーバーは、検証済みのリクエストを受け取り、HTTP呼び出しを発行し、レスポンスを返すという、最もシンプルな役割を維持できます。
ジェネレーターの使用は必須ですか?MCPサーバーを手動でコーディングしてはいけないのでしょうか?
エンドポイントが10個未満のAPIや、生成されたツールに対して大幅な事後処理(カスタム引数名、エンドポイントの統合、複雑なビジネスロジックなど)が必要な場合は、手動でのコーディングも合理的です。それを超える場合、通常は生成されたサーバーの方がメンテナンスコストが低くなります。APIにエンドポイントが追加された際、再生成によってそれが自動的に取り込まれるためです。手動でコーディングされたサーバーは徐々に乖離していきます。
生成されたサーバーのバージョン管理はどのように行いますか?
生成されたサーバーはビルド成果物であり、編集するソースコードではありません。OpenAPI specが変更されるたびに、理想的にはCI上で再生成を行います。operationIdが変更されない限りツール名は安定して維持されますが、これはspec作成者が維持すべき基本的なルールでもあります。以前のツールリストをキャッシュしている長期実行エージェントは、次のMCPディスカバリー呼び出し時に更新を検知します。
OpenAPI specが存在しないAPIの場合はどうすればよいですか?
最も難しいケースです。現実的な選択肢は3つありますが、いずれも完璧ではありません。(a) 実際のトラフィックやSDKのソースコードからspecを生成する(いくつかのツールがこれを実施していますが、精度にはばらつきがあります)。(b) 変換を行わず、MCPサーバーを直接手動でコーディングする。(c) OpenAPI specを手動で記述する。小規模なAPIの場合、選択肢 (c) は (b) よりも作業量が増えますが、大規模なAPIでは作業量が少なくなり、組織の他の部分でも利用可能なOpenAPI specが手に入るという副次的なメリットもあります。
これはAIゲートウェイのトレースごとのコスト帰属とどのように連携しますか?
MCP Gatewayを経由する各ツール呼び出しは、本シリーズの以前の記事で紹介したチームおよびアプリのメタデータを含むOTelスパンを発行します。ツールのレイテンシー、成功率、および基盤となるAPIに関連するコストは、呼び出し元のエージェントとチームに正しく帰属されます。
ジェネレーターの認証スコープとして適切な粒度はどのようなものですか?
ツール単位。OpenAPI 仕様のオペレーションごとのセキュリティ要件は、OAuth2 スコープ(またはその他の認証スキーム)のリストに変換され、ゲートウェイはこれをサーバー単位ではなくツール粒度で適用します。repos エンドポイントに対する読み取りスコープを持ち、書き込みスコープを持たないエージェントは、list_user_repos を呼び出すことはできますが、delete_repo を呼び出すことはできません。
TrueFoundry の役割
TrueFoundry の MCP Gateway は、ゲートウェイのコントロールプレーンで動作する OpenAPI-to-MCP ジェネレーターを搭載しています。変換は登録時に行われ、生成されたサーバーはゲートウェイがルーティングするマネージドプロキシとして実行されます。本記事で説明した認証インジェクションチェーン、スキーマ検証、RBAC、および監査ログは、生成されたサーバーがゲートウェイの背後に配置されることで継承するゲートウェイのプリミティブであり、登録された他のすべての MCP サーバーに適用されるものと同じプリミティブです。このジェネレーターは本番環境における選択肢の 1 つであり(Speakeasy、Stainless、FastMCP、およびいくつかのオープンソースの同等品も同様の変換を行います)、通常は、生成されたサーバーのホスト場所、チームの既存の認証および可視性(observability)との連携方法、およびチームが既に運用している環境によって選択が決まります。
1 エンジニア週あたり 47 個のエンドポイントを処理する場合、エンジニアリングのほぼ 1 四半期を費やすことになります。ジェネレーターを介した 47 個のエンドポイントの処理は、単なるビルドステップに過ぎません。残る作業(説明のキュレーション、エンドポイントごとのページネーション戦略の決定、変換できない半ダースほどのオペレーションの手動コーディング)は実際の作業ですが、範囲は限定的です。メカニクス(仕組みの構築)にエンジニアリングのリソースを割くべきではありません。
Northwind、Priya、および shipment-tracking-svc は例示用です。変換アーキテクチャ、マッピングルール、およびエッジケースは、本番環境の OpenAPI-to-MCP ジェネレーター(TrueFoundry、Speakeasy、Stainless、FastMCP、および複数のオープンソース同等品)の 2026 年 5 月時点における実際の動作を反映しています。OpenAPI および MCP の仕様は進化し続けており、より新しい機能(OpenAPI Webhook、MCP elicitations、readOnlyHint などの MCP ツール注釈)のマッピングは今後のリビジョンで変更される可能性があります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























