


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
エージェントが対話型セッションからCI/CDパイプラインに移行すると、人間によるペース調整メカニズムが消失し、ReActループによってコンテキストが二次関数的に増大します。プロバイダーの請求書は支出総額を示してくれますが、その理由や、開発速度を損なわずに削減すべき箇所までは教えてくれません。
対話型のAIセッションには、キーボードの前にいる人間という組み込みのペース調整メカニズムが存在します。人間はエージェントの出力を読み、次に何をすべきかを決定し、数分に1回程度のペースでプロンプトを消費します。このテンポは、ポリシーによって制限されていない場合でも、緩やかなレート制限として機能します。
CI/CDパイプラインにはそれがありません。自動化されたPRレビュー用に設定されたエージェントは、通常のコミットトラフィックによって1時間に数十回から数百回トリガーされる可能性があり、その環境には処理を遅らせる要素が一切存在しません。問題の計算はトリガーの頻度が示す以上に深刻です。コールごとのコスト自体が増大するためです。ReActのようなエージェント型フレームワークは、次の推論ステップの前に、すべての実行結果をコンテキストウィンドウに追加します。エージェント実行ごとのトークン消費量は、ステップ数に対しておおよそO(n²)で増加します。
。

AnthropicやOpenAIのダッシュボードは、組織が先週の火曜日に消費した正確なトークン数を教えてくれます。しかし、その理由は教えてくれません。プロバイダーにはアプリケーションのコンテキストが存在しないため、クリティカルな本番データパイプラインと、ジュニアエンジニアが無限ループさせているサイドプロジェクトを区別できません。どちらも同じように請求されます。
細やかな帰属情報(Attribution)がない場合、財務部門は利用可能な唯一の手段である「一括禁止」に依存せざるを得なくなります。AIの利用はレビュー完了まで一時停止されます。正当なワークロードも、暴走したワークロードとともに抑制されます。エンジニアリングリーダーは毎月の決算時期を恐れるようになります。根本的な問題は、帰属設定が請求時ではなくインジェスト(取り込み)時に行われなければならない点にあります。請求書が届く頃には、必要なラベルはすでに失われているのです。
プロバイダーの請求書は「いくらかったか」を示します。ゲートウェイで帰属付けされたレジャー(台帳)は「どのリポジトリ、どのパイプライン、どのエージェントステップか、そして何を修正すべきか」を示します。この違いが、財務上の危機をエンジニアリングのチケットへと変換します。
コスト帰属の基礎となるのは、ゲートウェイでのタグ付けの義務化です。CI/CDパイプラインからのすべてのリクエストは、X-TFY-METADATAヘッダーを介して小さなJSONオブジェクトを注入し、担当するチーム、リポジトリ、パイプライン、エージェントステップ、コストセンターを特定します。その形式はシンプルかつ意図的であり、すべてのチームで共通です。
HTTP · すべてのCIリクエストで必須のヘッダー
タグ付けは推奨ではなく必須です。タグのないリクエストはゲートウェイで拒否され、黙って通過することはありません。これが100%の可視性を生み出すポリシーです。ダッシュボードに「不明(unknown)」の分類が存在しないのは、それを生成する経路自体が存在しないからです。この強制にかかるコストはCedar/OPAのルール1つ分です。強制しないことにかかるコストは、四半期ごとの財務部門からのエスカレーションです。
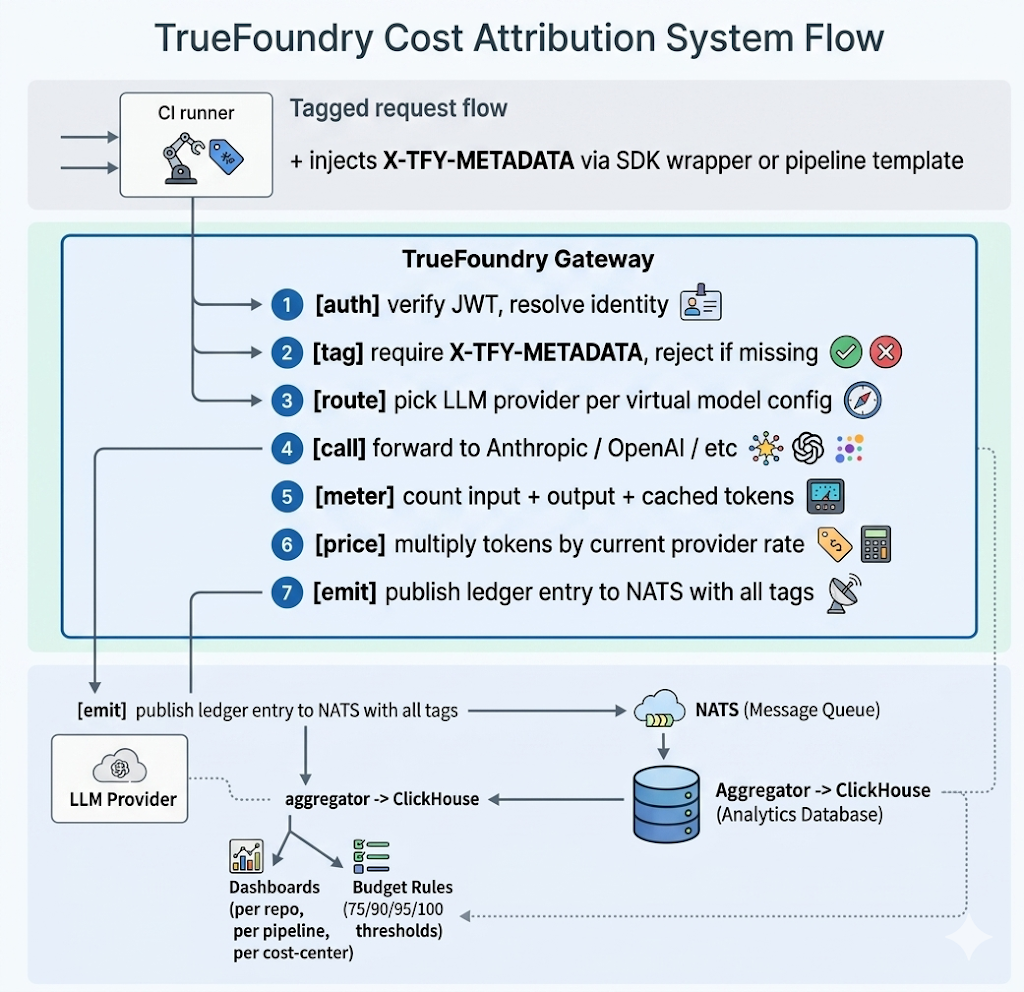
タグを活用して、ゲートウェイはすべてのコールに対して入力、出力、およびキャッシュされたトークンをカウントし、現在のプロバイダーレートに基づいて結果の価格を算出し、完全に帰属化されたレジャーエントリを書き込みます。コストビューはユーザー、モデル、チームごとに標準で分類されており、「Rawデータのダウンロード」オプションを使用すると、カスタムのgroupByフィールド(username、model_name、teams、またはタグ付けしたメタデータキー)でエクスポートできます。すべての支出の追跡が可能です。
強制力を伴わない可視化は、誰の行動も促さないダッシュボードに過ぎません。TrueFoundryは、タグ付けによって作成されたすべてのコストセンターに、階層的で数学的に強制された予算を関連付けます。予算は、サブジェクト、モデル、またはメタデータキーによってスコープ定義されたルールの順序付きリストです。予算ルールをレート制限ルールと区別する2つのセマンティクスがあり、正確に理解しておく価値があります。
予算アラートは、設定可能な4つのしきい値(上限の75%、90%、95%、100%)で発動し、メール、Slack Webhook、Slackボットへの通知チャネルを備えています。チェックは最新の帰属レジャーに対して20分ごとに実行されます。
表1 — 予算のしきい値。各しきい値は予算期間(日 / 週 / 月)ごとに1回発動し、次の期間の開始時にリセットされます。アラートは20分ごとにチェックされます。
100%時の挙動は後付けではなく設計の一部です。ゲートウェイは、枯渇した予算を明記し、オペレーターをダッシュボードへ誘導する構造化されたエラーを返します。
JSON · ハードキャップ時の429レスポンス
予算に達したパイプラインは、開発者がプラットフォームチームにコンテキストを確認しに行かなくても、次に何をすべきかを把握できる必要があります。CIランナーは429を標準的なバックオフ信号として解釈します。ビルドは分かりにくいクラッシュをするのではなく、実行可能なメッセージとともにクリーンに失敗します。
もう1つ知っておくべき挙動があります。それは監査モード(audit mode)です。任意のルールで block_on_budget_exceed: false を設定すると、追跡とアラートはアクティブなままですが、リクエストを通過させることができます。これは導入後の最初の1ヶ月間における適切なデフォルト設定です。疑似的に設定した上限に対してアラートが発動するのを確認し、上限を調整してから、強制機能をオンにします。監査モードをスキップすると、午前3時にすべてのパイプラインが失敗して怒っているチームからの連絡で目を覚ますことになります。
YAML · レイヤー化された予算設定
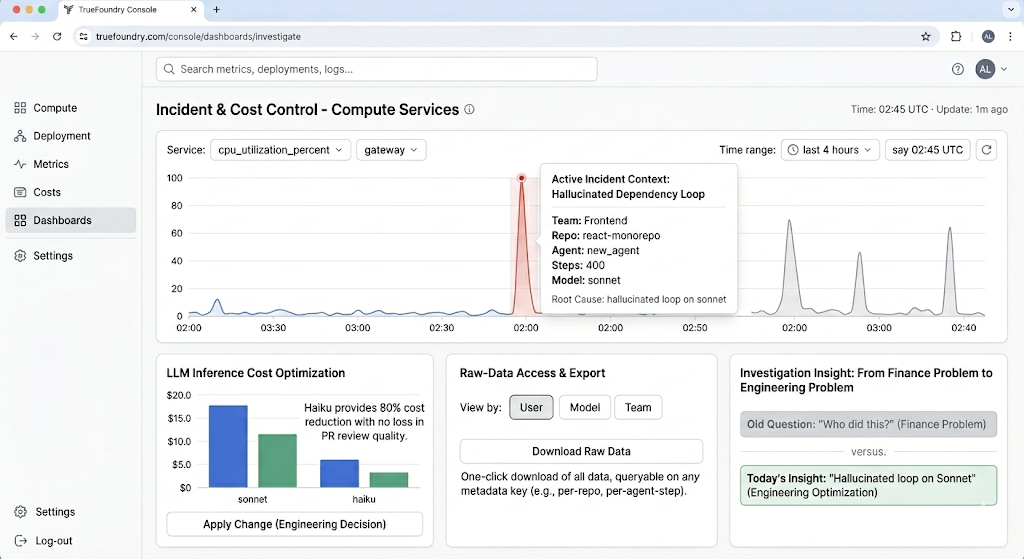
ゲートウェイのメトリクス層に流入するタグ付きデータにより、プラットフォームチームは集計ノイズを増やすのではなく、所有権の疑問に答えるダッシュボードを構築できます。スパイクを見て「誰がこれをやったのか?」と問いかける代わりに、ダッシュボードはすでに「UTC 02:00にフロントエンドチームが新しいエージェントをreact-monorepoにデプロイし、それが存在しない依存関係をハルシネーションして400ステップの解決ループに入った」という情報を提示してくれます。
このような運用コンテキストにより、コストは財務の問題からエンジニアリングの問題へと変化します。初期のコード要約ステップをSonnetからHaikuに切り替えることで、PRレビューの品質に影響を与えることなく、そのステップのコストを80%削減できることが視覚化できれば、すぐに変更を実行できます。運営委員会で予算上限について議論する必要はありません。TrueFoundryのコスト追跡ビューは、ユーザー、モデル、チームの観点から標準で提供されており、Rawデータのエクスポート機能により任意のメタデータキーで分類できるため、リポジトリごと、パイプラインごと、あるいはエージェントステップごとのビューを、データエンジニアリングプロジェクトを立ち上げることなくワンクリックでダウンロードできます。
集計されたタグ付けデータは、予測を扱いやすいものにします。エージェント型のワークロードはバースト性が高く、定期的な重いCIジョブが請求の大部分を占めるため、単純な過去の移動平均では支出が系統的に過小評価されます。95パーセンタイルが平均の4倍に達するようなワークロードに対して、過去7日間の平均を用いる予測手法は不適切です。
適切なモデルは、リポジトリごとおよびチームごとに実行されるP95ローリング予測です。P95は平均値では平滑化されてしまうバーストリスクを捉え、財務部門が予期せぬ請求に驚く前に、予算の調整、クォータの引き上げ、あるいは問題のあるパイプラインの停止を行うのに十分なリードタイムを持って月末の支出を予測します。「予期せぬ驚き(Surprise)」がキーワードです。これはそれらを発生させないために設計された予測手法です。実際、私たちが測定したワークロードにおいて、7日間のP95は実際の月末支出を8〜12%の誤差範囲内で追跡しており、アクションを起こすには十分な精度であり、過去の平均値を用いる代替案よりも遥かに優れています。
50人のエンジニアを擁する組織が、すべてのプルリクエストで実行される3ステップのClaude Codeレビューエージェントを構築しました:(1) diffの要約、(2) MCPドキュメントサーバーを介したセキュリティポリシーに対するdiffのレビュー、(3) コード変更の提案。賢明なアーキテクチャで、有用なワークフローであり、一見すると明らかな問題点はありませんでした。
エンジニア1人あたり週に約15件のPRがあり、再試行やファイル全体をプロンプトに注入するコンテキストウィンドウのコストを考慮すると、エージェントは1PRあたり平均約400,000入力トークンを消費していました。CI/CD自動化の1ヶ月目の請求額は8,400ドルでした。
表2 — あるコスト帰属デバッグのプロセス。ゲートウェイで5回クリックし、設定を1箇所変更しました。帰属情報がなければ、対応策はCIワークフローにおけるSonnetの一括禁止になっていたでしょう。帰属情報があったことで、対応策は1行の設定変更で済みました。
「モデルを禁止する」と「プロンプトを1つキャッシュする」の間にあるこのギャップこそが、適切な帰属分析を行うことの最大の成果です。コストデータはどちらの形でも存在します。問題は、それを読み解くためのラベルを持っているかどうかです。
予算は米ドルとトークンのどちらで建てられるべきですか?
両方同時に行うべきです。米ドルは財務や運用計画と整合します。トークンはプロンプトの効率性をデバッグするためのエンジニアリングメトリクスです。TrueFoundryは両方を追跡します。財務部門はドルベースのダッシュボードを所有し、エンジニアリング部門はトークンベースのダッシュボードを所有し、ゲートウェイが両方の信頼できる唯一の情報源(Source of Truth)となります。プロバイダーの価格変更はエンジニアリング側で何もリファクタリングすることなくドルレイヤーで吸収され、新しいファインチューニングモデルの導入は財務側でモデル名を知る必要なくトークンレイヤーで吸収されます。
パイプラインの途中でハード制限に達した場合はどうなりますか?
パイプラインは前述のような詳細なエラーと予算ダッシュボードへのリンクを含む429を受け取ります。CIランナーは429を標準的なバックオフ信号として解釈します。ビルドは分かりにくいクラッシュをするのではなく、実行可能なメッセージとともにクリーンに失敗します。クォータの増額申請はプラットフォームチームに対する標準的なチケットとして発行されます。エラーボディに含まれるダッシュボードURLにより、通常の「なぜこれが失敗しているのか分からない」というやり取りをショートカットできます。
タグ付けの義務化によってデプロイの速度が低下することはありますか?
実際には低下しません。SDKラッパーがCIテンプレート内でインジェクションを自動的に処理するため、個々の開発者がヘッダーを編集することはありません。一回限りのコストはチームのパイプラインテンプレートを更新することであり、継続的なコストはゼロです。得られる継続的なメリットは、その後のすべてのダッシュボード、すべてのアラート、そしてすべてのポストモーテム(事後分析)に及びます。
レート制限と予算制限の違いは何ですか?また、それぞれをどのように使い分けるべきですか?
レート制限はスパイク(短期間の過大アクセス)を止め、予算制限は支出を止めます。レート制限はリクエスト数/分やトークン数/分で建てられ、ダウンストリームサービスを過剰な負荷から保護するためにリクエストごとに評価されます。予算は日/週/月ごとの米ドルで建てられ、会社の資金を保護するために累積レジャーに対して評価されます。ほとんどの本番スタックでは、異なるエンティティを対象として両方が運用されています。これらのパターンは相補的であり、冗長ではありません。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























