



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Moonshot AIがKimi K2をオープンソース化したとき、AIコミュニティは大いに注目しました。それに続き、数百回に及ぶツール呼び出しを行っても卓越した整合性を維持して推論できるモデル「Kimi K2.6 Thinking」を発表すると、専門家たちは真剣に関心を寄せ始めました。そして現在、Kimi K2.6の登場により、Moonshotはさらに大きな前進を遂げました。コーディングや長期実行(long-horizon)型のエージェントベンチマークで頂点に立ち、世界最高峰のクローズドソースモデルに匹敵する最先端のオープンソースモデルです。
本記事では、K2.6の卓越性の理由、ベンチマークの数値が実際のプロダクションワークロードにおいて何を意味するのか、そして6週間もかかるようなデプロイプロジェクトを立ち上げることなく本番運用に導入する方法を深掘りします。
Kimi K2.6は、Hugging FaceおよびKimi API経由で利用可能なMoonshot AIの次世代マルチモーダルモデルです。従来モデルと同様に262,144トークンのコンテキストウィンドウを備えたMixture-of-Experts (MoE) アーキテクチャをベースに構築されています。しかし、K2.6は単なるマイナーアップデートにとどまりません。前世代ではばらつきが見られた3つの領域、すなわち長期実行(long-horizon)コーディング、コーディング主導型デザイン、およびエージェントスウォーム(群制御)の調整への大幅な設計シフトを実現しています。
「長期実行(long-horizon)」が実際に何を意味するのかを示す簡単な例を挙げます。あるベンチマークデモにおいて、K2.6はMac上のローカル環境にQwen3.5-0.8Bモデルを自律的にデプロイし、Zig(ニッチなシステムプログラミング言語)で推論処理を実装。4,000回以上のツール呼び出しと12時間以上の連続実行を通じて、スループットを約15トークン/秒から約193トークン/秒へと向上させました(LM Studioより約20%高速)。これは単に質問に答えるチャットボットではなく、持続的なタスクにおいてシニアパフォーマンスエンジニアとして機能するAIの姿です。
別のデモでは、K2.6は8年前のオープンソース金融マッチングエンジンを13時間のセッションで刷新し、1,000回以上の的確なコード変更を実施。初期のタスク指定以降は人間の指示を受けることなく、平均スループットを185%向上させ、ピークスループットを133%向上させました。
数値は重要ですが、そのコンテキストはさらに重要です。本番用のエージェントシステムにおいて最も重要視されるベンチマークにおけるK2.6のパフォーマンスは以下の通りです。
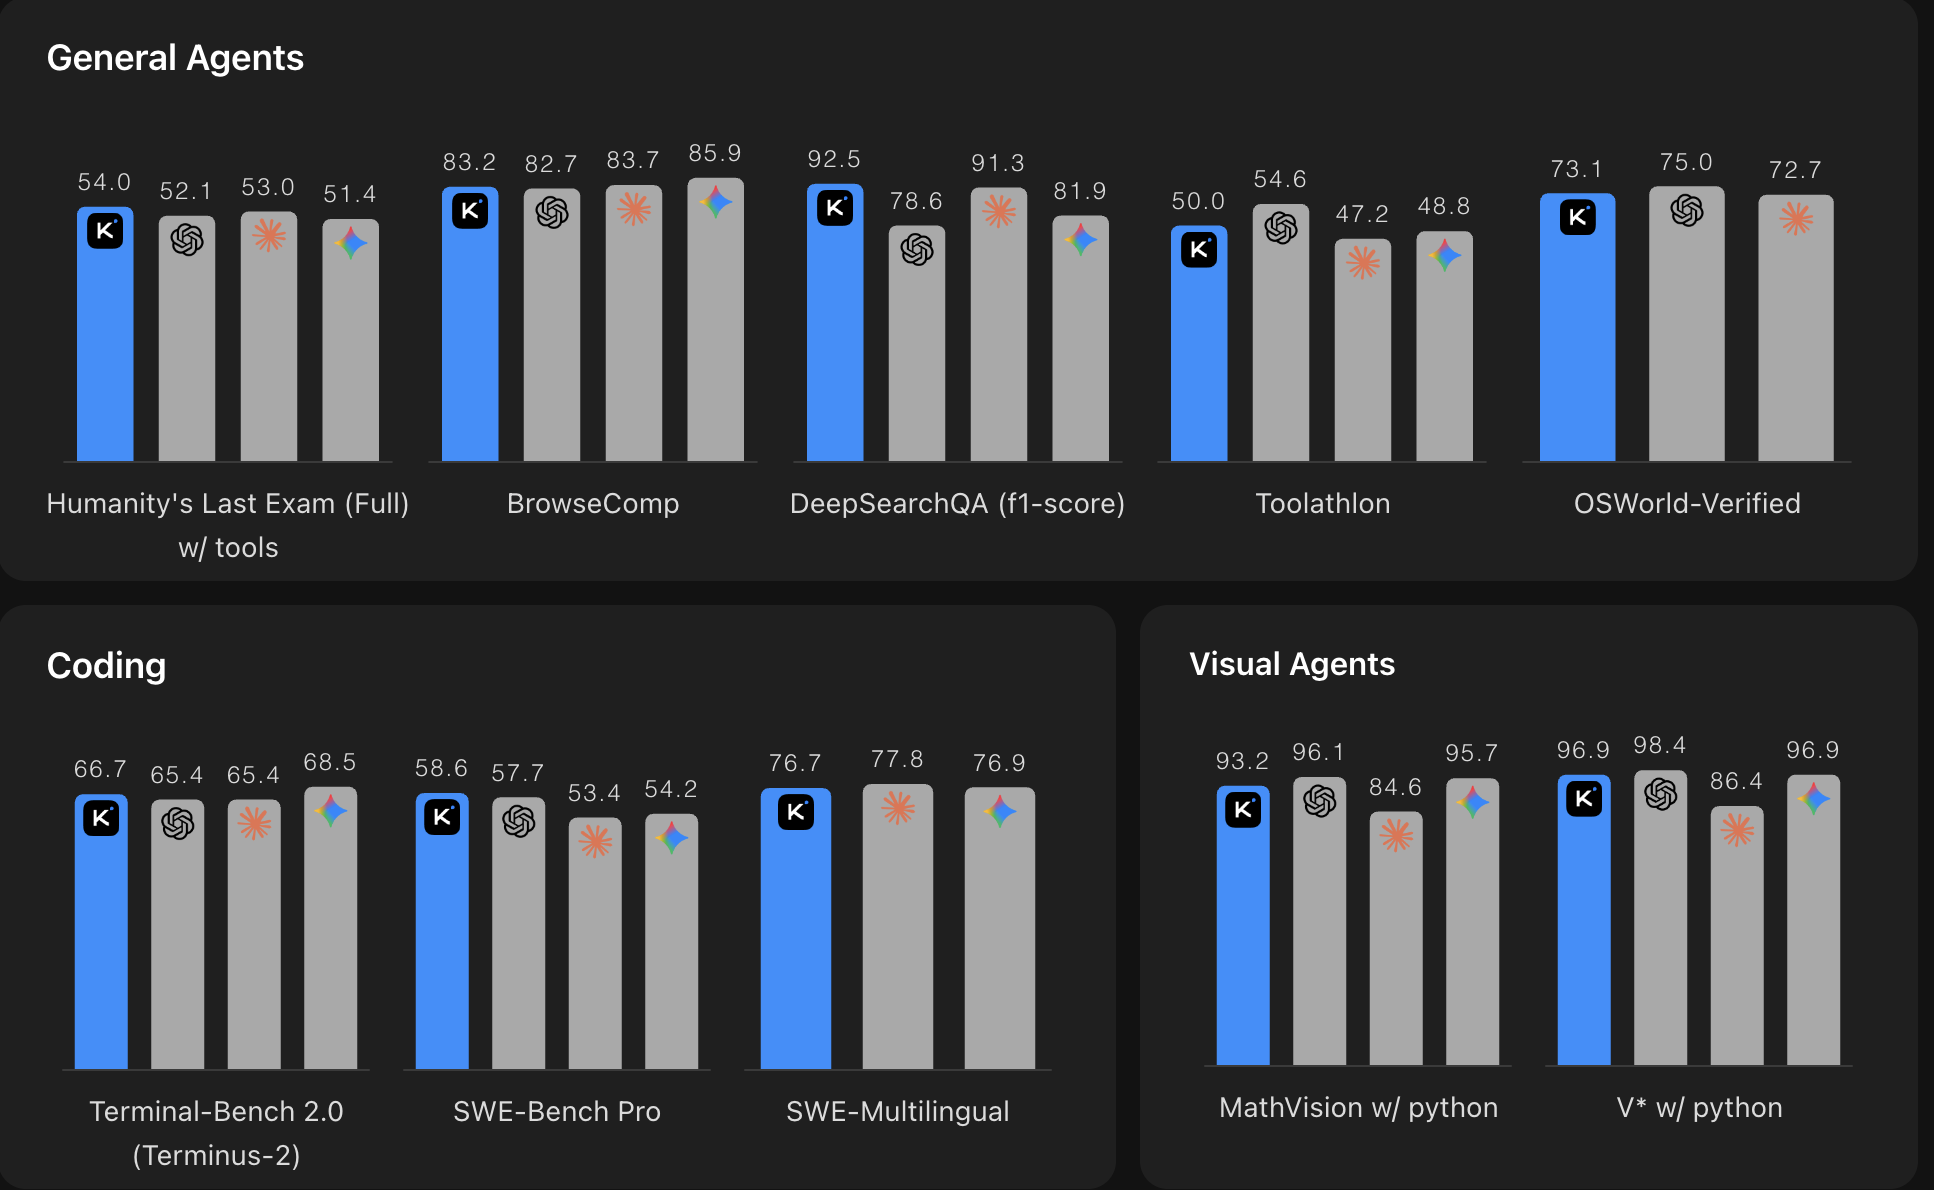
*出典: Moonshot AI Kimi K2.6ベンチマーク比較。数値が高いほど高性能。このグラフは、一般的なエージェント、コーディング、およびビジュアルエージェントのベンチマークにおいて、Kimi K2.6を主要なクローズドソースモデルと比較したものです。*
K2.6は、Claude Opus 4.6やGPT-5.4を含む最高峰のクローズドソースモデルと同等の競合力を持っています。これはエージェンティックコーディングや長期実行型タスクにおいて重要なほぼすべての次元に当てはまります。しかも、オープンウェイトモデルとして入力100万トークンあたり$0.74 / 出力100万トークンあたり$3.50という、同等レベルの商用代替モデルのわずか一ツ分のコストで利用可能です。
Kimi K2.5からの飛躍も顕著です。Toolathlonでは約80%向上し、BrowseCompおよびSWE-Bench Proでは約8ポイント向上しました。これらは単なる僅かな改善ではありません。
アーリーアクセスを利用したエンタープライズパートナーからも、同様に魅力的な結果が報告されています。AugmentcodeのCTOはK2.6の「大規模コードベースにおける外科手術のような正確さ」を評価し、VercelはK2.5と比較してNext.jsベンチマークで50%以上の向上を確認。CodeBuddyはコード生成精度の12%向上を測定し、ツール呼び出しの成功率は96.6%に達しました。
多くのLLMは、1回限りのコード生成には問題ありません。しかし、K2.6は数時間を要するタスク向けに設計されています。複数ファイルにまたがるリファクタリング、言語をまたいだ最適化、ビルドパイプラインの改善、さらにはモデルがコンパイラの出力を読み取り、仮説を修正して再試行する反復的なデバッグループなどに対応可能です。
このモデルは、Python、Rust、Goだけでなく、Zigのような稀少な言語においても強力な汎化性能を示します。これは、モデルがトレーニングデータのパターンを単に暗記しているのではなく、プログラミングの概念を深く理解して応用できていることを示唆しているため、特に注目に値します。
K2.6は、自然言語のプロンプト1つから、単なる静的なモックアップにとどまらず、インタラクティブな要素、スクロールアニメーション、データベース連携の認証機能を備えた完全なプロダクションレベルのフロントエンドを生成できます。Moonshotの内部ベンチマークであるKimi Design Benchにおいて、K2.6はビジュアル入力タスク、ランディングページの構築、フルスタックアプリケーション開発、および一般的なクリエイティブプログラミングの全域でGoogle AI Studioを上回る成果を上げています。
AI支援による開発ワークフローを構築するチームにとって、これはアーキテクチャ、ロジック、UI、デプロイ用スクラフォールディングまで、フルスタック全体を単一のモデルでカバーできることを実質的に意味します。
K2.6は、K2.5で初めてプレビューされたエージェントスウォームシステムのアーキテクチャを大幅に拡張しました。スウォームは、K2.5の「100エージェント・1,500ステップ」から、「300のサブエージェントが連携して同時に4,000ステップを実行する規模」へとスケーリングしました。これは単なるスケールの向上ではなく、実現可能なタスクの種類における質的変化を意味します。
従来は人間によるオーケストレーションが必要だったタスク(例えば「半導体企業100社を調査し、5つの定量的な投資戦略を構築して、McKinseyスタイルのプレゼンテーションを作成する」など)も、K2.6への1つの指示として発行し、完全な成果物として受け取ることが可能になりました。
通常、議論がストップするのはここです。チームがベンチマークの数値を見て胸を躍らせた後、モデルを安定してサービングする方法を解明するのに続く3週間を費やすことになります。
K2.6は大規模なMoEモデルです。262Kのコンテキストウィンドウを備えているため、メモリ要件は極めて高くなります。また、エージェンティックなワークロードはその性質上、非常に変動の激しいトラフィックパターンを発生させます。数時間は静かだった後に、突如として数百の並列サブエージェントを一斉にリクエストしてくるような状況が発生します。安易なデプロイ戦略では、このような負荷に耐えきれず崩壊してしまいます。
このインフラ課題を解決するために設計されたのが、TrueFoundry AI Gatewayです。
独自のGPUクラスタをプロビジョニングし、カスタムロードバランサーを構築し、推論パラメータを手動でチューニングする代わりに、TrueFoundryを使用すれば、アプリケーションの接続先を単一のエンドポイントに向けるだけで、残りの処理はすべて自動化されます。AI Gatewayは、プロバイダー間でリクエストをインテリジェントにルーティングし、バースト的なワークロード(300のサブエージェントを一斉に起動するスウォームなど)のコンカレンシーを管理し、トレース、レイテンシヒストグラム、チーム別のトークン使用量など、本来自作しなければならないオブザーバビリティーツールを提供します。
Kimi K2 Thinkingを使用した社内テストにおいて、TrueFoundryのGatewayは単一のvCPU上で約10msのオーバーヘッドのみで350以上のRPSを処理しました。単一のユーザー操作によるタスクが数十~数百のAPI呼び出しにファンアウトするようなエージェンティックワークロードにおいて、このヘッドルームは極めて重要です。
また、実用的な組織的観点もあります。K2.6を運用するエンタープライズチームでは、通常、データサイエンス、プロダクトエンジニアリング、プラットフォームなど、複数のチームが同じモデルで実験を行いたいと考えています。Gatewayは、チームごとに個別のAPIキー管理を必要とすることなく、レート制限、コスト帰属、アクセス制御を一括管理する単一のコントロールプレーンを提供します。
マネージドされた本番運用可能な環境でK2.6を実行するための最もスピーディなステップは以下の通りです。
1. TrueFoundry AI Gateway (API) 経由
すでにOpenAI SDKやOpenAI互換クライアントを使用している場合、モデル文字列を変更するだけでK2.6に切り替えることができます。
Gatewayは、プロバイダーの選択、フォールバックルーティング、レート制限を透過的に処理します。
2. エージェンティックワークロード向けの設定
K2.6のツール呼び出しインターフェースは、標準的なOpenAIファンクションコーディングスキーマに従います。長期実行型タスクの場合は、以下の設定を推奨します。
- `max_tokens` を余裕を持って高く設定する(モデルは大規模な生成予算を有効に活用できます)
- ストリーミングを有効にして、長いツールチェーンから増分出力を取得する
- TrueFoundryのトレーシングダッシュボードを使用して、どのツール呼び出しに時間がかかり、どこでコンテキストが消費されているかを可視化する
3. エージェントスウォームのオーケストレーション向けの設定
マルチエージェントシステムを構築する場合、TrueFoundryのGatewayはリクエストレベルのメタデータを提供します。各サブエージェントのリクエストに親タスクIDのタグを付与することで、実行後に完全な実行トレースを再構築できます。これは、スウォームの挙動のデバッグや、並列化が有効に機能しているか(あるいは悪影響を及ぼしているか)を把握するために非常に役立ちます。
エージェンティックコーディングツールを構築するエンジニアリングチーム: K2.6は、SWE-Bench ProにおいてGPT-5.4やClaude Opusと真剣に競合する初のオープンソースモデルです。プロダクションレベルのコードベースタスクを処理できるオープンウェイトモデルを待っていたのであれば、これが決定版となります。
モデルアクセスを管理するMLプラットフォームチーム: K2.6を他のフロンティアモデルと併せて評価している企業は、すべてを単一のゲートウェイ経由で実行することで大きな恩恵を受けられます。TrueFoundryのモデルカタログアプローチにより、実際のワークロード上でK2.6をClaudeやGPT-5.4とA/Bテストし、コストとレイテンシを横並びでトラッキングできます。
データレジデンシー要件を持つチーム: K2.6はオープンウェイトであるため、自社が管理するインフラストラクチャ上にデプロイ可能です。TrueFoundryのデプロイプラットフォームがオーケストレーションを処理するため、推論パスに商用ベンダーを挟むことなく、エンタープライズレベルのモデルガバナンスを実現できます。
クローズドソースモデルの高額なコストに苦しんでいる方: 100万トークンあたり$0.74 / $3.50という価格でありながら、ほとんどのエージェンティックタスクで商用代替モデルと同等以上のベンチマーク性能を発揮するK2.6のコストパフォーマンスは、無視し得ない選択肢となります。
Kimi K2.6は本物のフロンティアモデルです。「オープンソースとしては優秀」というレベルを超え、実際のエンジニアリング作業で重要となるベンチマークにおいて、世界最高峰のモデルと真正面から競合しています。長期実行における信頼性、エージェントスウォームのアーキテクチャ、そして競争力のある価格設定により、現在本番運用向けのエージェントシステムとして利用できる最も魅力的なオープンウェイトモデルとなっています。
実用上の問題は、K2.6を使う価値があるかどうかではありません。使う価値は十分にあります。真の問題は、いかに迅速かつ安定して本番環境に導入できるかです。TrueFoundry AI Gatewayはその問いに対する答えを提供します。インフラの構築に時間を取られることなく、モデルを活用したプロダクトの開発に集中できるようサポートします。
今すぐ試す: [TrueFoundry AI Gateway](https://www.truefoundry.com/ai-gateway) からKimi K2.6にアクセスするか、[デモを予約](https://www.truefoundry.com/book-demo) してチームのワークロードへの適用方法をご確認ください。
*引用されているすべてのベンチマーク数値は、公式のKimi K2.6テクニカルブログおよびOpenRouterで検証されたサードパーティ評価に基づきます。インフラストラクチャのパフォーマンス数値はTrueFoundryの社内テストによるものです。*
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























