



11月 20, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
MCP向けのHuman in the loop(HITL)は、指定された人間が承認または拒否するまで選択されたツール呼び出しを一時停止するゲートウェイポリシーです。これにより、エンタープライズ企業は不可逆的なアクションを無検証のリスクに変えることなく、AIエージェントに真の自律性を与えることができます。
認証はエージェントが誰であるかを証明します。認可は何を呼び出してよいかを証明します。HITLはどちらも答えることができない最後の問いに答えます。「この特定のアクションは今実行されるべきか?」HITLがなければ、認可された1つのミスがP1障害を引き起こし、エージェントの書き込み権限の一括削除を招き、より広範なエージェントプログラムの進行を停止させる可能性があります。
TrueFoundryとKongの違いは、人間の承認がどこに存在するかという点に集約されます。KongはステートレスなAPIゲートウェイとして機能します。各MCPツール呼び出しを評価し、同期的に認可または拒否しますが、リクエストを一時停止して再開するために必要なワークフローステートは保持しません。TrueFoundryはツール呼び出しをゲートウェイで保持し、ガバナンス対象の承認者に通知し、スコープを限定した時間制限付きのアクセス権(グラント)を発行できます。Kongを使用するエンタープライズ企業は、人間による承認ワークフローを自社で構築・運用する必要があります。
金融サービス業界のプラットフォームチームを想像してみてください。そのエージェントはMCPゲートウェイを介してのみ内部システムにアクセスします。アイデンティティ、RBAC、監査ログはすでに導入されています。クリーンアップエージェントはKubernetes、クラウドアカウント、Slackにアクセスでき、破壊的なデータベースツールも利用可能です。
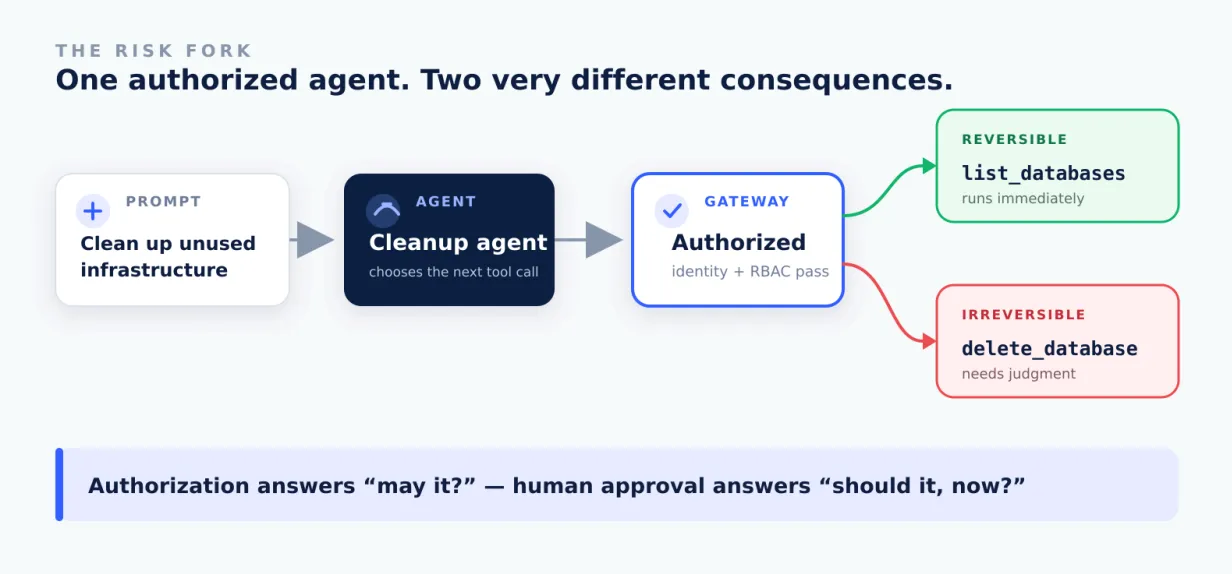
ここで、そのエージェントに「使用されていないインフラストラクチャをクリーンアップする」という合理的な四半期末のプロンプトを与えます。パーミッションから結果へとリクエストを追っていくと、リスクが顕在化します。
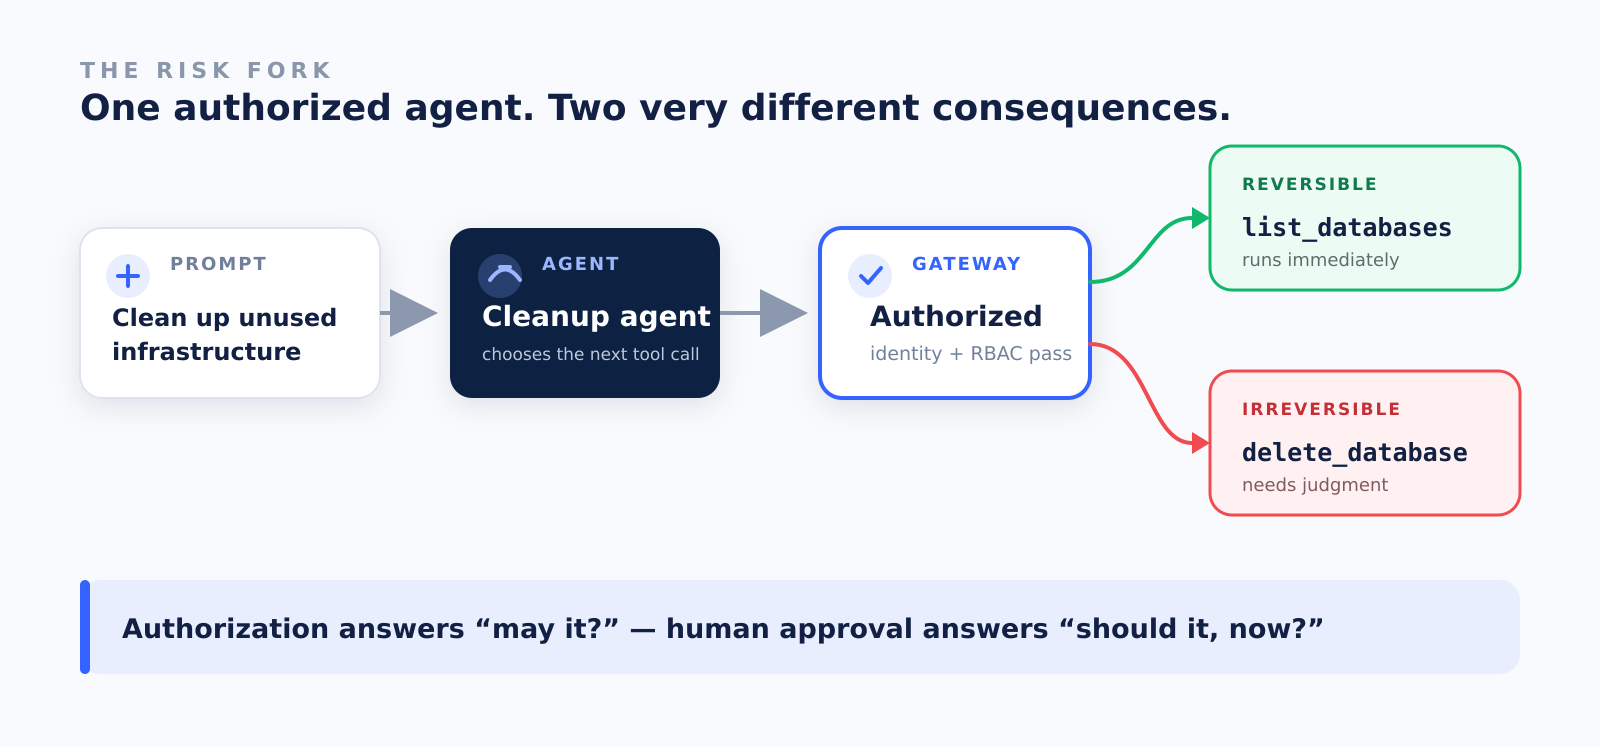
図 01 · 1つのアイデンティティと1つのゲートウェイが両方のパスを認可します。違いはアクセス権ではなく、その「結果」です。
エージェントは、ポッドのリスト表示、アイドル状態のデプロイメントのスケールダウン、データベースの棚卸しといった無害な作業から始めます。その後、34日間使用されていないdb-fin-rpt-01を発見します。ヒューリスティックルールが「古くて不要」と判断し、delete_databaseを呼び出します。
この呼び出しは有効であり、認証・認可され、ログにも記録されます。これこそがまさに問題なのです。従来のすべてのコントロールは呼び出しが「許可されているか」には答えますが、この不可逆的なアクションが「今実行されるべきか」を問うものは1つもありません。
呼び出しが一度実行されると、技術的な障害からの復旧は可能です。しかし、エージェントの自律性に対する信頼の失墜は復旧できません。
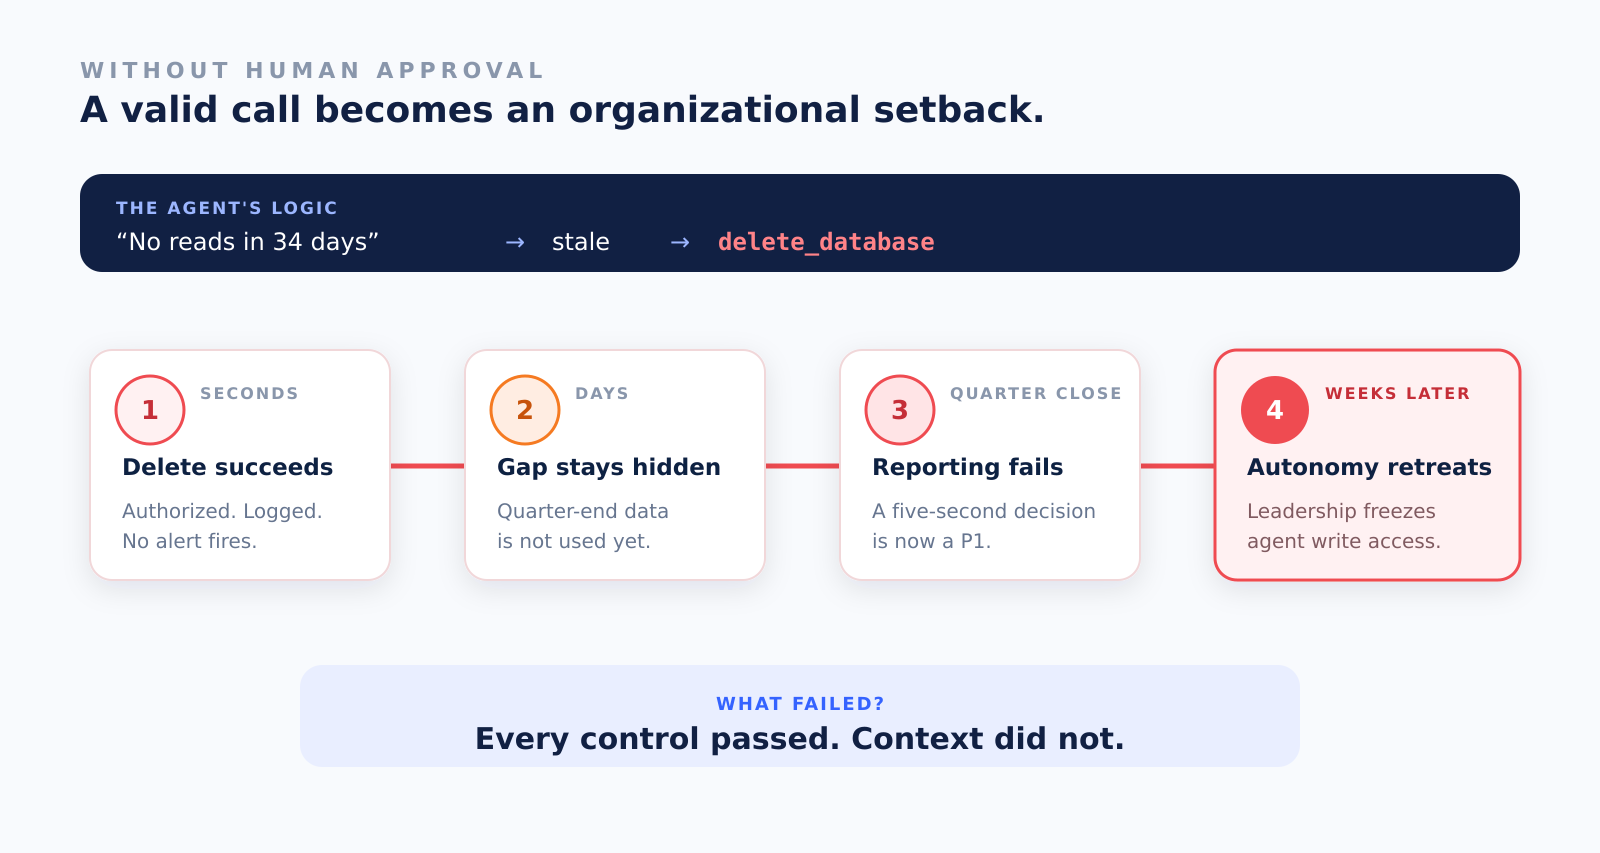
図 02 · 有効な削除処理が、見えない状態から緊急事態へと発展し、最終的にエージェントの書き込み権限が凍結されます。
エンジニアリング担当VPの視点から言えば、教訓は「エージェントにコントロールが欠けていた」ということではありません。コントロールはすべて揃っていました。失敗の原因は、「許可」と「拒否」の間にある必要な意思決定が欠落していたことです。delete_databaseの前に簡単な承認挟むだけで、四半期末のP1障害も、その後の読み取り専用エージェントへの後退も防ぐことができたはずです。
Human-in-the-loop(HITL)は、その第3のパスを作り出します。日常的な読み取りや可逆的な変更はマシン速度で継続され、削除、支払い、送信、デプロイなどの処理は指定された人間の確認を待ちます。こうして、この例は各エージェントチームが毎回再発明しなければならないリカバリロジックではなく、ゲートウェイポリシーの問題へと変わります。
TrueFoundryは、その第3のパスをファーストクラスのMCPゲートウェイポリシーへと変換します。プラットフォームチームはどのツールに承認が必要かを一度定義するだけで、そのルールがエージェント、クライアント、フレームワーク全体に適用されます。
これをdb-fin-rpt-01に適用してみましょう。エージェントがdelete_databaseを呼び出すと、ゲートウェイは実行前にリクエストを保持し、ガバナンス対象の承認者に通知し、エージェントが安全にリトライできる「承認待ち(approval-pending)」レスポンスを返します。承認されると、リクエスター、サーバー、ツールにスコープが限定された時間制限付きグラントが作成されます。
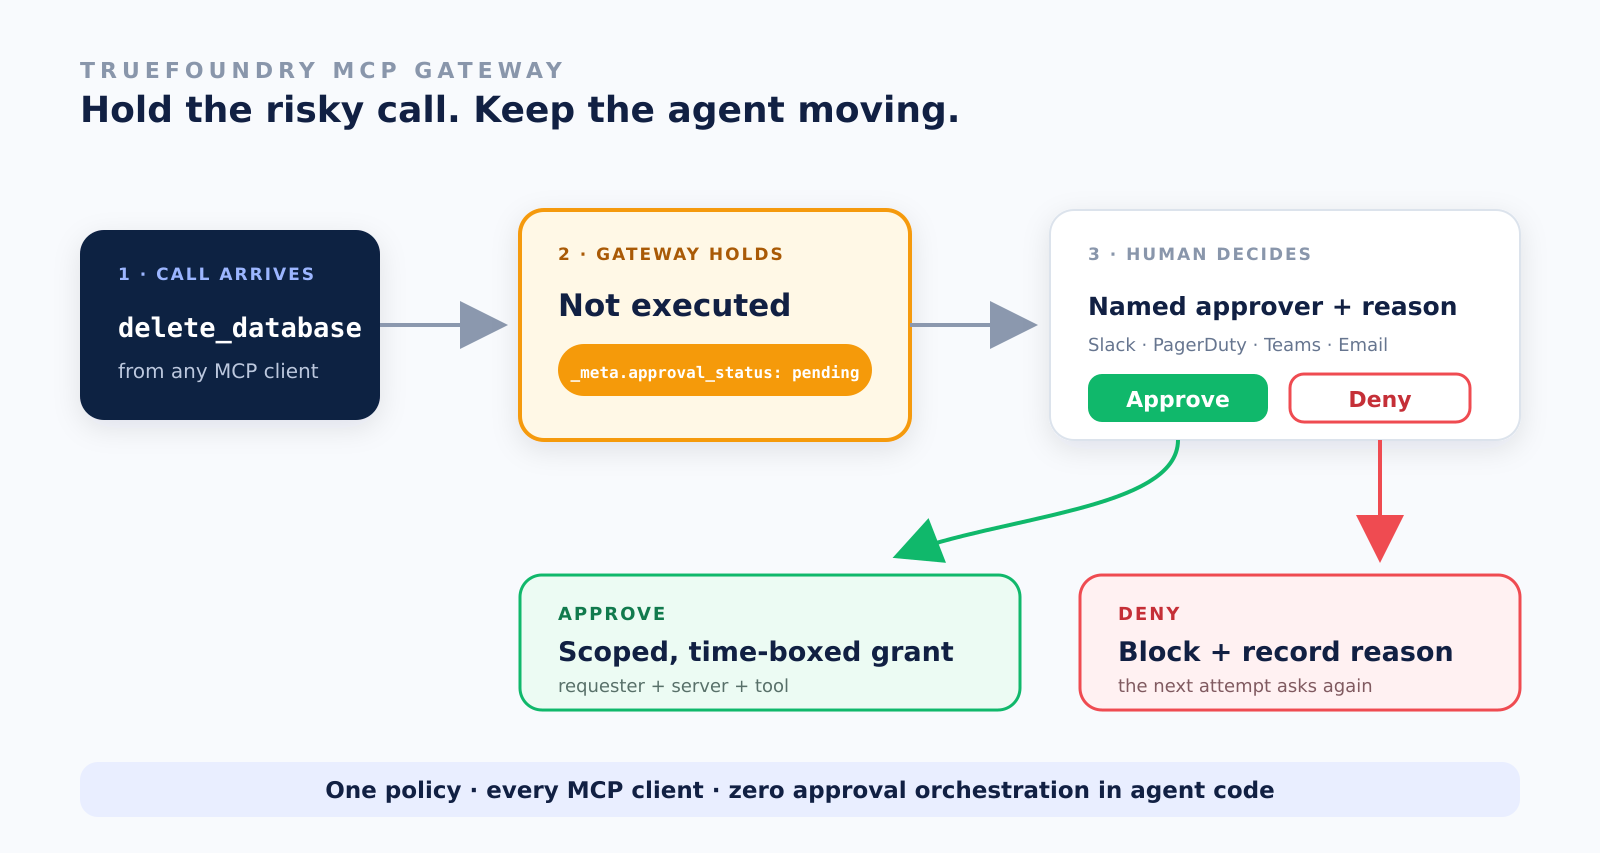
承認ステートはゲートウェイに存在するため、アプリケーションチームは一時停止、再開、通知、拒否処理、および監査ロジックをエージェントごとに再実装する必要がありません。決定できるのはテナント管理者と指定されたMCP Server Approverのみです。
プラットフォームチームにとって、設定はポリシー構成のままシンプルに完了します。サーバーとツールを選択し、有効期間を設定し、通知チャンネルを選んで保存するだけです。ルールがオーバーラップする場合、最も制限の厳しいポリシーが優先されます。このワークフローの境界線こそが、Kongとの比較の起点となります。
KongのMCPコントロールは、エージェントの認証、ツールACLの適用、呼び出しの許可・拒否を行います。しかし、人間が判断する間、本来なら許可されるツール呼び出しを保持できるような、ネイティブな承認ワークフローはサポートしていません。
これこそが欠落しているレイヤーです。HITLはステートフルです。ゲートウェイは保留中のリクエストを永続化し、認可された承認者に通知し、決定を記録し、有効期限付きのスコープ限定グラントを発行する必要があります。リクエストごとのバイナリ(許可/拒否)決定だけでは、このワークフロー自体を提供することはできません。
これらのコストはすべて、同じアーキテクチャ境界から生じています。Kongはリクエストを制御するだけであり、企業はその周囲に承認ライフサイクルを構築しなければなりません。以下の比較は、その境界線を明確に示しています。
機能比較表は、1つのライブ調達テストに要約できます。各ベンダーにこう問いかけてみてください。「認可されたエージェントがMCP上で不可逆的なアクションをリクエストしたとします。人間の承認、それをトリガーしたポリシー、そして結果として生成された監査ログを見せてください。」
もしデモが各エージェント内のカスタムワークフローコードに依存している場合、承認はプラットフォームの機能ではなく、単なるアプリケーションの技術的負債です。
デモを予約して最もリスクの高いツール呼び出しを半日でガードレール下に置くか、Agent GatewayおよびMCP Gatewayのドキュメントをご覧ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
























