


November 17, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
AIコーディングツールは今や日々の開発に欠かせないものとなっています。開発者はClaude Code、Cline、Cursor、Gemini CLI、OpenAI Codex CLI、Qwen Code CLI、Roo Code、Gooseなどの製品を使用し、エディターやターミナルから直接コードの生成、リファクタリング、デバッグ、大規模なコードベースの解説を行っています。多くの企業における課題は、ツールの導入・定着そのものではなく、ガバナンスにあります。各ツールは1つ以上のモデルベンダーと通信できます。また、各ツールはキーをローカルに保存することが少なくありません。その結果、チーム内には外部モデルへの管理されていないエントリーポイントが瞬く間に数十個も増えてしまいます。これにより、どのモデルが承認されているのか、コードやコンテキストがどこに送信されているのか、支出がどのように割り当てられているのか、インシデントがどのように調査されるのか、といった点で深刻なリスクが生じます。さらに、ツールごとにルーティングやフォールバックの一貫性がなくなるため、信頼性の維持も難しくなります。
この問題を仕組化せずに解決しようとすると、通常はすべてのIDEやCLIが接続する社内プロキシを自作することになります。そのプロキシには、認証、認可、承認済みモデルの許可リスト、プロバイダーのルーティング、監査ログ、レート制限、予算管理、オブザーバビリティが必要となります。さらに、これらのツールが前提としているAPIとの互換性も求められます。多くのツールはOpenAI互換APIに対応していますが、モデルの命名規則や特殊な挙動など、個別に処理しなければならない独自仕様も存在します。
これがなぜ本格的なエンジニアリング作業になってしまうのかを示す、簡単なダミー例を以下に挙げます。これは本番環境用ではなく、課題の全体像を示すことのみを目的としています。
from fastapi import FastAPI, Request, HTTPException
import time
import httpx
app = FastAPI()
APPROVED_MODELS = {
"gpt-4o": {"provider": "openai", "target": "gpt-4o"},
"claude-3-5-sonnet": {"provider": "anthropic", "target": "claude-3-5-sonnet"},
}
OPENAI_URL = "https://api.openai.com/v1/chat/completions"
ANTHROPIC_URL = "https://api.anthropic.com/v1/messages"
def verify_token(auth_header: str) -> dict:
# In reality this is JWT validation against Okta or your IdP.
if not auth_header or not auth_header.startswith("Bearer "):
raise HTTPException(status_code=401, detail="missing token")
return {"user": "alice", "team": "platform"}
@app.post("/v1/chat/completions")
async def chat_completions(req: Request):
user_ctx = verify_token(req.headers.get("authorization"))
body = await req.json()
model = body.get("model")
if model not in APPROVED_MODELS:
raise HTTPException(status_code=403, detail="model not approved")
route = APPROVED_MODELS[model]
started = time.time()
async with httpx.AsyncClient(timeout=60) as client:
if route["provider"] == "openai":
upstream = await client.post(
OPENAI_URL,
headers={"Authorization": "Bearer " + "UPSTREAM_OPENAI_KEY"},
json={**body, "model": route["target"]},
)
else:
# You would also need request and response transforms here.
upstream = await client.post(
ANTHROPIC_URL,
headers={"x-api-key": "UPSTREAM_ANTHROPIC_KEY"},
json={"model": route["target"], "messages": body.get("messages", [])},
)
latency_ms = int((time.time() - started) * 1000)
# In reality you would emit OpenTelemetry traces and structured logs here.
print("llm_request", {"user": user_ctx["user"], "model": model, "latency_ms": latency_ms})
return upstream.json()
この簡略化されたバージョンであっても、不足している要素があることがお分かりいただけるでしょう。ベンダー間の堅牢な変換、ストリーミング対応、リトライ、フォールバック、安全なパススルーヘッダー、テナントおよびチーム単位のスコープ設定、耐久性のある監査ログが依然として必要です。さらに、チーム全体にスケールする設定システムも不可欠です。
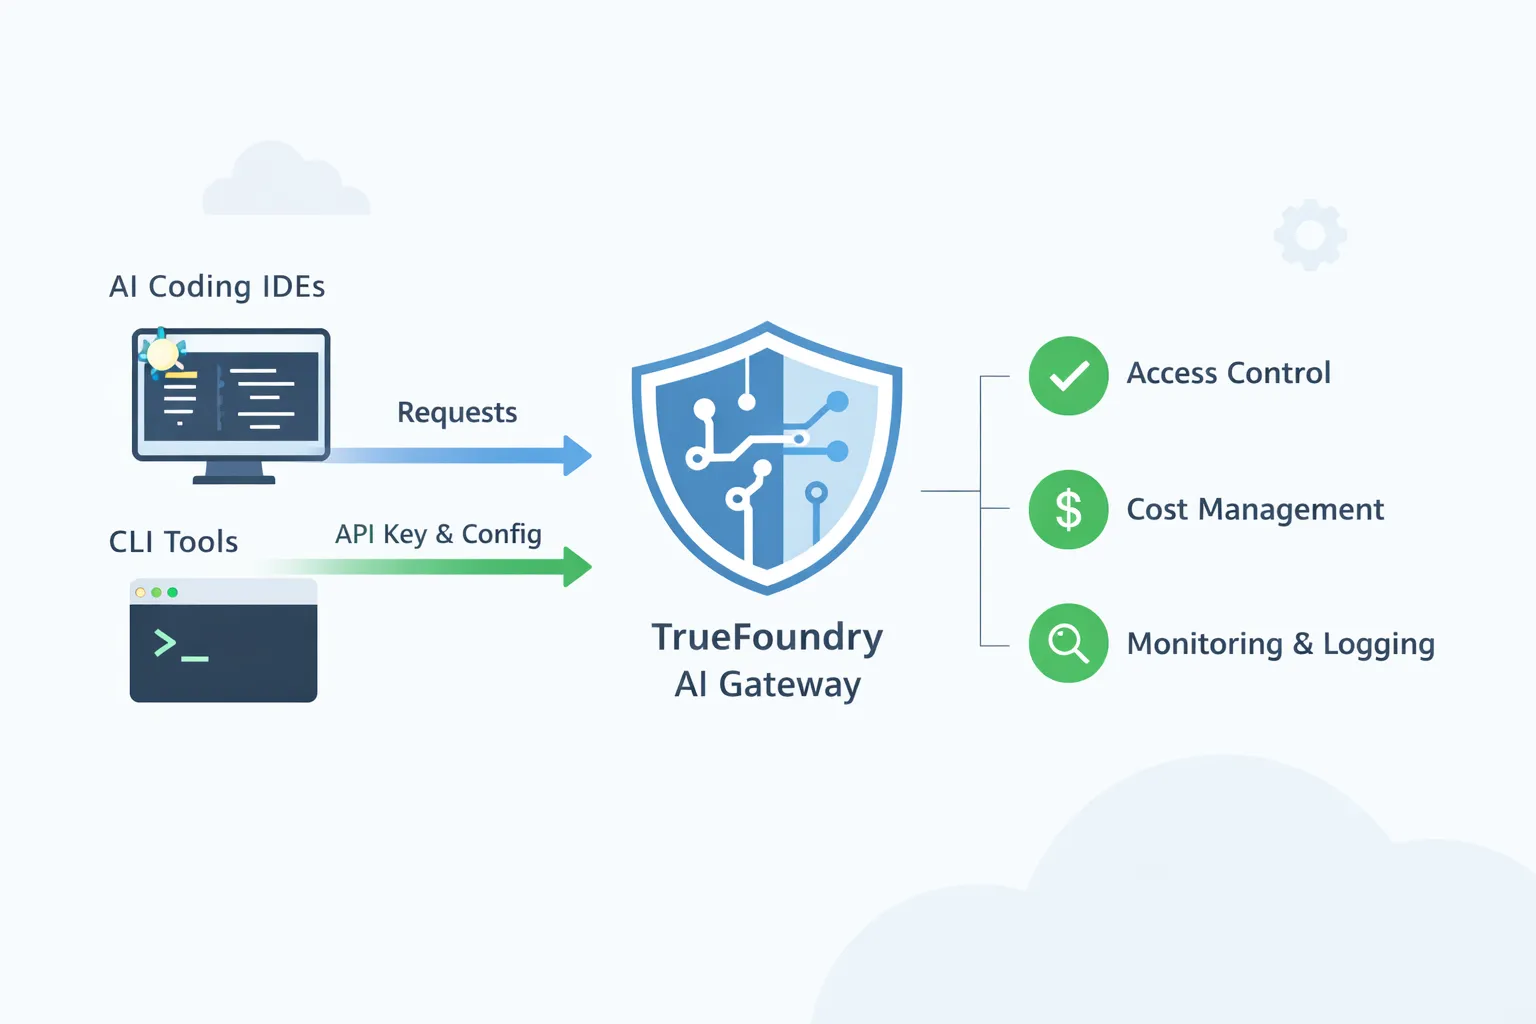
TrueFoundry AI Gatewayは、まさにそのような共有コントロールポイントとなるよう設計されています。IDEやCLIは開発者が好む既存のワークフローを維持したまま、トラフィックのみがガバナンスの効いた単一のゲートウェイを経由してルーティングされます。このゲートウェイが、プラットフォームチームが承認済みモデルへのアクセスを適用し、ポリシーを実行し、使用状況の完全な可視性を得るための集約拠点となります。
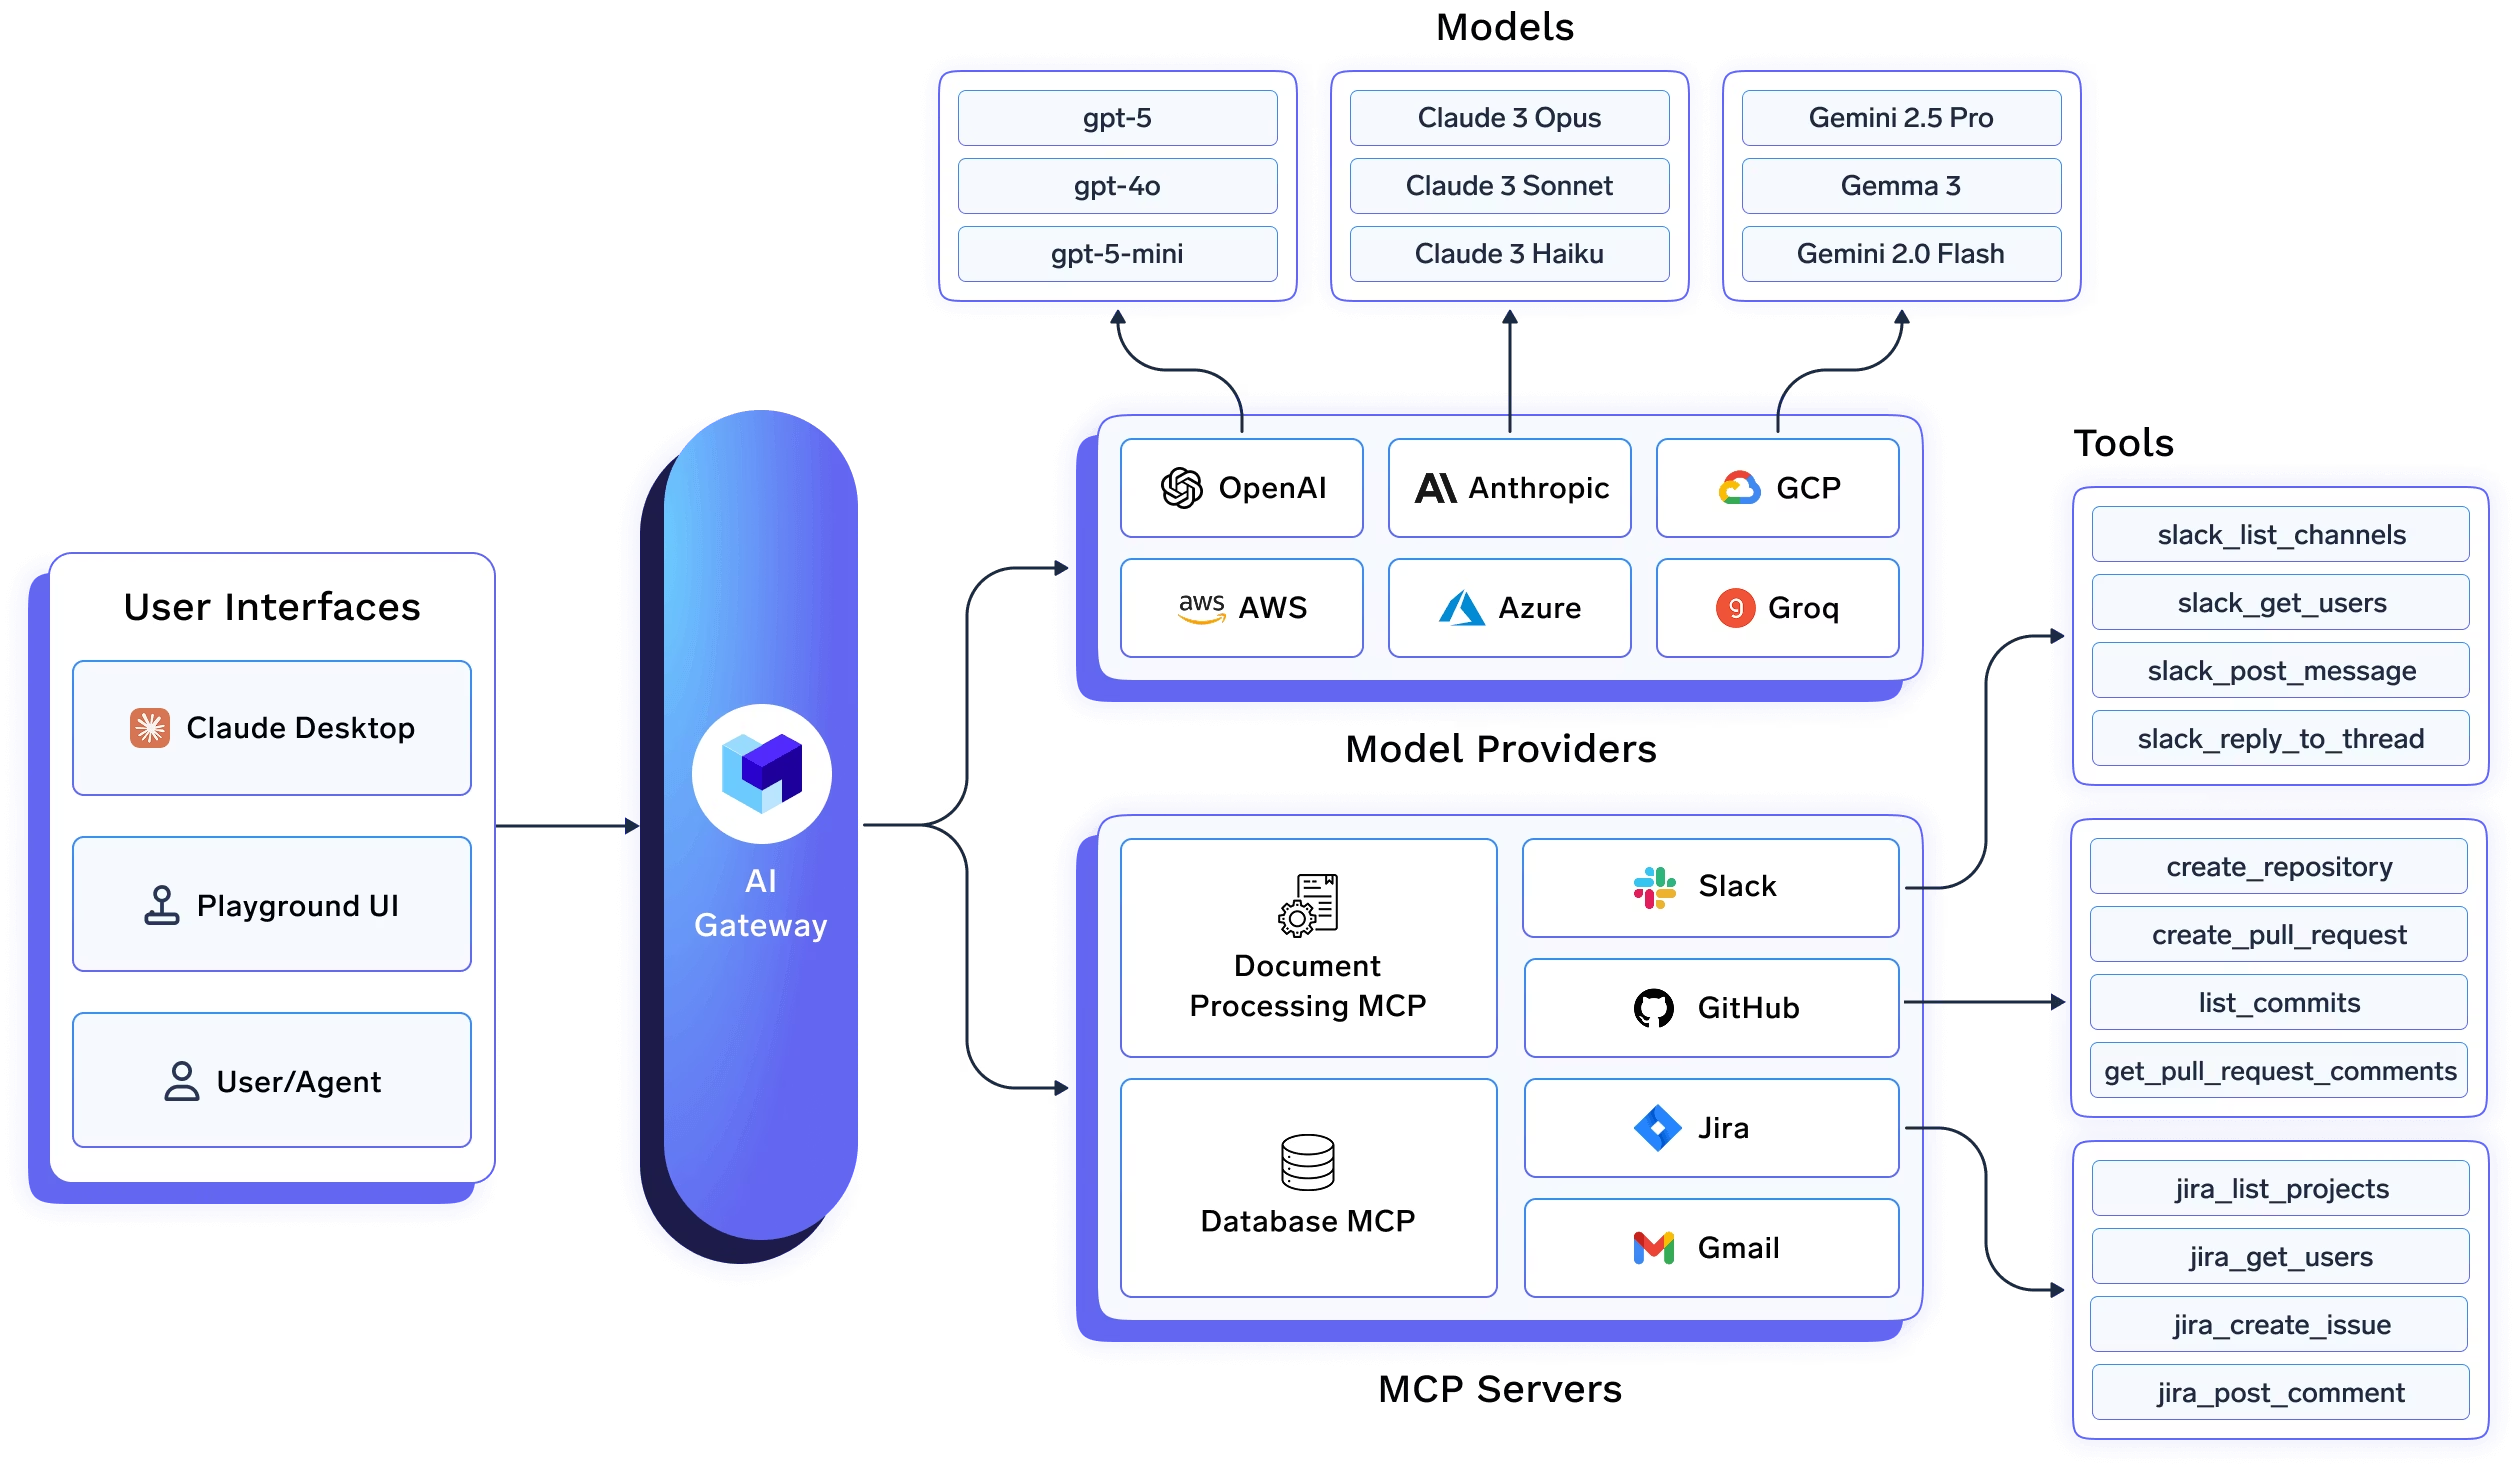
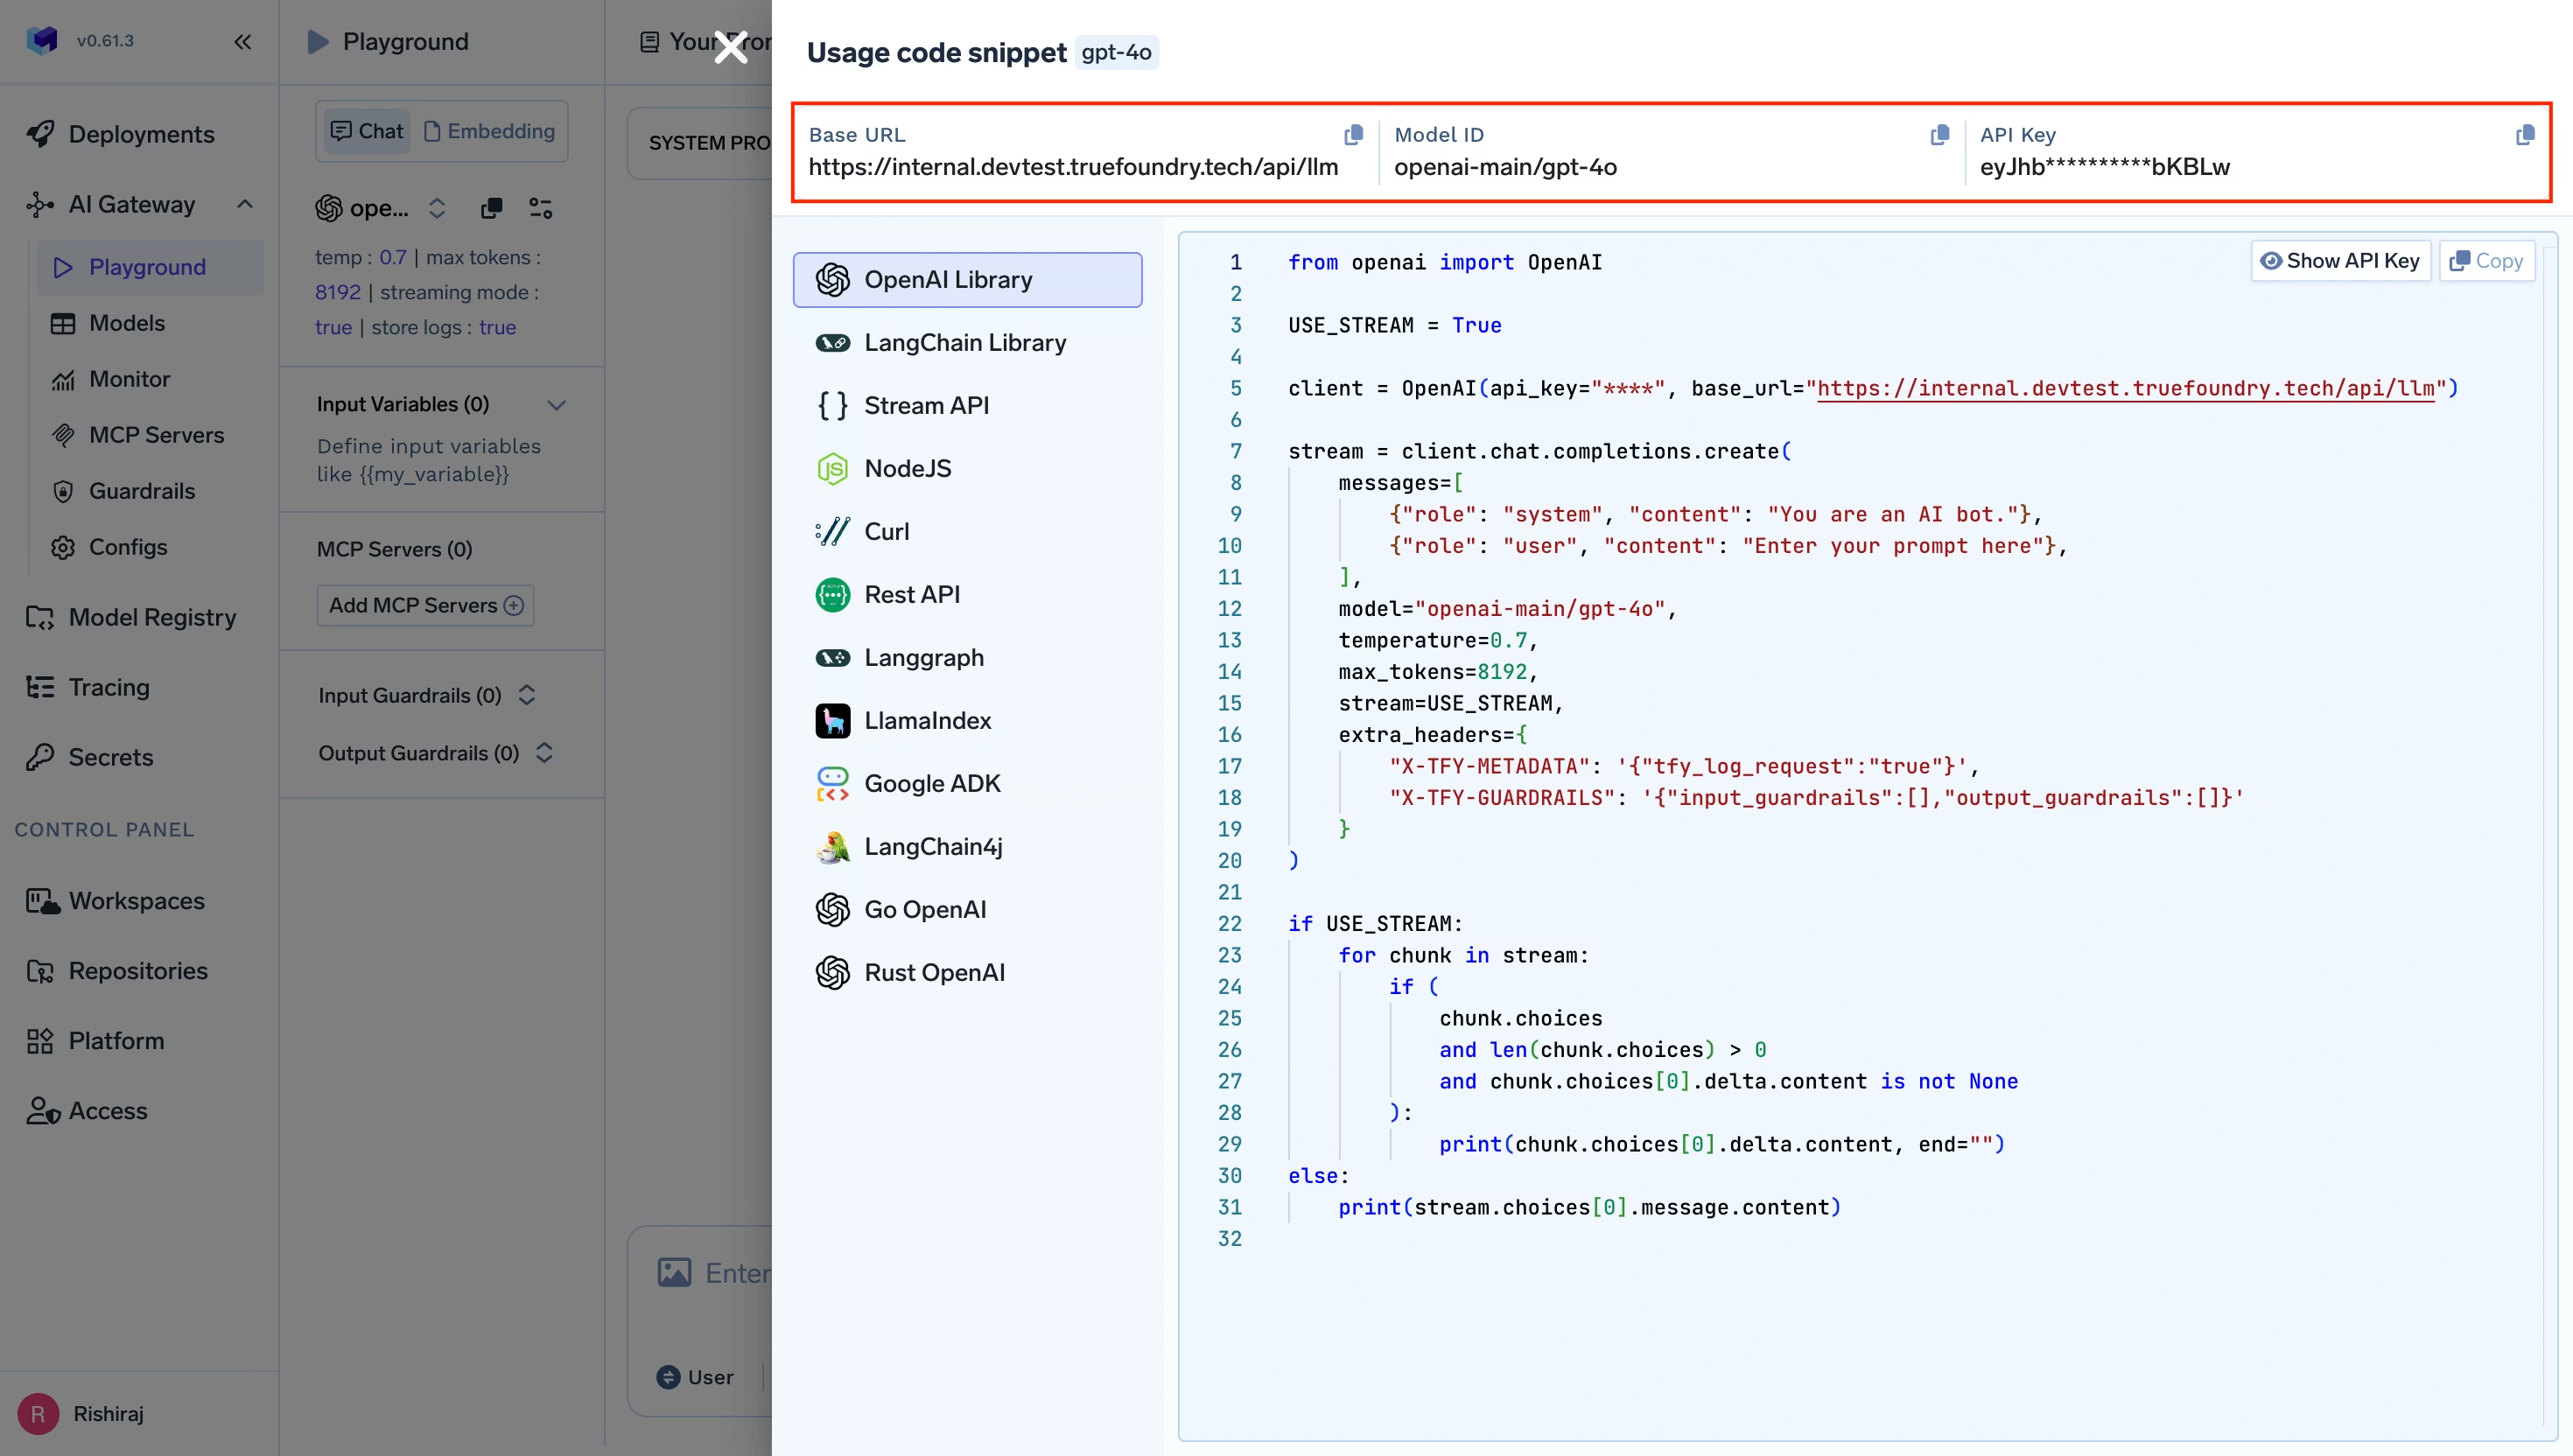
各IDEガイドに共通するテーマは非常にシンプルです。TrueFoundry AI GatewayのプレイグラウンドからベースURLとモデル名を取得します。次に、そのベースURLとTrueFoundryトークンを使用するようにIDEやCLIを設定します。
ほとんどのAIコーディングIDEやデスクトップツールは、単一のOpenAI互換エンドポイントに接続できます。TrueFoundry AI Gatewayはそのエンドポイントを提供します。まずGatewayのプレイグラウンドで統一されたスニペットをコピーします。このスニペットには、使用すべきベースURLとモデル名が含まれています。次にIDEの設定を開き、カスタムベースURLをサポートするプロバイダーオプションを選択します。多くのツールではこれを「OpenAI互換(OpenAI-compatible)」と呼んでいます。そこにGatewayのベースURLを貼り付けます。APIキーとしてTrueFoundryトークンを貼り付けます。トークンは開発者個人のトークンでも、共有・自動化利用のための仮想アカウント(virtual account)トークンでも構いません。TrueFoundryでは両方のオプションをドキュメントで説明していますが、本番運用スタイルの利用には仮想アカウントトークンを推奨しています。詳細はこちら
一部のIDEは、gpt-4oのような短く標準的なモデル名が設定されている場合に最も良好に動作します。TrueFoundryのモデル名は完全修飾名(fully qualified)になっていることが一般的です。推奨される解決策は、Gateway内にルーティングまたはロードバランシングのルールを定義することです。これにより、IDE側では短い名前を使い続け、Gatewayがそれを完全修飾ターゲットモデルにマッピングします。CursorとCodexはどちらも標準モデル名に紐付いた内部ロジックを持っているため、ドキュメントでこのパターンを説明しています。Cursorのドキュメント
また、ネットワーク上の制限が存在する場合もあります。CursorのリクエストフローにはCursor側のサーバーが含まれる場合があるとドキュメントに記載されています。つまり、GatewayのURLはCursorのインフラストラクチャから到達可能である必要があります。実際には、ガイドで説明されている通りにCursorを動作させるには、Gatewayエンドポイントがパブリックに到達可能である必要があります。
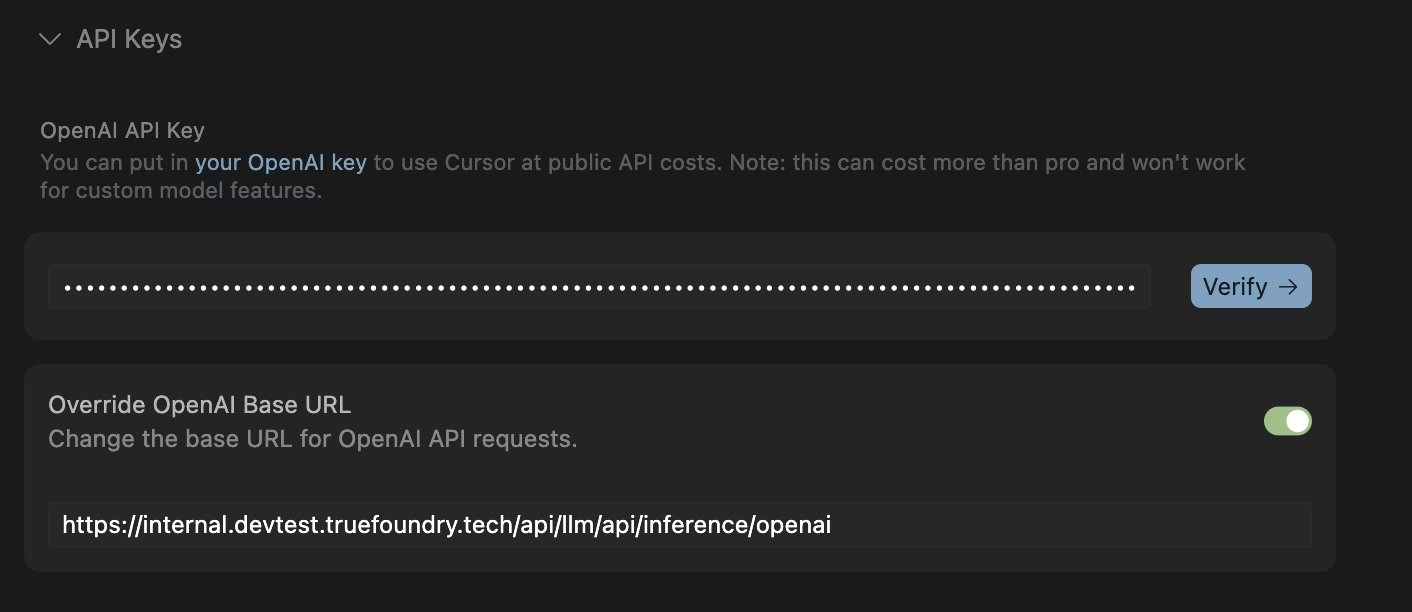
CLIツールは通常、環境変数またはローカルの設定ファイルを介して統合します。OpenAI互換のCLIにおける一般的なパターンは、OPENAI_BASE_URLにTrueFoundry Gatewayのエンドポイントを設定し、OPENAI_API_KEYにTrueFoundryトークンを設定することです。TrueFoundryでは、これをGatewayでサポートされる認証アプローチとしてドキュメント化しています。詳細はこちら:認証
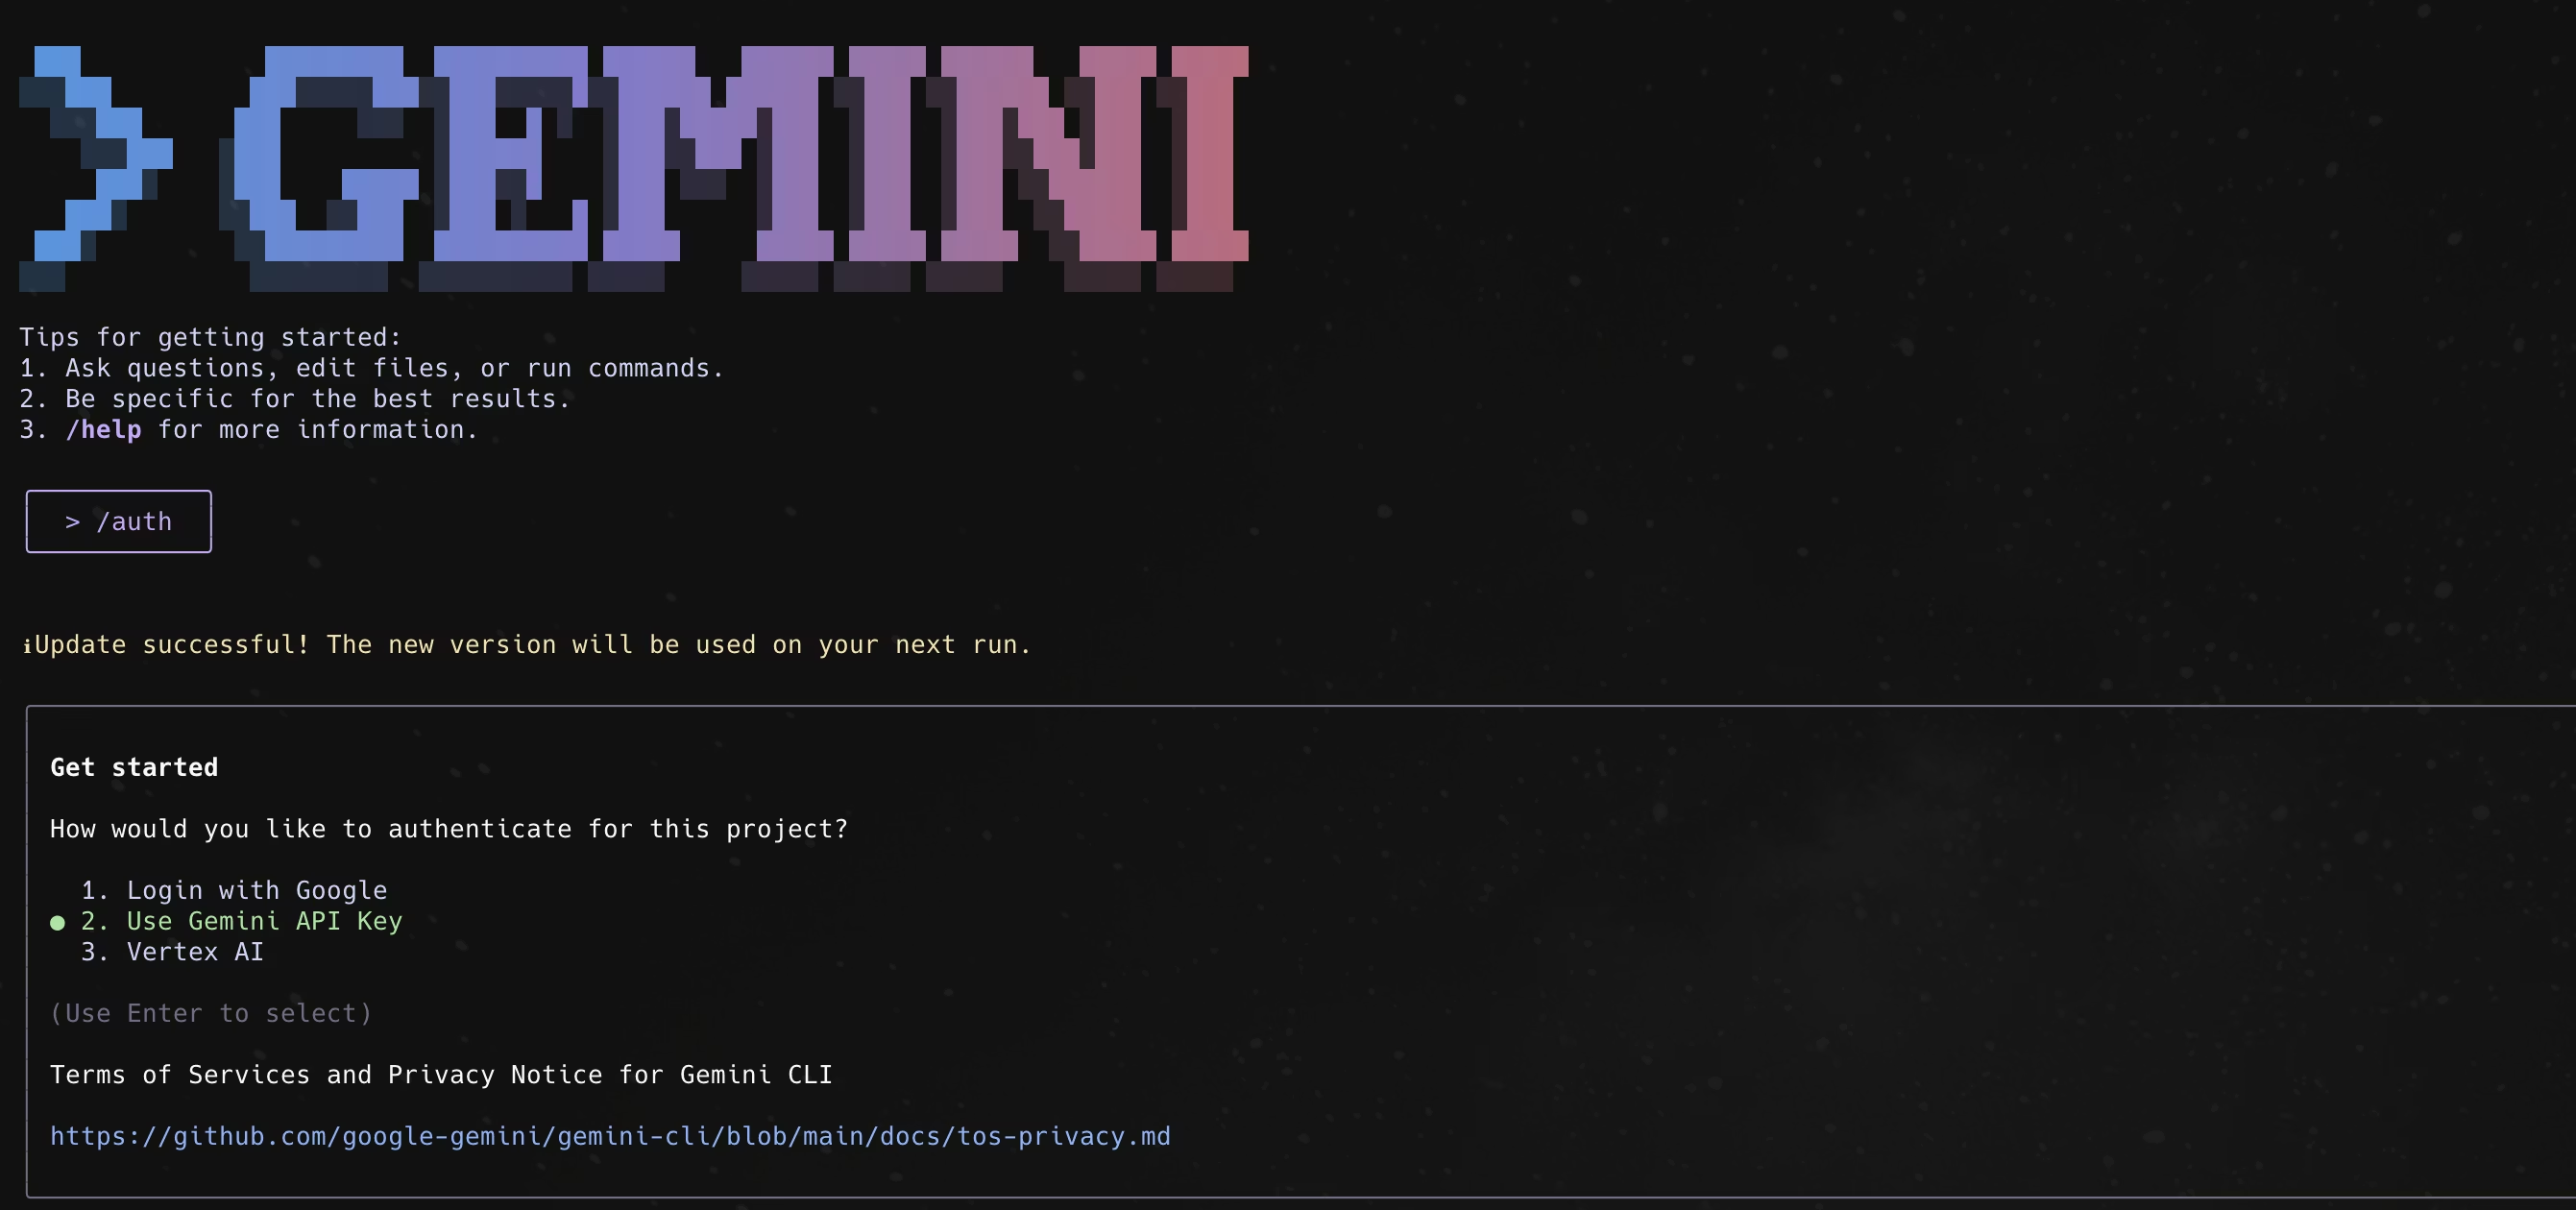
一部のCLIはプロバイダー固有の変数を使用します。Gemini CLIはGeminiベースURLとGemini APIキーを使用します。TrueFoundryのガイドでは、GOOGLE_GEMINI_BASE_URLにTrueFoundryのGeminiプロキシURLを設定し、GEMINI_API_KEYにTrueFoundryトークンを設定することで、すべてのリクエストがGatewayを経由するようにする方法を説明しています。詳細はこちら:Gemini-cli
他のCLIはsettings.jsonファイルに依存しています。Claude Codeは、ベースURLと認証ヘッダーの環境変数を設定するsettings.jsonファイルを通じて構成されます。TrueFoundryのガイドでは、ANTHROPIC_BASE_URLがGatewayを指すようにし、カスタムヘッダーでBearerトークンを使用することで、Claude CodeのトラフィックがGatewayを通じてガバナンスされる様子を示しています。詳細はこちら:Claude Code
前述した標準名のマッピングを必要とするツールもあります。Codex CLIのガイドでは、Codexが標準モデル名を前提としており、完全修飾名では正常に動作しない可能性があると説明されています。CLIではgpt-5を呼び出しつつ、Gatewayが舞台裏で適切な完全修飾モデルにルーティングするようにGatewayルーティングを使用することを推奨しています。詳細はこちら:Codex
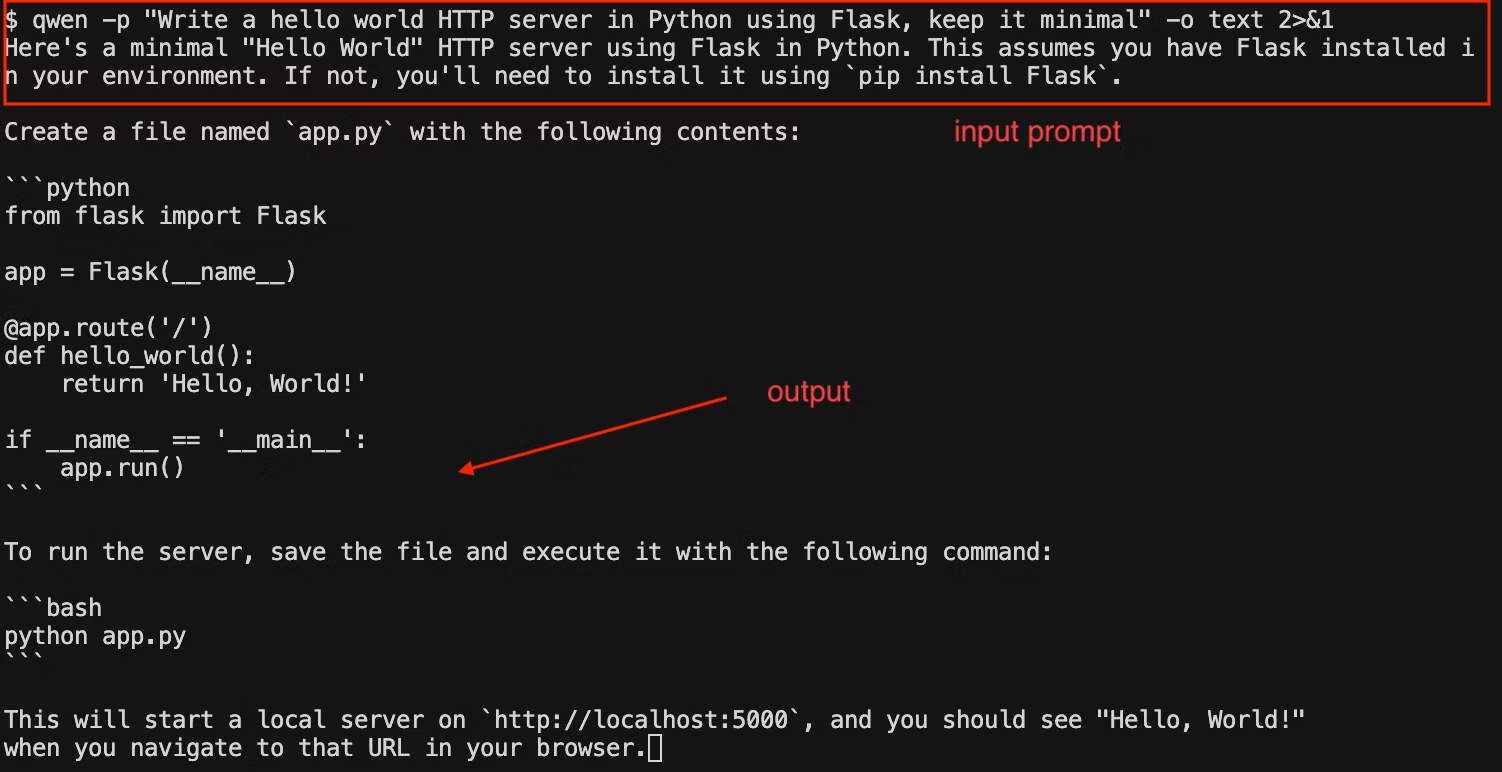
AIコーディングツールが企業全体に広がる際、最も基本的なガバナンスのニーズとなるのがモデルの承認とアクセス制御です。開発者は数分でCursorやClineをインストールし、任意のモデルプロバイダーに接続できてしまいます。ゲートウェイがない場合、個人キーを使用してコードのコンテキストやプロンプトがネットワーク外に流出するような、管理されていないルートが多数発生することになります。TrueFoundry AI Gatewayを使用すれば、コーディング利用が許可されたモデルの承認済みカタログを小さく作成し、それらのモデルをチームやユーザーグループにマッピングできます。開発者は使い慣れたIDEをそのまま利用できますが、すべてのリクエストがゲートウェイを経由するため、未承認モデルへのリクエストはブロックされます。これにより、リスクレベルに応じたアクセスの分離も可能になります。例えば、ジュニアエンジニアには手軽な修正用に低コストなモデルへのアクセス権を与え、スタッフエンジニアや本番インシデント対応チームには高度なデバッグ用に高性能なモデルへのアクセス権を与えるといった運用が可能です。重要なのは、各開発者がポリシー文書に従うことに頼るのではなく、承認が中央で強制されるという点です。
コストの所有権(コストアトリビューション)の明確化も重要になります。AIコーディングツールは、誰も気づかないうちに膨大な量のトークンを消費することがあるためです。コードベース上で試行錯誤を繰り返すエージェントを使用している開発者は、短時間で数百から数千回もの呼び出しを発生させることがあります。ゲートウェイがない場合、支出は個人キーや個別のベンダーアカウントに分散するため、財務部門は請求書を受け取っても、どのチームやアプリケーションがそれを発生させたのかを特定できません。ゲートウェイがあれば、アイデンティティベースのトークンを発行し、各IDEやCLIセッションでユーザーまたはサービスアイデンティティによる認証を必須にすることができます。これにより、使用量を個人、チーム、または社内ツールに紐付けることが可能になります。帰属が明確になれば、実践的なコントロールが可能になります。チームごとに月ごとの予算を設定したり、意図しない無限ループを防ぐためのレート制限を設定したりできます。ツールが大量のリクエストを送信し始めた場合、無制限に予算を消費させることなく、ゲートウェイ側でスロットリングをかけることができます。
インシデント対応と監査は、プラットフォームチームが日常的にその効果を実感する分野です。開発者から「アシスタントの動作が遅い」「エラーが発生する」と報告を受けた際、トラフィックがラップトップから直接ベンダーに送信されているとデバッグが非常に困難になります。問題の原因がベンダーなのか、ネットワークなのか、設定ミスされたモデル名なのか、あるいはツール固有の設定なのかを把握するのが難しいためです。リクエストがゲートウェイを経由していれば、プラットフォームチームはゲートウェイのメトリクスやログを確認し、呼び出されたモデル、レイテンシ、発生したエラー、障害が特定のプロバイダーやリージョンに限定されているかどうかを即座に特定できます。これは監査要件の基礎でもあります。セキュリティチームやコンプライアンスチームからは、コードのコンテキストがどこに送信され、誰がアクセス権を持っていたのかについての問い合わせがよく入ります。ゲートウェイは、利用された送信先と実行者の記録を保持できます。また、リクエストが外部プロバイダーに到達する前に機密文字列をマスキングしたり、特定のチームが外部エンドポイントにプロンプトを送信するのを完全に制限したりするなど、リスクを軽減するポリシーの適用もサポートします。
プロバイダーで定期的に発生する低速化やタイムアウトに対処するためには、プロバイダー障害時の信頼性が不可欠です。AIコーディングツールはインタラクティブに使用されるため、特にこのような障害に敏感です。タイムアウトが数回発生するだけでツールが壊れているように感じられ、開発者は動く別のツールに乗り換えてしまいます。また、多くのIDEは特定のモデル名を前提としています。Cursorのようなツールは、モデル名が標準的なOpenAIスタイルの形式になっている時に最も安定して動作します。プロバイダーを変更する場合、通常は全開発者の設定を変更する必要があります。しかし、ゲートウェイのルーティングを使用すれば、IDE設定のモデル名は変更せず、舞台裏でマッピング先を変更するだけで済みます。あるプロバイダーがタイムアウトしている場合は、別のプロバイダー、別のアカウント、あるいは別のリージョンへ自動的にルーティングできます。開発者は同じIDE設定を使い続けることができ、ツールがそのまま機能し続けるのを確認するだけです。これは、新しいモデルを導入したい場合にも役立ちます。ユーザーエクスペリエンスを安定させたまま徐々に新しいモデルへトラフィックを移行でき、品質やレイテンシが許容範囲に達しない場合は迅速に切り戻す(ロールバックする)ことができます。
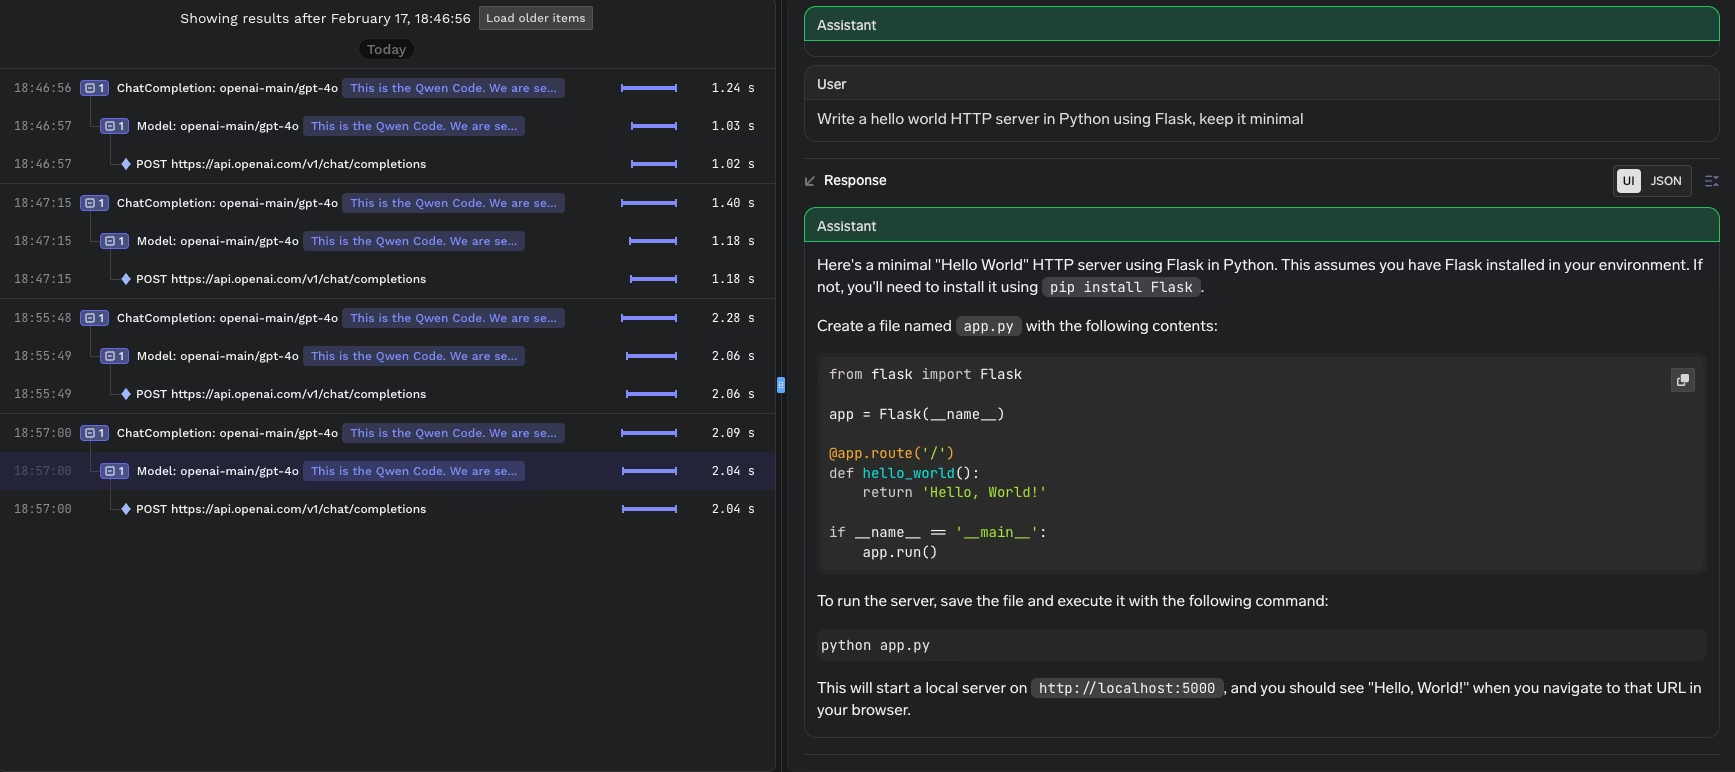
AIコーディングIDEは開発者の生産性を劇的に向上させます。一方で企業には、ソース管理やCIシステムに適用しているのと同等のガバナンスが求められます。現実的なアプローチは、開発者にツールの変更を強制することなく、管理・制御を中央に集約することです。TrueFoundry AI Gatewayは、まさにそのコントロールポイントとして機能するよう設計されています。Claude Code、Cline、Cursor、Gemini CLI、OpenAI Codex CLI、Qwen Code CLI、Roo Code、Gooseにわたる統合ガイドは、すべて同じ原則に従っています。開発者のワークフローはそのまま維持し、ポリシー、可視性、そしてコントロールのみをゲートウェイに集約します。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























