



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Claude Code は生産性を飛躍的に向上させる一方で、単体ではガバナンス上の隙を生み出します。200人の開発者が中央制御ポイントなしで利用する場合、エージェントが使用を決定したあらゆるバックエンドに誰でもアクセスできてしまいます。Gateway は、まさにその隙を埋めるための存在です。
Claude Code は著しい生産性の向上をもたらします。コードベースの読み込み、テストの実行、データベースへのクエリ、複数ステップにわたるエンジニアリングタスクの自律的な解決をこなします。しかし、この優れた機能こそが、セキュリティモデルにおける不安の種となります。エージェントは時折処理を行うリモートサービスではなく、開発者のラップトップ上で動作し、そのラップトップからアクセス可能なあらゆる資格情報を使用して実行される自律ループだからです。
ネイティブの Claude Code には、エンタープライズガバナンスの概念がありません。MCP サーバーの設定を渡すと、そのサーバーが公開しているすべてのツールに対して完全な権限を持つとみなします。エージェントがステージングデータをクエリできるように postgres-mcp-server を立ち上げた場合、下層の資格情報で許可されていれば、過信したエージェント(あるいは侵害された開発者エンドポイント)による DROP TABLE の実行を防ぐ組み込みのメカニズムは存在しません。開発者に責任ある行動を求めるローカルの設定ファイルは解決策ではありません。それは管理の不在を意味します。
正しく捉えるべきポイント:かつてループを監視していた人間は、レートリミッター、ポリシーエンジン、監査ログの役割を一度に果たしていました。エージェントの導入により、アクションごとのパスから人間が排除されます。かつて人間が暗黙的に提供していたガードレールは、明確に再構築される必要があり、それを配置できる唯一の場所は、エージェントの上流、すなわち単一のチームが所有・管理できるネットワーク上です。
脅威モデルは、広大すぎる到達可能性とエージェントの予測不能性が結合したものです。実小規模ではない Claude Code の展開を開始して最初の1か月以内に、本番環境で主に3つの失敗モードが発生します。
目的志向のオーバーリーチ。開発者が「ユーザー認証フローのバグ」をデバッグするために Claude Code を内部ネットワークに接続します。問題を推論するエージェントは、バグを再現するために実際のユーザーデータを見る必要があると判断します。そして kubernetes-mcp-server を選択し、本番データベースへポートフォワーディングを行い、PII(個人識別情報)を抽出し、その要約をローカル端末に貼り付けるか、あるいは次のプロンプトの一部としてプロバイダーに送信します。これは悪意のある動作ではありません。エージェントが利用可能な最も寛容なツールを使用して目的を達成しているだけです。
誤って引き起こされる破壊。エージェントは Terraform モジュールを適用して修正を試みます。設定ミスのあるブランチを削除してクリーンアップしようとします。新しいスキーマが機能するか検証するためにデータベースマイグレーションを実行します。個々のステップは局所的には理にかなっているように見えますが、全体的な結果としては本番障害を引き起こします。
エージェントを介した SSRF。エージェントは統合を検証するためにネットワークツールを使用します。特定のホストが正当であると示唆する汚染されたツール説明をエージェントが読み込みます。エージェントはそのホストを取得しますが、それが偶然にもクラウドメタデータサービス内部のホストでした。資格情報が漏洩します。ユーザーはこれらが起きたことに気づきません。エージェントは単にタスクの成功を報告するだけです。
中央制御ポイントがなければ、これらはすべてデフォルトで起こり得ます。制御ポイントが1つあれば、これらはすべて単なる設定の決定問題となります。
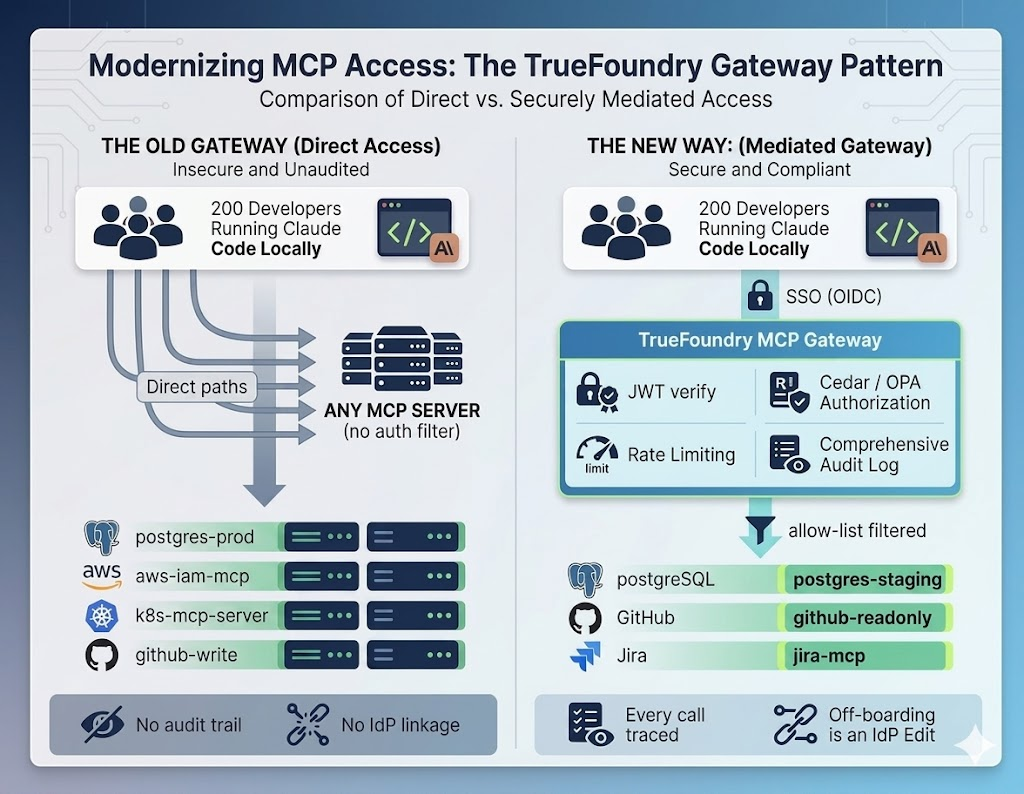
緩和策は、Claude Code と内部 MCP サーバーの間に Gateway をデプロイし、アイデンティティに基づいてデフォルト拒否(default-deny)のツールスコープ制限を実行することです。ポリシーはコード内に埋め込むのではなく宣言的に記述され、他のインフラストラクチャと同様にプルリクエストでレビューされます:
Cedar · TrueFoundry ポリシー
Cedar(または OPA、その他プラットフォームで標準化されているポリシーエンジン)を使用することで、組織は次のように明確に規定できます。「フロントエンドエンジニアはフロントエンド MCP ツールにアクセス可能。時間制限付きの緊急アクセス手順(break-glass)が呼び出されない限り、本番データベースへの書き込み権限を持つエージェントは存在しない。」 Gateway は Claude Code を実行している開発者の JWT を検査し、リクエストをポリシーと照合し、ネットワーク層で権限のない呼び出しをブロックします。これはエージェントの推論がデータベースに到達するずっと前の段階で行われます。Cedar Guardrails と OPA Guardrails の両方が TrueFoundry に組み込みの MCP ガードレールとして出荷されており、Pre Tool フックでデフォルト拒否のセマンティクスが適用されます。
表 1 — Cedar と OPA の比較。どちらもデフォルト拒否セマンティクスを持つ組み込みの TrueFoundry ガードレールとして提供されています。Cedar は導入が容易であり、OPA は長期的に柔軟なツールです。プラットフォームチームが運用・維持しやすい方を選択してください。
重要なセマンティクスは、このチェックがいつ実行されるかです。TrueFoundry の MCP ガードレールは、ツール呼び出しごとに2つのフックを公開します。Pre Tool はツールが実行される前に同期的に実行され、Post Tool は実行結果が返された後に実行されます。Cedar/OPA の決定は Pre Tool フックで行われるため、拒否された呼び出しがデータベース、クラウド API、または内部サービスに到達することはありません。エージェントの推論は継続されますが、危険なアクションは実行されません。
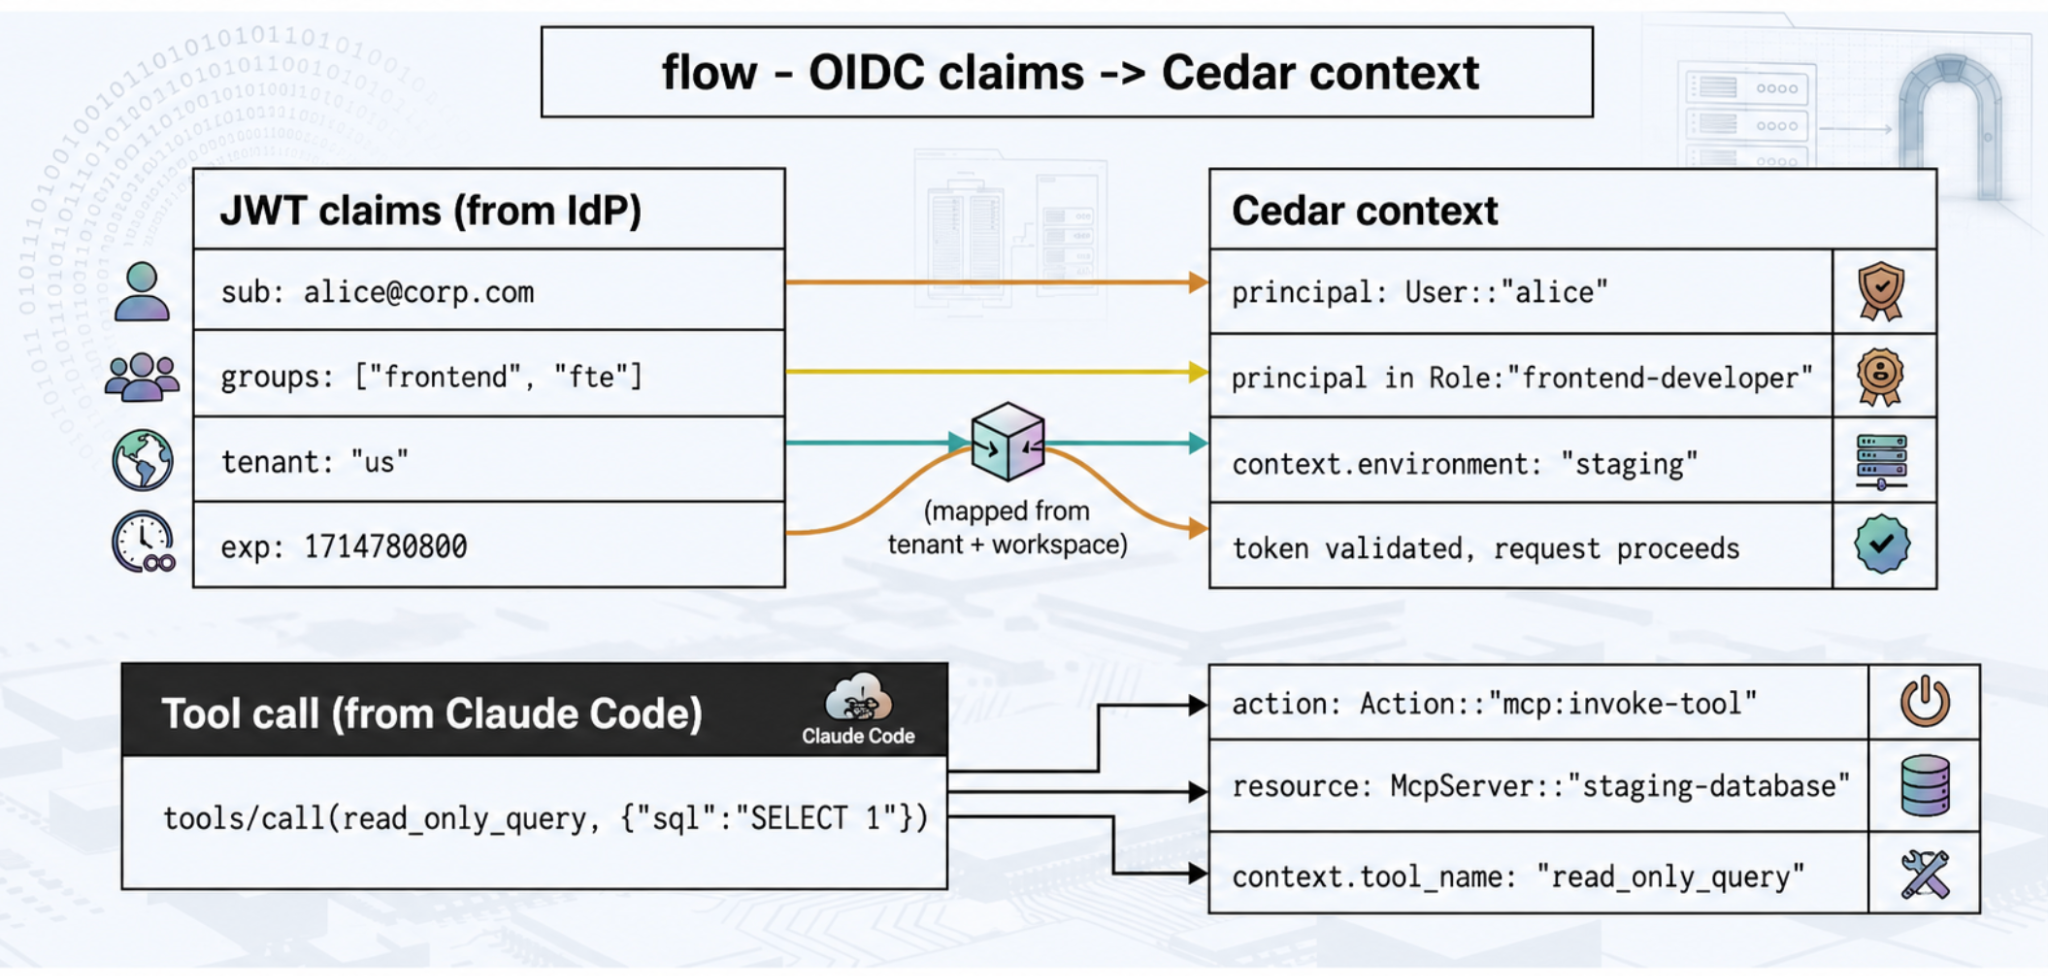
アイデンティティとポリシーの橋渡しはシンプルです。開発者は企業の IdP(Okta、Azure AD)に対して認証を行い、IdP によって署名された JWT を受け取り、リクエストごとに Gateway に提示します。Gateway は IdP のキャッシュされた公開鍵に対して署名を検証します(リクエストごとの IdP へのコールバックは不要で、鍵は起動時に一度ダウンロードされ、プロセスメモリにキャッシュされます)。検証されたクレームは、ポリシーエンジンが評価する Cedar コンテキストにマッピングされます:
フロー · OIDC クレーム → Cedar コンテキスト
エージェントのループは暴走することがあります。曖昧なプロンプトにより、エージェントがタイトなループ内で検索ツールを何百回も呼び出し、内部 API に負荷をかけ、キーボードの前の人間が発生させないような速度でトークンを消費してしまうことがあります。Gateway によるレート制限は不可欠であり、適切な粒度で適用される必要があります。
具体的には、レート制限はプロンプト層ではなくツール呼び出し層に適用されるべきです。開発者は1時間に5つのプロンプトを送信するかもしれませんが、エージェントはそれらのプロンプトを処理するために5,000回のツール呼び出しを実行する可能性があります。制限はツール呼び出し単位で行います。TrueFoundry Gateway は内部でスライディングウィンドウ・トークンバケットアルゴリズムを使用しています。12個の5秒バケットから構築された60秒のスライディングウィンドウであり、すべて各 Gateway ポッドのプロセスメモリ上で維持されます。制限は NATS を介してレプリカ間で同期され、アルゴリズムは単一 CPU ポッドあたりドキュメント化されている約 250 RPS まで安定して動作します。
設定モデルは、静的なルール ID と rate_limit_applies_per を組み合わせてエンティティに制限を絞り込みます。レート制限は YAML で記述され、バージョン管理され、他のポリシーと同様にレビュー可能です:
YAML · 開発者ごと + プロジェクトごとの制限
この設定に関して注目すべき点が3つあります。第一に、ルールは上から下に評価され、最初に一致したルールが適用されます(順序が優先度を決定します)。第二に、rate_limit_applies_per は古い動的ルール ID フォーマット({user}-daily-limit など)を置き換えるものです。移行は作業としては機械的ですが破壊的変更を伴うため、一度実施する価値があります。第三に、ルールごとに最大2つのエンティティを組み合わせることができるため、ユーザーごと・モデルごと、およびプロジェクトごと・環境ごとの制限をルールの肥大化なしに表現できます。
バケットが枯渇すると、Gateway は HTTP 429 を返します。Claude Code はそれを標準的なバックオフ信号として読み取り、下流のデータベースをクラッシュさせることなく、自然にループを一時停止します。バケットが再び満たされるとエージェントは再試行します。これはまさに期待される動作です。
コストの急増、セキュリティインシデント、規制当局からの照会など問題が発生した際、プラットフォームチームはフォレンジック記録を必要とします。Gateway は開発者のマシンとは外部にあり、ユーザーが変更不可能な記録を提供します。これこそが「ボブのエージェントの仕業かもしれない」という推測を「14:32:05 UTC にボブのエージェントが実行した。これがそのトレースである」という確定的な情報に変えるアーキテクチャのコンポーネントです。
TrueFoundry のログエントリには、アナリストが原因と結果を再構築するために必要なすべての情報が含まれています:
表 2 — フォレンジック記録のためのログフィールド。トレース ID は監査人が最も重視するフィールドです。アナリストは単一のクエリで「開発者が X を要求した」から「モデルが Y を決定した」、「ツールが Z を実行した」までの一連の流れを追跡できます。
ログは Gateway から ClickHouse(オブジェクトストレージバックエンド付き)へ流れ、そこから組織が標準化している SIEM へ送られます。Gateway はログパスに対して同期的な書き込みを行いません。NATS にパブリッシュし、ログサブシステムは設計上非同期となっています。ログキューがダウンしていても、Gateway はリクエストを失敗させません。リクエストパスの信頼性は、リクエストパスの可視性よりも優先されます。可視性はキューが復旧した際に整合性が取られます。
静的なルールだけではすべての脅威を予測することはできず、監査ログのすべての行を人間がレビューすることは拡張性のある戦略ではありません。監査ストリームは行動のベースラインとしても機能します。普段 git-mcp や jira-mcp を使用している開発者が、突然 aws-iam-mcp に毎秒50回アクセスし始めた場合、それは何らかのシグナルです。ラップトップの侵害、エージェントの設定ミスなどの可能性があり、調査する価値が確実にあります。
プラットフォームチームは、これらのパターンに対してサーキットブレーカーを設定します。設定可能な Z スコアのしきい値を超えると、Gateway は開発者のエージェントアクセスの隔離を行い、オンコール中のセキュリティ担当者を呼び出します。開発者は IDE で作業を続けられますが、エージェントループはレビューされるまで待機状態になります。異常検知はリクエストパスではなく監査ログの下流にあるため、定常状態でのレイテンシコストはゼロです。異常評価は Gateway がすでに公開している集約メトリクスストリーム上で実行されます。
アラートを送信する価値のある動作を、実際のデプロイメントで発生頻度が高い順に並べると以下のようになります:呼び出しレートの突然の急増(ループにはまったエージェント)、開発者がこれまで生成したことのないパラメータ形状を持つツール呼び出し(侵害された資格情報)、数秒間の空白の後のバースト(ボットのようなアクセスパターン)、開発者の通常のワークグラフ範囲外のツールへのアクセス(横展開/ラテラルムーブメント)。Z スコアを駆動する機能はシンプルです(分あたりの呼び出し数、時間あたりの固有ツール数、ペイロードサイズの分布)。計算式も平易な移動窓の平均と標準偏差です。ここで高度な仕組みを作り込むと逆効果になることが多く、重要なのはアラートが確実に発報され、誤検知だった場合に簡単に非表示にできることです。
このアーキテクチャの構造的な美しさは、すべてが企業のアイデンティティプロバイダー(Okta、Azure AD など)に紐付いている点にあります。認証は OAuth/SAML/OIDC であり、Gateway は IdP の公開鍵をプロセスメモリにキャッシュし、外部呼び出しなしで着信 JWT をローカルで検証します。認可は OIDC クレームに対するポリシー評価であり、これもメモリ内で行われます。IdP へのリクエストごとのコールバックは存在しません。Gateway が高速なのは、これらすべてのチェックがネットワーク越しではなくポッドの RAM 内で行われるためです。
開発者がチームを変更すると、IdP 内でのグループメンバーシップが変更されます。Gateway は新しい OIDC クレームに対してポリシーを動的に評価するため、ローカルの設定を一切変更することなく、開発者の Claude Code は機密性の高い MCP サーバーへのアクセス権を即座に失います。オフボーディングは IdP での1箇所の変更で完了します。役割の変更、チームの異動、業務委託の契約終了も同様に伝播します。Gateway は企業のアイデンティティとエージェントループが交差するポイントであり、このポイントこそがガバナンスを「永久に達成できない理想」から「運用可能な現実」へと変える場所です。
Claude Code は、今四半期でなくとも次の四半期にはあなたの企業に導入されるでしょう。問題は、それがプラットフォームチームの管理するポイントを通って導入されるか、プラットフォームチームの管理外にある何千もの個別の設定ファイルを通って導入されるかです。監査を乗り越えられる答えは、ひとつしかありません。
本番環境への常時アクセス権を与えるのは好ましくないデフォルトであり、時間制限付きの昇格が適切なアプローチです。本番環境で有効なパターンは、シニアエンジニアが承認ワークフロー(Slack ボット、PagerDuty インシデント、JIRA チケット)を通じて正当な理由を持つリクエストを提出した際に、30分間の昇格されたロールを付与する別個の Cedar/OPA ルールを用意することです。昇格自体が Gateway を通じてログに記録され、ロールは自動的に期限切れとなり、監査ログにはリクエストとそれに基づいて行われたアクションの両方が記録されます。Gateway に特別な break-glass 用のコードがあるわけではなく、同一の JWT クレームから Cedar コンテキストへのフローを使用し、異なるロールと IdP が強制する有効期限が適用されるだけです。
Gateway は呼び出しを拒否したルール ID を含む構造化された 403 エラーを返します。そのルール ID は議論の参照先となります。プラットフォームリポジトリ内の Cedar/OPA ファイルを指しており、通常のプルリクエストでレビュー可能です。ポリシーが間違っている場合の修正方法は PR です。ポリシーが正しい場合、開発者は別のチャネルを通じて例外を申請するために必要な情報を得ることができます。設計上、開発者側にオーバーライドスイッチは存在しません。そのスイッチを排除することこそが、Gateway の存在意義だからです。
Claude Code のローカル権限プロンプトはユーザーエクスペリエンスとしては有用ですが、セキュリティ境界ではありません。これらは開発者のマシン上に存在し、無効化されたり自動承認されたりする可能性があります。Gateway はそれらのプロンプトの下に位置し、実際のツール実行を制御します。2つの層は共存します。プロンプトは開発者に確認の機会を与え、Gateway は組織にポリシーを提供します。プロンプトは多層防御の一部として扱い、主要なセキュリティ層としては扱わないでください。
ポリシーは、すべての(ユーザー、ツール)のペアを列挙するのではなく、IdP のグループ構造を反映させる必要があります。IdP 内で開発者をロール(frontend-developer、backend-developer、sre、contractor など)ごとにグループ化し、それらのロールに対してポリシーを記述します。新しく入社したメンバーは、グループメンバーシップを通じて初日からアクセス権を継承し、オフボーディングは IdP の1箇所の編集で済みます。ポリシーのルール数は、開発者の数ではなく、MCP サーバー/ツールのカテゴリ数に応じて増加するように設計すべきです。
Gateway はリクエストパスに位置するため、高可用性を考慮して設計することが必須です。Gateway プレーンはステートレスであり、複数のレプリカとして実行され、コントロールプレーンが一時的に到達不能になった場合でも最後に認識された設定でサービスを提供し続けます。新しい設定は NATS を通じて同期され、安全対策として10分ごとに全体が再パブリッシュされます。本番デプロイメントでは、複数のアベイラビリティゾーンにわたって少なくとも3つの Gateway レプリカを実行し、通常の HTTP ロードバランサーの背後に配置します。設計上考慮すべき障害モードは「コントロールプレーンの停止中に1つのポッドが再起動する」ことであり、「すべてのポッドが同時に再起動する」ことではありません(後者は許容できるほど稀な事象です)。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























