



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Hermes Agent est un agent IA autonome développé par Nous Research et publié en open-source sous licence MIT. Nous le décrit comme « l'agent IA auto-améliorant » et « le seul agent doté d'une boucle d'apprentissage intégrée — il crée des compétences à partir de son expérience, les améliore en cours d'utilisation, s'incite lui-même à persister les connaissances et construit un modèle de plus en plus précis de qui vous êtes au fil des sessions » (documentation Hermes Agent, consultée en septembre 2026).
Le cadrage est important. Hermes n'est pas un copilot de codage intégré à un IDE, ni un simple wrapper de chat autour d'une clé API unique. C'est un processus que vous lancez et laissez s'exécuter. La propre documentation de Nous l'indique clairement : il « vit là où vous le placez — un VPS à 5 $, un cluster de GPU, ou une infrastructure serverless (Daytona, Modal) qui ne coûte presque rien lorsqu'elle est inactive. Échangez avec lui depuis Telegram pendant qu'il travaille sur une VM cloud sur laquelle vous ne vous connectez jamais en SSH. »
La façon la plus claire de comprendre ce que vous obtenez est de le comparer à ce que la plupart des équipes utilisent déjà.
Cette dernière ligne n'est pas une faute de frappe. C'est l'essence même du compromis.
Nous Research est un laboratoire de recherche en IA surtout connu pour la famille de modèles open-weight Hermes et pour ses travaux sur l'entraînement distribué comme Psyche. Hermes Agent est leur projet d'agent, et la courbe d'adoption a été particulièrement rapide pour une publication open-source.
Il occupe également la première place dans les catégories Productivity, Coding Agents, Personal Agents et CLI Agents d'OpenRouter à la même date. TechCrunch a rapporté en juillet 2026 que Nous Research était en pourparlers pour une levée de fonds sur la base d'une valorisation de 1,5 milliard de dollars — en pourparlers, pas encore conclue.
Analysés objectivement, ces chiffres montrent que Hermes est l'un des projets d'agents IA open-source les plus utilisés au monde, et non une simple curiosité.
[SCREENSHOT: Hermes Agent — l'écran d'accueil de l'application de bureau montrant une conversation active, issu de hermes-agent.nousresearch.com]
Le terme « auto-améliorant » ne veut souvent rien dire. Dans Hermes, il s'articule autour de deux sous-systèmes concrets qui écrivent des fichiers sur le disque. Il est important d'être précis sur les deux, car leurs limites constituent l'élément clé des choix d'ingénierie.
Hermes conserve deux espaces de stockage dans le répertoire de profil : MEMORY.md pour les faits relatifs à l'environnement, les conventions et les leçons apprises, et USER.md pour savoir qui vous êtes et comment vous préférez qu'il s'adresse à vous. L'agent y écrit lui-même à l'aide d'un outil de mémoire proposant les actions ajouter, remplacer et supprimer — il n'y a pas d'action de lecture, car la mémoire est injectée dans le prompt système au début de la session.
Trois détails de la documentation relative à la mémoire importent plus que le discours marketing :
Le contexte plus ancien est récupéré grâce à session_search, une recherche plein texte FTS5 dans les sessions passées, complétée par une synthèse réalisée par LLM.
Les compétences sont le cœur de l'argument « évolue avec vous ». Selon la documentation des compétences, une compétence est un fichier SKILL.md avec des métadonnées (frontmatter) et un ordre de sections fixe — Quand l'utiliser, Procédure, Pièges, Vérification — que l'agent peut créer lui-même après avoir résolu un problème.
Le chargement est délibérément échelonné, ce qui constitue une approche pertinente à adopter même si vous n'exécutez jamais Hermes :
Niveau 0 : skills_list() -> nom, description, catégorie (~3k tokens)
Niveau 1 : skill_view(name) -> contenu complet de la compétence
Niveau 2 : skill_view(name, path) -> un fichier de référence spécifique
Seul le niveau 0 est en permanence dans le contexte. L'agent consomme le reste à la demande. Il existe également une commande /learn qui transforme un répertoire, une URL, un PDF ou « le workflow que vous venez de faire effectuer à l'agent dans cette conversation » en une compétence. Pour les sources volumineuses, il crée une compétence de base de connaissances avec un index et des fichiers par sujet sous references/ plutôt qu'un seul fichier trop lourd. Les compétences suivent la norme ouverte agentskills.io, ce qui les rend portables d'un agent à l'autre.
[SCREENSHOT: Hermes Agent — la page Skills dans le tableau de bord, montrant les compétences installées et le panneau « Learn a skill »]
La valeur de tout harness d'agent se mesure à ce que vous n'avez plus besoin de coder vous-même. En septembre 2026, la documentation d'Hermes répertorie :
Ce dernier point offre véritablement plus de fonctionnalités que la majorité des agents open-source actuels, et mérite d'être souligné.
Trois méthodes, toutes documentées sur le site de Nous Research :
Après l'installation, hermes setup --portal exécute une authentification OAuth unique qui couvre un modèle ainsi que la passerelle d'outils hébergée (recherche web, génération d'images, TTS, navigateur).
Le choix des modèles vous appartient : Nous Portal, OpenRouter, OpenAI, ou tout endpoint compatible. Les offres de Portal telles que publiées en septembre 2026 sont Free (0 $, modèles gratuits uniquement), Plus (20 $/mois, 22 $ de crédits), Super (100 $/mois, 110 $ de crédits) et Ultra (200 $/mois, 220 $ de crédits), chacune donnant accès à plus de 200 modèles. L'agent lui-même est gratuit.
[SCREENSHOT: Hermes Agent — le flux d'installation dans le terminal et de première configuration sur Linux]
Quatre modes de défaillance apparaissent fréquemment dès lors qu'un agent Hermes dépasse le cadre d'un projet personnel du week-end.
L'exécution en continu est un modèle de facturation, pas seulement une architecture. Un agent sans état génère des coûts lorsque vous l'appelez. Un agent actif en permanence doté de tâches cron, de sous-agents et d'une passerelle de messagerie génère des coûts dès qu'il décide d'effectuer une action. La propre documentation de Nous signale le coût de compaction des sessions de passerelle de longue durée. Sans visibilité sur les dépenses par agent, votre première alerte sera le montant de la facture.
Le système de mémoire présente des limites strictes. Un budget de 2 200 caractères et un snapshot figé au début de la session sont des choix d'ingénierie raisonnables, mais ils entraînent des comportements où l'agent semble ne pas appliquer vos consignes. Les petits modèles locaux en particulier affirmeront « J'ai enregistré cela » sans jamais appeler l'outil de mémoire — la documentation le mentionne explicitement.
Les approbations se font par machine, et non par organisation. approvals.mode réside dans un fichier YAML unique sur un hôte donné, et une commande /yolo ou HERMES_YOLO_MODE contourne toutes les demandes de confirmation pour une session. Pour un développeur isolé, cela a du sens. Pour douze développeurs, votre niveau de sécurité dépend uniquement de la dernière commande saisie par chacun, sans possibilité d'audit centralisé.
Un agent est simple à gérer ; vingt agents deviennent un problème de plateforme. Chaque instance Hermes conserve ses propres identifiants, clés de modèle, connexions MCP et mémoire sur son propre disque. Il n'y a pas de modèle d'identité partagé, pas de budget centralisé, pas de vue de traçabilité inter-agents. Ce n'est pas une critique — Hermes est un outil mono-agent très performant. C'est simplement le constat de ce qui se trouve en dehors de son périmètre.
Pour évaluer correctement un projet de qualité, il faut en connaître clairement les limites :
Si vous êtes un développeur souhaitant un agent IA open source performant qui s'adapte à votre travail spécifique, Hermes est un choix très solide. Si vous faites partie d'une équipe plateforme, poursuivez votre lecture.
Il existe deux couches distinctes ici, et les confondre est la raison pour laquelle de nombreux projets d'agents bloquent au stade de pilote.
Un harness d'agent contrôle le fonctionnement interne d'un agent : la boucle, les outils, l'état, la sandbox. Une passerelle IA (AI gateway) contrôle la manière dont cet agent accède aux modèles et aux outils : accès, budgets, routage, politiques, traces. Hermes est un excellent harness. Ce n'est pas une passerelle, et il ne prétend pas l'être.
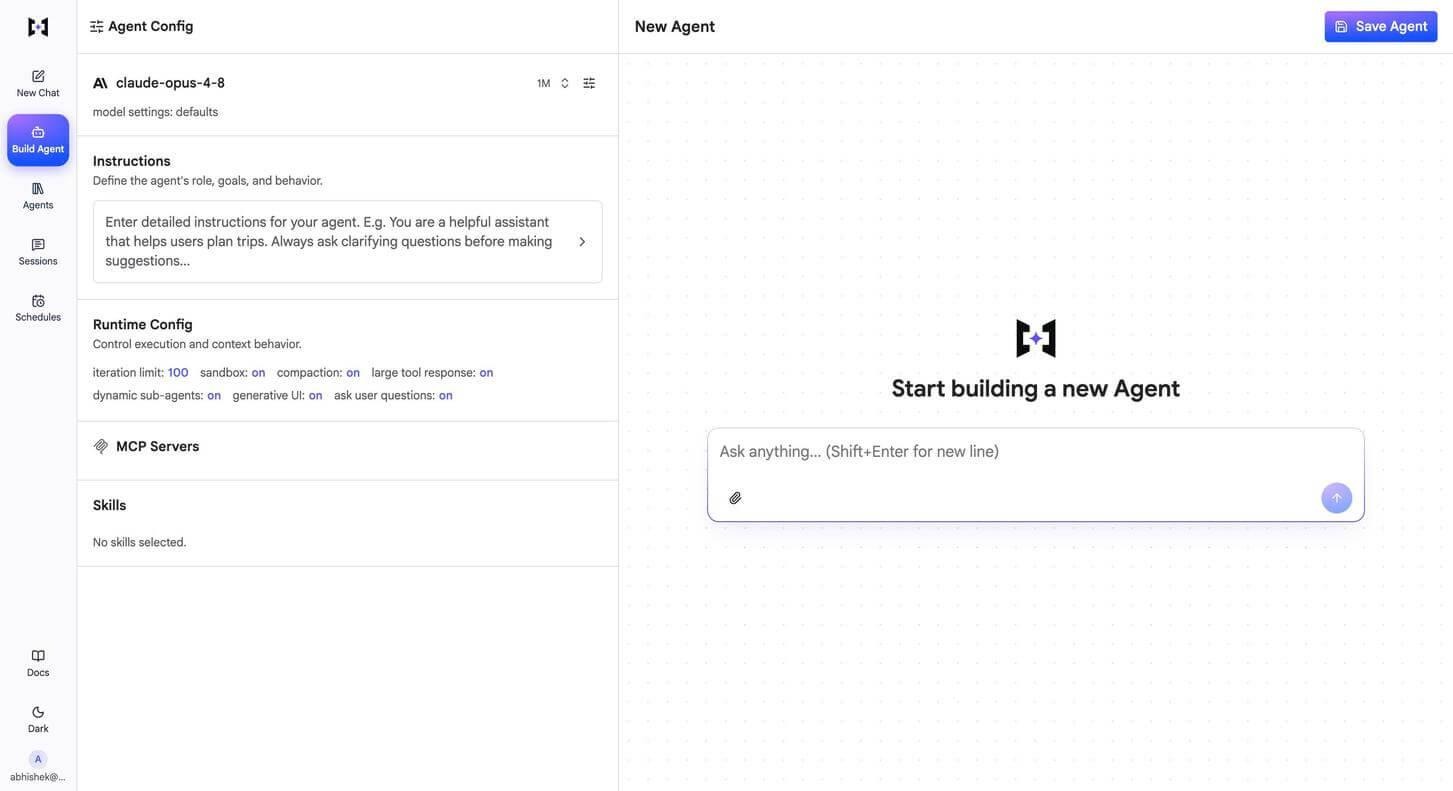
TrueForge est le harness d'agent de TrueFoundry, open-source, sous licence MIT et neutre vis-à-vis des modèles (github.com/truefoundry/trueforge). Comme Hermes, il gère la boucle d'agent, l'exécution des outils, la gestion du contexte et le sandboxing. Contrairement à un agent auto-hébergé isolé, il intègre le plan de contrôle global : accès MCP et identifiants centralisés, approbations human-in-the-loop, exécution en sandbox, observabilité et gouvernance pour l'ensemble des équipes et des environnements. Exécutez-le localement avec npx @truefoundry/trueforge, ou déployez-le pour une équipe avec Docker Compose ou Helm.
Dans le benchmark de TrueFoundry par rapport à Claude Managed Agents, TrueForge a atteint une précision de tâche équivalente en consommante nettement moins de tokens.
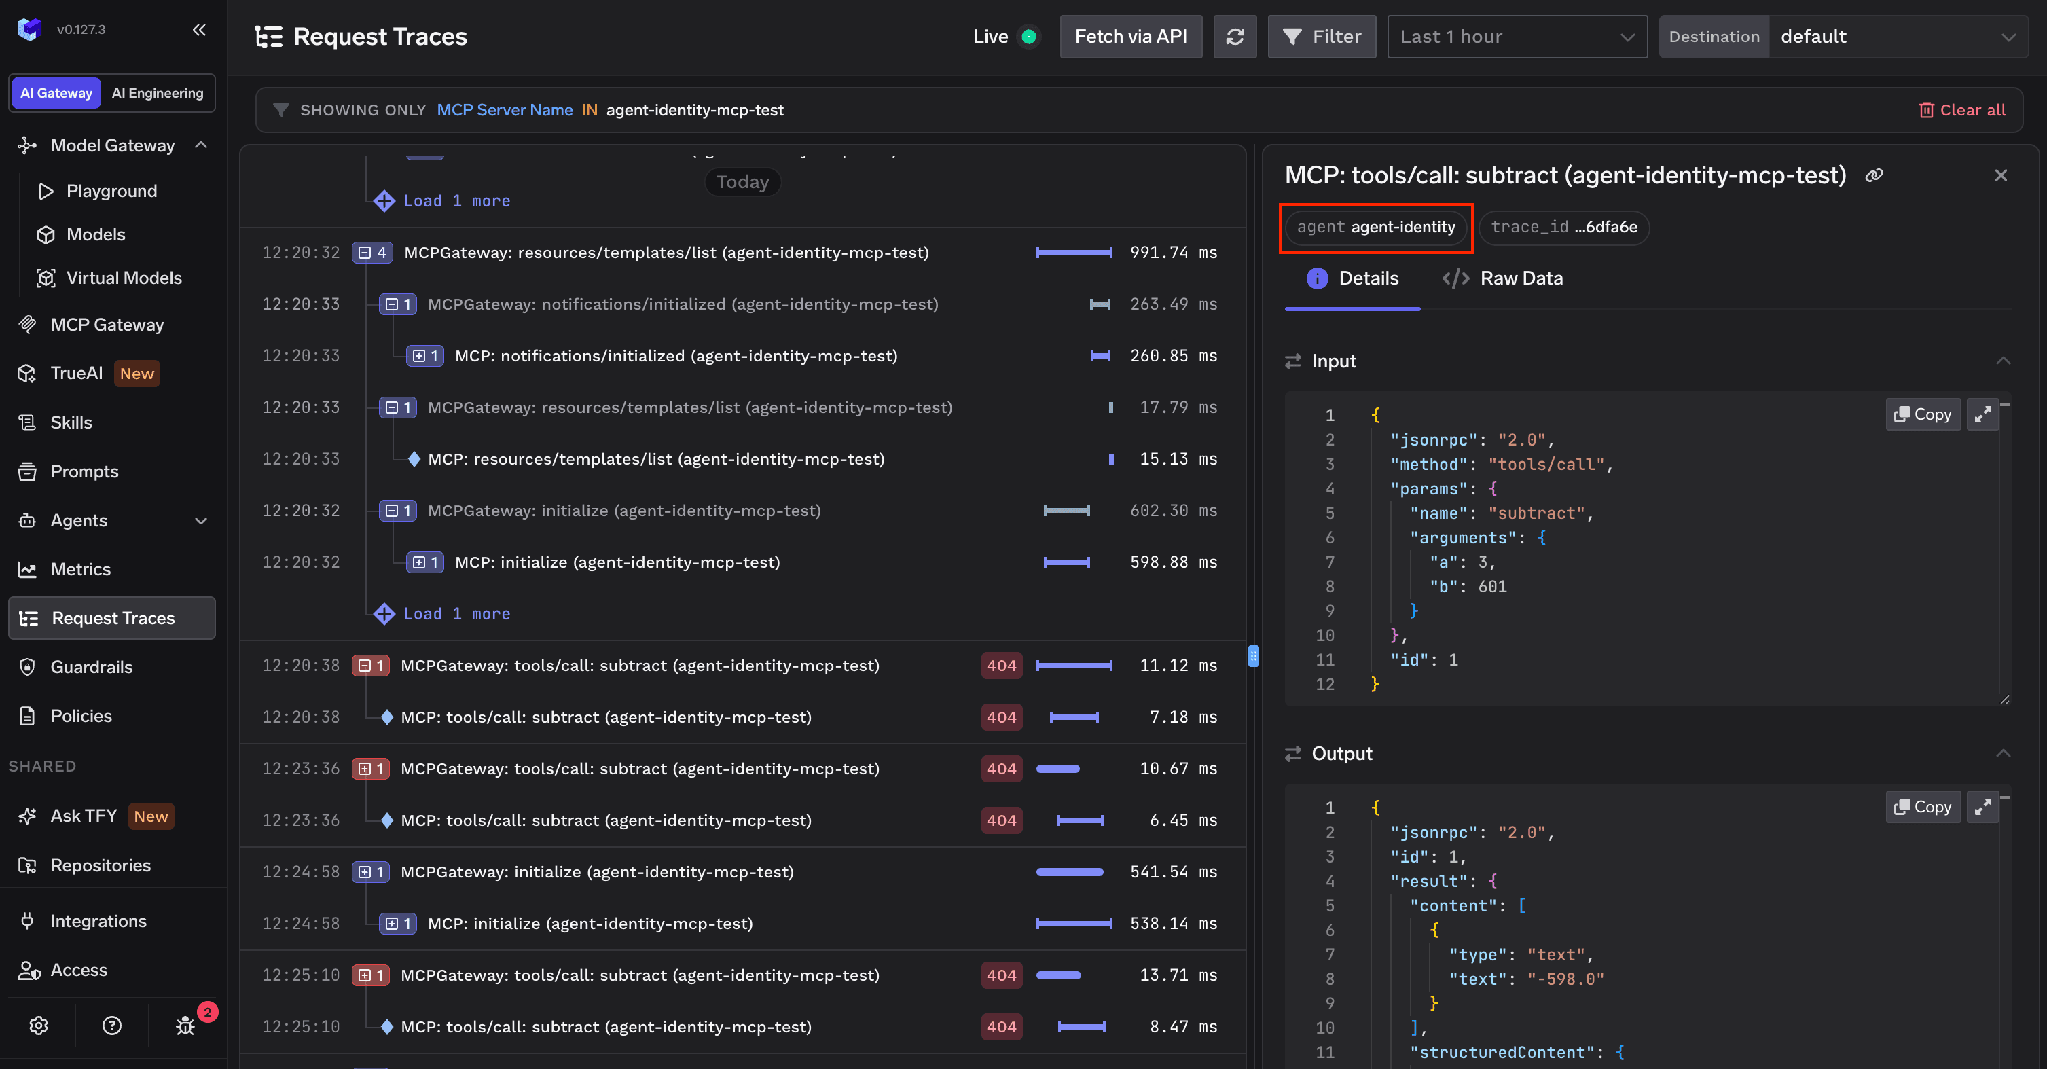
Il s'agit de la partie qui s'applique, que vous utilisiez Hermes, TrueForge ou les deux. Le choix du harness n'impose pas nécessairement celui de la gouvernance.
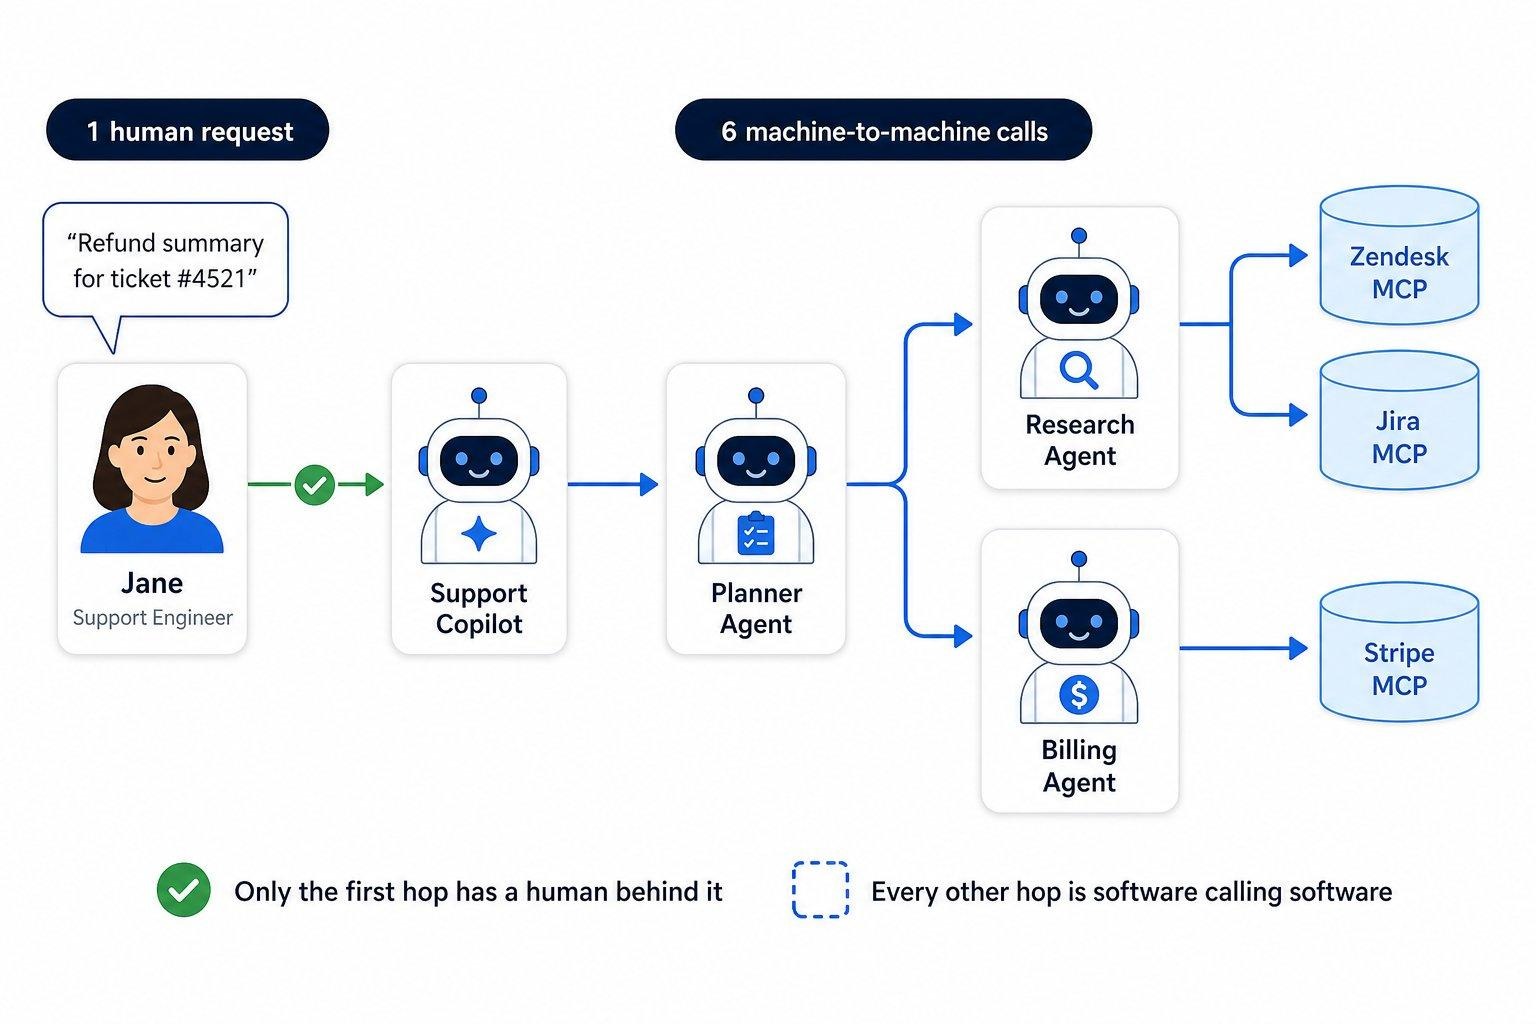
Puisque Hermes communique avec « tout endpoint compatible », vous pouvez le diriger vers une passerelle plutôt que directement vers les fournisseurs. L'AI Gateway de TrueFoundry se place alors en amont de chaque appel de modèle et de MCP effectué par l'agent : accès centralisé aux modèles, budgets par équipe, limites de débit (rate limits), garde-fous (guardrails), gestion des identifiants et traces unifiées. Elle prend en charge plus de 1 000 LLM via une seule API compatible OpenAI, ajoute seulement 3 à 4 ms de surcoût et gère plus de 350 RPS sur un seul vCPU. Elle peut ainsi s'insérer dans le flux d'un agent exécuté en continu sans devenir un goulot d'étranglement. Elle s'exécute dans votre propre VPC, on-premise ou en environnement air-gapped.

C'est également la solution au problème des coûts d'une exécution en continu. Dans le benchmark d'Auto Routing de TrueFoundry portant sur 550 prompts, la classification des requêtes par complexité et leur routage entre différents niveaux de modèles ont réduit les coûts de 69 % tout en conservant 98 % de la qualité initiale, avec une latence moyenne passant de 7,6s à 4,0s. Sur un trafic de production réel, la réduction a atteint 80 %. Un agent qui s'exécute sans surveillance toute la journée n'a pas besoin d'un modèle de pointe pour chaque étape.
Séparer ces deux éléments vous permet de changer de modèle ou de harness sans avoir à tout réarchitecturer.
Hermes Agent prouve de manière très convaincante qu'un agent personnel, auto-hébergé et auto-améliorant constitue une catégorie à part entière et non une simple démonstration technique. La conception de la mémoire et des compétences est bien pensée, la documentation aborde en toute transparence ses propres modes de défaillance, et les chiffres d'adoption sont très concrets — 51,7 billions de tokens et le premier rang quotidien sur OpenRouter en septembre 2026 illustrent un usage réel et massif.
En revanche, il n'a pas été conçu pour gouverner une flotte d'agents. Chaque instance fonctionne de manière isolée : ses propres identifiants, ses propres paramètres d'approbation, ses propres dépenses, sa propre mémoire enregistrée sur son propre disque. C'est parfaitement adapté pour une personne sur une machine, mais inapproprié pour vingt ingénieurs sous le contrôle d'un auditeur.
La question n'est donc pas « Hermes ou une autre solution », mais ce que vous souhaitez gérer. Si vous voulez gérer votre agent personnel, Hermes est un excellent choix. Si vous devez gérer une flotte d'agents, vous avez besoin d'un harness complété par un plan de contrôle et d'une passerelle en amont des modèles — ce pour quoi TrueForge et l'AI Gateway de TrueFoundry ont été conçus.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Hermes Agent est l'agent d'IA autonome de Nous Research, open source et sous licence MIT, rendu public fin février 2026. Vous l'auto-hébergez sur un ordinateur portable, un VPS ou une infrastructure serverless, et vous interagissez avec lui depuis la CLI, une application de bureau ou plus de 20 plateformes de messagerie, dont Telegram, Discord et Slack. Sa caractéristique distinctive est une boucle d'apprentissage fermée : une mémoire persistante d'une session à l'autre, ainsi que des skills que l'agent écrit et affine lui-même.
Le logiciel est gratuit et sous licence MIT. Vous payez l'inférence des modèles et l'infrastructure sur laquelle vous l'exécutez. Nous Portal propose des offres payantes facultatives (20, 100 et 200 $ par mois en septembre 2026) qui regroupent des crédits de modèles et des outils hébergés, mais vous pouvez utiliser votre propre fournisseur à la place.
Par deux mécanismes. La mémoire : l'agent tient à jour MEMORY.md et USER.md dans la limite d'un budget de caractères ; ces fichiers sont injectés dans le prompt système au début de chaque session, avec une recherche en texte intégral sur les sessions passées pour tout ce qui est plus ancien. Les skills : lorsqu'il résout quelque chose, il peut écrire un fichier SKILL.md décrivant la procédure et les pièges, puis le charger à la demande par divulgation progressive, de sorte que les skills inutilisées ne consomment presque pas de contexte.
Oui. Hermes fonctionne avec Nous Portal, OpenRouter, OpenAI ou tout point de terminaison compatible ; le faire pointer vers une passerelle compatible OpenAI est donc un simple changement de configuration. Vous obtenez ainsi des budgets par équipe, le routage de modèles, des garde-fous et des traces unifiées sans modifier l'agent.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















