



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Mis à jour : November 3, 2026
Published: May 11, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Nous sommes ravis d'annoncer l'intégration de Resemble AI avec TrueFoundry AI Gateway, apportant le clonage vocal, la synthèse vocale synchrone (text-to-speech) et le TTS en streaming dans le même chemin de passerelle que les équipes utilisent déjà pour les LLM, les embeddings et le trafic d'agents.
Les équipes qui routent le trafic IA via l'AI Gateway de TrueFoundry peuvent désormais connecter Resemble AI en tant que fournisseur de synthèse vocale de premier ordre grâce au pass-through SDK natif de la passerelle. Les requêtes vers les endpoints /synthesize et /stream de Resemble passent par le chemin de la passerelle avec une authentification centralisée, un contrôle d'accès par équipe, un suivi unifié des coûts et un traçage complet des requêtes. Aucune modification du code client n'est requise, si ce n'est de faire pointer l'URL de base de Resemble vers la passerelle et de s'authentifier avec un jeton TrueFoundry.
Cet article présente l'architecture de l'intégration. Il explique comment l'AI Gateway de TrueFoundry expose les fournisseurs TTS, comment la surface d'API native de Resemble est préservée via la couche pass-through et comment le basculement (failover) entre plusieurs fournisseurs TTS fonctionne grâce aux Virtual Models.
TrueFoundry fournit la couche de contrôle pour les systèmes d'IA en production. Grâce à l'AI Gateway, les équipes centralisent le routage des modèles, la gestion des clés, le contrôle d'accès, l'observabilité et le suivi des coûts pour les LLM, les embeddings, ainsi que les fournisseurs d'images et d'audio. Chaque requête passe par une couche proxy unique où l'identité est vérifiée, les limites de débit sont appliquées et les traces sont capturées.
En production, le trafic TTS ressemble à celui des LLM sur trois aspects. Plusieurs fournisseurs sont généralement utilisés car aucun éditeur TTS ne s'impose sur tous les plans. La latence est critique car les agents vocaux diffusent l'audio en temps réel aux utilisateurs. Les coûts augmentent rapidement au caractère ou à la seconde, et bénéficient des mêmes contrôles de facturation interne et de budget que les équipes appliquent déjà aux completions de chat. Les arguments en faveur de la mise en place d'une passerelle devant les fournisseurs LLM s'appliquent donc directement.
Resemble AI est une plateforme complète de sécurité pour l'IA générative permettant de créer, vérifier et détecter les médias synthétiques (audio, vidéo et image). Resemble développe également ses propres modèles fondateurs pour la génération et la détection, ce qui lui donne un avantage majeur dans l'identification du contenu généré par IA. Pour la génération vocale, son modèle de synthèse principal est Chatterbox, Chatterbox Multilingual, avec une variante Chatterbox Turbo pour une latence plus faible et la prise en charge des balises paralinguistiques. Tous les modèles TTS développés par Resemble incluent du tatouage numérique (watermarking) par défaut. La plateforme prend également en charge le clonage vocal, le voice design, l'édition audio, le SSML, la synthèse HD et la sortie en streaming. Ensemble, les deux plateformes offrent aux équipes un espace unique pour gouverner et tracer la génération vocale aux côtés du reste de leur stack IA. TrueFoundry gère le déploiement, le routage et le contrôle opérationnel. Resemble gère la synthèse elle-même. L'intégration utilise le pass-through SDK natif de TrueFoundry, qui préserve l'intégralité de la surface d'API de Resemble sans la forcer à adopter un format compatible OpenAI.
L'endpoint de synthèse vocale synchrone de Resemble prend un ensemble restreint de champs et renvoie l'audio ainsi que des métadonnées d'horodatage. L'endpoint synthesize accepte un voice_uuid sélectionnant la voix entraînée ou préconçue à utiliser, et un champ data contenant du texte ou du SSML jusqu'à 3 000 caractères. Des champs optionnels contrôlent la sélection du modèle via model (par exemple chatterbox-turbo), la précision audio via precision (parmi MULAW, PCM_16, PCM_24 ou PCM_32), le format de sortie via output_format (wav ou mp3), le taux d'échantillonnage, le mode HD via use_hd, et la gestion personnalisée de la prononciation via apply_custom_pronunciations.
La charge utile de réponse renvoie un statut de succès et un champ audio_content encodé en base64 contenant les octets audio synthétisés. Les métadonnées d'horodatage arrivent dans audio_timestamps avec les caractères graphèmes, leurs horodatages, les caractères phonèmes et leurs horodatages pour les cas d'usage d'alignement en aval tels que la synchronisation labiale et le sous-titrage. La réponse indique également duration (la durée audio en secondes), synth_duration (le temps brut de synthèse), output_format, sample_rate et tous les problèmes signalés par le synthétiseur pendant la génération.
Un second endpoint situé sur /stream prend en charge la synthèse en streaming sur HTTP pour les cas d'usage d'agents vocaux où le délai avant le premier bloc audio est critique. La structure de la requête est identique. La réponse est un flux de trames audio plutôt qu'une charge utile base64 unique. L'authentification pour les deux endpoints s'effectue via un jeton Bearer émis depuis la console du compte Resemble.
L'AI Gateway de TrueFoundry fonctionne sur le framework Hono et un seul pod de passerelle traite plus de 250 requêtes par seconde sur 1 vCPU et 1 Go de RAM avec environ 3 ms de latence ajoutée. Les pods de passerelle sont sans état (stateless), dépendants du CPU et évoluent horizontalement jusqu'à des dizaines de milliers de RPS en ajoutant des pods. Le plan de contrôle et le plan de passerelle sont séparés. La configuration des fournisseurs, y compris les identifiants, les règles de routage et les limites de débit, réside dans le plan de contrôle et se synchronise avec les pods de passerelle via NATS. Le chemin de requête effectif reste en mémoire sans appels externes au-delà de l'appel au fournisseur lui-même.
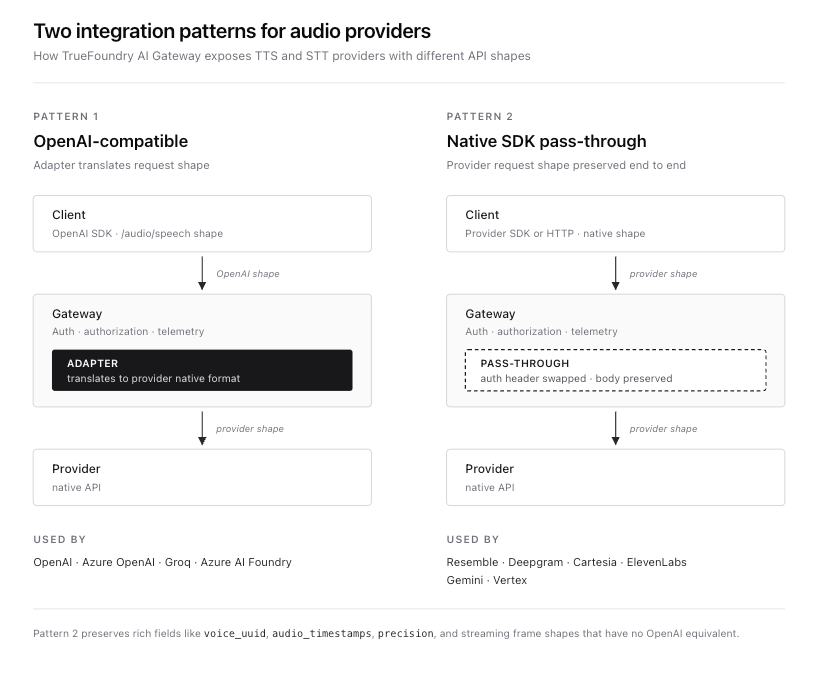
Pour le TTS, la passerelle propose deux modèles d'intégration.
Le premier est le modèle d'API compatible OpenAI à l'URL de base de la passerelle. Les fournisseurs qui utilisent la structure /audio/speech d'OpenAI (OpenAI, Azure OpenAI, Azure AI Foundry et Groq) s'y connectent. Les clients utilisent le SDK OpenAI standard et la passerelle traduit la requête dans le format natif du fournisseur via une couche d'adaptation.
Le second est le modèle de pass-through SDK natif sur {GATEWAY_BASE_URL}/tts/{providerAccountName}. Les fournisseurs disposant d'API natives riches qui ne se superposent pas proprement au format OpenAI s'intègrent ici. La structure complète de requête et de réponse du fournisseur est préservée. La passerelle gère l'authentification, le contrôle d'accès, le traçage et le routage, mais ne réécrit pas la charge utile. C'est le modèle utilisé par Resemble car le corps de requête Resemble avec voice_uuid, audio_timestamps, les niveaux de précision et le sélecteur de modèle chatterbox-turbo n'a pas d'équivalent dans le contrat TTS d'OpenAI.
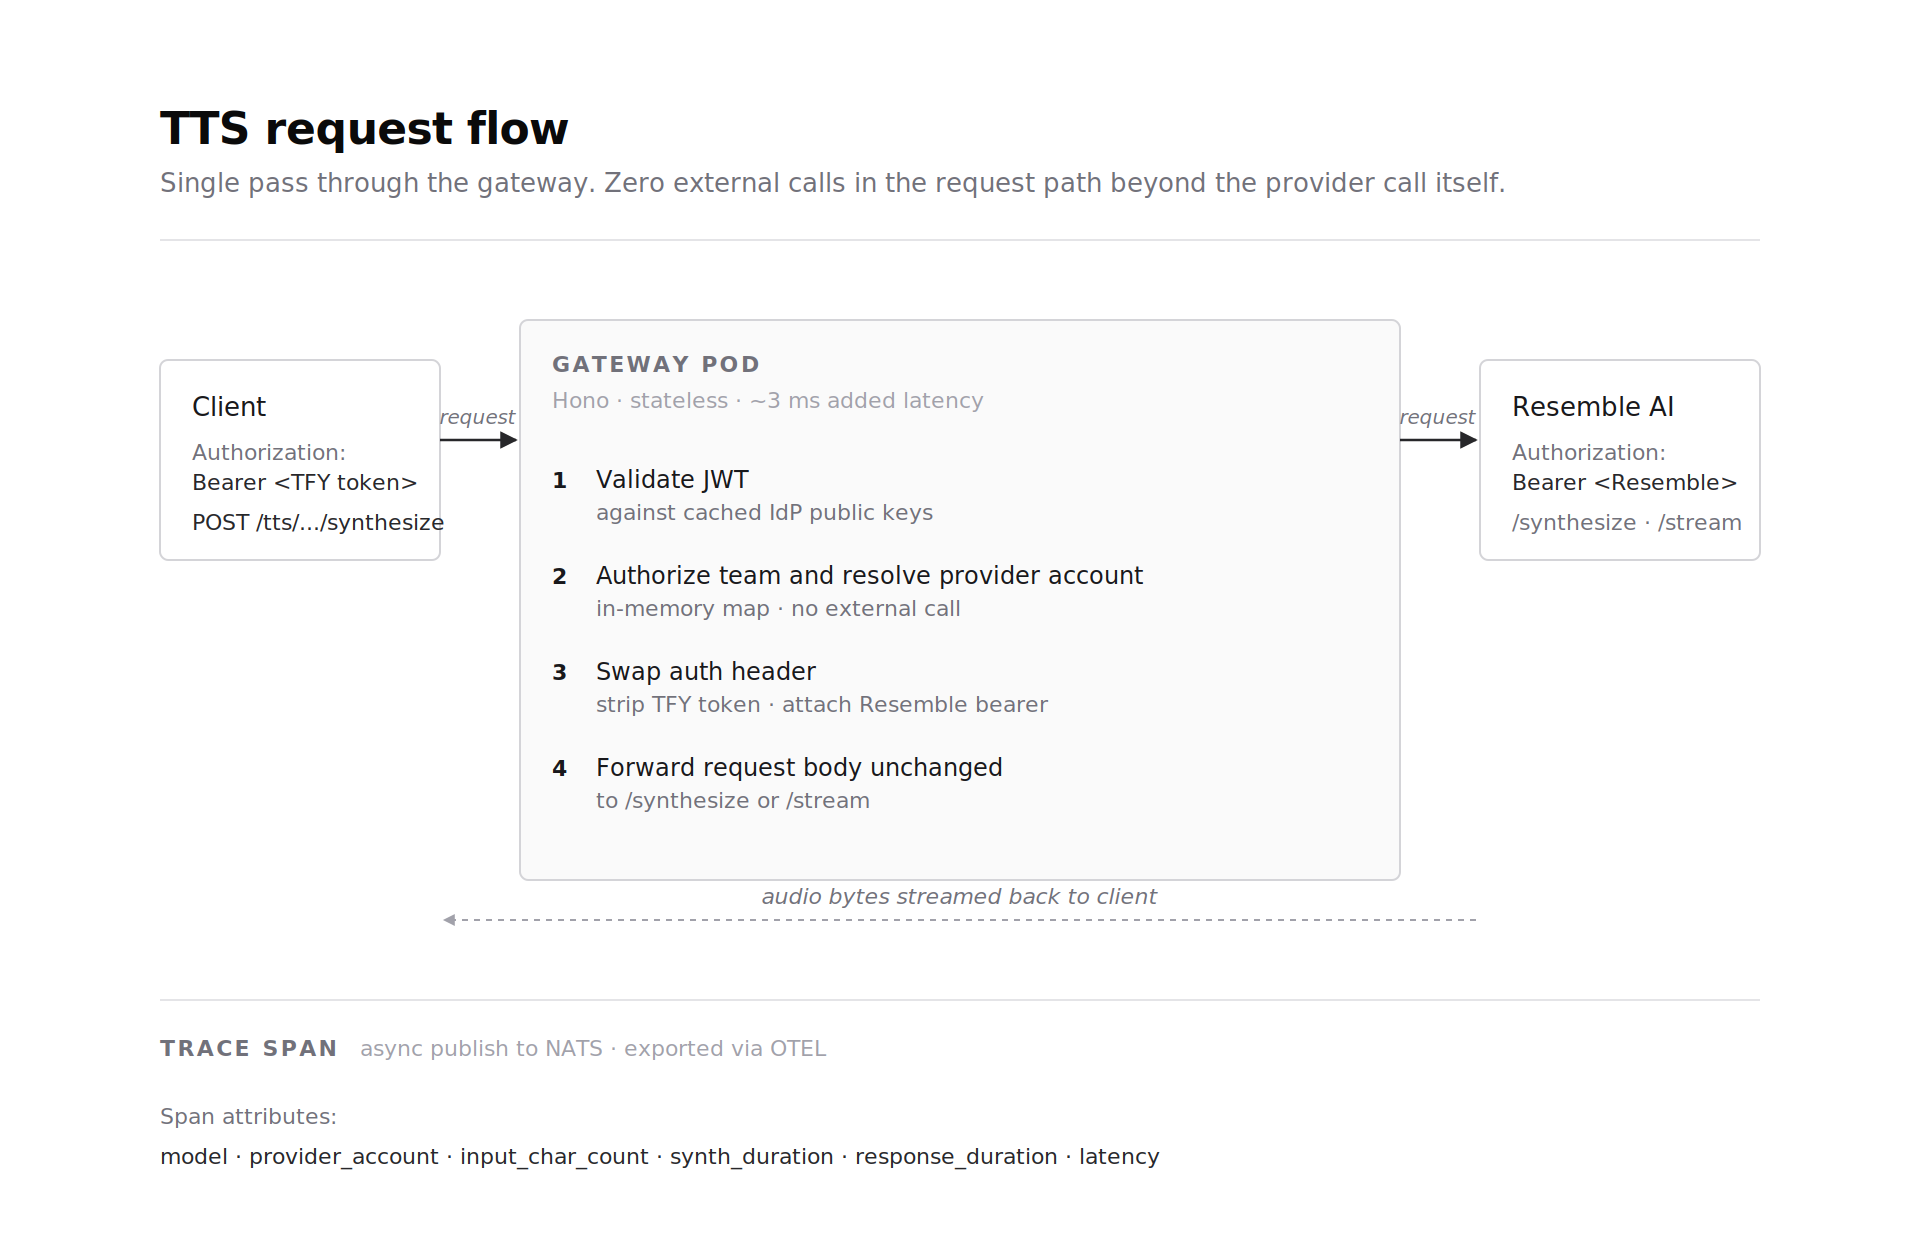
Lorsqu'une requête atteint un pod de passerelle, le cheminement est le suivant. Le jeton TrueFoundry dans l'en-tête Authorization est validé par rapport aux clés publiques IdP en cache. L'identité de l'équipe est résolue par rapport à une carte en mémoire et l'autorisation d'accès au compte du fournisseur Resemble est vérifiée. Le corps de la requête est transmis à l'endpoint synthesize ou stream de Resemble avec le jeton Bearer Resemble attaché côté serveur. La réponse est renvoyée en streaming au client. L'interaction complète est capturée dans un span de trace avec le nom du modèle, le compte fournisseur, le nombre de caractères en entrée, la durée de réponse, la durée de synthèse et la latence. Il n'y a pas d'aller-retour supplémentaire au-delà de l'appel au fournisseur effectif.
Resemble est enregistré dans le plan de contrôle TrueFoundry en tant que compte fournisseur, le jeton Bearer Resemble étant stocké comme un secret. Une fois le compte ajouté, la passerelle expose deux routes TTS pour celui-ci. La route SDK native sur {GATEWAY_BASE_URL}/tts/{providerAccountName}/synthesize sert de proxy vers l'endpoint synchrone. La route de streaming sur {GATEWAY_BASE_URL}/tts/{providerAccountName}/stream sert de proxy vers l'endpoint de streaming. Les deux routes préservent exactement la structure de requête et de réponse de Resemble.
Un appel client minimal ressemble à l'extrait ci-dessous. Notez que la seule modification par rapport à un appel direct à Resemble est l'URL de base et l'en-tête d'authentification.
Le code d'application existant qui cible directement Resemble migre en remplaçant simplement l'URL de base et le jeton Bearer. Les UUID de voix, les charges utiles SSML, les paramètres de précision et le mode HD sont tous conservés sans modification. Les bibliothèques clientes officielles de Resemble peuvent être configurées de la même manière en surchargeant leur URL de base.
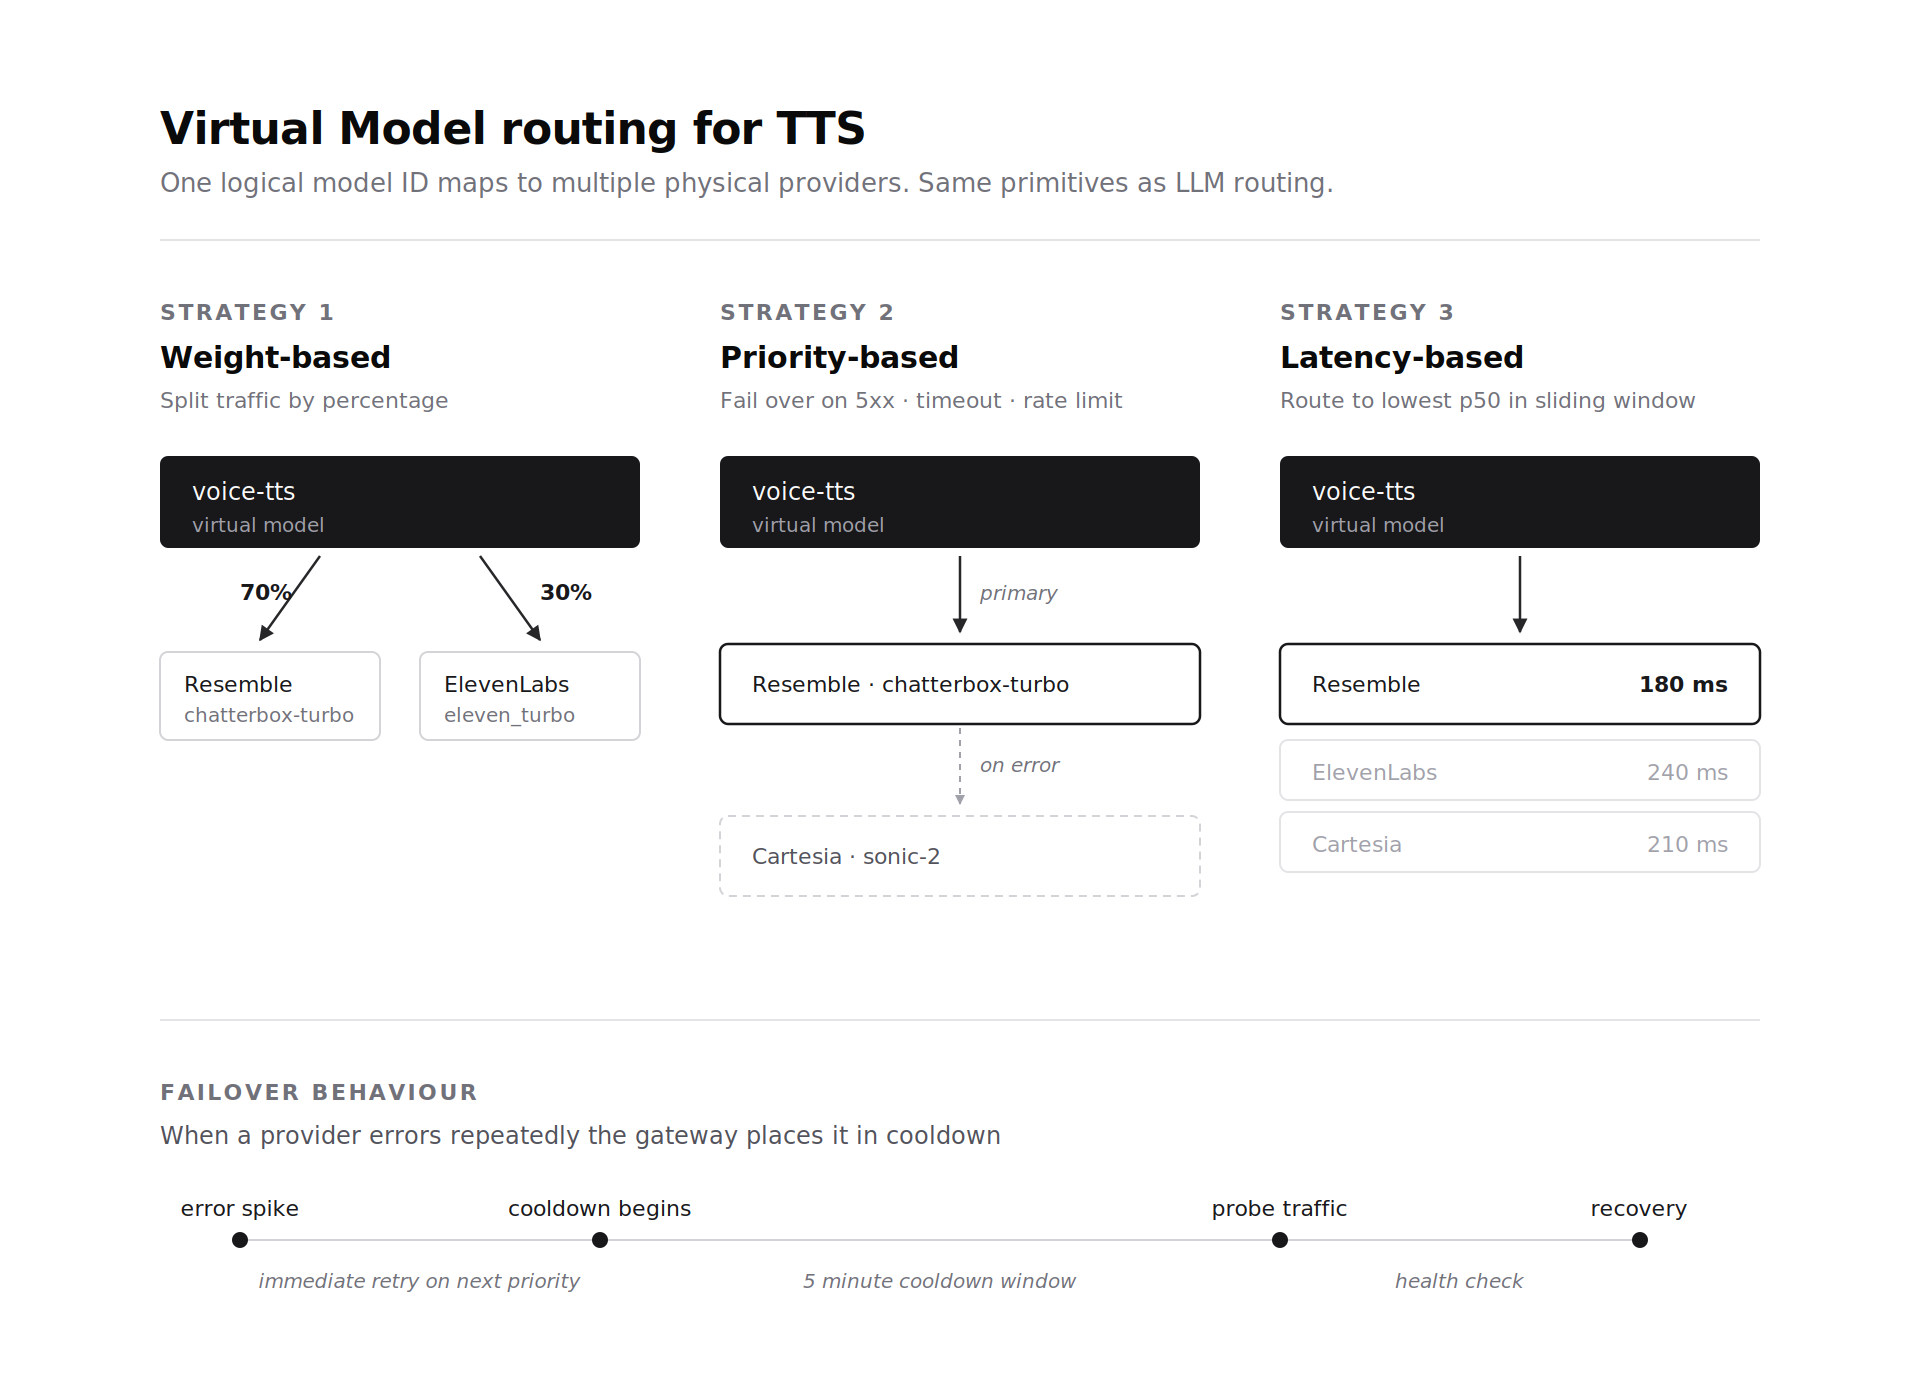
Les architectures d'agents vocaux exécutent souvent plusieurs fournisseurs TTS en production pour des raisons de coût et de latence. L'abstraction Virtual Model de la passerelle s'étend aux fournisseurs TTS de la même façon qu'aux fournisseurs LLM. Un identifiant de modèle virtuel s'associe à un ou plusieurs déploiements TTS physiques avec des règles de routage. Le routage basé sur le poids distribue le trafic en pourcentage entre les fournisseurs. Le routage basé sur la priorité tente le premier fournisseur et bascule en cas d'erreur 5xx, de délai d'attente (timeout) ou de limite de débit. Le routage basé sur la latence envoie le trafic au fournisseur ayant la latence p50 la plus faible dans la fenêtre glissante.
Le basculement (failover) pour le TTS repose sur les mêmes primitives que le basculement LLM. Les erreurs non réessayables déclenchent une tentative immédiate sur le fournisseur de priorité suivante. Les pics d'erreurs placent un fournisseur dans une période de refroidissement de 5 minutes, et un trafic de sondage vérifie le rétablissement. Une équipe exécutant Resemble Chatterbox Turbo comme chemin principal à faible latence peut basculer vers Cartesia ou ElevenLabs sans modifier le code client. Le Virtual Model gère la sélection.
Le suivi des coûts capture l'utilisation du TTS avec la même granularité que celle des LLM. La passerelle enregistre le nombre de caractères en entrée, la durée de synthèse, le modèle, l'équipe et l'utilisateur pour chaque requête. Le service d'agrégation calcule les dépenses par équipe et par utilisateur et alimente les mêmes tableaux de bord et primitives de contrôle budgétaire qui couvrent déjà les completions de chat et les embeddings. Les limites de débit s'appliquent via l'algorithme Sliding Window Token Bucket avec des fenêtres par minute définies par utilisateur, équipe ou modèle. Pour le TTS, l'unité est le caractère ou la requête plutôt que le token, mais l'algorithme reste inchangé.
Chaque requête TTS émet un span de trace. Les attributs du span incluent le compte fournisseur, l'identifiant du modèle (par exemple resemble-prod/chatterbox-turbo), le nombre de caractères en entrée, la durée de réponse en secondes, le temps de synthèse brut, le format de sortie, le taux d'échantillonnage et la latence côté passerelle. Les traces sont émises de manière asynchrone via NATS et exportées via OTEL vers l'outil d'observabilité configuré par l'équipe (Arize, Langfuse, LangSmith ou toute autre cible prise en charge). L'option Exclude Request Data s'applique de la même manière que pour les completions de chat afin d'exclure le texte d'entrée des traces exportées lorsque la confidentialité des données l'exige.
Cela signifie que les appels TTS apparaissent dans la même chronologie de trace que l'appel LLM en amont qui a généré le texte et l'action d'agent en aval qui a consommé l'audio. Pour le débogage d'agents vocaux, cette consolidation est essentielle. Un tour de conversation échoué peut être tracé depuis la completion du LLM qui a sélectionné la réponse, en passant par la synthèse TTS qui l'a rendue, jusqu'à l'action suivante effectuée par l'agent.
De bout en bout, le flux de requête se déroule comme suit. Un client envoie une requête TTS à la passerelle sur {GATEWAY_BASE_URL}/tts/{providerAccountName}/synthesize ou son équivalent en streaming avec un jeton Bearer TrueFoundry. La passerelle authentifie l'appelant à l'aide des clés IdP en cache, résout le compte fournisseur et vérifie l'autorisation de l'équipe et de l'utilisateur en mémoire. Si un Virtual Model est utilisé, la logique de routage sélectionne un fournisseur physique en fonction du poids, de la priorité ou de la latence. Le corps de la requête est transmis à Resemble avec le jeton Bearer Resemble côté serveur. La réponse est renvoyée en streaming au client en préservant la structure complète de la charge utile Resemble, y compris le contenu audio, les horodatages et les métadonnées de durée. Chaque étape est capturée dans un span de trace émis de manière asynchrone vers NATS et exporté via OTEL.
Rien d'autre ne doit changer dans l'application. Aucune réécriture de SDK n'est nécessaire, aucun traitement d'authentification par fournisseur n'est requis sur le client, et aucun pipeline d'observabilité séparé n'est à prévoir pour le trafic vocal. La passerelle se trouve déjà sur le chemin des requêtes pour le reste de la stack IA, et Resemble s'y rattache via le pass-through natif. Le code client Resemble existant continue de fonctionner en modifiant simplement l'URL de base.
Le principe architectural qui rend cela possible est le double modèle d'intégration. Les fournisseurs qui respectent le contrat OpenAI s'intègrent via l'adaptateur compatible OpenAI et réutilisent les mêmes SDK clients. Les fournisseurs disposant d'API natives riches s'intègrent via la route pass-through, qui préserve l'intégralité de la surface du fournisseur sans forcer la traduction. Pour le TTS, cela est fondamental car les différences entre fournisseurs ne sont pas cosmétiques. Les UUID de voix, les formats d'horodatage audio, les niveaux de précision et les structures de trames de streaming varient d'une manière qu'un adaptateur de style OpenAI devrait aplanir. Le modèle pass-through conserve intacts la sélection du modèle Chatterbox de Resemble, les horodatages audio et les contrôles de précision, tandis que la passerelle gère les aspects transversaux d'authentification, de routage, d'observabilité et de suivi des coûts.
En savoir plus sur l'AI Gateway de TrueFoundry et la plateforme Resemble AI. Ajoutez Resemble en tant que compte fournisseur dans le plan de contrôle de la passerelle et appelez l'endpoint synthesize ou stream sur la route /tts/{providerAccountName} depuis le code d'application existant.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















