



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Un serveur MCP est un processus. C'est tout ce dont il s'agit. Le Model Context Protocol définit la manière dont un client découvre et appelle des outils sur ce processus, mais ne dit rien sur l'endroit où il réside ni sur qui le maintient en vie. Cela laisse une question d'infrastructure pure, et elle se divise selon le mode de transport.
Les serveurs Stdio communiquent en MCP via l'entrée standard et la sortie standard. Ce sont des programmes de type CLI, généralement démarrés par le client lui-même avec npx ou uvx. Pas de port, pas d'URL, pas d'écouteur réseau — le client lance un processus enfant sur la même machine et communique avec lui via des pipes.
Les serveurs HTTP/SSE exposent directement des points d'accès HTTP. Ils écoutent sur un port et se comportent comme n'importe quel autre service web que vous savez déjà exploiter.
La documentation de TrueFoundry trace la même ligne avec une conséquence : les serveurs HTTP se déploient sans wrappers supplémentaires, tandis que les serveurs stdio doivent être enveloppés avec mcp-proxy pour convertir stdio en HTTP. La documentation est également très claire sur ce qu'il convient d'écrire si vous partez de zéro — les serveurs basés sur HTTP sont recommandés car ils sont plus sécurisés et plus faciles à déployer.
C'est par là que presque tout le monde commence, et c'est très bien pour une seule personne. Vous collez un bloc dans votre configuration Cursor ou Claude, le client lance npx -y @some/mcp-server à la demande, et la clé d'API se trouve dans une carte d'environnement en dessous.
Cela fonctionne bien. Mais cela ne résiste pas au travail en équipe. Il n'y a pas d'URL à partager. Les identifiants sont distribués par copier-coller. Chaque développeur exécute sa propre copie, ce qui signifie que chaque installation est distincte et peut dériver vers une version différente. Et rien ne répertorie de manière centralisée quel outil a été appelé par qui, car l'appel n'a jamais franchi une frontière réseau que vous contrôlez. Le mode stdio local est un mode de développement, pas une stratégie d'hébergement.
Certains serveurs MCP sont proposés sous forme de points d'accès hébergés par leurs mainteneurs, et certains fournisseurs de passerelles exécutent des serveurs pour votre compte dans leur propre cloud. Vous obtenez une URL et vous vous affranchissez de la gestion de l'infrastructure.
C'est la voie la plus rapide, et c'est généralement la bonne pour les serveurs publics, en lecture seule ou peu sensibles. Le compromis réside dans l'endroit où le processus s'exécute. Un serveur hébergé qui interroge vos systèmes internes implique soit d'ouvrir ces systèmes aux plages de sortie d'un fournisseur, soit d'envoyer des identifiants vers une infrastructure que vous ne contrôlez pas. Pour tout ce qui lit une base de données de production, c'est souvent la fin de la discussion.
Vous exécutez le processus sur votre propre cluster Kubernetes, dans votre propre VPC, derrière votre propre politique réseau. C'est la solution vers laquelle les équipes se tournent dès que le serveur touche à des éléments internes.
L'auto-hébergement n'est pas difficile de la manière dont les gens l'imaginent. Un serveur MCP est un petit service HTTP sans état, et chaque équipe plateforme sait déjà comment les faire tourner. Le véritable travail réside dans la couche périphérique : une URL stable, la décision de savoir qui peut l'appeler, l'injection des identifiants sans les intégrer dans une image, et le journal de ce qui s'est passé.
Déplacer un serveur hors d'un ordinateur portable n'est pas une simple migration sans changement (lift-and-shift). Quatre éléments apparaissent, dont l'ordinateur portable n'a jamais eu besoin, au-delà de l'évidente URL stable.
L'adresse de liaison (Bind address). Un serveur stdio ne lie jamais rien. Un serveur HTTP doit se lier à 0.0.0.0, et non à localhost, sinon il démarre proprement à l'intérieur de son conteneur mais reste inaccessible depuis le reste du cluster. La documentation contient un avertissement à ce sujet, ce qui prouve à quel point le problème est fréquent.
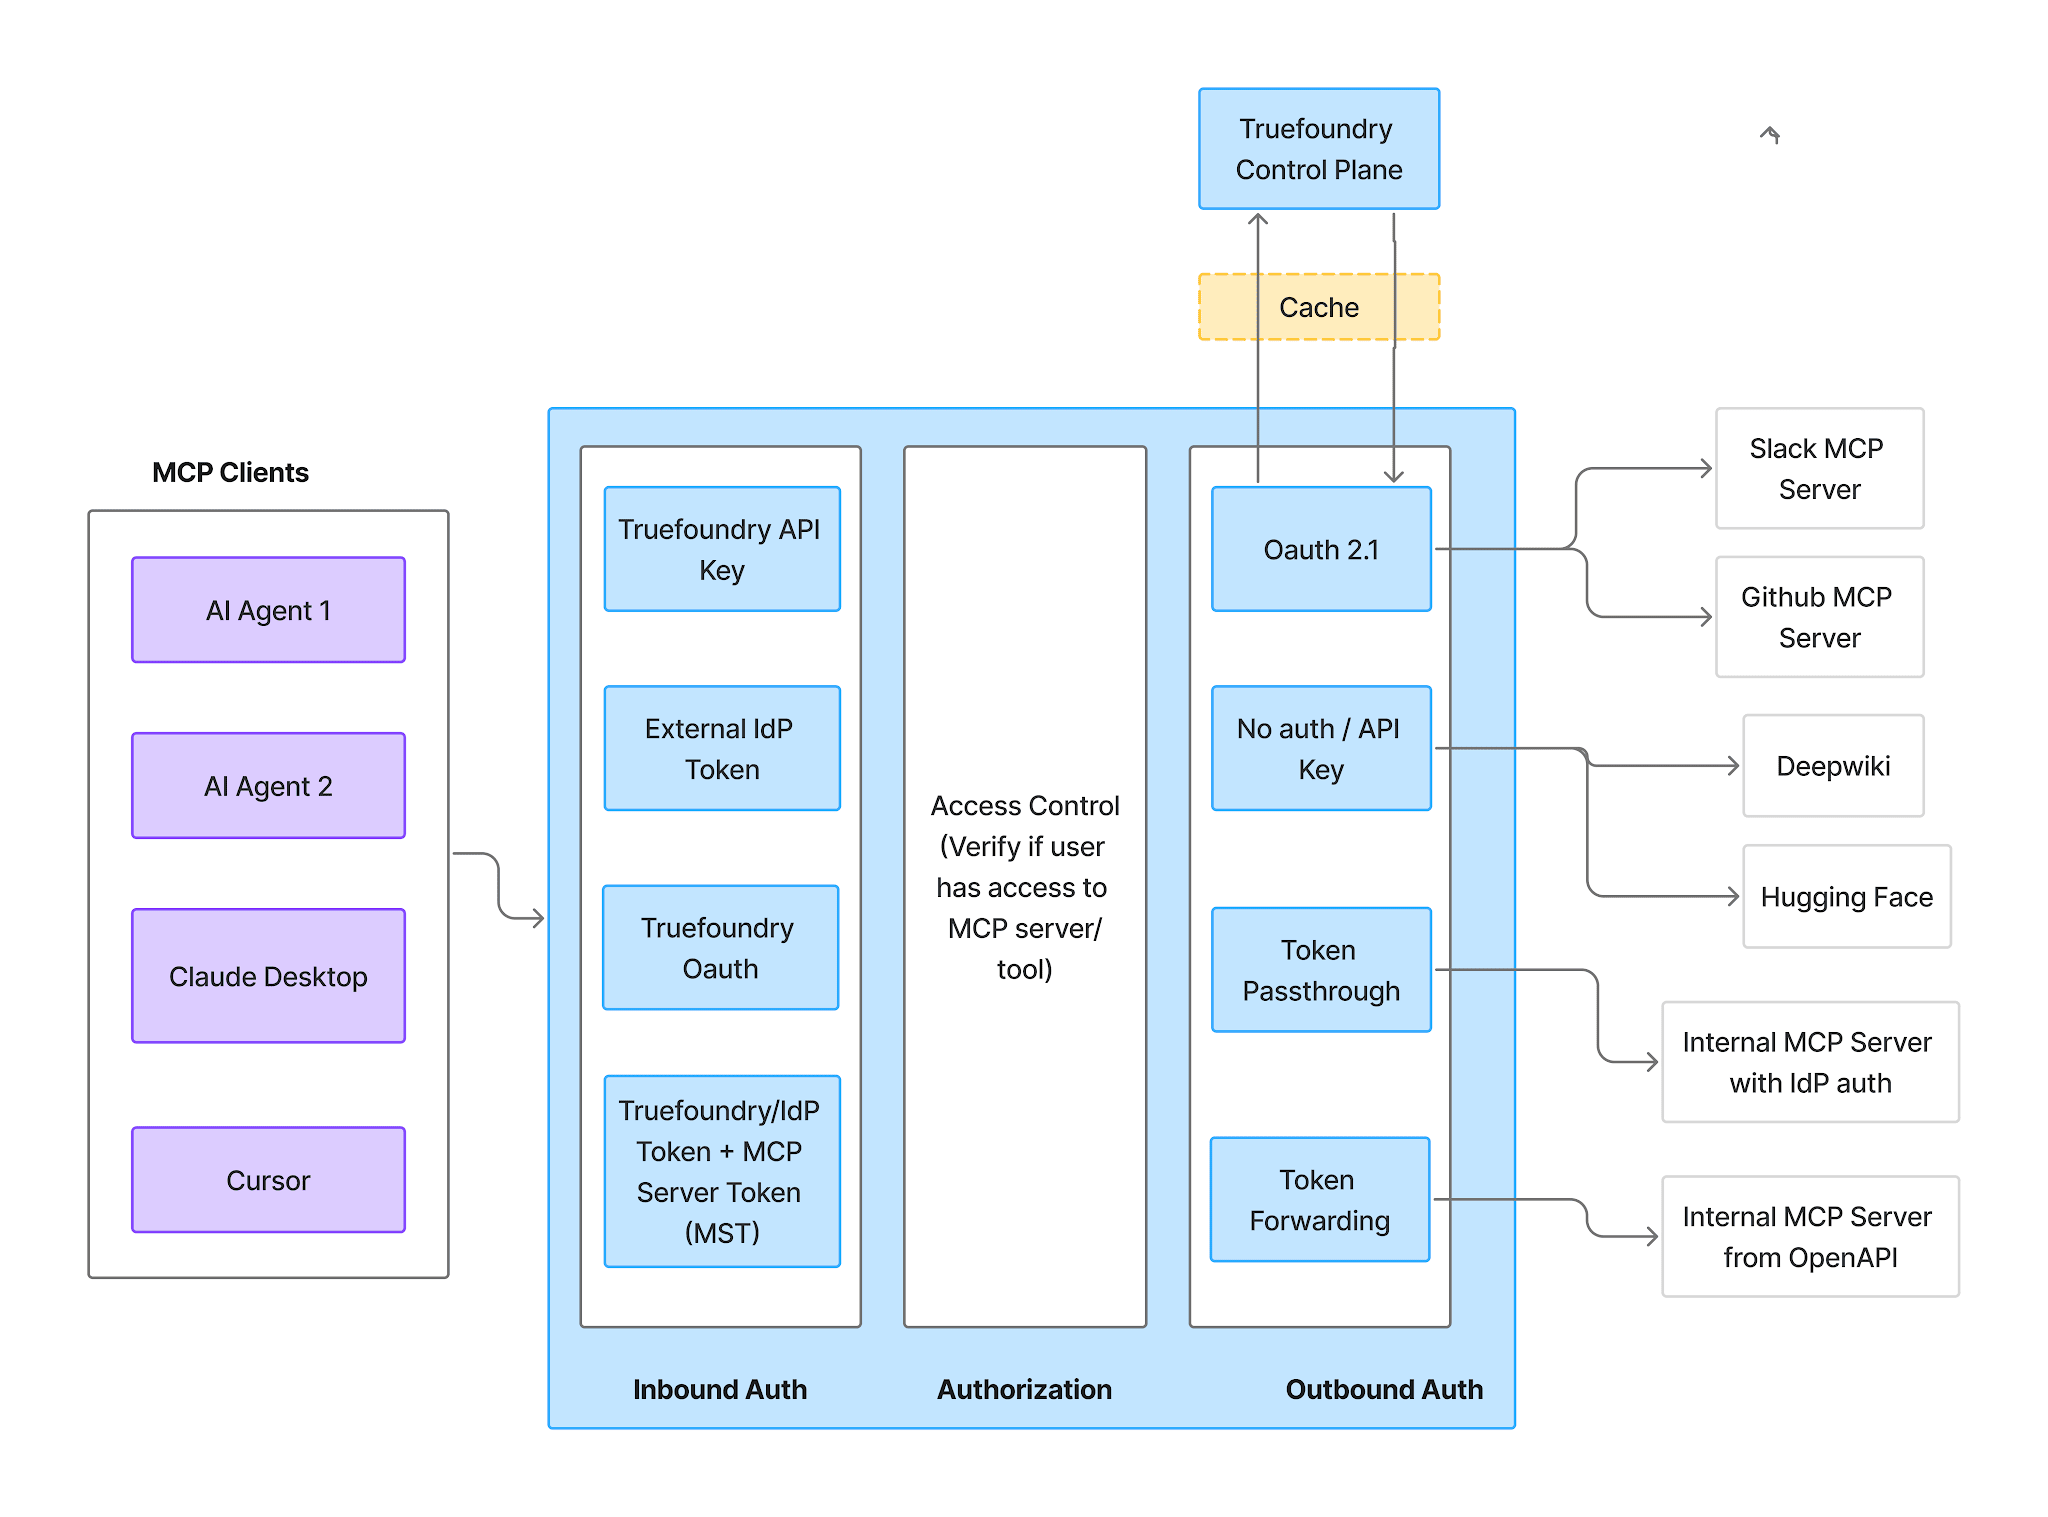
L'authentification dans les deux sens. Localement, il n'y avait qu'un seul identifiant — votre clé, dans votre configuration. À distance : comment un appelant prouve-t-il son identité au serveur, et comment le serveur prouve-t-il son identité à ce qu'il appelle en aval ? Problèmes distincts, réponses distinctes.
Concurrence et ressources. Un processus servait un seul client. Il sert désormais toute une équipe, et vous devez définir des demandes de CPU et de mémoire, des limites et des nombres de répliques comme pour n'importe quel autre service.
Sortie réseau (Egress). Le serveur passe désormais des appels sortants depuis l'intérieur de votre réseau plutôt que depuis un ordinateur portable connecté au Wi-Fi du bureau. C'est généralement le but recherché, mais cela fait de la position réseau du serveur une décision de sécurité plutôt qu'un hasard.
Chaque développeur exécute toujours sa propre copie. L'échec le plus courant n'est pas technique. La configuration locale n'est jamais retirée, de sorte que la moitié de l'équipe utilise l'URL de la passerelle tandis que l'autre moitié lance encore npx en local avec un jeton personnel. Ce n'est pas de la centralisation ; c'est une deuxième voie qui s'ajoute.
Des jetons dans les arguments au lieu des variables d'environnement. Lors du passage d'une commande stdio à un manifeste, il est tentant d'intégrer le jeton là où il se trouvait dans l'appel CLI. La documentation est explicite : ne mettez jamais de jetons dans les arguments, car les arguments sont stockés en texte brut dans le manifeste et peuvent apparaître dans les listes de processus. Les identifiants doivent figurer dans des variables d'environnement adossées à un coffre-fort de secrets.
Des paquets non verrouillés en version. npx -y some-package résout la version la plus récente au démarrage du conteneur, de sorte que deux répliques démarrées à une semaine d'intervalle peuvent exécuter des ensembles d'outils différents. Fixez des versions explicites dans les arguments.
Considérer l'URL comme la ligne d'arrivée. Un serveur déployé sans contrôle d'accès est un point d'accès à des outils que n'importe qui à l'intérieur du réseau peut appeler. L'hébergement a résolu l'accessibilité, mais pas l'autorisation d'accès — qui est la partie la plus difficile.
La position de TrueFoundry est que l'hébergement et la gouvernance doivent former un seul système plutôt que deux. Le serveur se déploie comme un service ordinaire sur votre propre cluster Kubernetes — avec les mêmes espaces de travail, secrets, mise à l'échelle automatique et journaux que toute autre charge de travail — puis s'enregistre derrière l'MCP Gateway, qui détient l'URL, l'authentification et le modèle d'accès. Trois voies d'accès sont possibles, selon votre point de départ.
Utilisez cette méthode lorsque vous avez écrit le serveur vous-même ou que vous le déployez à partir d'un dépôt que vous pouvez compiler.
Il s'agit d'un déploiement de service standard : Deployments → New Deployment → Service, choisissez votre espace de travail, puis sélectionnez Git Repo ou Code From Laptop comme source. Pour un serveur HTTP Python construit avec FastMCP et sans Dockerfile, la configuration comprend un chemin de contexte de build, un chemin requirements.txt, une version de Python, la commande (python server.py) et le port 8000.
Si votre source est un serveur stdio, enveloppez-le. La voie recommandée est un Dockerfile qui installe mcp-proxy et définit une commande CMD comme mcp-proxy --port 8000 --host 0.0.0.0 --server stream python server.py. Pour vous passer du Dockerfile, utilisez l'option Python Build, déclarez mcp-proxy comme dépendance, et définissez la même commande directement :
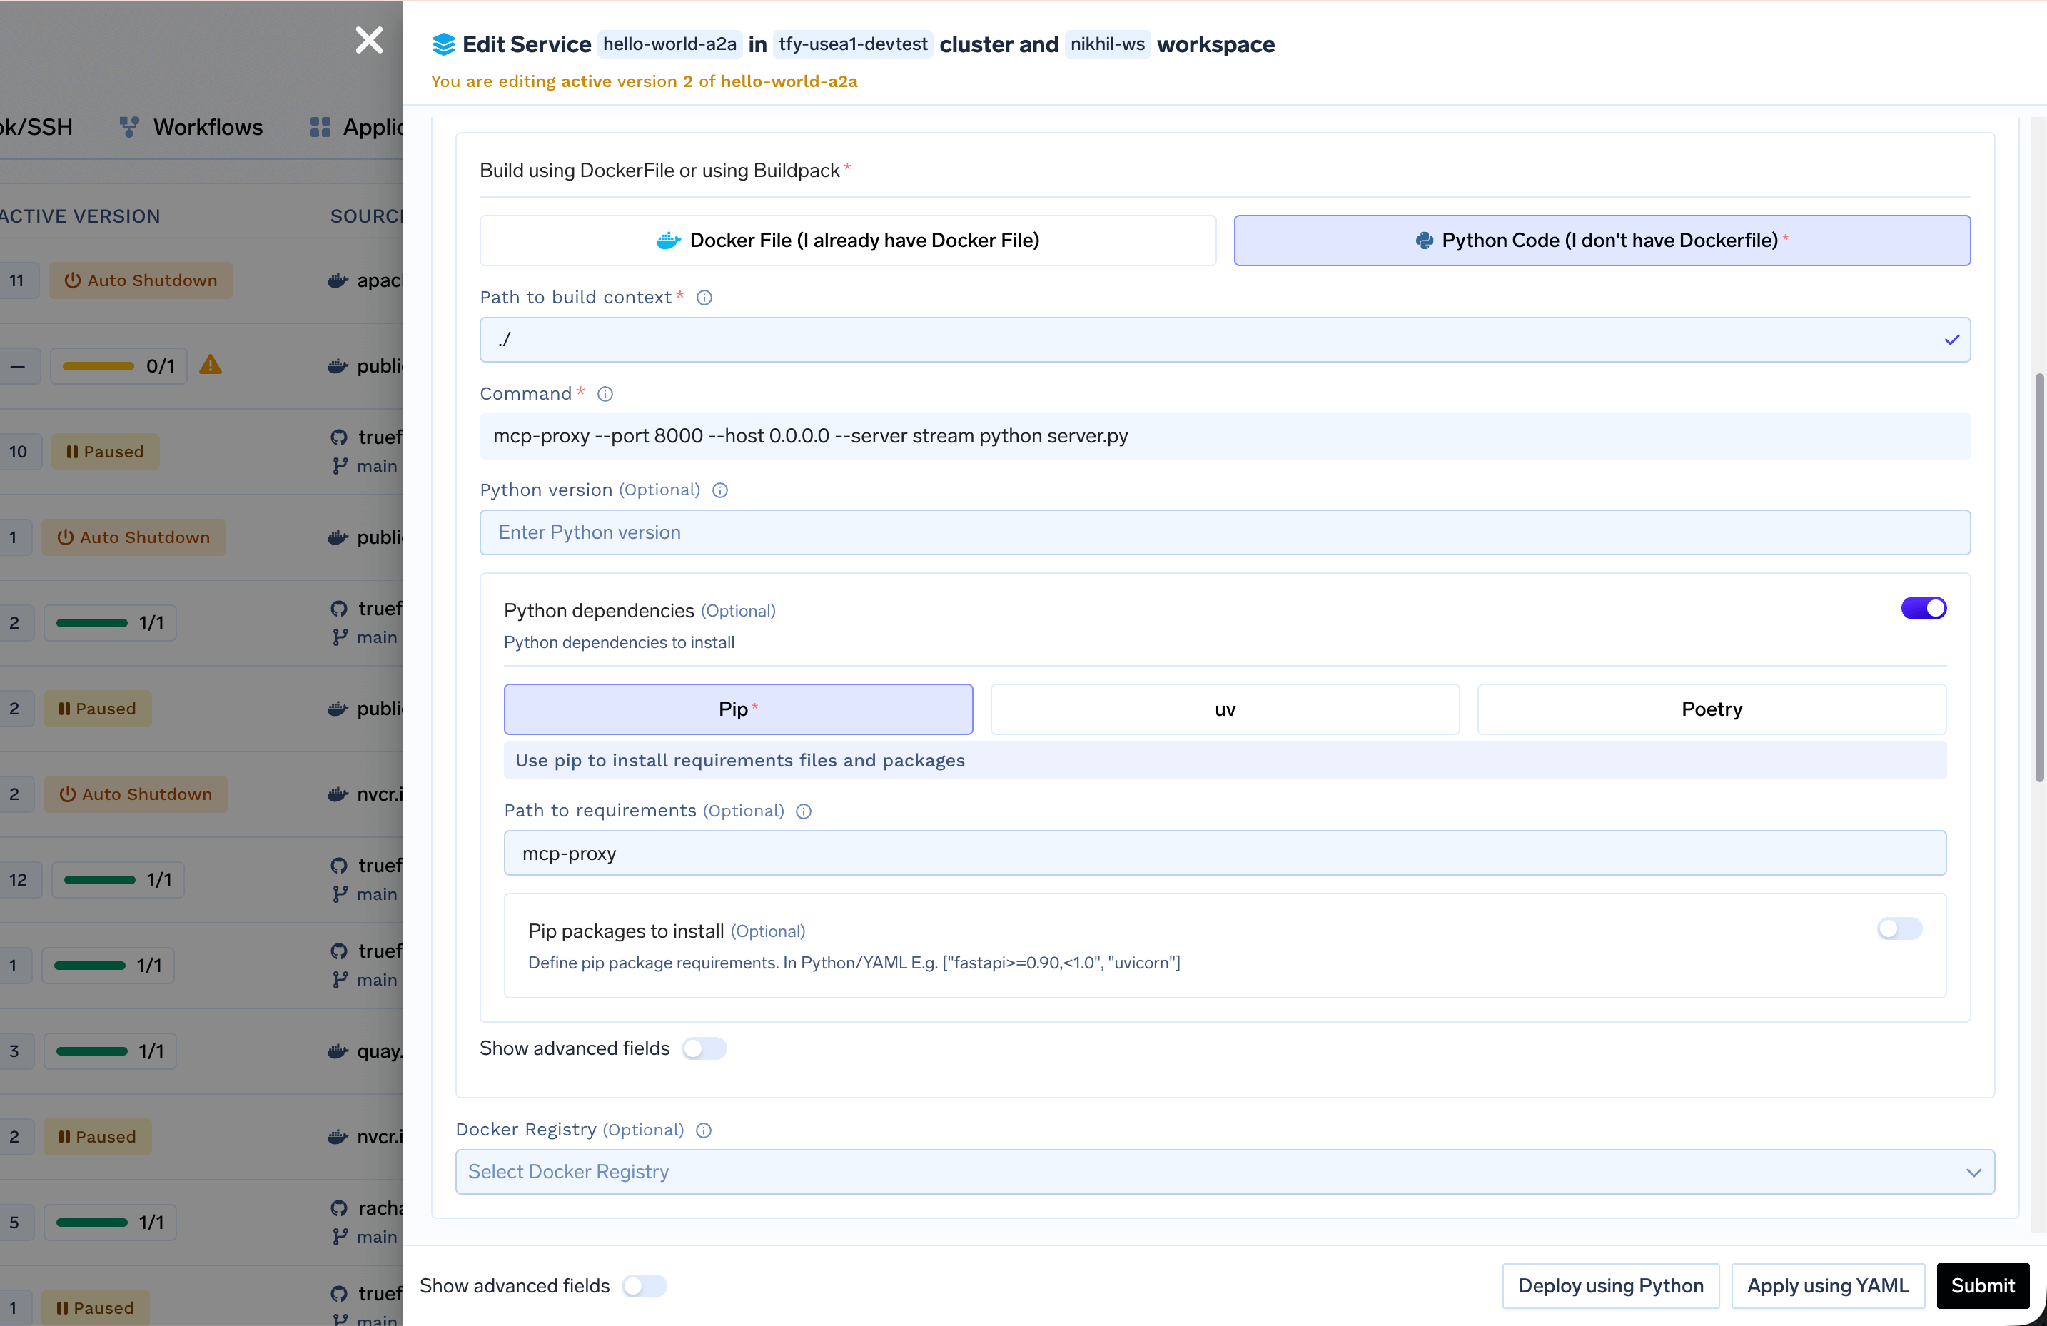
La configuration du port est la même dans les deux cas : port 8000, protocole TCP, protocole d'application http, exposition définie sur false si le service ne doit être accessible qu'à l'intérieur du cluster. Les valeurs sensibles vont dans TrueFoundry Secrets, référencées sous la forme tfy-secret://your-workspace:your-secret-group:API_KEY.
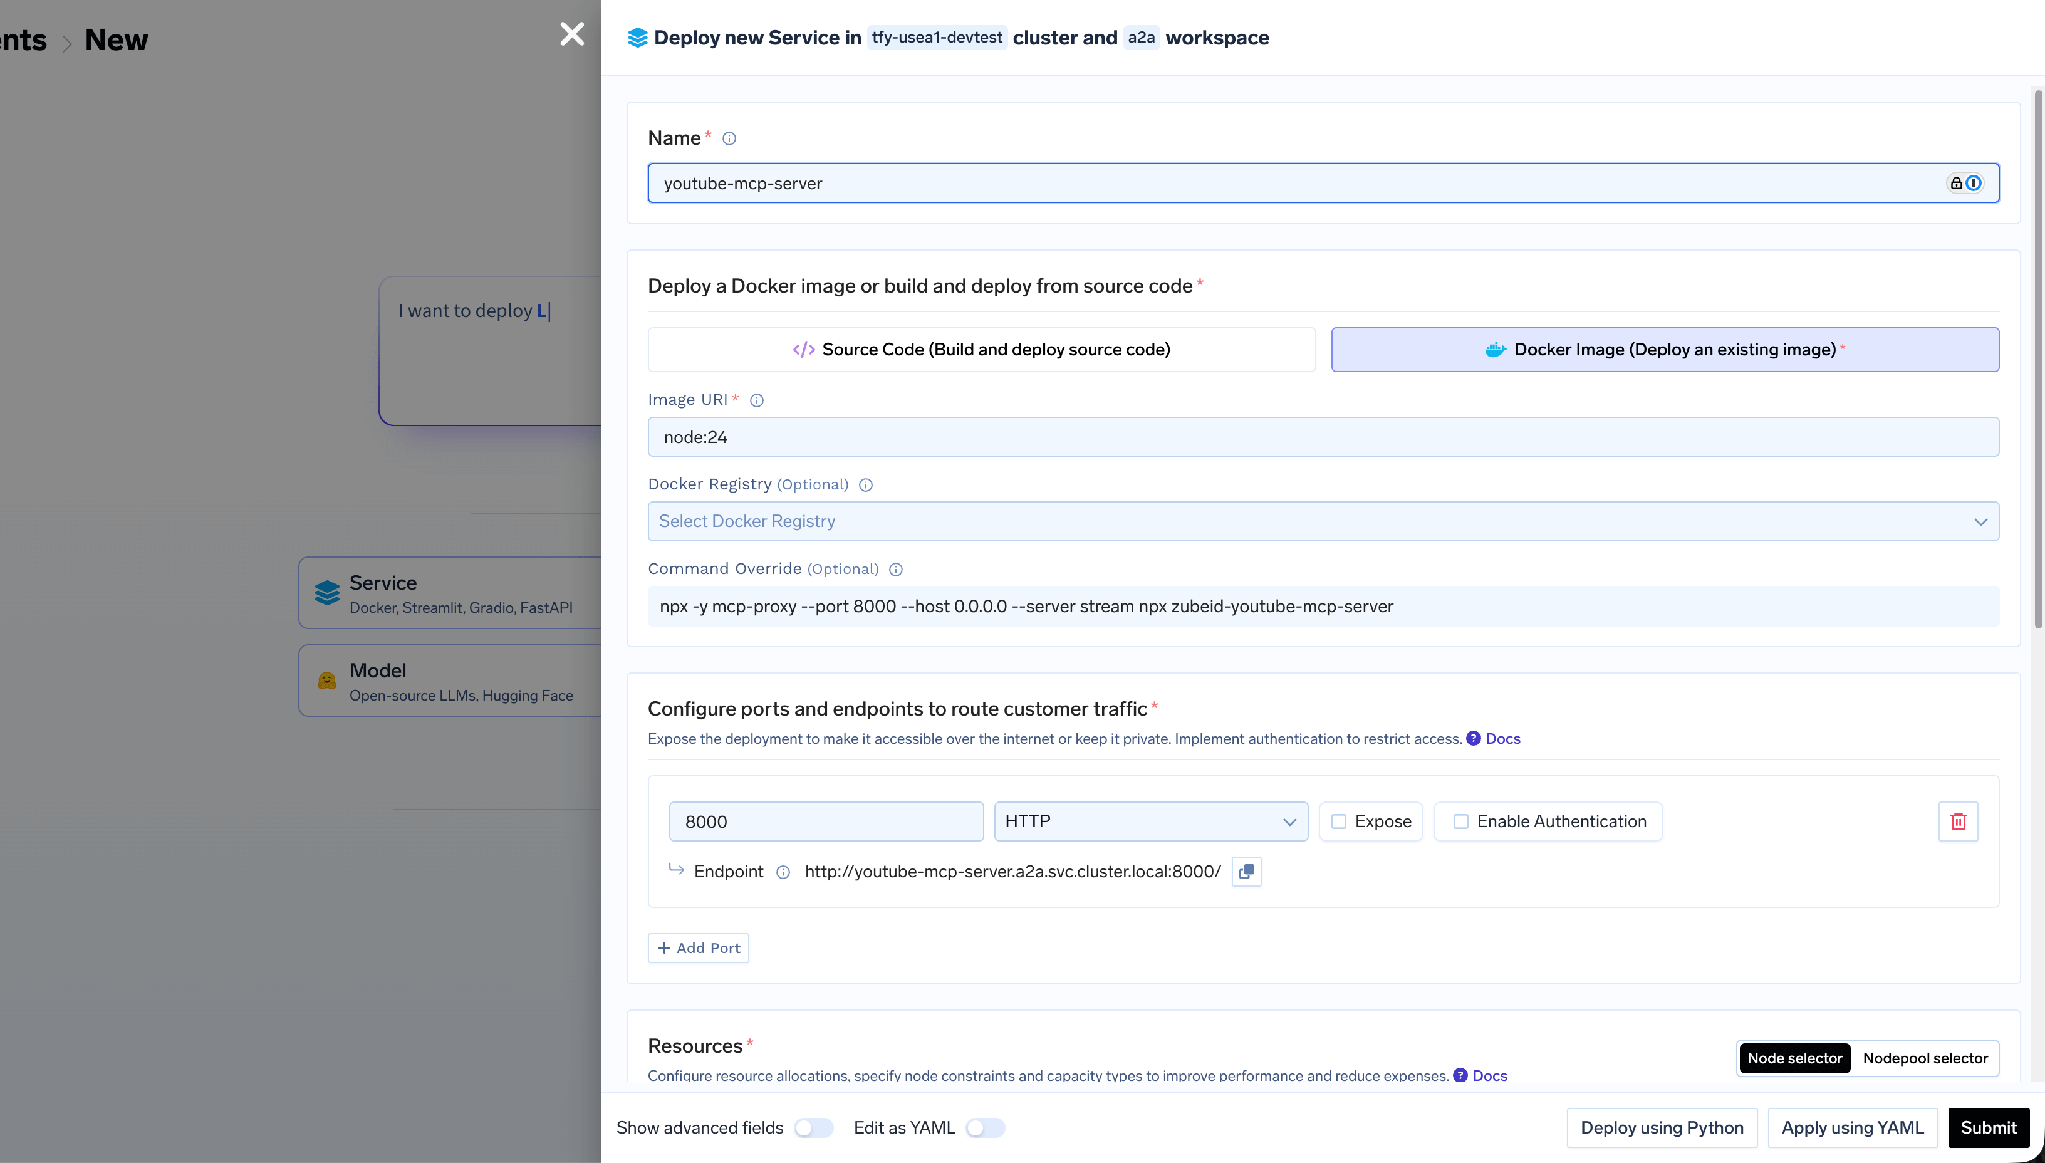
Utilisez cette méthode lorsque le serveur existe sous forme de paquet publié et que vous n'avez aucune raison de le modifier — la traduction directe du bloc qui se trouve aujourd'hui dans votre configuration Cursor. Les deux variantes se déploient à partir d'une image Docker, la commande effectuant le travail.
Pour les paquets npm, l'image de base est node:24 et la commande est :
npx -y mcp-proxy --port 8000 --host 0.0.0.0 --server stream npx -y <package-name>
Le premier npx -y mcp-proxy installe et exécute le proxy ; le second exécute votre paquet de serveur. Ainsi, un serveur Notion devient npx -y mcp-proxy --port 8000 --host 0.0.0.0 --server stream npx -y @notionhq/notion-mcp-server.
Pour les paquets Python, l'image de base est public.ecr.aws/docker/library/python:3.11-slim et la commande installe d'abord l'outillage :
sh -c "pip install uv mcp-proxy && mcp-proxy --host=0.0.0.0 --port=8000 uvx <package-name>"
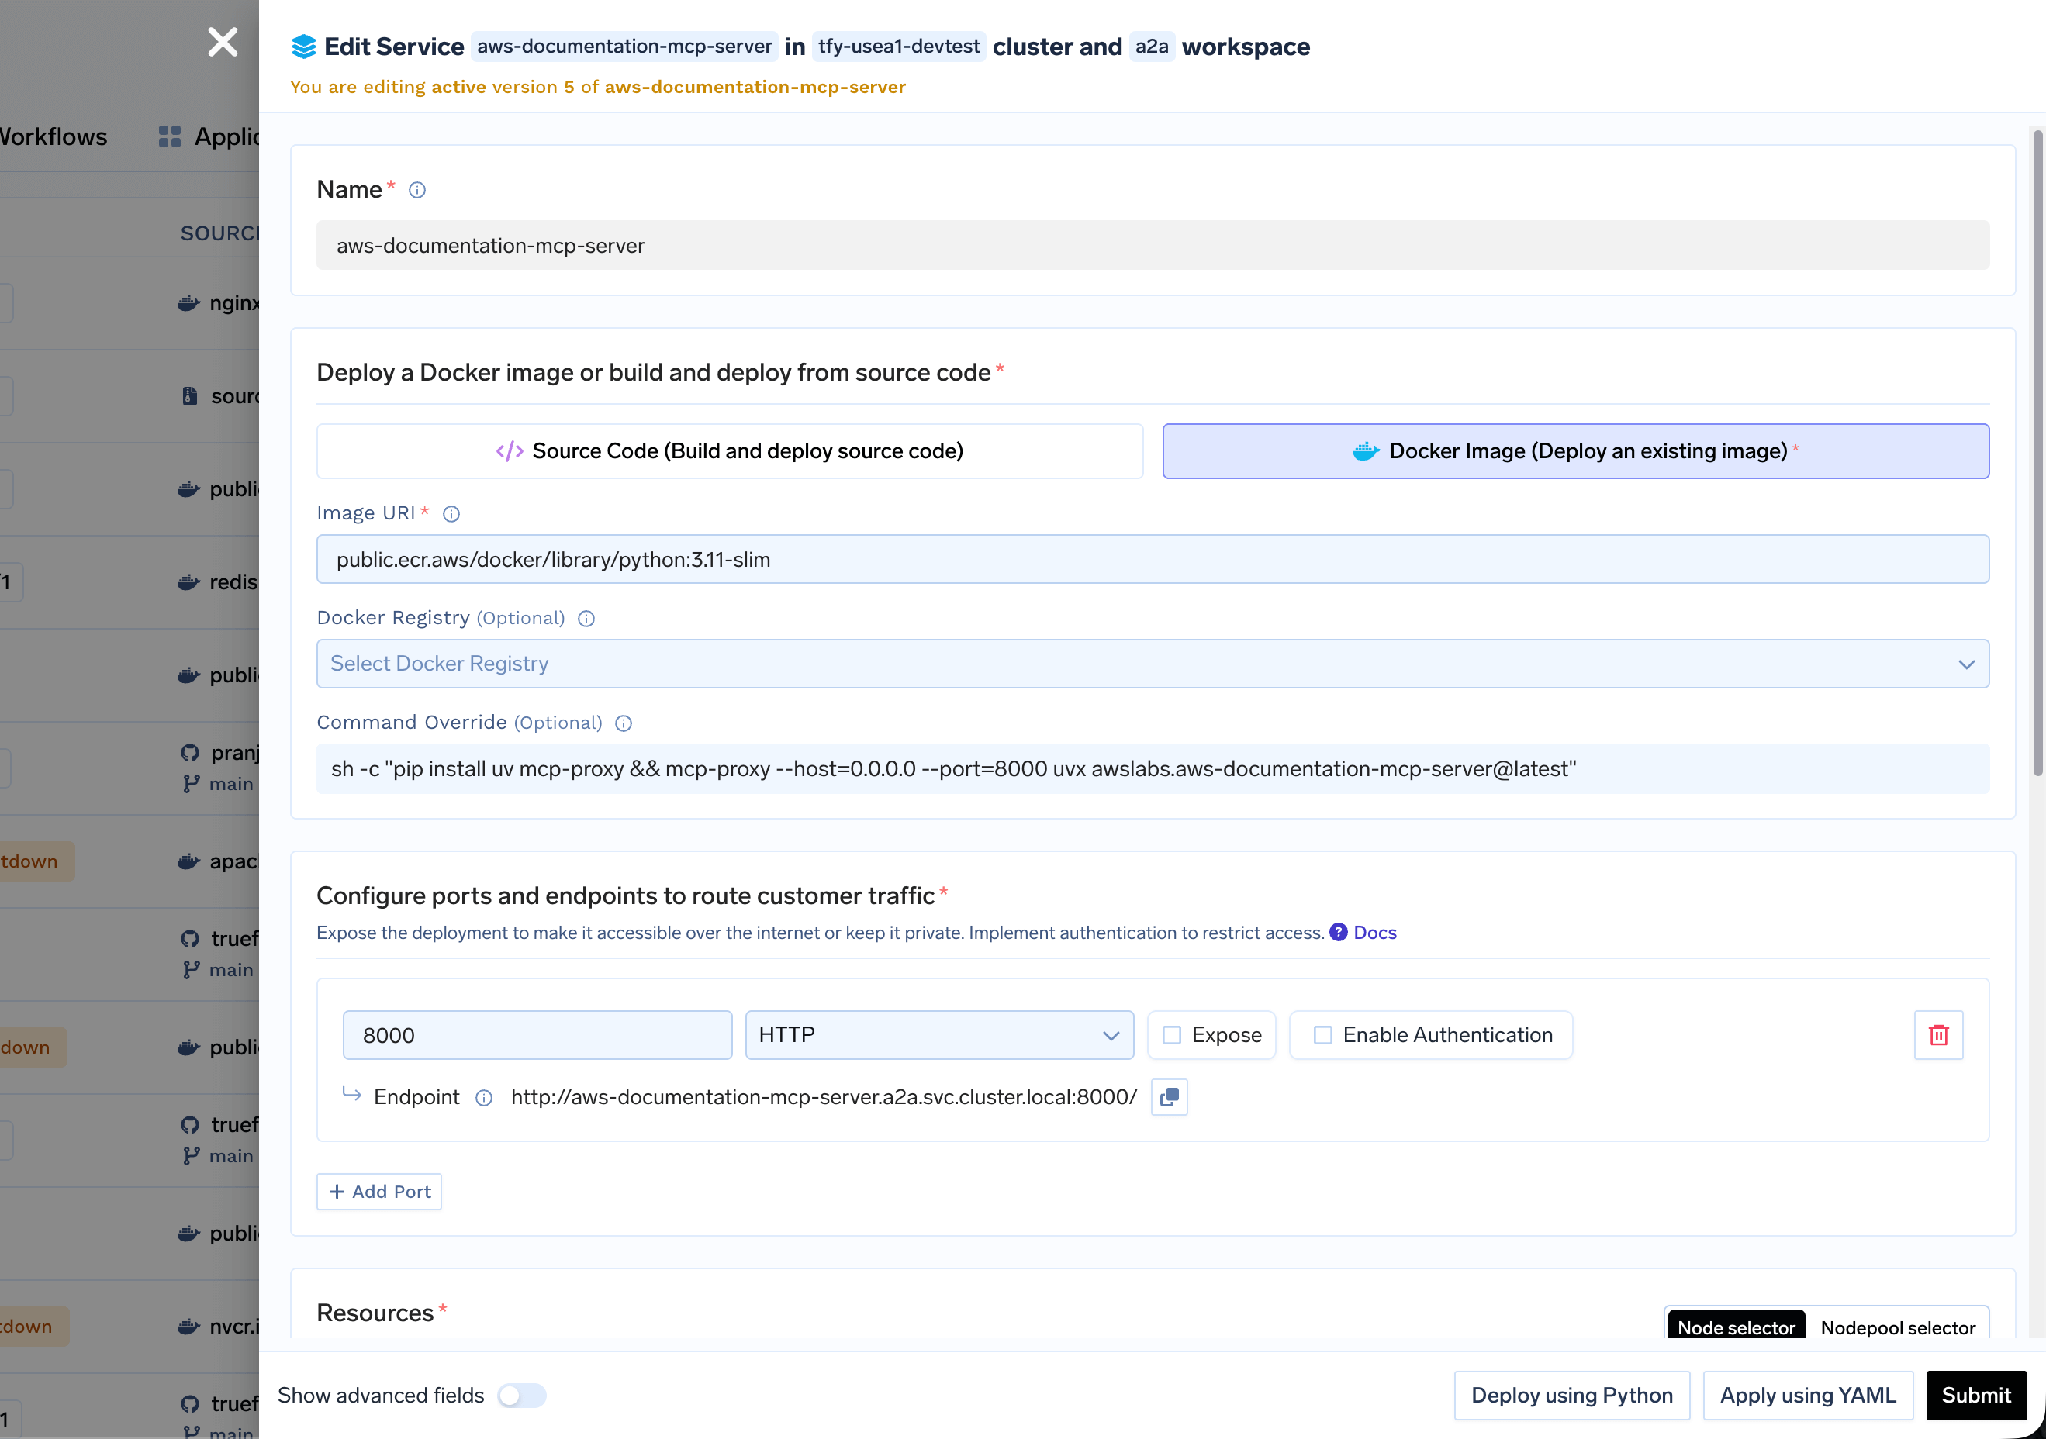
Formulaire Deploy from Docker Image avec une image de base python:3.11-slim et mcp-proxy enveloppant un paquet MCP uvx
Les variables d'environnement sont reprises à l'identique de votre configuration locale — NOTION_API_KEY, GITHUB_TOKEN — les plus sensibles étant déplacées dans Secrets. Une précision importante : le premier démarrage est lent le temps que npx ou uvx télécharge le paquet. Si le temps de démarrage à froid est critique, préinstallez-le dans une image personnalisée.
Une troisième voie permet de vous affranchir totalement du déploiement de service : plutôt que d'envelopper vous-même un serveur stdio et de le déployer, la passerelle exécute le processus et l'expose à la même URL qu'elle utilise pour les serveurs distants. Depuis MCP Servers → Add Server, choisissez Hosted Stdio-based MCP Server :
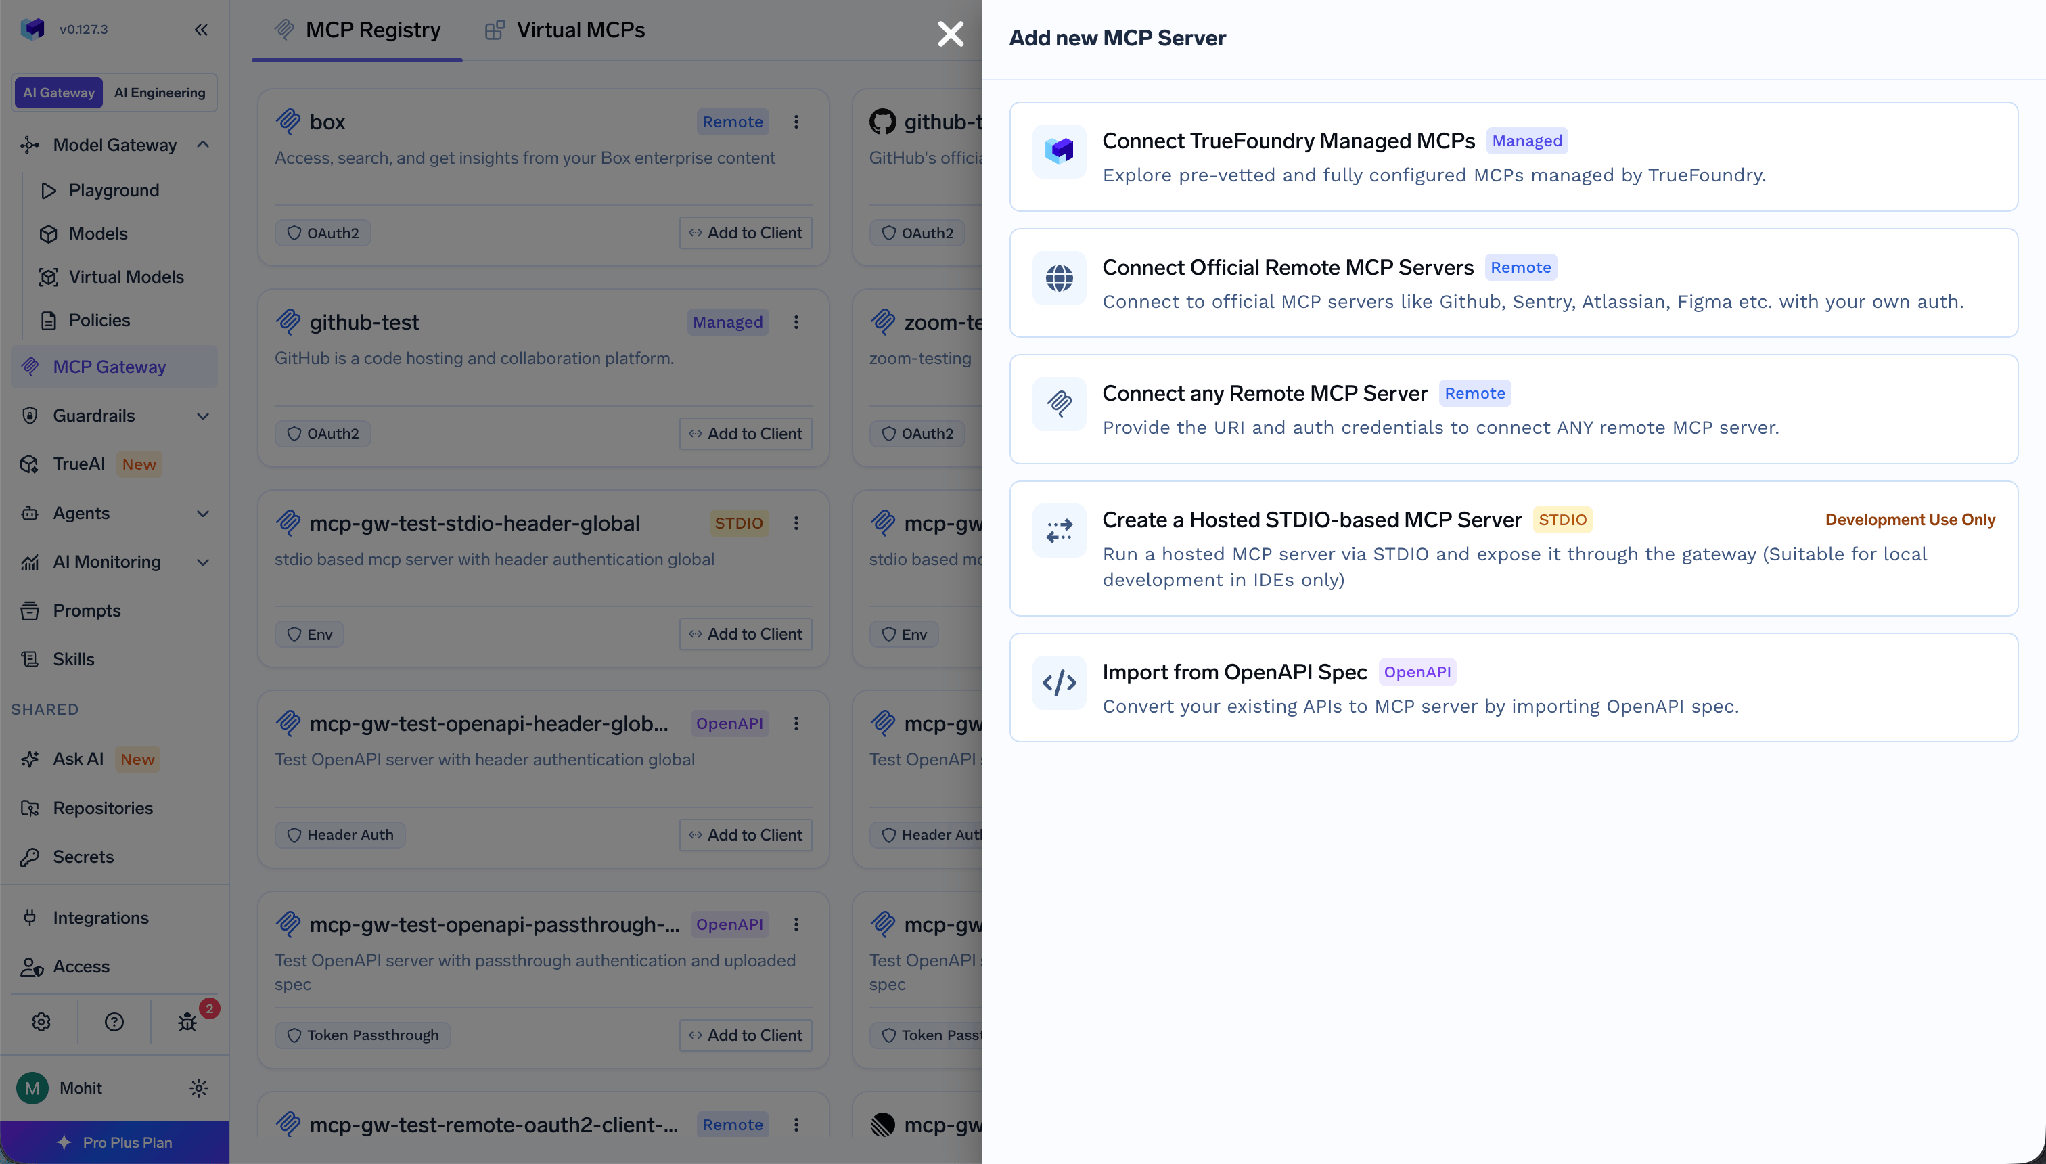
Vous fournissez une commande, des arguments et des variables d'environnement, ou vous collez du JSON au format éditeur — le même format mcpServers à entrée unique issu de Cursor ou VS Code — et le formulaire se remplit automatiquement. Le serveur de référence pour le système de fichiers s'exprime par la commande : npx avec les arguments -y, @modelcontextprotocol/server-filesystem, /tmp.
La passerelle l'exécute via la bibliothèque mcp-proxy dans un environnement isolé (sandbox) en mode sans état, et les clients se connectent via HTTP POST en mode stream. Les variables d'environnement peuvent être globales (tout le monde partage l'identifiant en aval) ou par utilisateur, où une valeur comporte exactement un espace réservé sous forme de modèle résolu à partir des Auth Overrides de l'appelant. Une mise en garde : la documentation recommande cette voie pour le développement local dans les IDE — la façon la plus rapide d'obtenir une URL partagée et gouvernée sur un serveur de type CLI, mais ce n'est pas le modèle adapté à une charge de travail de production à fort volume.
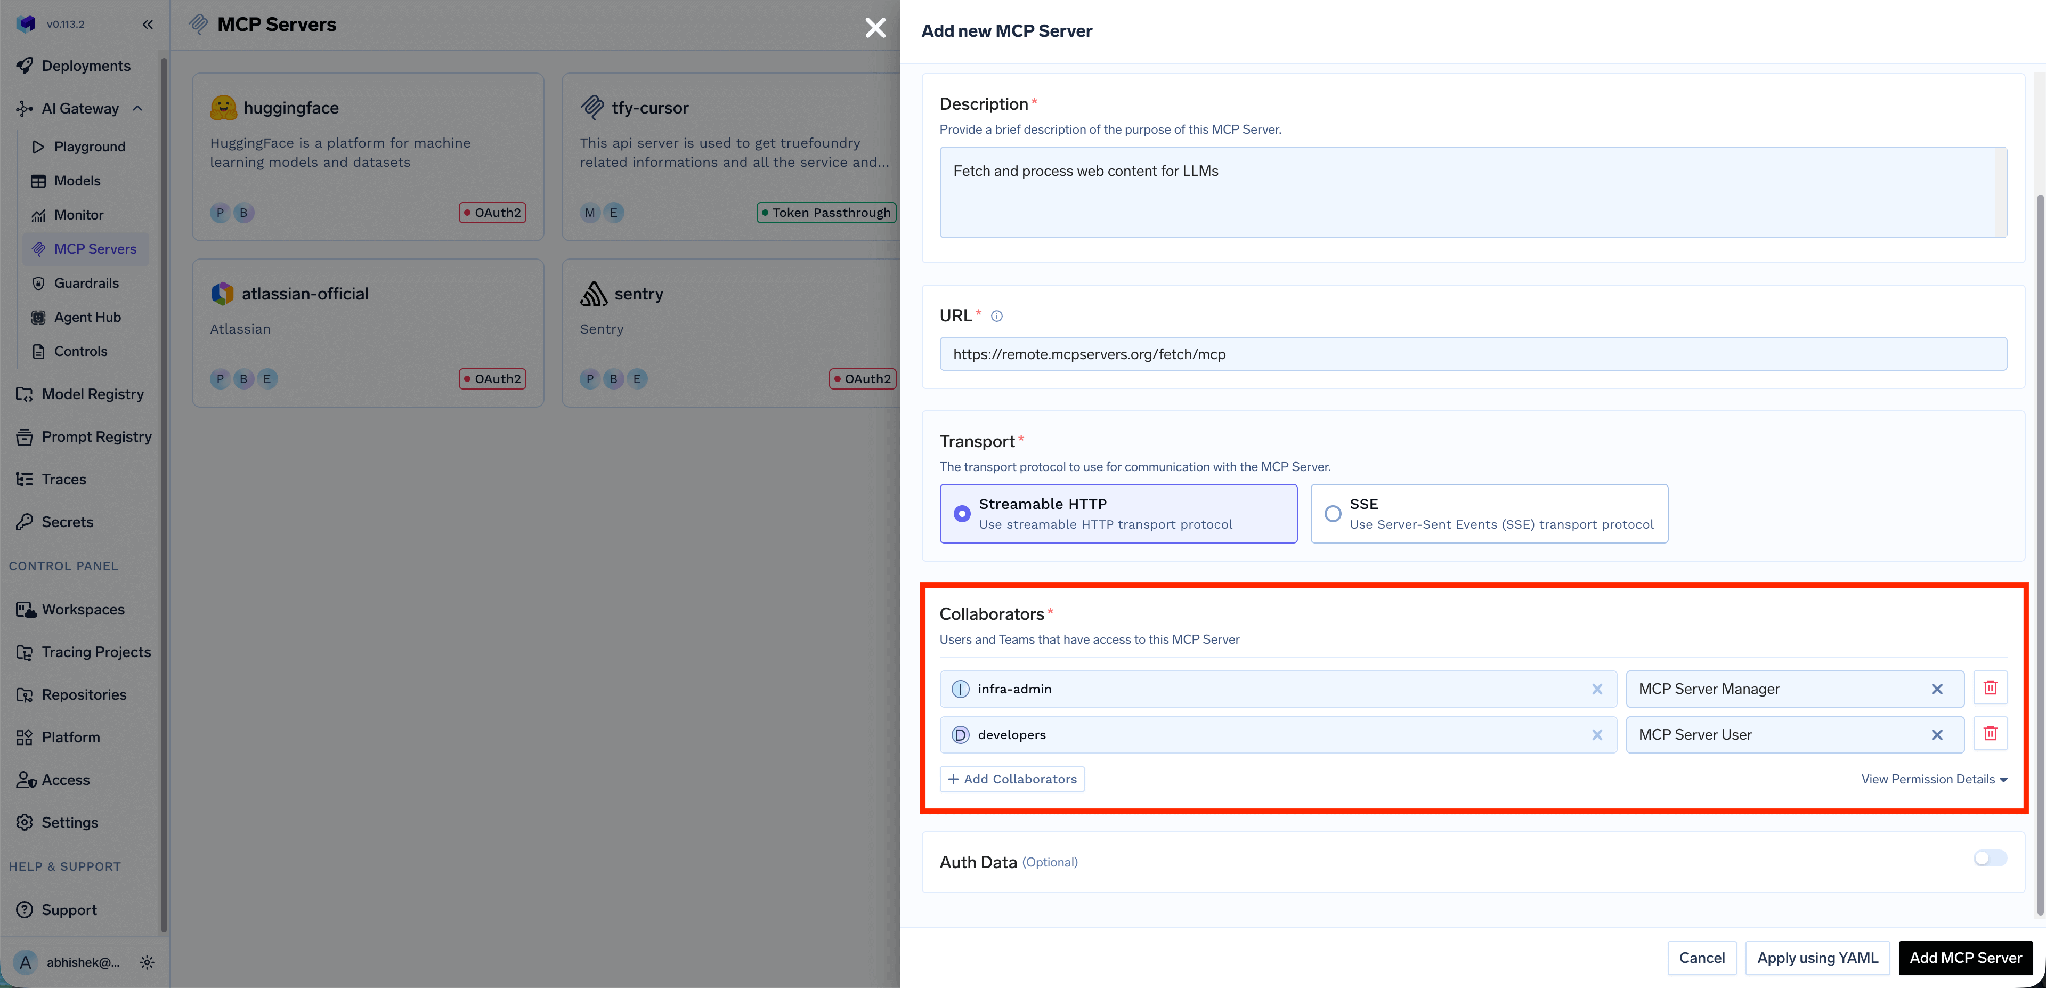
Quelle que soit la manière dont le serveur a été déployé, la dernière étape est identique. Prenez l'URL du point d'accès du service, allez dans Add Server → Connect any Remote MCP Server, et fournissez un nom, une description, une URL, des collaborateurs et des données d'authentification.
Le contrôle d'accès entrant s'attache ici. Les collaborateurs sont des utilisateurs ou des équipes, disposant du rôle MCP Server Manager pour les droits de configuration complets ou MCP Server User pour invoquer des outils sans modifier les paramètres :
L'authentification sortante — la façon dont la passerelle prouve son identité au serveur que vous avez déployé — s'effectue au choix par API Key, OAuth2, AWS SigV4 ou Token Passthrough. L'option API Key se divise en Shared Credentials, où une seule clé sert à tout le monde, et Individual Credentials, où la valeur d'en-tête comporte un espace réservé tel que Bearer {{API_KEY}} et où chaque utilisateur fournit la sienne via les Auth Overrides :
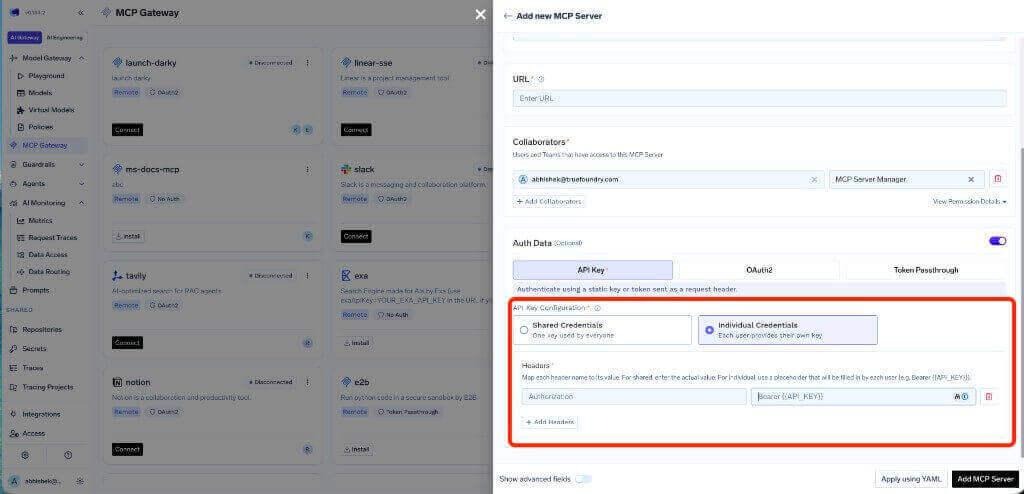
Pour un serveur que vous hébergez vous-même, les identifiants partagés sont souvent suffisants — la décision d'accès a déjà été prise au niveau de la passerelle. Pour tout ce qui protège des données par utilisateur, OAuth2 est la recommandation officielle en production : il gère les portées (scopes), les utilisateurs peuvent révoquer leur propre autorisation, et l'accès est limité à ce que chaque utilisateur est autorisé à voir.
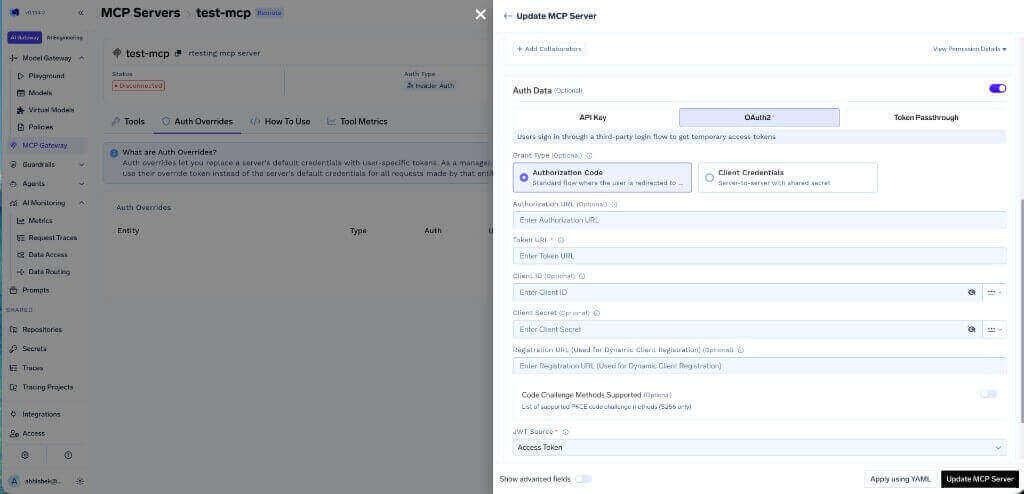
Configuration OAuth2 pour un serveur MCP avec les types d'octroi Authorization Code et Client Credentials
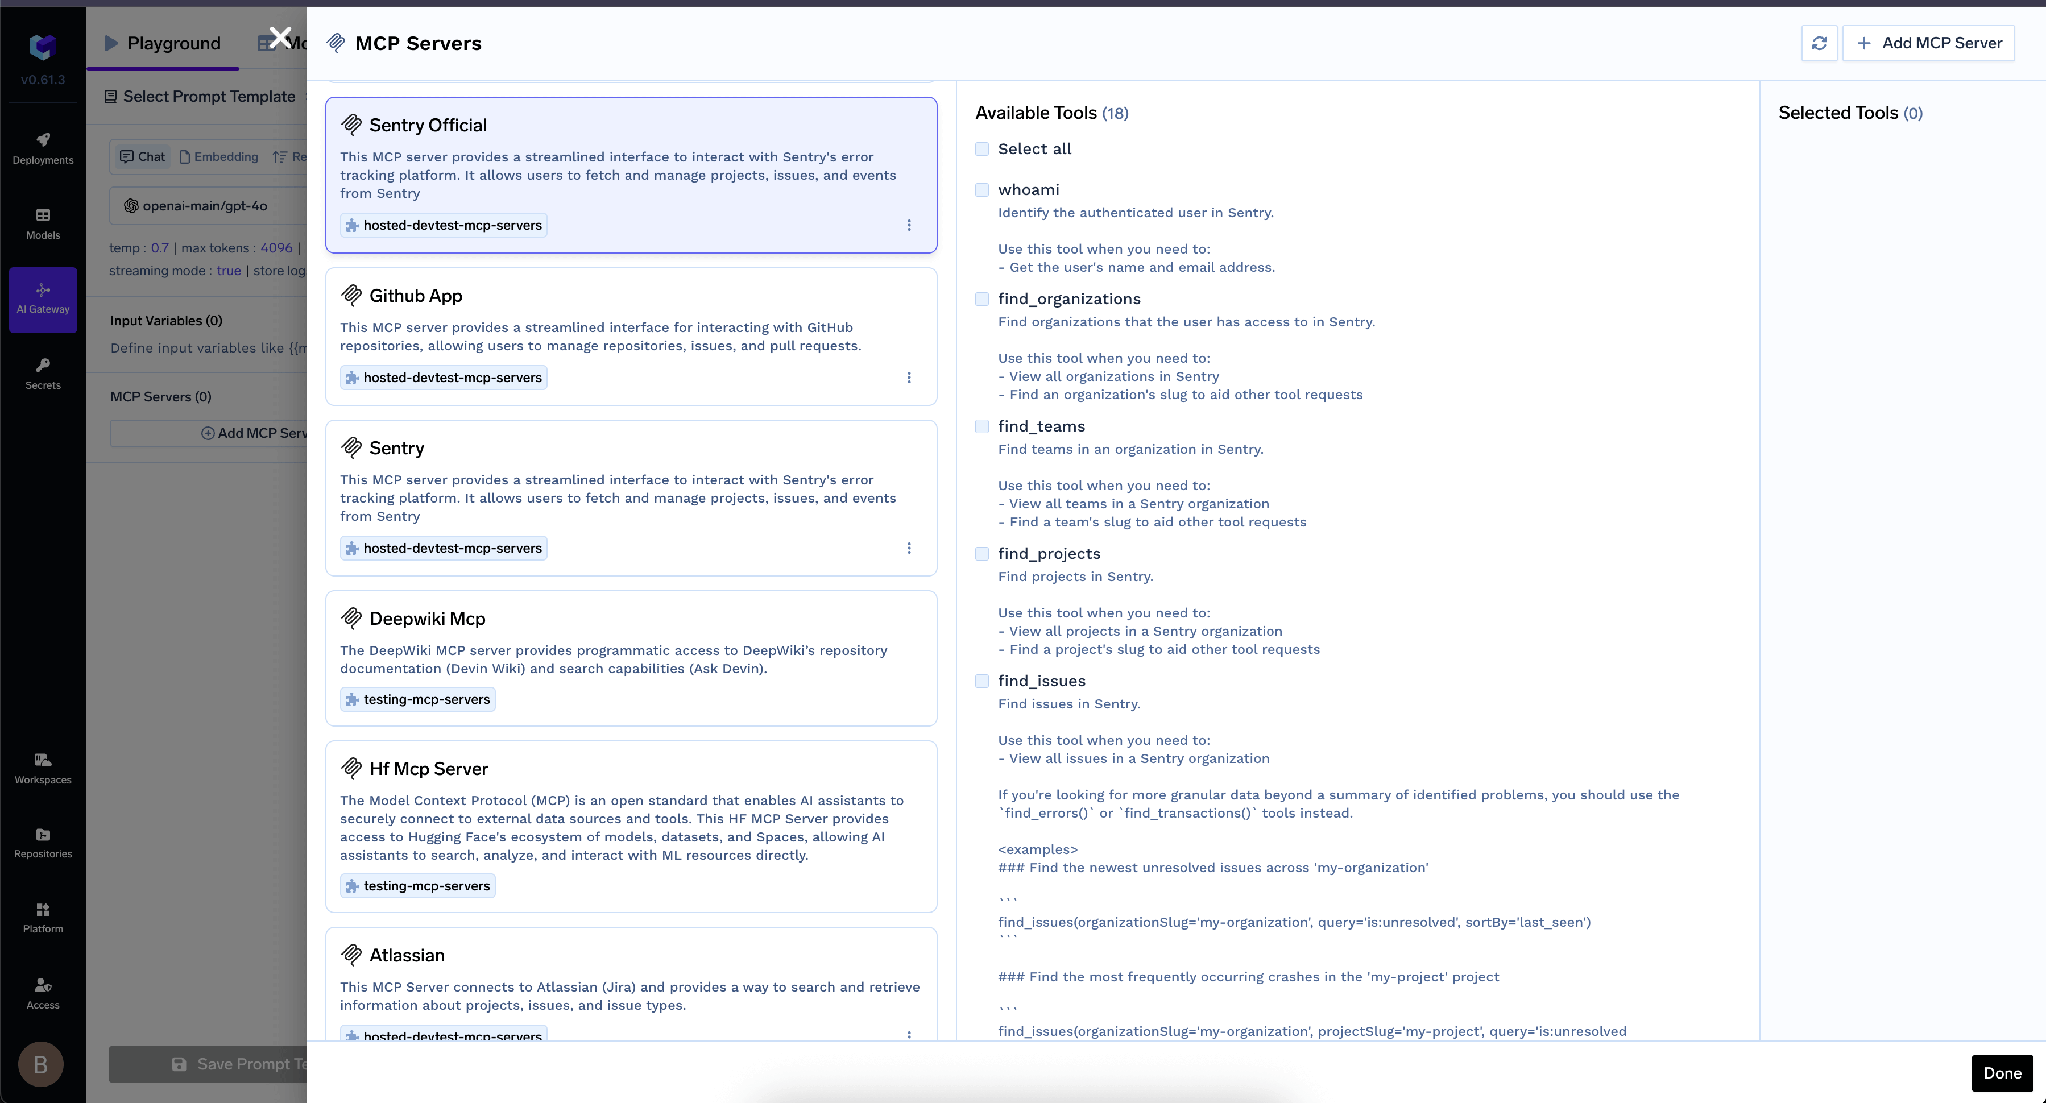
Une fois enregistrés, les outils apparaissent et peuvent être invoqués depuis le Playground :
Huit développeurs disposent chacun du bloc npx Notion dans leur configuration Cursor, chacun avec une clé Notion personnelle. Vous souhaitez une seule copie hébergée.
Étape 1 — Déployer. New Deployment → Service → Deploy from Docker Image, image de base node:24, commande npx -y mcp-proxy --port 8000 --host 0.0.0.0 --server stream npx -y @notionhq/notion-mcp-server, port 8000, protocole TCP, protocole d'application http. Verrouillez la version du paquet. Placez NOTION_API_KEY dans Secrets, et non dans le champ env en texte brut.
Étape 2 — Vérifier. Attendez le statut DEPLOY_SUCCESS, puis notez l'URL du point d'accès du service et testez-la avec curl. Le serveur doit répondre avec des messages du protocole MCP sur HTTP. Effectuer cette vérification avant d'enregistrer quoi que ce soit permet de distinguer « le conteneur ne démarre pas » de « la passerelle ne peut pas l'atteindre », ce qui évite bien des erreurs de diagnostic.
Étape 3 — Enregistrer. Add Server → Connect any Remote MCP Server, collez l'URL du point d'accès, nommez-le, ajoutez l'équipe d'ingénierie comme MCP Server User et vous-même comme MCP Server Manager, puis configurez les données d'authentification.
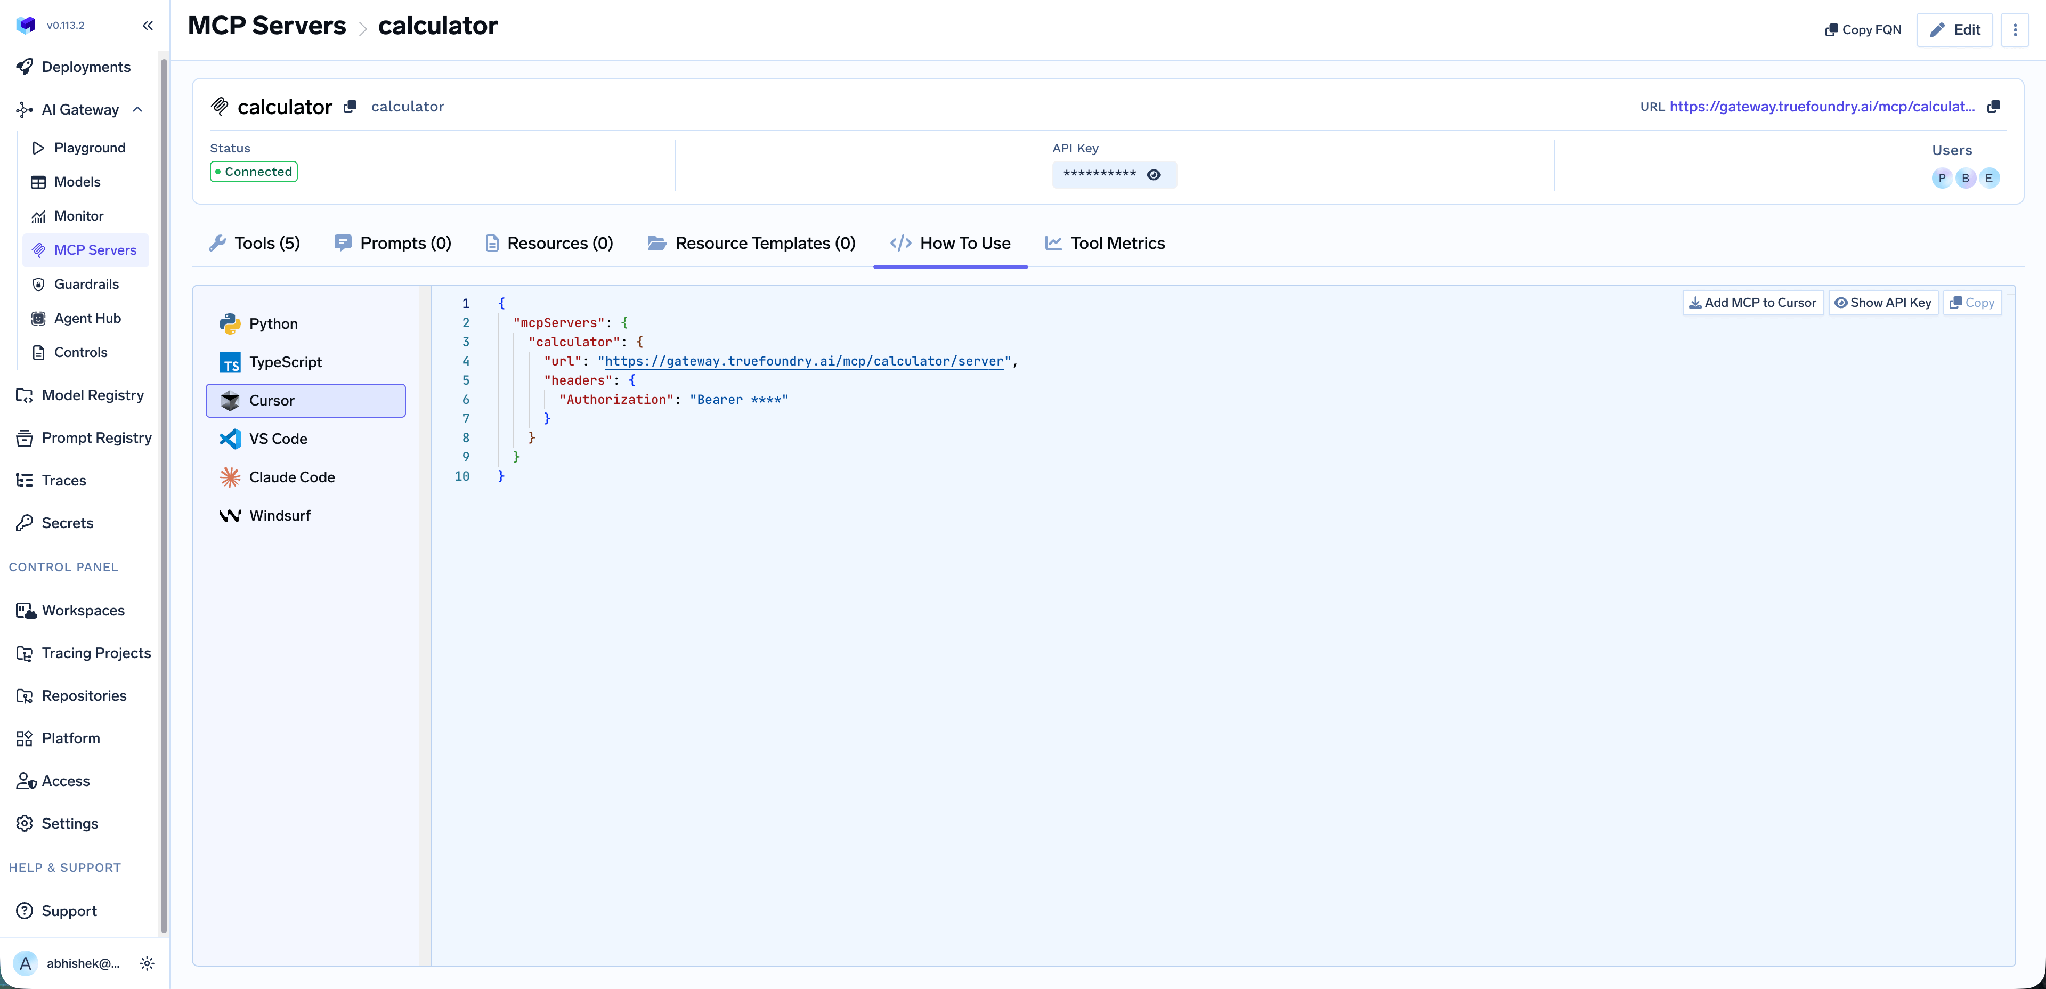
Étape 4 — Distribuer l'URL de la passerelle. L'onglet How To Use fournit des extraits de connexion spécifiques à l'environnement du client pour Cursor, VS Code, Claude Code, Windsurf, Codex, ainsi que pour les SDK Python et TypeScript, en plus d'un bouton Add MCP to Cursor qui écrit directement la configuration pour le développeur.
Étape 5 — Supprimer les blocs locaux. L'étape que les équipes oublient souvent, et celle qui donne tout son sens aux quatre autres. Tant que les entrées npx ne sont pas supprimées de la configuration de tout le monde, vous exécutez neuf copies au lieu d'une.
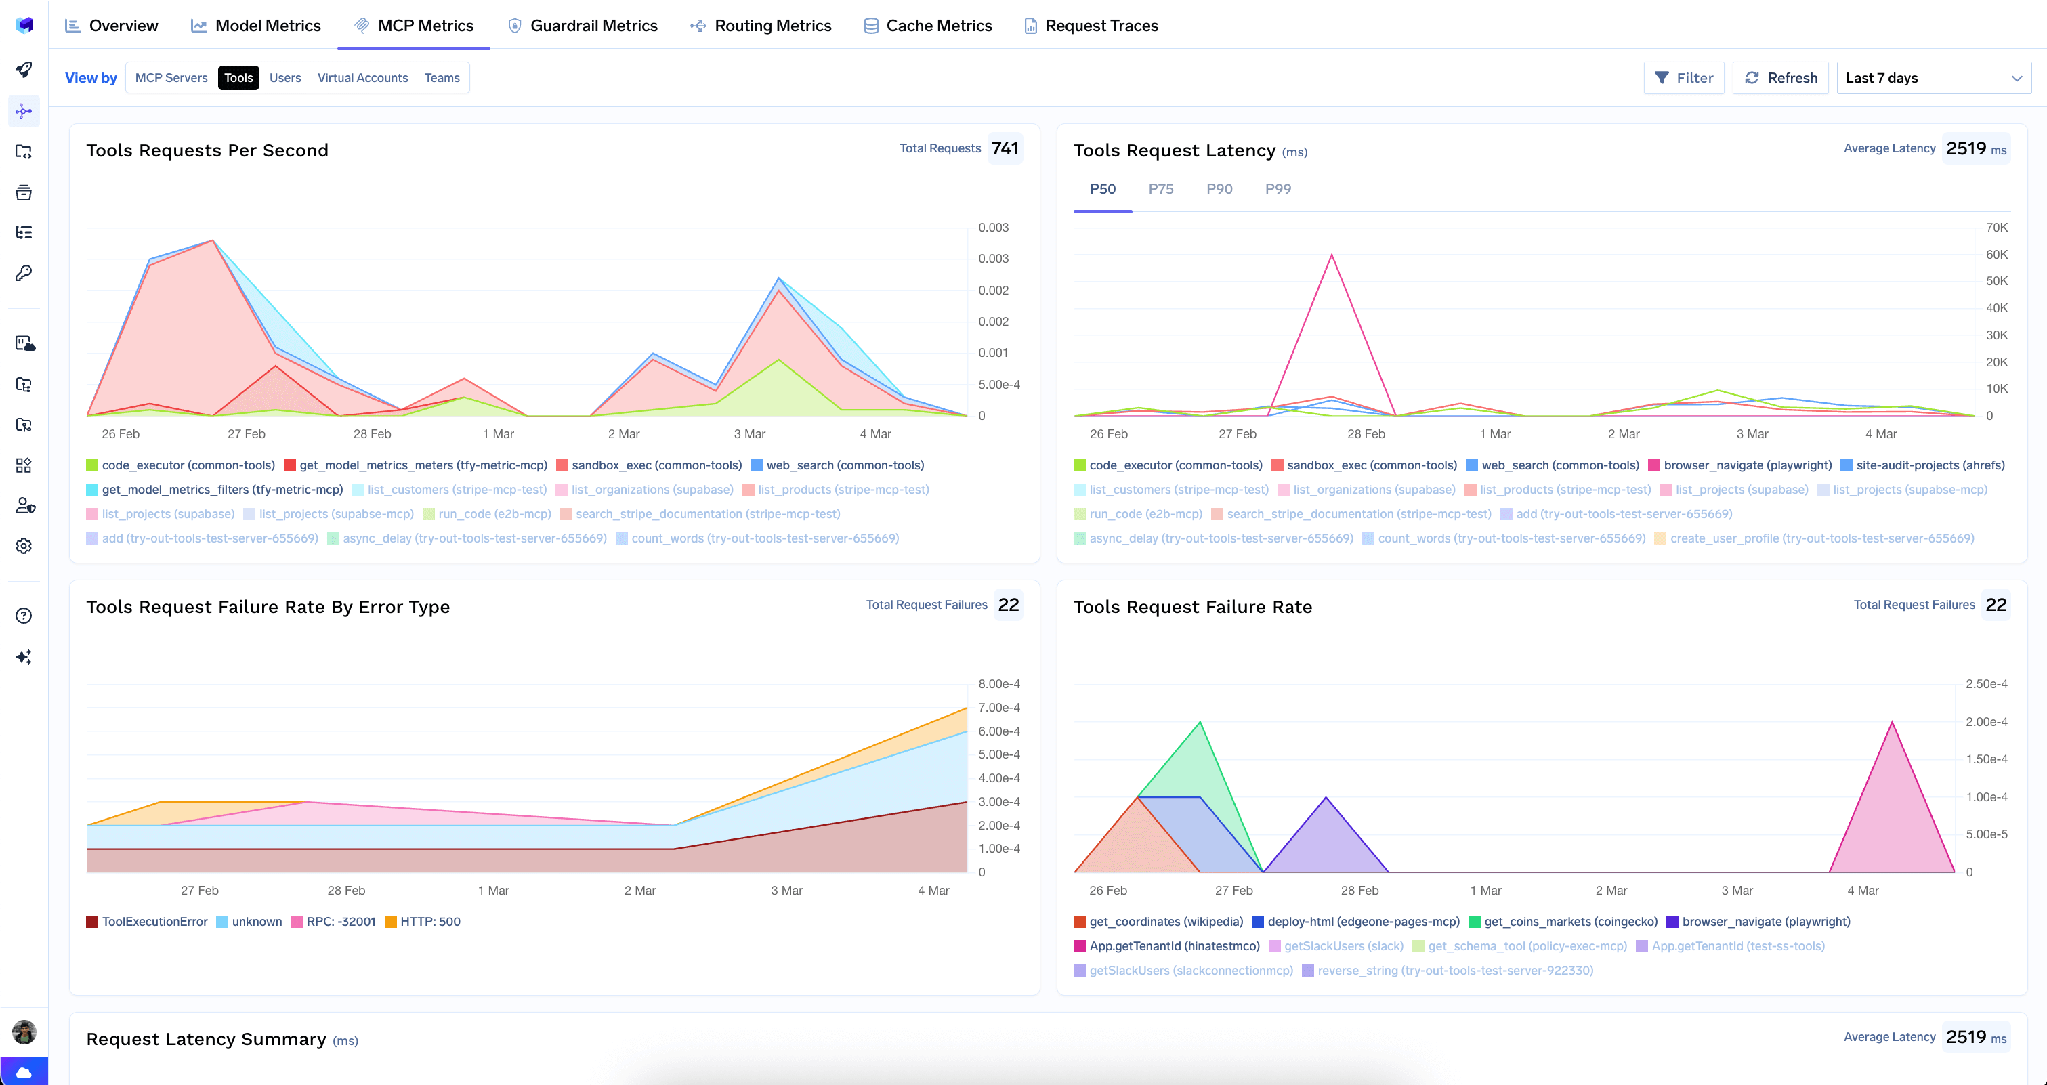
Ce que vous obtenez : une version unique du serveur, des identifiants dans un coffre-fort de secrets au lieu de huit ordinateurs portables, une visibilité par outil et la capacité de désactiver des outils de manière centralisée au lieu de devoir le demander gentiment à chacun.

Une installation bloquée ressemble à un serveur bloqué. Pour les serveurs stdio hébergés, l'échec d'installation d'un paquet n'apparaît pas sous forme d'erreur — le serveur reste indéfiniment dans l'état mcp_server_starting, parce que le gestionnaire de paquets ne passe jamais la main au processus MCP. Causes habituelles : une URL git sans référence de version fixe, des identifiants intégrés dans une URL de paquet npm (npm les supprime lors de la normalisation), ou un téléchargement partiel qui corrompt le cache npx après l'interruption d'un premier lancement. Modifier un élément dans les arguments réinitialise le bac à sable et permet un démarrage propre.
Les notifications hors du flux de réponse sont ignorées. La passerelle exécute les serveurs stdio en mode sans état, de sorte que les notifications autonomes initiées par le serveur en dehors du flux de réponse d'une requête ne sont pas transmises. Consultez la matrice de compatibilité du protocole avant de porter un serveur qui pousse des messages non sollicités.
L'adresse de liaison vous piégera au moins une fois. Se lier à localhost produit un conteneur qui démarre, réussit son propre contrôle de santé, mais reste invisible pour le cluster. Chaque commande d'enveloppement stdio dans la documentation comporte --host 0.0.0.0 exactement pour cette raison.
Les démarrages à froid sont bien réels avec npx/uvx. Le paquet est téléchargé au démarrage du conteneur — ce qui est acceptable pour un serveur destiné au développement, mais gênant pour tout ce qui exige une faible latence.
L'hébergement de serveurs MCP n'est pas un problème exotique. C'est le problème classique consistant à prendre un processus qui fonctionne sur un ordinateur portable pour en faire un service sur lequel une équipe peut compter — avec une URL, une identité, des limites de ressources, des secrets et un historique de ce qui s'est passé.
Ce qui rend cette démarche essentielle, c'est qu'un serveur MCP est un point d'accès à des outils. Garantir l'accessibilité sans contrôle d'accès n'est pas une réussite ; c'est une exposition aux risques. Déployer sur votre propre Kubernetes et enregistrer le serveur derrière une passerelle sur la même plateforme rassemble ces deux enjeux en une seule tâche : le processus s'exécute là où votre politique réseau s'applique déjà, et l'URL qui le protège sait déjà qui passe l'appel.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Exécuter un serveur MCP comme un processus persistant et joignable plutôt que comme un processus enfant sur la machine d'un développeur. En pratique : le déployer comme un service HTTP — directement s'il parle déjà HTTP/SSE, ou encapsulé avec mcp-proxy s'il parle stdio — afin que de nombreux clients partagent un seul déploiement derrière une seule URL.
Le stdio local pour un développeur seul qui expérimente. Le cloud managé d'un fournisseur pour les serveurs publics ou en lecture seule, lorsque la rapidité compte plus que l'emplacement réseau. Votre propre infrastructure pour tout ce qui touche aux systèmes internes ou aux données réglementées, car la position réseau et le stockage des identifiants relèvent alors de votre décision et non de celle d'un fournisseur.
Oui. Un serveur MCP qui parle HTTP est un service sans état ordinaire — un conteneur, un port, des demandes de ressources, un nombre de réplicas. Sur TrueFoundry, vous le déployez dans un workspace de votre propre cluster à partir d'un dépôt Git, de code local ou d'une image Docker, et les serveurs stdio y parviennent en étant encapsulés avec mcp-proxy.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















