



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
GPT-6 Astra est arrivé le 3 septembre 2026. La chaîne API est gpt-6-astra — pas de snapshot daté, pas d'alias séparé ; la page du modèle liste gpt-6-astra à la fois comme snapshot et comme alias.
Les spécifications, issues de la documentation du modèle d'OpenAI :
Trois éléments dans les petites lignes comptent plus que le titre principal.
Premièrement, reasoning.effort n'accepte plus none. GPT-5.6 Sol l'acceptait. Si vous avez un parcours rapide et peu coûteux fixé à none, il ne sera pas portable direct.
Deuxièmement, temperature, top_p et logprobs ont disparu. Le journal des modifications indique qu'Astra « ne prend pas en charge les valeurs personnalisées de temperature ou top_p ni les log probabilities. » Tout ce qui, dans votre stack, définit des paramètres d'échantillonnage doit être audité avant de basculer.
Troisièmement, l'appel d'outils (tool calling) nécessite l'API Responses. Si vous appelez des outils via Chat Completions aujourd'hui, il s'agit d'une migration et non d'un simple changement de modèle.
[CAPTURE D'ÉCRAN : Plateforme OpenAI — la page du modèle gpt-6-astra montrant la fenêtre de contexte, la sortie maximale et le prix par token]
La fenêtre de contexte et la limite de sortie n'ont pas bougé. Le prix, oui.
Sources : Documentation du modèle GPT-6 Astra, documentation du modèle GPT-5.6 Sol, septembre 2026. Notez qu'OpenAI décrit les tarifs de GPT-5.6 Sol comme des prix promotionnels disponibles au moins jusqu'au 21 novembre 2026, de sorte que le ratio pourrait ne pas être maintenu au-delà de cette date.
Chaque tarif a évolué exactement dans les mêmes proportions. Cela s'avère important pour la question de la mise en cache abordée ci-dessous.
Batch et Flex restent à 50 % de Standard. Le mode Fast, qui, selon OpenAI, offre une vitesse jusqu'à 2x supérieure à celle du traitement Standard, est facturé au double des tarifs applicables — le mode Fast d'Astra est donc à 20 $ en entrée et 100 $ en sortie.
OpenAI publie un grand tableau comparatif dans son billet de lancement. Voici la partie qui mérite d'être reproduite, puis la partie que la plupart des analyses omettent.
Source : Billet de lancement de GPT-6 Astra, septembre 2026. Les scores représentent le maximum pour chaque effort de raisonnement.
Où Astra est nettement en tête. Le travail agentique sur de longs horizons. Terminal-Bench 4.0 gagne plus de vingt points par rapport à Sol. Terminal-Bench Science a presque triplé. AutomationBench fait plus que doubler. La recherche dans un contexte long (retrieval) à 512K-1M passe de 73,8 % à 96,3 %. Ce sont les charges de travail pour lesquelles le modèle a été conçu, et l'écart est flagrant.
Où l'écart devient négligeable. Les connaissances et le raisonnement en un seul coup (single-shot). GPQA Diamond passe de 94,6 % à 96,0 %. DeepSWE passe de 72,7 % à 74,1 %. Si votre trafic concerne des questions avec réponses plutôt que des tâches avec étapes, vous payez 2,5x plus cher pour environ un point de gain.
Où Astra ne gagne pas. Sur les deux indices composites tiers qu'OpenAI a choisi d'inclure, Astra n'est pas premier. L'Intelligence Index d'Artificial Analysis place Claude Fable 5.1 à 65,7 contre 61,2 pour Astra. Le Coding Agent Index place Claude Opus 5 à 68,1 contre 67,0 pour Astra. OpenAI a publié ces deux chiffres, ce qui est à son honneur, et ils constituent le contrepoids honnête aux réussites agentiques ci-dessus.
Un élément qui complique l'analyse financière. Les estimations de coût par tâche d'OpenAI s'avèrent parfois inférieures à celles de Sol malgré le tarif de 2,5x, parce qu'Astra termine ses tâches en consommant moins de tokens. Le billet de lancement annonce un coût API estimé par tâche inférieur d'environ 9 % sur Terminal-Bench 4.0 par rapport à Sol, d'environ 27 % sur Terminal-Bench Science avec une configuration plus économique, et d'environ 43 % sur BenchCAD. Ce sont les propres estimations d'OpenAI dans des configurations spécifiques, et non des études indépendantes, et elles ne se généraliseront pas à l'ensemble de votre trafic. Mais elles signifient que « 2,5x plus cher » est une conclusion trompeuse pour le travail agentique. Mesurez les tokens par tâche accomplie, et non le prix par token.
TrueFoundry a réalisé le calcul du seuil de rentabilité de la mise en cache sur GPT-5.6 lorsque les écritures de cache sont devenues payantes pour la première fois. La même question se pose ici, et la réponse est plus intéressante qu'il n'y paraît.
Les multiplicateurs de cache d'Astra sont identiques à ceux de GPT-5.6. La documentation indique que les écritures de cache sont facturées 1,25x le tarif d'entrée non mis en cache, et le tarif d'entrée mis en cache publié de 1,00 $ par rapport au tarif d'entrée de 10,00 $ est exactement de 0,10x. Donc :
Soit w la part des requêtes sur un préfixe partagé qui sont des écritures de cache plutôt que des lectures. La mise en cache devient rentable lorsque :
1,25w + 0,10(1 - w) = 1
1,15w = 0,90
w = 78,3 %
Le seuil de rentabilité est de 78,3 %, inchangé par rapport à GPT-5.6. P s'annule, c'est pourquoi l'augmentation de prix de 2,5x ne change rien à l'équation. La mise en cache cesse d'être rentable uniquement si plus d'environ 78 % de vos requêtes sur un préfixe donné sont des écritures — c'est-à-dire lorsque votre contexte partagé ne survit pas à plus de 1,3 requête en moyenne avant de changer ou d'expirer. Presque aucune charge de travail agentique réelle ne se situe dans cette zone.
Ce que l'augmentation de prix change, en revanche, c'est le montant des économies réalisables. Prenons un préfixe partagé de 32K tokens réutilisé lors d'une session de 25 requêtes — une écriture, vingt-quatre lectures :
Le pourcentage est identique. Les montants en dollars sont 2,5 fois supérieurs. La mise en cache a toujours valu le coup ; sur Astra, ne pas l'utiliser coûte deux fois et demi plus cher.
Le cas d'échec reste également inchangé : un contexte qui varie constamment. Si votre agent reconstruit son system prompt ou son schéma d'outils toutes les quelques étapes, vous payez 12,50 $ par million pour écrire un cache que vous lisez à peine. C'est désormais une erreur à 12,50 $ au lieu d'une erreur à 5,00 $.
La fenêtre de contexte annoncée de GPT-6 est de 1 050 000 tokens. La facturation ne progresse pas de manière linéaire sur l'ensemble de ce volume.
D'après la documentation : « Les prompts contenant plus de 272K tokens d'entrée sont facturés au double des tarifs d'entrée et de cache et à 1,5x pour la sortie sur l'ensemble de la requête. »
Lisez ceci attentivement. C'est sur l'ensemble de la requête, et non sur le surplus dépassant 272K. Franchir cette ligne ne vous coûte pas le double sur les tokens supplémentaires ; cela vous coûte le double sur TOUS vos tokens.
Une augmentation de 0,7 % de la taille du prompt entraîne une hausse de 101 % de la facture d'entrée. Les lectures mises en cache doublent également, passant de 1,00 $ à 2,00 $ par million, et la sortie passe de 50,00 $ à 75,00 $. GPT-5.6 Sol appliquait la même règle, ce n'est donc pas une nouveauté — mais avec les tarifs d'Astra, le saut est 2,5 fois plus haut.
La conséquence pratique : si vos prompts se situent autour de 272K, l'optimisation des coûts la plus efficace à votre disposition consiste à repasser sous cette limite. Retirer 5K tokens d'un prompt de 275K rapporte plus que n'importe quel changement de routage que vous pourriez mettre en place.
[CAPTURE D'ÉCRAN : Plateforme OpenAI — tableau de bord d'utilisation montrant les dépenses en tokens d'entrée, d'entrée mise en cache et de sortie par modèle]
Quatre modes d'échec apparaissent régulièrement dans les premières semaines suivant le lancement d'un modèle frontière, et Astra rassemble ces quatre pièges.
Tout est redirigé vers le nouveau modèle. La décision la plus coûteuse qu'une équipe puisse prendre après un lancement est d'en faire le choix par défaut. À 10 $ l'entrée et 50 $ la sortie, un appel de classification auquel un modèle bon marché répond correctement coûte désormais 2,5 fois plus cher que le mois dernier, sans aucun gain de qualité. Le tableau de benchmarks ci-dessus milite pour une flotte mixte, non pour une migration aveugle.
La migration n'est pas un simple remplacement de chaîne de caractères. Pas d'effort de raisonnement à none, pas de temperature, pas de top_p, pas de logprobs, et un appel d'outils qui nécessite l'API Responses. Du code qui fonctionnait sur gpt-5.6-sol peut échouer sur gpt-6-astra de manière peu évidente jusqu'à la mise en production.
La surveillance de l'alignement peut interrompre votre requête. OpenAI exécute des contrôles asynchrones sur le travail des agents dans les requêtes prises en charge par l'API Responses. Le billet de lancement est explicite sur les conséquences : dans ChatGPT ou Codex, il peut vous être demandé de revoir une action, mais « dans l'API, la tâche s'arrêtera. » OpenAI reconnaît que ces vérifications « peuvent parfois interrompre un travail légitime. » C'est une nouvelle caractéristique de fiabilité à prendre en compte lors de la conception, et non un simple détail.
Personne ne connaît le coût réel avant de recevoir la facture. Le prix par token ne vous dit pas grand-chose lorsque le modèle utilise un nombre différent de tokens par tâche. Sans attribution des coûts par requête et par équipe, il est impossible de savoir si « Astra est plus ou moins cher pour nous ».
Un modèle frontière plus coûteux ne réduit pas l'intérêt d'une gateway. Au contraire, cela le renforce, car chaque décision de routage a désormais 2,5 fois plus de valeur.
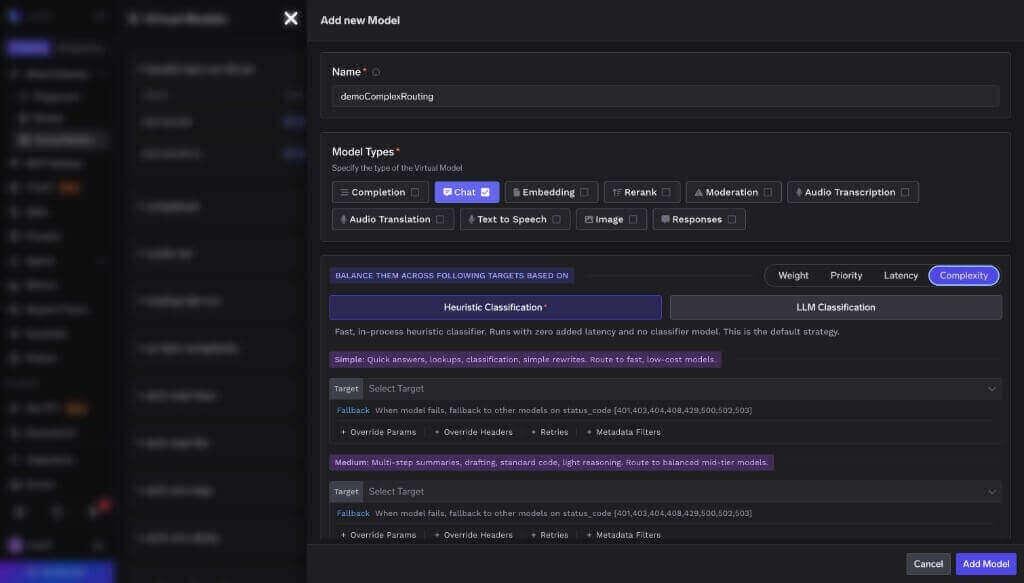
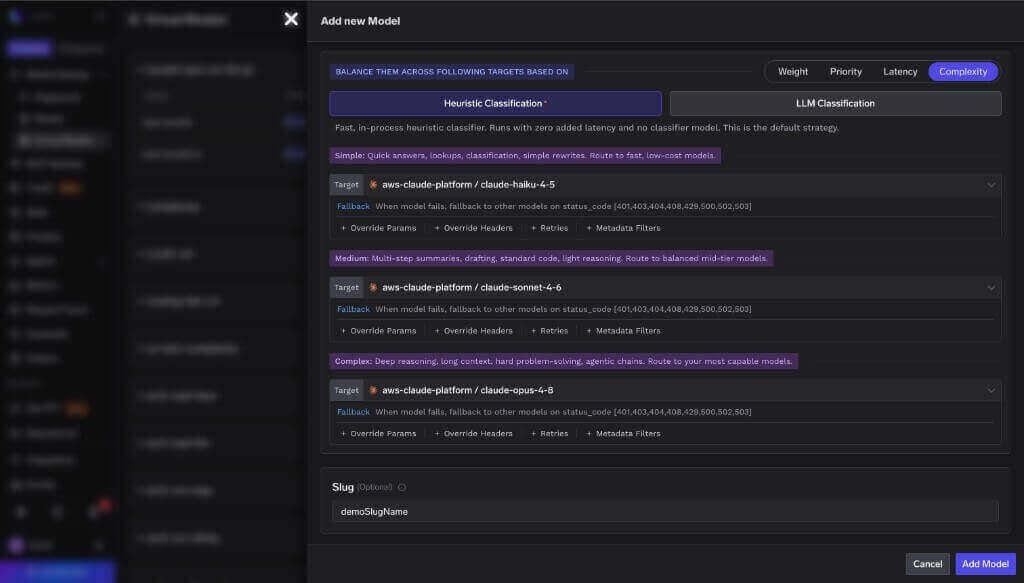
Acheminez en fonction de la complexité, pas par habitude. L'AI Gateway classe les requêtes entrantes et les envoie vers le niveau approprié, de sorte que le travail agentique lourd atteigne Astra tandis que l'extraction, la classification et le résumé sont traités ailleurs. Dans le benchmark d'Auto Routing de TrueFoundry réalisé sur 550 prompts, l'organisation par niveaux a réduit les coûts de 69 % tout en conservant 98 % de la qualité de référence, la latence moyenne passant de 7,6s à 4,0s. Sur un trafic représentatif de la production, la réduction a atteint 80 %. Appliqués à des tarifs de 10 $/50 $, ces pourcentages représentent une valeur bien plus importante qu'à 4 $/20 $.
Normalisez la mise en cache entre les fournisseurs. La sémantique de cache d'Astra est propre à OpenAI. Celle d'Anthropic est différente, et celle de Bedrock l'est également. La mise en cache de prompts indépendante du fournisseur au niveau de la gateway signifie que vous écrivez le préfixe une fois et que la règle des 78,3 % s'applique quel que soit le modèle sélectionné par le routeur.
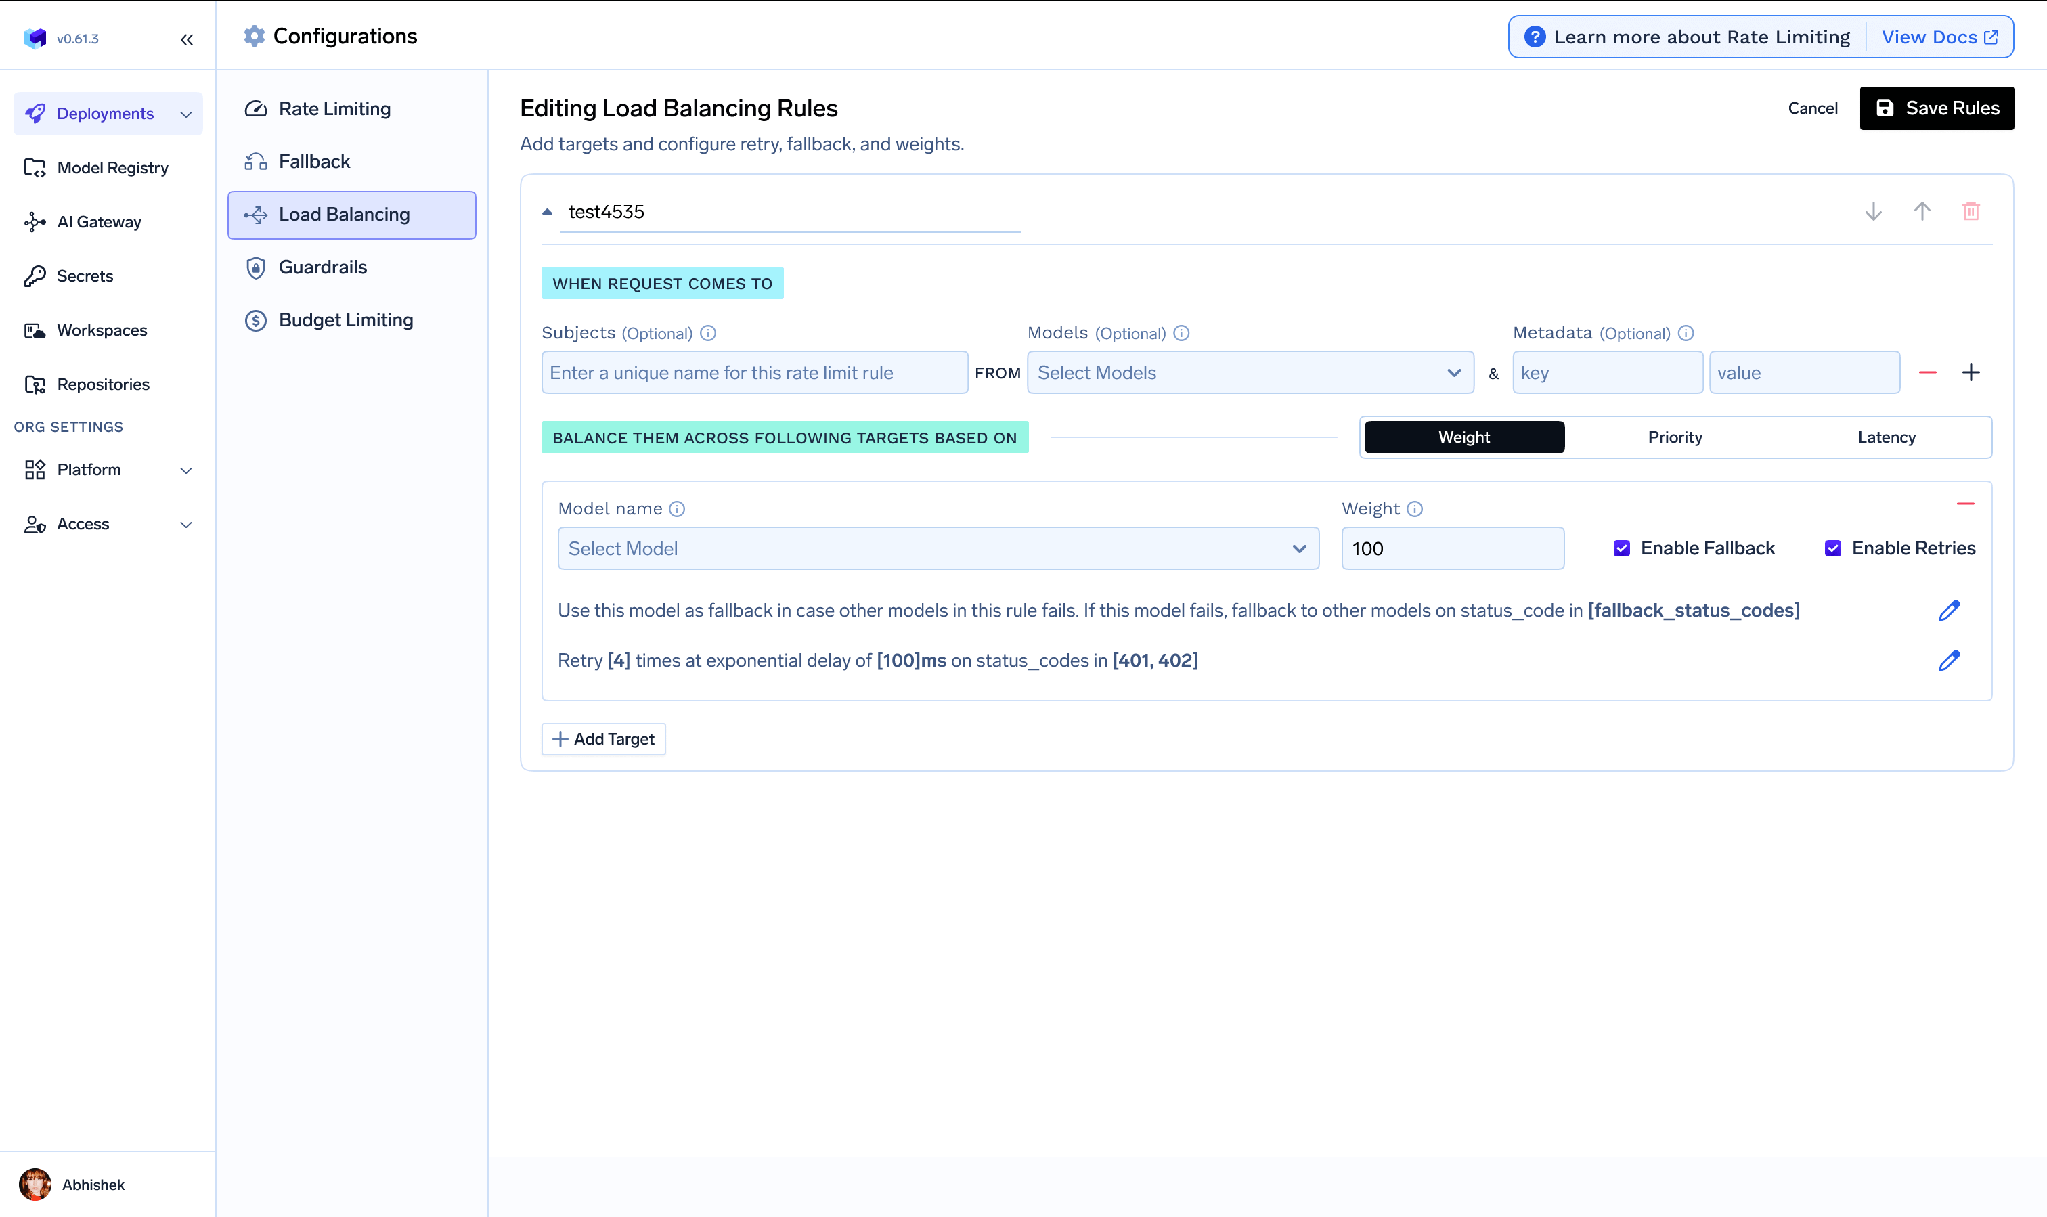
Mesurez le coût par tâche, non le coût par token. Tout l'argument de tarification d'Astra repose sur l'efficacité en tokens, et vous ne pouvez pas trancher cela à partir d'une grille tarifaire. L'analyse des coûts par requête, du nombre de tokens et de la latence, ventilée par équipe et par modèle, est le seul moyen de vérifier si la promesse d'Astra de réduire le nombre de tokens par tâche se vérifie sur vos charges de travail.

Conservez une stratégie de garde-fous (guardrails) unique quel que soit le modèle. Les garde-fous installés au niveau de la gateway s'exécutent sur le parcours des requêtes et des réponses quel que soit le modèle qui répond, de sorte qu'un changement de routage n'altère pas discrètement votre niveau de sécurité.

En résumé, au mois de septembre 2026 :

GPT-6 Astra représente une réelle avancée pour les tâches pour lesquelles il a été conçu. Terminal-Bench 4.0 en hausse de vingt points, recherche sur contexte long en hausse de vingt-deux points, AutomationBench qui fait plus que doubler — ces résultats ne sont pas marginaux. En revanche, sur les indices composites tiers publiés par OpenAI elle-même, il ne termine pas en tête, et sur les questions de connaissances en un seul coup (single-shot), la différence par rapport à GPT-5.6 Sol reste très modeste.
La tarification reflète cette même dualité. Chaque tarif a augmenté de 2,5x, ce qui semble être une hausse directe, jusqu'à ce que l'on remarque que les propres estimations d'OpenAI par tâche sont inférieures à celles de Sol sur plusieurs benchmarks agentiques parce qu'Astra consomme moins de tokens. Ces deux constats sont compatibles. Savoir lequel s'applique à votre situation est une question empirique liée à votre trafic, et la seule façon d'y répondre est d'exécuter les deux modèles et de mesurer le coût par tâche accomplie.
Deux éléments ne nécessitent pas de mesure particulière. La mise en cache reste rentable exactement au même seuil de 78,3 % que sur GPT-5.6 ; si vous l'utilisez aujourd'hui, continuez. Et la falaise de facturation à 272K est un saut brutal qui doublera silencieusement la facture d'entrée d'un prompt qui a augmenté de seulement quelques milliers de tokens.
Tout dépend donc de ce que vous souhaitez gérer. Si vous voulez un modèle unique et une facture simple, redirigez tout vers Astra et acceptez de surpayer pour la moitié la plus simple de votre trafic. Si vous préférez envoyer le travail complexe vers le modèle le plus performant et le reste vers une solution plus économique, cela nécessite une couche de routage — et à 10 $ l'entrée et 50 $ la sortie, l'intérêt économique d'en mettre une en place vient de devenir deux fois et demi plus convaincant.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




GPT-6 Astra est le modèle de pointe d'OpenAI, sorti le 3 septembre 2026 et appelable dans l'API sous le nom gpt-6-astra. Il est disponible via l'API OpenAI, Microsoft Azure et AWS Bedrock, ainsi que pour les utilisateurs de ChatGPT Plus, Pro, Business et Enterprise.
En septembre 2026, par million de tokens : 10,00 $ en entrée, 1,00 $ en entrée mise en cache, 12,50 $ pour les écritures en cache, 50,00 $ en sortie. Batch et Flex sont à 50 % de ces tarifs ; le mode Fast est à 2x. Les requêtes de plus de 272K tokens d'entrée sont facturées à 2x les tarifs d'entrée et de cache et à 1,5x le tarif de sortie pour l'ensemble de la requête.
1 050 000 tokens, avec une sortie maximale de 128 000 tokens. Les deux valeurs sont identiques à celles de GPT-5.6 Sol. La limite pratique est commerciale plutôt que technique : au-delà de 272K tokens d'entrée, toute la requête est facturée au double du tarif d'entrée.
Cela dépend entièrement de la nature de la tâche. Sur le travail agentique de longue durée, les gains sont importants — Terminal-Bench 4.0 passe de 37,3 % à 57,9 %. Sur les questions de connaissance à réponse unique, ils sont marginaux, et vous les payez 2,5 fois plus cher par token. Routez en conséquence plutôt que de tout basculer.
Oui, et dans la même proportion. Les écritures en cache coûtent 1,25 fois le prix d'entrée et les lectures 0,10 fois, exactement comme avec GPT-5.6, si bien que le seuil de rentabilité se situe dans les deux cas à une part d'écritures de 78,3 %. Des prix catalogue plus élevés augmentent les économies en valeur absolue, pas le seuil.
L'AI Gateway de TrueFoundry ajoute environ 3 à 4 ms et soutient plus de 350 RPS sur 1 vCPU, ce qui est négligeable face à des temps de génération de plusieurs secondes.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















