November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Braintrust s'est imposé comme une plateforme d'observabilité de premier plan pour l'évaluation de l'IA et le tracing en production. Ses atouts sont clairs : les équipes peuvent tracer le comportement en production, exécuter des évaluations, comparer les prompts et les modèles, gérer des jeux de données et transformer les échecs réels en tests de régression. Pour les équipes d'ingénierie qui recherchent des workflows d'évaluation rigoureux, Braintrust reste une excellente option.
Néanmoins, les équipes évaluent les alternatives à Braintrust lorsque leurs besoins dépassent le cadre de la seule évaluation. Certaines recherchent des coûts réduits pour des volumes de trace élevés. D'autres exigent un auto-hébergement open-source. D'autres encore ont besoin d'une gouvernance à l'exécution qui applique l'accès aux modèles, le contrôle des coûts, les politiques d'agents, les autorisations MCP et la preuve d'audit avant même que le trafic de production n'atteigne les fournisseurs.
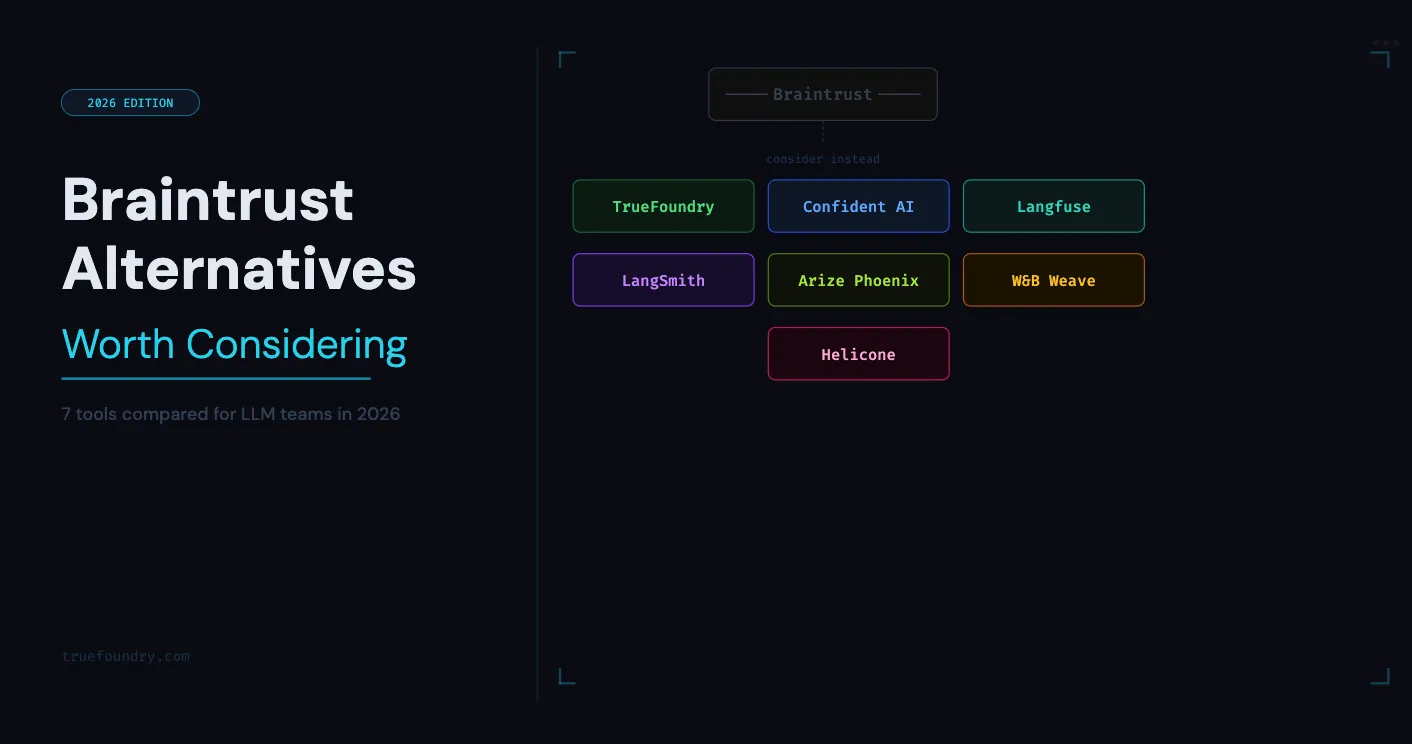
Ce guide compare sept concurrents de Braintrust en 2026, explique les forces de chaque outil et précise leurs limites respectives. L'objectif n'est pas d'affirmer que chaque équipe doit remplacer Braintrust, mais plutôt d'aider les équipes LLM à choisir la couche la plus adaptée au problème spécifique qu'elles cherchent à résoudre.
Avant de comparer les outils, définissez vos critères de sélection. Les alternatives à Braintrust ne sont pas interchangeables car chacune répond à une couche différente du cycle de vie des LLM. Une bonne alternative à Braintrust doit apporter la capacité manquante à votre modèle opérationnel actuel.
La couverture des langages et des intégrations est également déterminante. Les équipes doivent vérifier la prise en charge des workflows Python, TypeScript, Ruby et Java, en particulier lorsque le code applicatif s'étend sur plusieurs services. Une plateforme unique peut sembler attrayante jusqu'à ce que l'instrumentation, la couverture SDK et les méthodes de travail de l'équipe créent des frictions.
Les meilleures alternatives à Braintrust en 2026 se divisent en trois grandes catégories. Certaines se concentrent sur l'évaluation et la qualité des prompts. D'autres privilégient le tracing et l'observabilité. D'autres enfin ajoutent une gouvernance à l'exécution pour le trafic de production, les agents, les outils et les contrôles de coûts.
TrueFoundry est la meilleure alternative à Braintrust lorsque le besoin principal réside dans la gouvernance en production plutôt que dans l'évaluation hors ligne. La solution aborde la pile LLM depuis la couche d'infrastructure, où l'accès aux modèles, le routage, l'observabilité, les politiques d'agents, le contrôle des outils MCP et la gestion des coûts s'effectuent avant que le trafic de production n'atteigne les fournisseurs.
Contrairement aux outils d'évaluation pure, TrueFoundry aide les équipes à régir ce qui s'exécute en production. Sa passerelle AI Gateway centralise l'accès, les contrôles de politiques, la surveillance, le routage, le basculement, les limites de débit et les traces d'audit. Cela en fait une solution particulièrement pertinente lorsque l'évaluation est déjà en place, mais que la gouvernance à l'exécution reste fragmentée.
La tarification de TrueFoundry comprend un forfait Developer gratuit à 0 $ pour les créateurs débutants, un forfait Pro à 499 $ par mois, un forfait Pro Plus à 2 999 $ par mois, ainsi qu'un tarif Enterprise sur mesure. L'offre Enterprise est conçue pour des exigences accrues en matière de gouvernance, de sécurité, de flexibilité de déploiement et de fiabilité critique.
TrueFoundry est idéal pour les équipes d'infrastructure IA d'entreprise et les organisations réglementées gérant des programmes LLM multi-équipes. La plateforme est particulièrement adaptée lorsque des mécanismes d'évaluation existent déjà, mais que le contrôle des accès en production, de l'identité, des coûts et des audits demeure morcelé.
Confident AI est une excellente alternative à Braintrust pour les équipes souhaitant des workflows d'évaluation axés sur la qualité produit autour d'applications LLM réelles. Reposant sur DeepEval, le framework open-source d'évaluation de LLM, la solution y ajoute la collaboration, le tracing, le suivi, des tableaux de bord et des workflows d'équipe.
Confident AI convient particulièrement aux équipes nécessitant une évaluation approfondie et une participation élargie des équipes QA ou produit. La plateforme aide les groupes qui relient les tests avant mise en service à une surveillance de qualité en production.
Confident AI reste principalement une plateforme d'évaluation et de qualité. Les équipes ne doivent pas la considérer comme un plan de contrôle complet pour la gouvernance à l'exécution ou l'infrastructure IA sans valider directement leurs exigences en matière de déploiement, de contrôle d'accès et de politiques.
Langfuse figure parmi les alternatives open-source les plus solides à Braintrust pour les équipes qui recherchent l'observabilité LLM, le tracing, la gestion des prompts, les jeux de données et les workflows d'évaluation tout en conservant le contrôle de l'auto-hébergement. La plateforme attire également les équipes qui suivent les étoiles GitHub comme indicateur d'adoption par la communauté.
Langfuse est idéal pour les équipes plateforme qui recherchent la maîtrise de l'open-source, l'auto-hébergement et une large couverture en matière d'observabilité. Il convient parfaitement aux équipes qui préfèrent administrer leur propre pile d'observabilité.
L'auto-hébergement implique des compromis opérationnels réels. Les équipes doivent gérer elles-mêmes la montée en charge, les mises à jour, le stockage, le renforcement de la sécurité, la réponse aux incidents et la fiabilité à long terme de leur stack d'observabilité.


LangSmith constitue un concurrent très pratique à Braintrust pour les équipes qui développent déjà avec LangChain ou LangGraph. La plateforme réduit la complexité d'instrumentation et offre aux développeurs le tracing, le débogage, la gestion des jeux de données, les évaluations et la surveillance directement dans l'écosystème LangChain.
LangSmith s'adresse en priorité aux équipes qui s'appuient fortement sur LangChain ou LangGraph. Il convient aux développeurs qui recherchent une intégration simple et des workflows de débogage performants.
LangSmith s'avère moins attractif pour les équipes qui privilégient une observabilité agnostique vis-à-vis des fournisseurs, l'auto-hébergement open-source ou la gouvernance au niveau de l'infrastructure sur des systèmes hors écosystème LangChain.
Arize Phoenix est une plateforme open-source d'observabilité et d'évaluation de l'IA. Elle est particulièrement adaptée aux équipes qui privilégient l'instrumentation basée sur OpenTelemetry, l'évaluation RAG, le débogage de la recherche d'information (retrieval), l'expérimentation et la résolution d'incidents.
Aux équipes disposant de compétences en ingénierie de plateforme qui recherchent des outils open-source d'observabilité et d'évaluation LLM, accompagnés de workflows robustes de tracing et d'expérimentation.
Même si Phoenix est très performant, une exploitation à grande échelle en entreprise peut nécessiter des développements complémentaires sur la plateforme ou un passage à l'offre commerciale d'Arize, selon vos exigences de sécurité, de charge et de support.
W&B Weave est une alternative logique à Braintrust pour les équipes qui utilisent déjà Weights & Biases pour le suivi d'expérimentations ML. La solution étend l'écosystème W&B à l'observabilité LLM, l'évaluation, le tracing et les workflows d'agents pour l'ensemble des systèmes d'IA en production.
W&B Weave convient idéalement aux équipes ML déjà standardisées sur W&B. Il s'adresse aussi aux équipes qui suivent des workflows de modèles soutenus par NVIDIA et des applications LLM au sein d'un même modèle opérationnel.
Weave exprime tout son potentiel lorsque W&B est déjà ancré dans le modèle opérationnel ML de l'équipe. Pour une évaluation LLM pure ou une observabilité auto-hébergée, des outils comme Langfuse, Phoenix ou Braintrust peuvent être plus simples à évaluer.

Helicone est une passerelle IA et une plateforme d'observabilité LLM légère. C'est une excellente option pour les équipes de développement qui recherchent une mise en place rapide, un routage compatible OpenAI, la répertoriation des requêtes, le suivi des coûts, la mise en cache et la limitation de débit, sans avoir à créer une instrumentation lourde en interne.
Helicone s'adresse en priorité aux startups et aux équipes d'ingénierie qui souhaitent mettre en place rapidement une observabilité LLM et un suivi des coûts. Il convient aux équipes qui cherchent à éviter un chantier lourd de mise en place d'infrastructure.
Helicone n'a pas été conçu à l'origine comme un banc d'essai d'évaluation hors ligne ni comme une plateforme globale de gouvernance de l'IA. Les entreprises soumises à des contraintes réglementaires doivent valider leurs besoins en gestion des identités, audits, contrôle des données et application des politiques avant d'en faire leur unique solution.
Le piège le plus fréquent dans cette catégorie consiste à penser que l'évaluation, l'observabilité et la gouvernance désignent la même chose. Bien qu'elles soient liées, ces notions restent distinctes. Cette nuance est essentielle lors de l'évaluation des alternatives à Braintrust pour des systèmes d'IA en production.
La question pratique n'est donc pas « Quel outil est le meilleur ? », mais plutôt « Quelle couche manque-t-il à notre modèle opérationnel LLM actuel ? ». Si le manque concerne l'accès unifié aux modèles et la gouvernance des requêtes, une passerelle LLM (LLM Gateway) sera bien plus pertinente qu'un banc d'évaluation supplémentaire.

Braintrust ne manque pas d'atouts. C'est une plateforme d'observabilité et d'évaluation IA très performante, et sa passerelle apporte un accès unifié aux modèles, la mise en cache, l'observabilité et la gestion multi-fournisseurs. Un comparatif rigoureux doit reconnaître les qualités de Braintrust avant d'aborder ses alternatives.
L'alternative idéale dépend de la couche qui vous manque. Si votre besoin prioritaire est l'auto-hébergement, Langfuse et Phoenix méritent toute votre attention. Si vous privilégiez la profondeur d'évaluation et les workflows de qualité pluridisciplinaires, Confident AI s'impose comme un choix sérieux. Si votre équipe utilise principalement LangChain, LangSmith représente l'option la plus simple à intégrer.
Pour les utilisateurs de W&B, Weave s'inscrira naturellement dans leurs usages. Si vous cherchez avant tout une observabilité légère via passerelle, Helicone s'avère très attrayant. Chacune de ces solutions constitue une alternative crédible à Braintrust dès lors que son fonctionnement répond directement à votre besoin.
Enfin, pour les équipes d'entreprise dont le besoin principal concerne la gouvernance en production, TrueFoundry constitue la solution la plus adaptée de ce comparatif. Elle a été conçue pour les organisations qui doivent encadrer l'accès aux modèles, les actions des agents, les outils MCP, les limites de coûts, l'observabilité et les preuves d'audit au travers d'une couche de contrôle d'infrastructure dédiée.
Cela ne signifie pas que TrueFoundry a vocation à remplacer tous vos workflows d'évaluation. Cela signifie que TrueFoundry peut compléter votre pile d'évaluation existante lorsque l'accès à la production, les coûts, l'identité et les contrôles d'audit nécessitent un encadrement renforcé. C'est toute la différence entre observer la qualité de l'IA et maîtriser ses risques.
Réservez une démonstration pour découvrir comment TrueFoundry sécurise et régit vos workloads d'IA avant qu'ils ne posent un risque en production.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception