October 12, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: October 7, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Requesty ofrece una pasarela de LLM unificada para acceder a cientos de modelos a través de una única API. Su política de precios públicos es sencilla. Los clientes que utilizan el modelo de pago por uso abonan un margen del 5 % sobre el gasto del modelo original. No existen cuotas estándar por puesto ni requisitos de compromiso mínimo. Los planes empresariales utilizan precios personalizados.
Este modelo es ideal para equipos que buscan una pasarela de IA gestionada con acceso a una amplia gama de modelos y una carga de trabajo de infraestructura mínima. Requesty incluye enrutamiento, almacenamiento en caché, conmutación por error, control de gastos y observabilidad para más de 600 modelos. Los equipos también pueden aportar sus propias claves de proveedor, caso en el que Requesty indica actualmente que el margen es del 0 %.
Por tanto, los compradores empresariales deben mirar más allá del porcentaje anunciado. El coste real de Requesty AI depende de la selección de modelos, el tráfico, los contratos con los proveedores, el volumen de salida y los reintentos de los agentes. Los requisitos de seguridad y las necesidades de despliegue privado también pueden influir en la decisión final sobre la plataforma.
Requesty ofrece tres vías de precios públicos. Su plan gratuito permite acceder a modelos con un límite de 200 solicitudes diarias y no requiere tarjeta de crédito. El acceso de pago por uso añade un 5 % a los precios de los modelos originales. Los precios empresariales dependen de los controles organizativos, los requisitos de soporte y las condiciones negociadas.
Una clave de API permite a las aplicaciones acceder a través del punto de conexión unificado. El uso de claves propias (BYOK) es importante para las empresas que han negociado tarifas con OpenAI, Anthropic u otros proveedores. Esto permite a los equipos mantener dichos contratos mientras utilizan la capa de enrutamiento y supervisión de Requesty.
Los siguientes ejemplos asumen un modelo con un coste de 10 $ por millón de tokens. También suponen que Requesty proporciona el acceso al modelo bajo su estructura de pago por uso del 5 %. Las cargas de trabajo con claves propias (BYOK) seguirían una economía de pasarela diferente, ya que Requesty indica actualmente un margen del 0 % en esos casos.
Escenario
Tokens mensuales
Gasto del proveedor
Comisión de Requesty del 5%
Total
Prototipo individual
5 M
50 $
2,50 $
52,50 $
Equipo de producto pequeño
50 M
500 $
25 $
525 $
Carga de trabajo de producción en crecimiento
500 M
5.000 $
250 $
5.250 $
Plataforma de agentes multiservicio
2,5 B
25.000 $
1.250 $
26.250 $
Carga de trabajo de gran empresa
10.000 millones
100.000 $
5.000 $
105.000 $
Estas cifras ilustran la estructura de precios, no el gasto esperado del cliente. Los costes reales de los modelos varían enormemente según el proveedor y el modelo. GPT, Gemini, Claude y Mistral también pueden tener precios diferentes para los tokens de entrada, salida y caché.
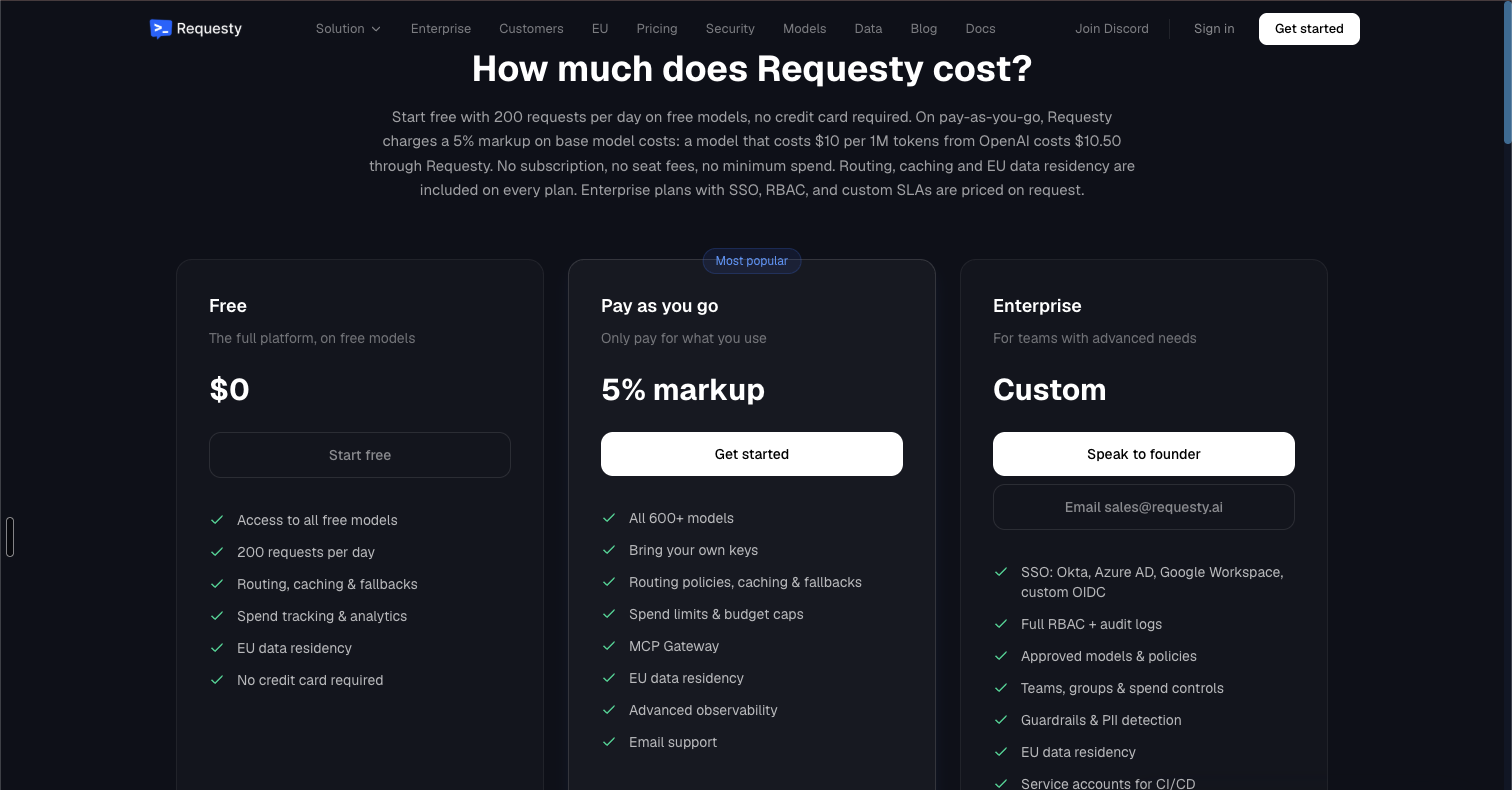
Texto alternativo: La página de precios de Requesty compara el uso gratuito y los planes de pasarela de pago
Esto hace que Requesty sea fácil de entender para equipos en etapas iniciales que buscan un acceso predecible de pago por uso. Fácil de empezar. Fácil de explicar al departamento financiero. Toda la página de precios cabe en una sola pantalla.
Área de precios
Qué ofrece Requesty
Qué deben comprobar los equipos
Precios estándar
Margen del 5 % sobre los costes del modelo base
Combinación real de proveedores y modelos
Cuotas de suscripción
No se indica ninguna suscripción
El plan Enterprise puede variar
Tarifas por puesto
No se indican tarifas por puesto
Necesidades del equipo y administración
Gasto mínimo
Sin gasto mínimo establecido
Compromisos de volumen si se negocian
Precios para empresas
Precios personalizados
SSO, RBAC, SLA y soporte
Requesty se posiciona como una pasarela gestionada para modelos de lenguaje de gran tamaño. La plataforma abarca el acceso a modelos, fiabilidad, control de costes, almacenamiento en caché y monitorización. Es compatible con OpenAI, Anthropic, Google, AWS Bedrock, Gemini, Mistral y otros proveedores a través de una única interfaz.
La capa de pasarela incluye varias capacidades más allá del acceso a modelos:
Requesty también publica datos operativos a nivel de proveedor que abarcan tasas de éxito, adopción de streaming y comportamiento de caché. Estas diferencias demuestran por qué la elección del modelo por sí sola no determina el rendimiento en producción. La fiabilidad del proveedor puede afectar significativamente a las decisiones de enrutamiento.
Requesty enruta el tráfico a través de una interfaz compatible con OpenAI. Las integraciones existentes con el SDK de OpenAI pueden cambiarse modificando la URL base y las credenciales de Requesty. Este mismo patrón funciona en varias herramientas y marcos de desarrollo comunes.
Si ya utilizas el SDK de OpenAI, solo tienes que apuntar al endpoint del router en router.requesty.ai y cambiar la cadena del modelo:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["REQUESTY_API_KEY"],
base_url="https://router.requesty.ai/v1",
)
response = client.chat.completions.create(
model="openai/gpt-4o",
messages=[{"role": "user", "content": "Summarize this incident report."}],
)
Los modelos siguen una sintaxis de proveedor/nombre-del-modelo, y también puedes hacer referencia a políticas de enrutamiento con política/nombre-de-la-política para que la pasarela elija el modelo por ti.
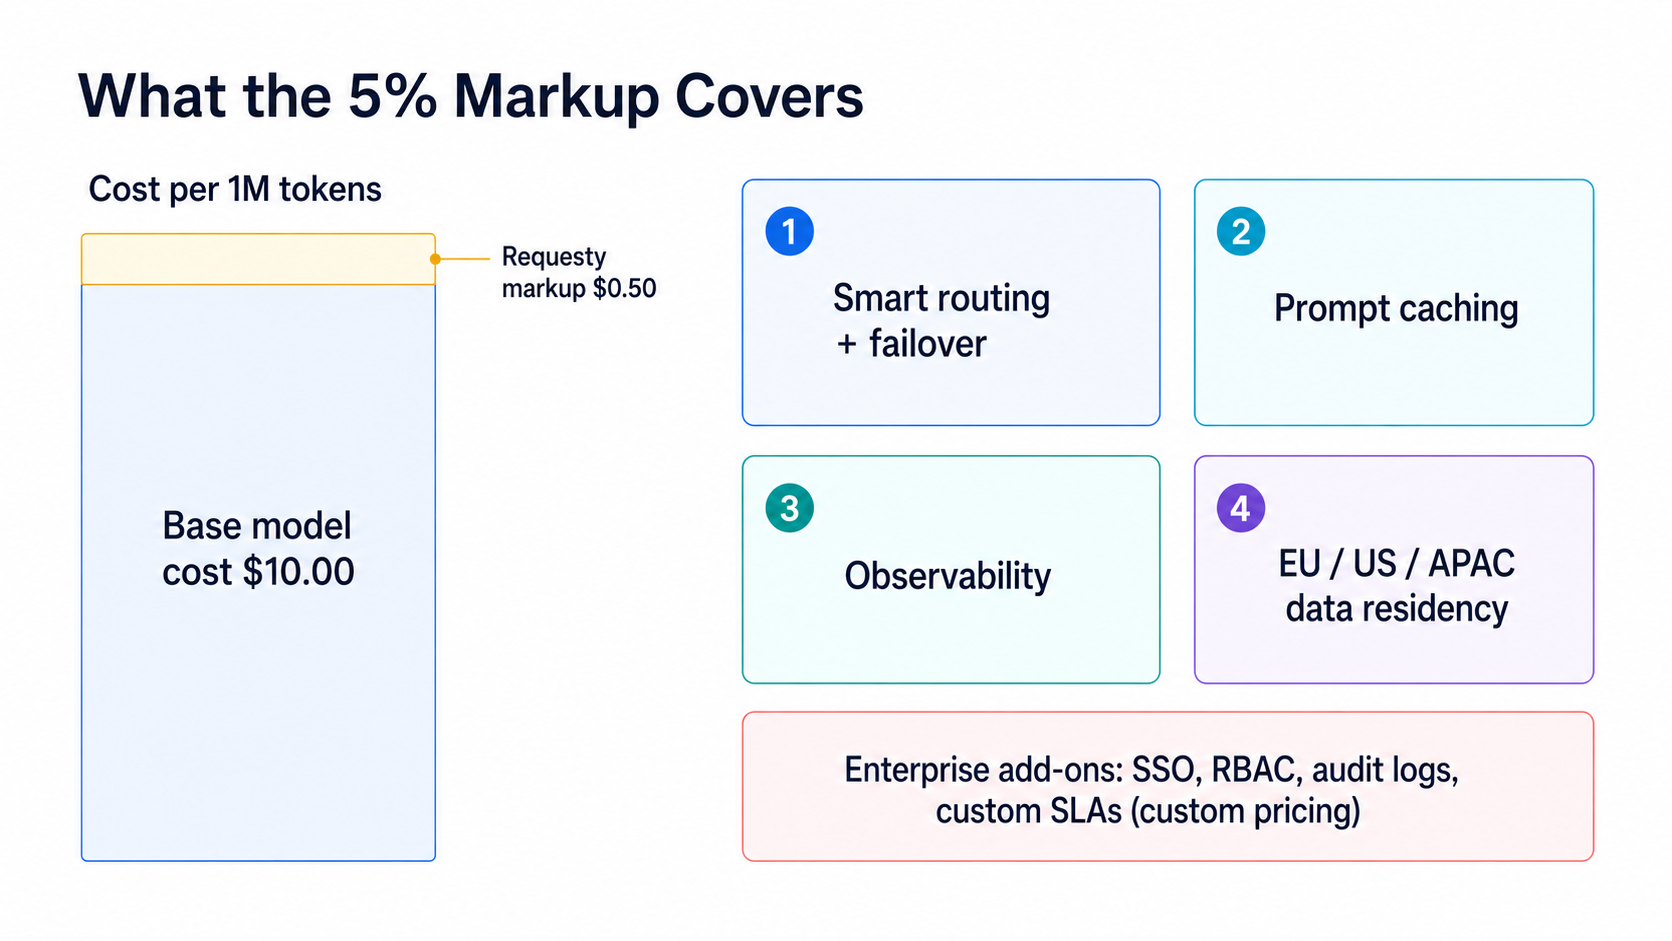
Figura 1: El margen del 5% cubre la capa de pasarela alojada, no solo el acceso al modelo
Texto alternativo: La tarifa de la pasarela Requesty incluye enrutamiento, almacenamiento en caché, supervisión y conmutación por error
El porcentaje en sí es sencillo, pero el tráfico de producción rara vez lo es. Los equipos financieros deben estimar el volumen de solicitudes, el tamaño del contexto, las salidas, los reintentos, el enrutamiento y la selección de proveedores. El almacenamiento en caché también modifica el gasto efectivo cuando el contenido repetido pasa a ser apto para un descuento por caché.
Las cargas de trabajo de los agentes dificultan la previsión, ya que una sola acción del usuario puede activar múltiples llamadas al modelo. Un enrutador también puede cambiar de modelo tras errores o problemas de capacidad. Por tanto, las diferentes políticas de reserva pueden alterar tanto la fiabilidad como el gasto total.
Para ilustrarlo de forma sencilla, consideremos 2500 millones de tokens mensuales en un modelo de 10 dólares por millón. El gasto del proveedor asciende a 25 000 dólares. Una tarifa de pago por uso del 5% de Requesty añade 1250 dólares. Ese cálculo cambia con BYOK, ya que Requesty indica actualmente que tus propias claves de proveedor no conllevan margen de beneficio.
La lección más amplia es que la fijación de precios por porcentaje sigue el gasto del proveedor. Los equipos deberían modelar los patrones de uso para sus facturas en lugar de confiar en los precios medios de los tokens. La guía de TrueFoundry sobre optimización de costes de LLM explica cómo el enrutamiento, el almacenamiento en caché, los presupuestos y la atribución afectan al gasto en IA en producción.
Factor de coste
Por qué es importante
Selección de modelo
Los modelos de vanguardia pueden aumentar el coste por solicitud
Longitud de salida
Las respuestas más largas aumentan el consumo de tokens
Reintentos del agente
Los flujos de trabajo de varios pasos pueden multiplicar la inferencia
Tasa de aciertos de caché
Un menor número de aciertos reduce el ahorro por caché
Selección de ruta
Los proveedores pueden tener precios diferentes
Controles empresariales
Los requisitos avanzados pueden modificar los precios del contrato
La elaboración de presupuestos también debe tener en cuenta las alertas, los límites de gasto y el comportamiento de aplicación de políticas. Requesty admite límites presupuestarios y cortes automáticos. Esta distinción es importante porque supervisar el gasto y detener el gasto resuelven necesidades operativas diferentes.
Requesty y TrueFoundry utilizan modelos de precios diferentes. Requesty aplica un recargo del 5 % sobre los costes de los modelos ascendentes para el tráfico estándar de pago por uso. TrueFoundry utiliza precios basados en planes, empezando por un nivel gratuito para desarrolladores. Sus planes de precios luego escalan según el volumen de solicitudes y los requisitos de la plataforma.
La diferencia cobra mayor importancia a medida que aumenta el uso. Los costes de Requesty aumentan con el gasto en proveedores, por lo que los modelos caros o las salidas más largas incrementan las tarifas de la pasarela. Los precios de TrueFoundry, en cambio, se basan en las asignaciones de solicitudes. Esto puede facilitar la previsión de los costes de gobernanza cuando el gasto en modelos aumenta más rápido que el número de solicitudes.
Área de precios
Requesty AI
TrueFoundry
Precio de entrada
Nivel gratuito disponible
El plan para desarrolladores comienza en 0 $/mes
Precios estándar
Margen del 5 % sobre el coste del proveedor
Pro desde 499 $/mes
Controles avanzados
Precios personalizados para empresas
Pro Plus por 2999 $/mes
Precios para empresas
Personalizado
Personalizado
Base de facturación
Porcentaje del gasto en modelos
Asignaciones del plan basadas en solicitudes
Despliegue
Nube gestionada
SaaS, VPC, local (on-premises), aislado (air-gapped)
El despliegue supone una segunda diferencia. Requesty sigue siendo un servicio en la nube gestionado, mientras que TrueFoundryAI Gateway también puede ejecutarse dentro de la infraestructura de la empresa. Esto es importante cuando los prompts, los registros o los controles de gobernanza deben permanecer dentro de los límites de seguridad aprobados.
Ninguno de los dos modelos de precios es automáticamente más barato. Los precios basados en porcentajes pueden funcionar bien para cargas de trabajo pequeñas o variables. Los planes basados en solicitudes pueden resultar más predecibles a medida que aumenta el uso en producción.
Los equipos que comparen otras pasarelas alojadas también pueden consultar el análisis de precios de OpenRouter de TrueFoundry análisis de precios de OpenRouter para ver otro modelo basado en el uso. El Guía de precios de LiteLLM ofrece una comparativa útil para los equipos que consideran una infraestructura de pasarela de código abierto.
La decisión final debe tener en cuenta los precios de Requesty AI, el uso de modelos, las necesidades de despliegue y el nivel de gobernanza requerido en producción.

Figura 2: La diferencia de precio es, en realidad, una diferencia de despliegue: pasarela alojada frente a una pasarela que se ejecuta dentro de su propio perímetro.
Texto alternativo: Requesty y TrueFoundry se diferencian principalmente por los límites de despliegue empresarial
Requesty funciona bien cuando los equipos necesitan elegir modelos sin tener que gestionar la infraestructura de la pasarela. Su servicio gestionado reduce el trabajo de configuración a la vez que proporciona enrutamiento inteligente, conmutación por error, supervisión y controles presupuestarios. Esto puede convertirlo en la mejor alternativa a la integración directa con proveedores para ciertas cargas de trabajo en etapas iniciales.
Requesty es una buena opción cuando:
Pensemos en un equipo de producto que gasta 500 dólares al mes en proveedores a través de la clave unificada de Requesty. La tarifa de la pasarela añadiría aproximadamente 25 dólares bajo la estructura actual del 5%. Construir internamente un sistema equivalente de enrutamiento y supervisión rara vez tendría sentido a esa escala.
El panorama cambia a medida que el tráfico se distribuye entre varios equipos y flujos de trabajo de agentes. Los entornos más grandes pueden requerir controles de configuración más sólidos, metadatos detallados, redes privadas y políticas de identidad consolidadas. Esos requisitos suelen ser más importantes que la propia tarifa porcentual.
BANNER CRO:
Título: Lleve la gobernanza de la IA más allá del enrutamiento de modelos alojados
Subtexto: Controla modelos, herramientas, agentes, presupuestos y políticas desde una única puerta de enlace
CTA: Empezar
Texto alternativo: TrueFoundry centraliza la gobernanza de IA empresarial más allá del enrutamiento de modelos alojados
Enlace:https://www.truefoundry.com/book-demo?ref=requesty_ai_pricing
El precio de Requesty AI puede seguir siendo atractivo incluso cuando los requisitos arquitectónicos superan su modelo de despliegue. Requesty está totalmente gestionado y actualmente no ofrece alojamiento propio (self-hosting). Los equipos empresariales pueden utilizar la residencia de datos en la UE a través de Frankfurt y seleccionar puntos de conexión regionales para los modelos cuando estén disponibles.
Su política de retención de datos también requiere una lectura atenta. El registro de autoservicio está activado por defecto y puede conservar el contenido de los prompts hasta 30 días. Los equipos pueden desactivar el registro de contenido por clave. La retención cero a nivel de toda la organización está disponible bajo solicitud por escrito.
Requesty declara actualmente que su programa SOC 2 Tipo II sigue en curso. Su página de seguridad indica que la finalización está prevista para el tercer trimestre de 2026. Los equipos de compras empresariales deben verificar el estado actual de la certificación directamente antes de confiar en ella para el cumplimiento normativo.
Los equipos empresariales deberían preguntarse:
Las mismas preguntas se aplican cuando una aplicación de chat se convierte en un flujo de trabajo autónomo. Los agentes pueden llamar a modelos repetidamente e invocar sistemas internos. El requisito de control va entonces más allá de la selección del modelo y se centra en la identidad, las herramientas, los costes y la política de ejecución.
Para las empresas que buscan la siguiente mejor opción más allá del enrutamiento de modelos gestionados, TrueFoundry aborda una gama más amplia de necesidades de infraestructura. Su AI Gateway centraliza el acceso a modelos, el enrutamiento, las barreras de seguridad, el control de costes y la observabilidad. La misma plataforma puede ejecutarse como SaaS o dentro de entornos empresariales privados.
TrueFoundry también es compatible con proveedores como OpenAI, Anthropic, Google y modelos alojados internamente a través de una única interfaz. Los equipos pueden realizar un seguimiento de la latencia, los costes, los errores y la analítica a nivel de solicitud en todo el tráfico de producción compartido. Las políticas pueden utilizar metadatos personalizados para la atribución por equipo, cliente, proyecto o entorno.
Tres controles cobran importancia a medida que las cargas de trabajo se expanden:
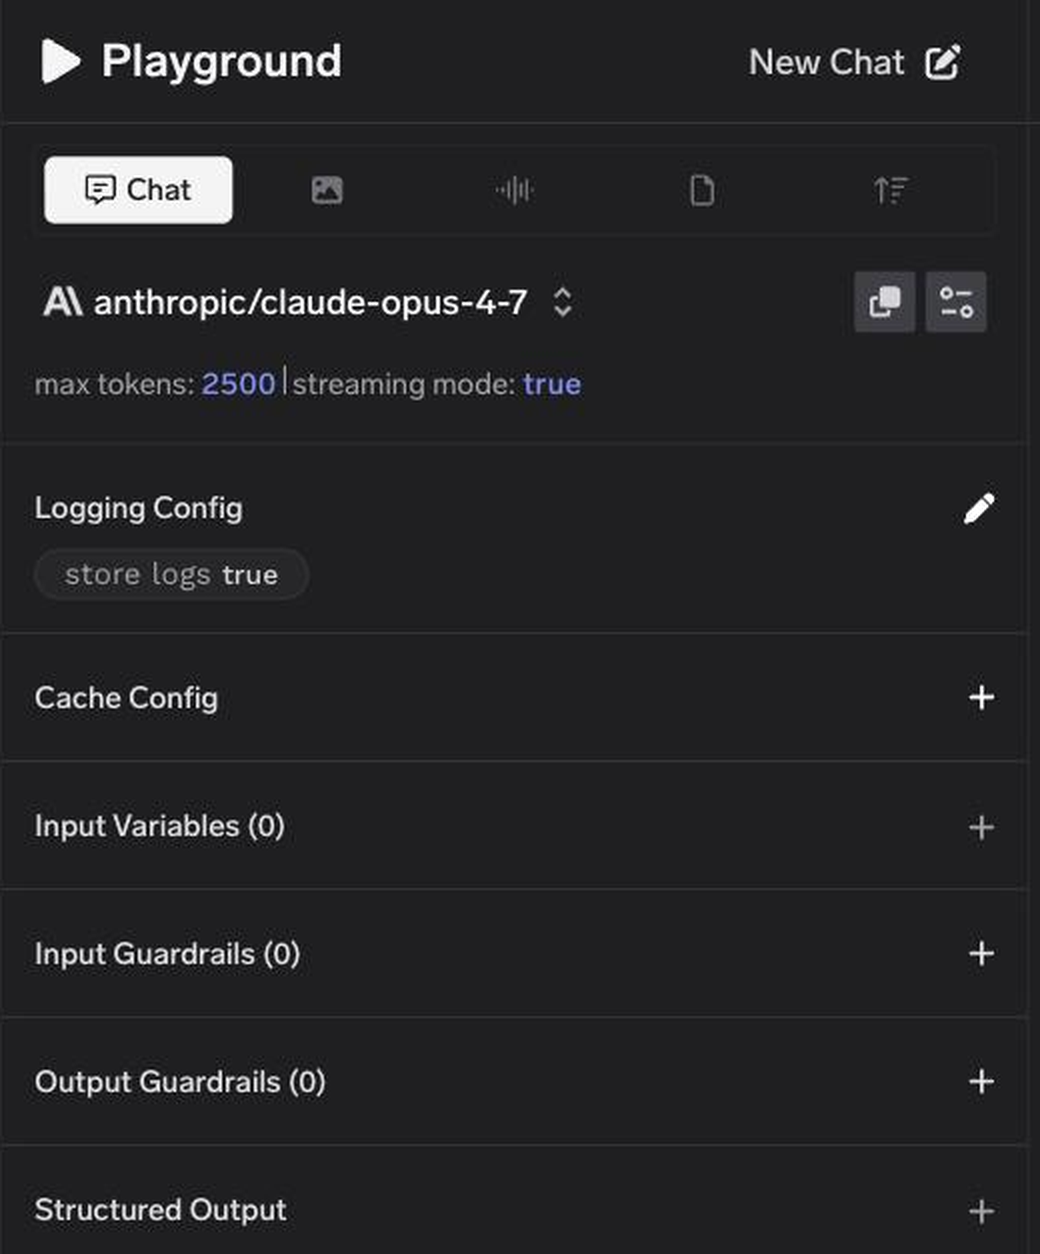
Consola de puerta de enlace de TrueFoundry que muestra los controles que se aplican a una única llamada de modelo: registro activado, con caché, barreras de seguridad de entrada y salida, y ranuras de salida estructurada en la misma solicitud.
Texto alternativo: Controles por llamada de la pasarela de IA de TrueFoundry para registro, almacenamiento en caché y barreras de seguridad
TrueFoundry también utiliza una interfaz compatible con OpenAI, por lo que su adopción no requiere un nuevo SDK. Las aplicaciones existentes pueden dirigir sus URL a la pasarela manteniendo los formatos de solicitud habituales. El punto de conexión seleccionado puede representar el SaaS de TrueFoundry o un entorno empresarial privado.
from openai import OpenAI
client = OpenAI(
api_key="tu_clave_api_de_truefoundry",
base_url="https://gateway.truefoundry.ai", # o tu propio punto de conexión VPC
)
Los controles de costes operan en la ruta de solicitud. Los equipos pueden definir cuotas basadas en costes o en tokens por usuario, servicio, modelo o flujo de trabajo. La pasarela puede entonces limitar, degradar o bloquear la actividad según la política establecida.
Esta estructura resulta útil cuando el código de la aplicación debe permanecer independiente de la lógica del proveedor. También hace que la conmutación por error automática, el enrutamiento y los presupuestos sean coherentes en todas las cargas de trabajo, en lugar de implementar cada regla por separado.

Figura 3: El límite de despliegue y el alcance de la gobernanza determinan esto, no el marcado.
Requesty resuelve bien el acceso gestionado a múltiples proveedores. TrueFoundry sirve a empresas que necesitan una pasarela, tráfico de modelos, herramientas MCP y agentes bajo una única capa de infraestructura gobernada.
Para las empresas que comparan los precios totales de Requesty AI frente a los requisitos de gobernanza, los límites de despliegue pueden ser, en última instancia, más determinantes que las tarifas brutas de los modelos.
Reserva una demostración con TrueFoundry para evaluar sus requisitos de enrutamiento de modelos, gobernanza de agentes, despliegue y control de costes.
Requesty aplica un recargo del 5 % sobre los costes de los modelos originales para el acceso estándar de pago por uso. No existen tarifas por puesto ni requisitos de gasto mínimo. El plan gratuito incluye 200 solicitudes diarias. Actualmente, Requesty indica que el tráfico BYOK (trae tu propia clave) no tiene recargo, mientras que los planes Enterprise utilizan precios personalizados para ofrecer controles y soporte avanzados.
El acceso directo al proveedor evita el recargo del 5 % por pago por uso de Requesty. Esta tarifa cubre el enrutamiento gestionado, las alternativas de respaldo, el almacenamiento en caché, la monitorización, los presupuestos y el acceso unificado a modelos. El modelo BYOK cambia la comparativa, ya que Requesty actualmente no aplica recargos cuando los clientes utilizan sus propias claves de proveedor. Por tanto, al comparar, se debe tener en cuenta el esfuerzo de ingeniería y los requisitos operativos, además del precio bruto de los tokens.
La elección del modelo suele ser el factor que genera mayor variación, ya que los precios de entrada y salida difieren sustancialmente. La longitud de la respuesta, los reintentos, la selección de rutas y el rendimiento de la caché también influyen en el gasto total. Los requisitos empresariales pueden añadir precios personalizados para SSO, RBAC, registros de auditoría, medidas de seguridad y soporte. El modelo BYOK puede alterar aún más la rentabilidad para aquellas empresas que ya cuentan con acuerdos negociados con proveedores.
Requesty ofrece SSO empresarial, RBAC, registros de auditoría, políticas de modelos, controles de gasto, medidas de seguridad y residencia de datos en la UE. La plataforma es totalmente gestionada y actualmente no admite el autohospedaje. Su certificación SOC 2 Tipo II también figura como en proceso. Por ello, las empresas deben comparar sus controles con sus requisitos internos de despliegue, residencia de datos y cumplimiento normativo.
TrueFoundry es una alternativa sólida cuando las empresas requieren una solución SaaS que, además, ofrezca opciones de despliegue en VPC, local (on-premises) o en entornos aislados (air-gapped). Su AI Gateway gestiona el acceso a modelos, el enrutamiento, los presupuestos y las medidas de seguridad. Los gateways de MCP y agentes amplían estos controles a las herramientas empresariales y a los flujos de trabajo autónomos. Este alcance más amplio resulta ideal para equipos cuyos requisitos de infraestructura van más allá del simple enrutamiento de modelos alojados.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada