



noviembre 19, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Actualizado: noviembre 19, 2026
Published: noviembre 19, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Bifrost aparece en casi todas las listas de selección de «AI gateway» en 2026, generalmente junto a las palabras más rápido y código abierto. Ninguna de las dos afirmaciones resiste una lectura directa de las propias cifras del proveedor, por lo que lo comprobamos por la vía difícil: lo analizamos nosotros mismos en un entorno restringido de 1 vCPU.
Este artículo cubre qué promesas de rendimiento de Bifrost se sostienen bajo una medición real, en un entorno de prueba fijo de 1 vCPU / 2 GB, el mismo estándar con el que evaluamos a cada gateway en esta comparación.
Esta es la sección a la que debe responder cualquier afirmación de «gateway más rápido».
La cifra del proveedor: ~5.000 RPS con un sobrecoste medio de ~11 microsegundos —en una t3.xlarge (4 vCPU), contra un upstream simulado (mocked). Antes de comparar eso con cualquier otra cosa, lee lo que mide realmente. Según la propia fuente de Bifrost, la cifra en microsegundos se toma sin la gestión de peticiones HTTP ni la conversión (marshalling) de JSON, por lo que es tiempo transcurrido dentro del pipeline interno del gateway, no latencia neta añadida a la petición de un cliente. La misma fuente la sitúa en 59 µs en una t3.medium, por lo que ya se degrada aproximadamente 5 veces en una máquina más pequeña. También es una media, no un percentil, en 4 veces el cómputo que la mayoría de los equipos asignan a un contenedor de gateway.
Nada de eso hace que la cifra sea deshonesta; simplemente responde a una pregunta diferente a «¿cómo se ve mi p99?». Todo lo que se muestra a continuación es la otra cifra: latencia añadida de extremo a extremo para tamaños de carga reales y documentados, con marshalling y HTTP incluidos, el coste total que paga un cliente por tener el gateway en la ruta. Los microsegundos y los milisegundos son verdaderos aquí, porque están midiendo cosas diferentes.
Construimos un entorno de prueba fijo —1 vCPU, 2 GB de RAM, carga en bucle abierto, el mismo estándar con el que evaluamos a cada gateway en esta comparación— y medimos Bifrost directamente en tres tamaños de carga de pago (payload): pequeño (200 tokens de entrada / 100 de salida), mediano (2.000/500) y grande (20.000/1.000). El upstream simulado detrás de Bifrost también se fijó, por lo que cualquier ralentización es de Bifrost, no un doble de prueba inestable: 50 ms de tiempo de «pensamiento» + 50 ms al primer token para llamadas sin streaming, y una duración fija de streaming de 500 ms para llamadas con streaming; esos son los límites mínimos de ~55 ms y ~530–627 ms que verás en los gráficos a continuación, presentes en cada tamaño de carga.
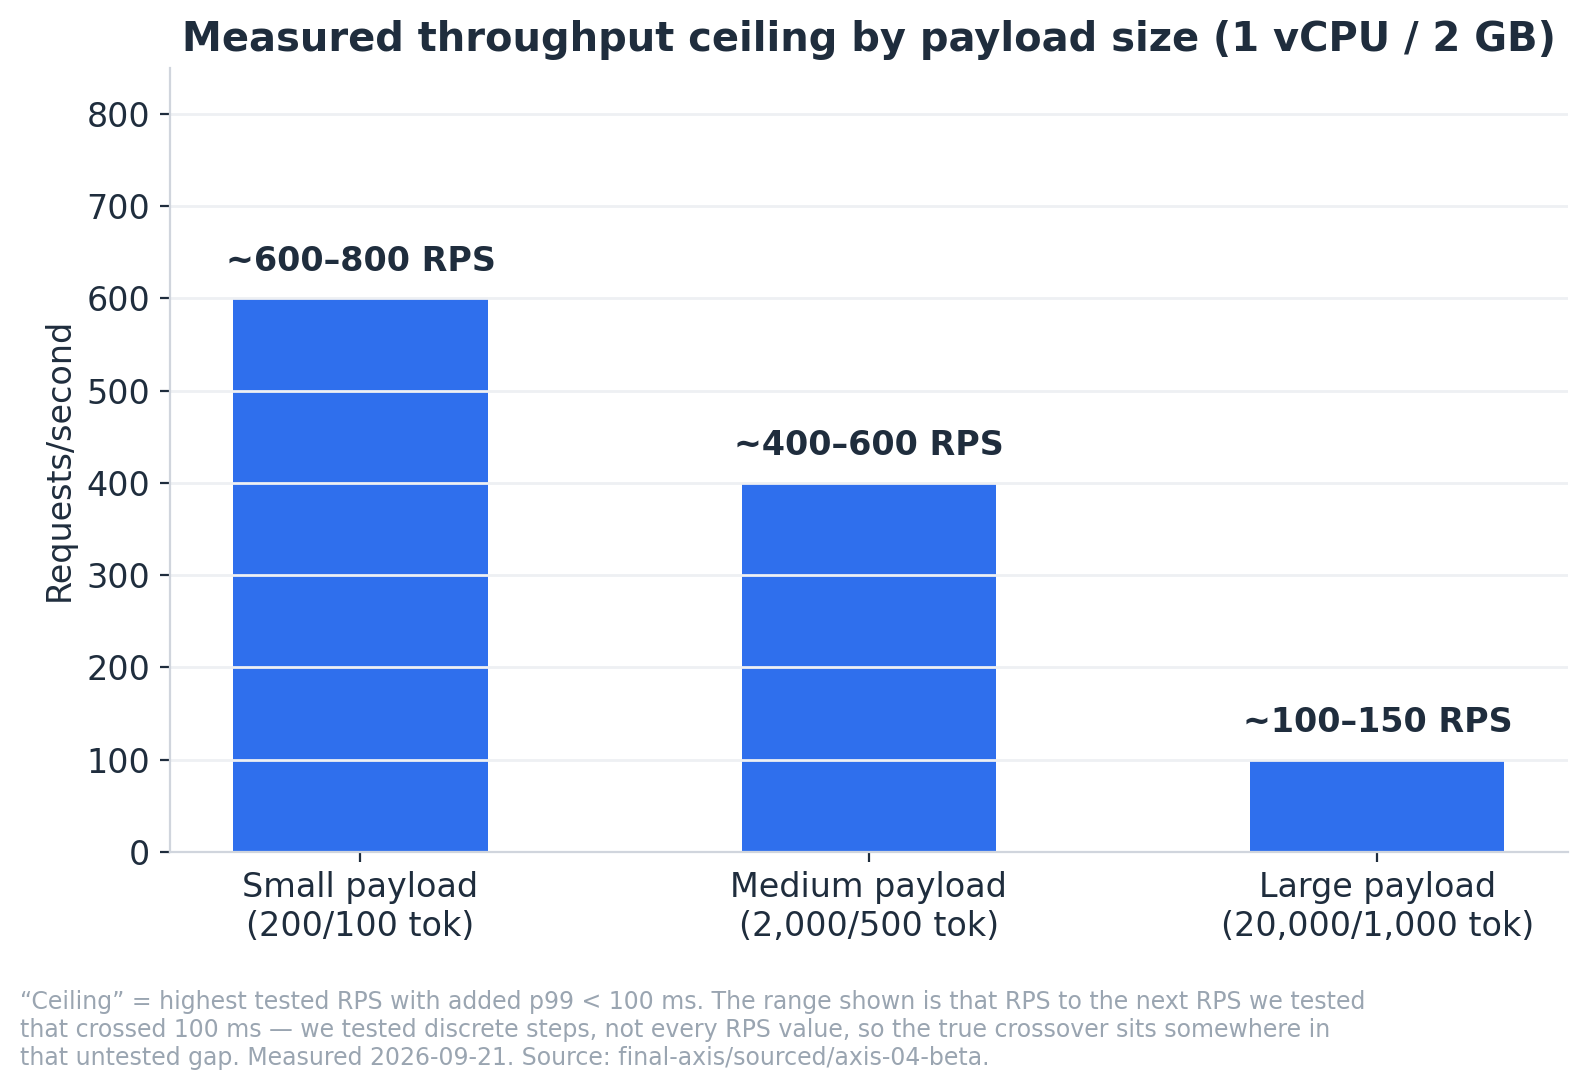
Límites reales de procesamiento, con un margen de latencia añadida de 100 ms: ~600–800 RPS para cargas pequeñas, ~400–600 para medianas, ~100–150 para grandes. Son rangos, no números exactos, a propósito: probamos pasos discretos de RPS, no cada valor, por lo que cada límite es realmente «el último RPS que confirmamos que estaba bien, hasta el siguiente que confirmamos que no lo estaba». Por debajo del extremo inferior de esos rangos, la petición mediana paga de 2 a 6 ms por el gateway. Esa mediana es la cifra más amigable de esta sección y la menos útil para la planificación de capacidad: apenas varía con la carga (de 2,1 a 3,1 ms para cargas pequeñas en un rango de tráfico ofrecido de 60x), por lo que se mantiene tranquilizadora hasta el momento en que el gateway falla. La cifra que realmente varía es el p99. El p99 añadido pasa de +5,6 ms (pequeña), +7,5 ms (mediana) y +15,2 ms (grande) a 10 RPS a +60 ms para pequeña a 600 RPS, +75 ms para mediana a 400, y +41 ms para grande a solo 100, y luego supera el presupuesto de 100 ms en el siguiente paso que probamos en los tres casos. Por encima del extremo superior, ninguno de los tres tamaños de carga se degrada de forma gradual, y cada uno falla de manera diferente. Aquí está cada carga de pago lado a lado, el gateway frente a su propia medición directa al mock real (no una única línea base aproximada compartida entre tamaños; pequeña, mediana y grande tienen un límite mínimo directo genuinamente diferente de ~55–62 ms, y el gráfico muestra la cifra real para cada una):
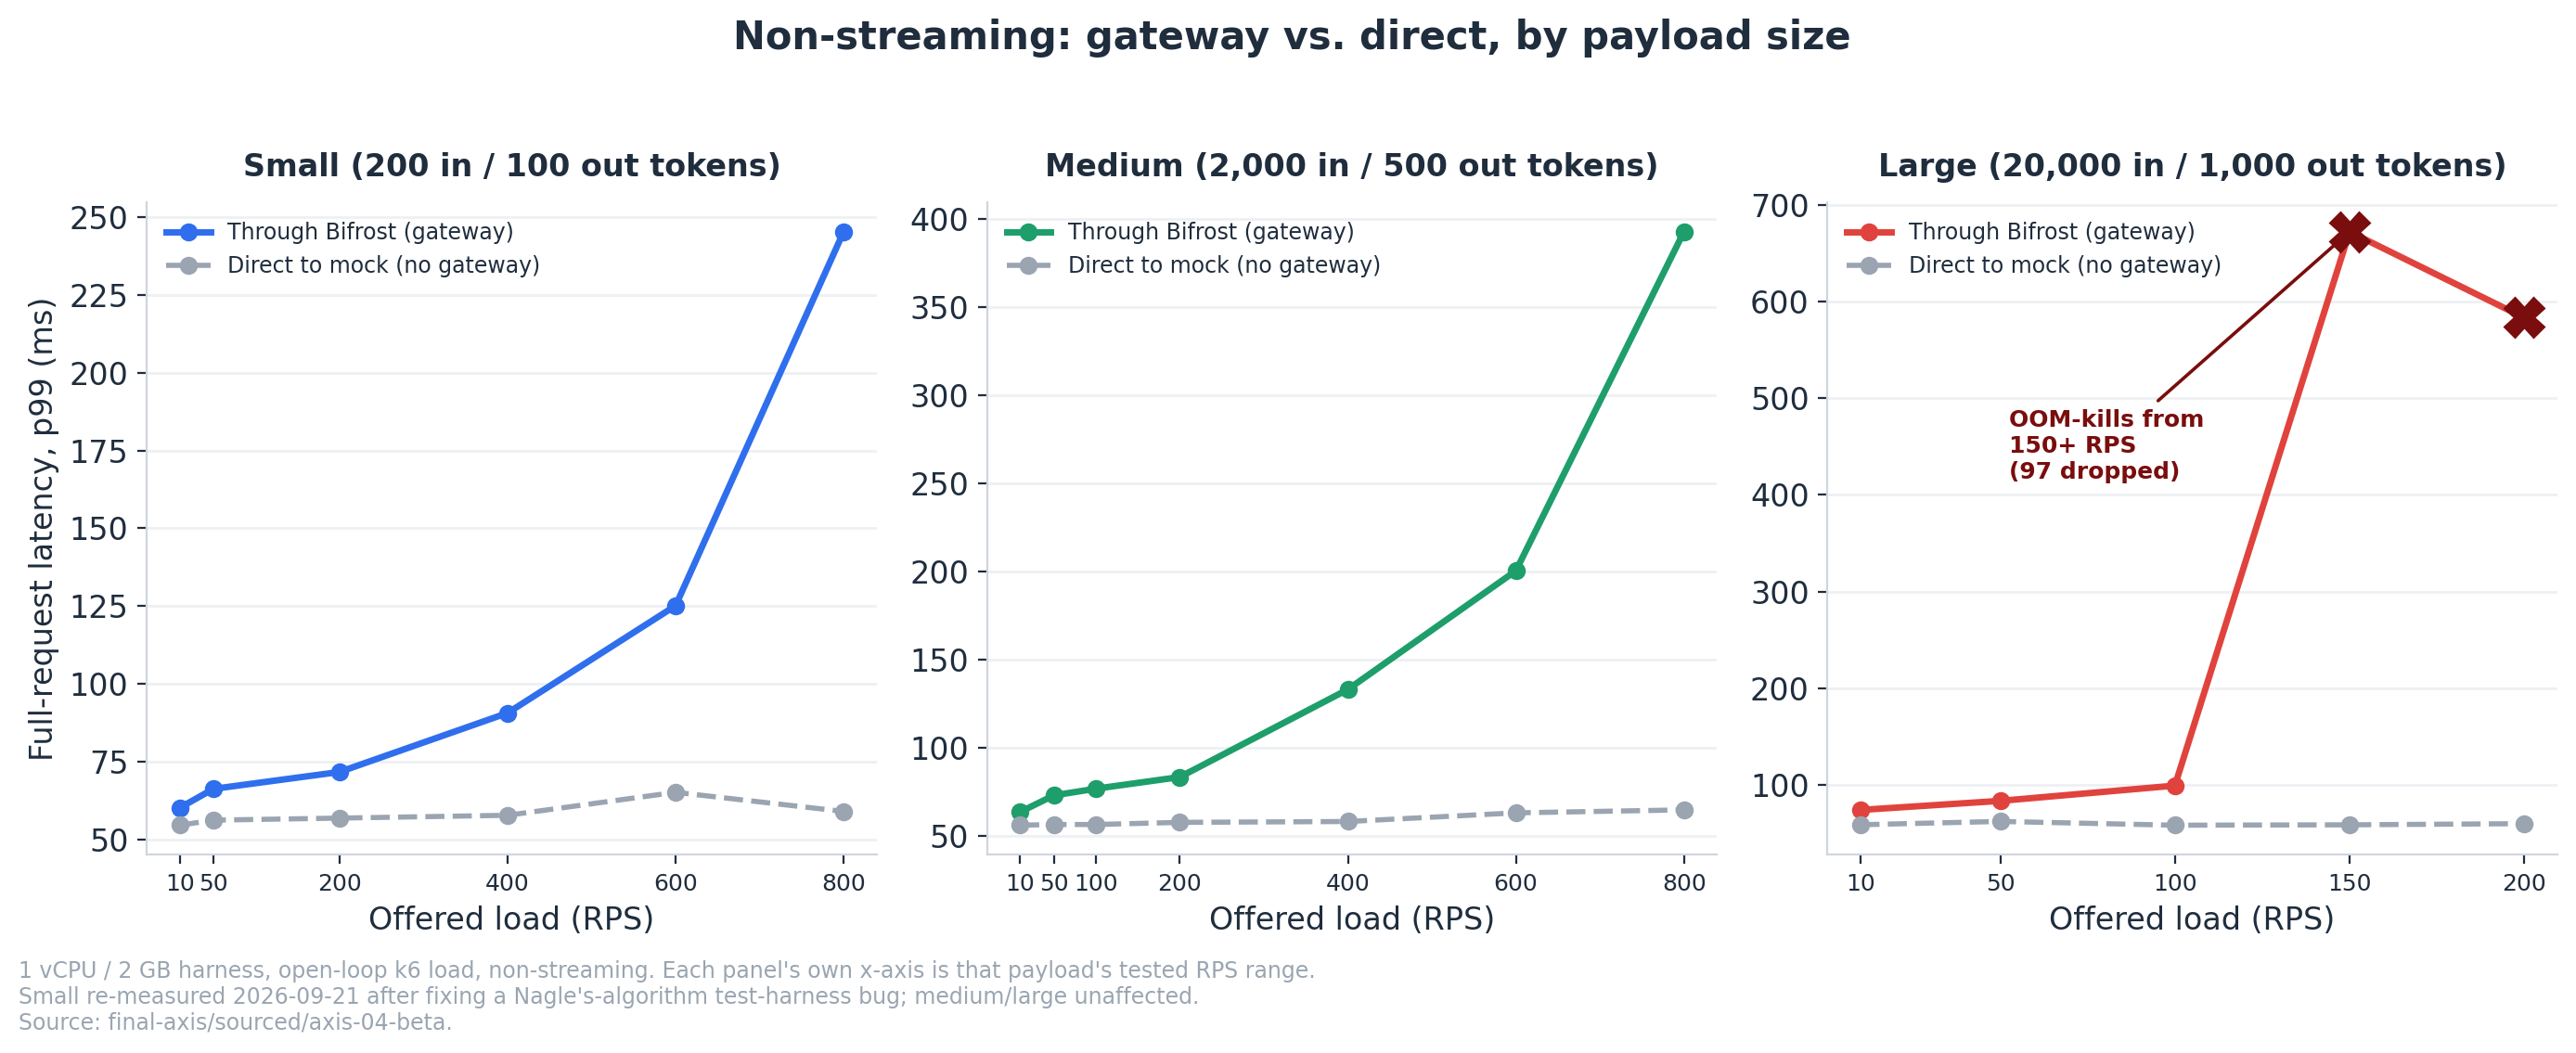
Las cargas pequeñas y medianas siguen la misma forma (plana, luego una cola p99 ascendente), solo que a diferentes RPS. El ascenso de la pequeña comienza alrededor de 400–600 RPS; el de la mediana empieza antes por petición, pero su muro más duro está más alejado (400+ RPS) porque su entrada de 2.000 tokens mantiene un coste por petición más alto en todo momento. La grande no asciende de forma gradual en absoluto: es plana de 10 a 100 RPS, luego cae en picado a 150 RPS, donde el pod empieza a ser eliminado por falta de memoria (OOM-killed) a mitad de la ejecución (61 peticiones caídas a 150 RPS, 97 más a 200). Eso no es un cuello de botella por cola de espera como en la pequeña/mediana: es un muro de recursos duro, y se muestra como un salto casi vertical en lugar de una curva.
El streaming alcanza el mismo muro, solo que más rápido, porque cada stream abierto mantiene sus búferes en memoria durante más tiempo; mismo tratamiento, gateway vs. directo, por carga de pago:
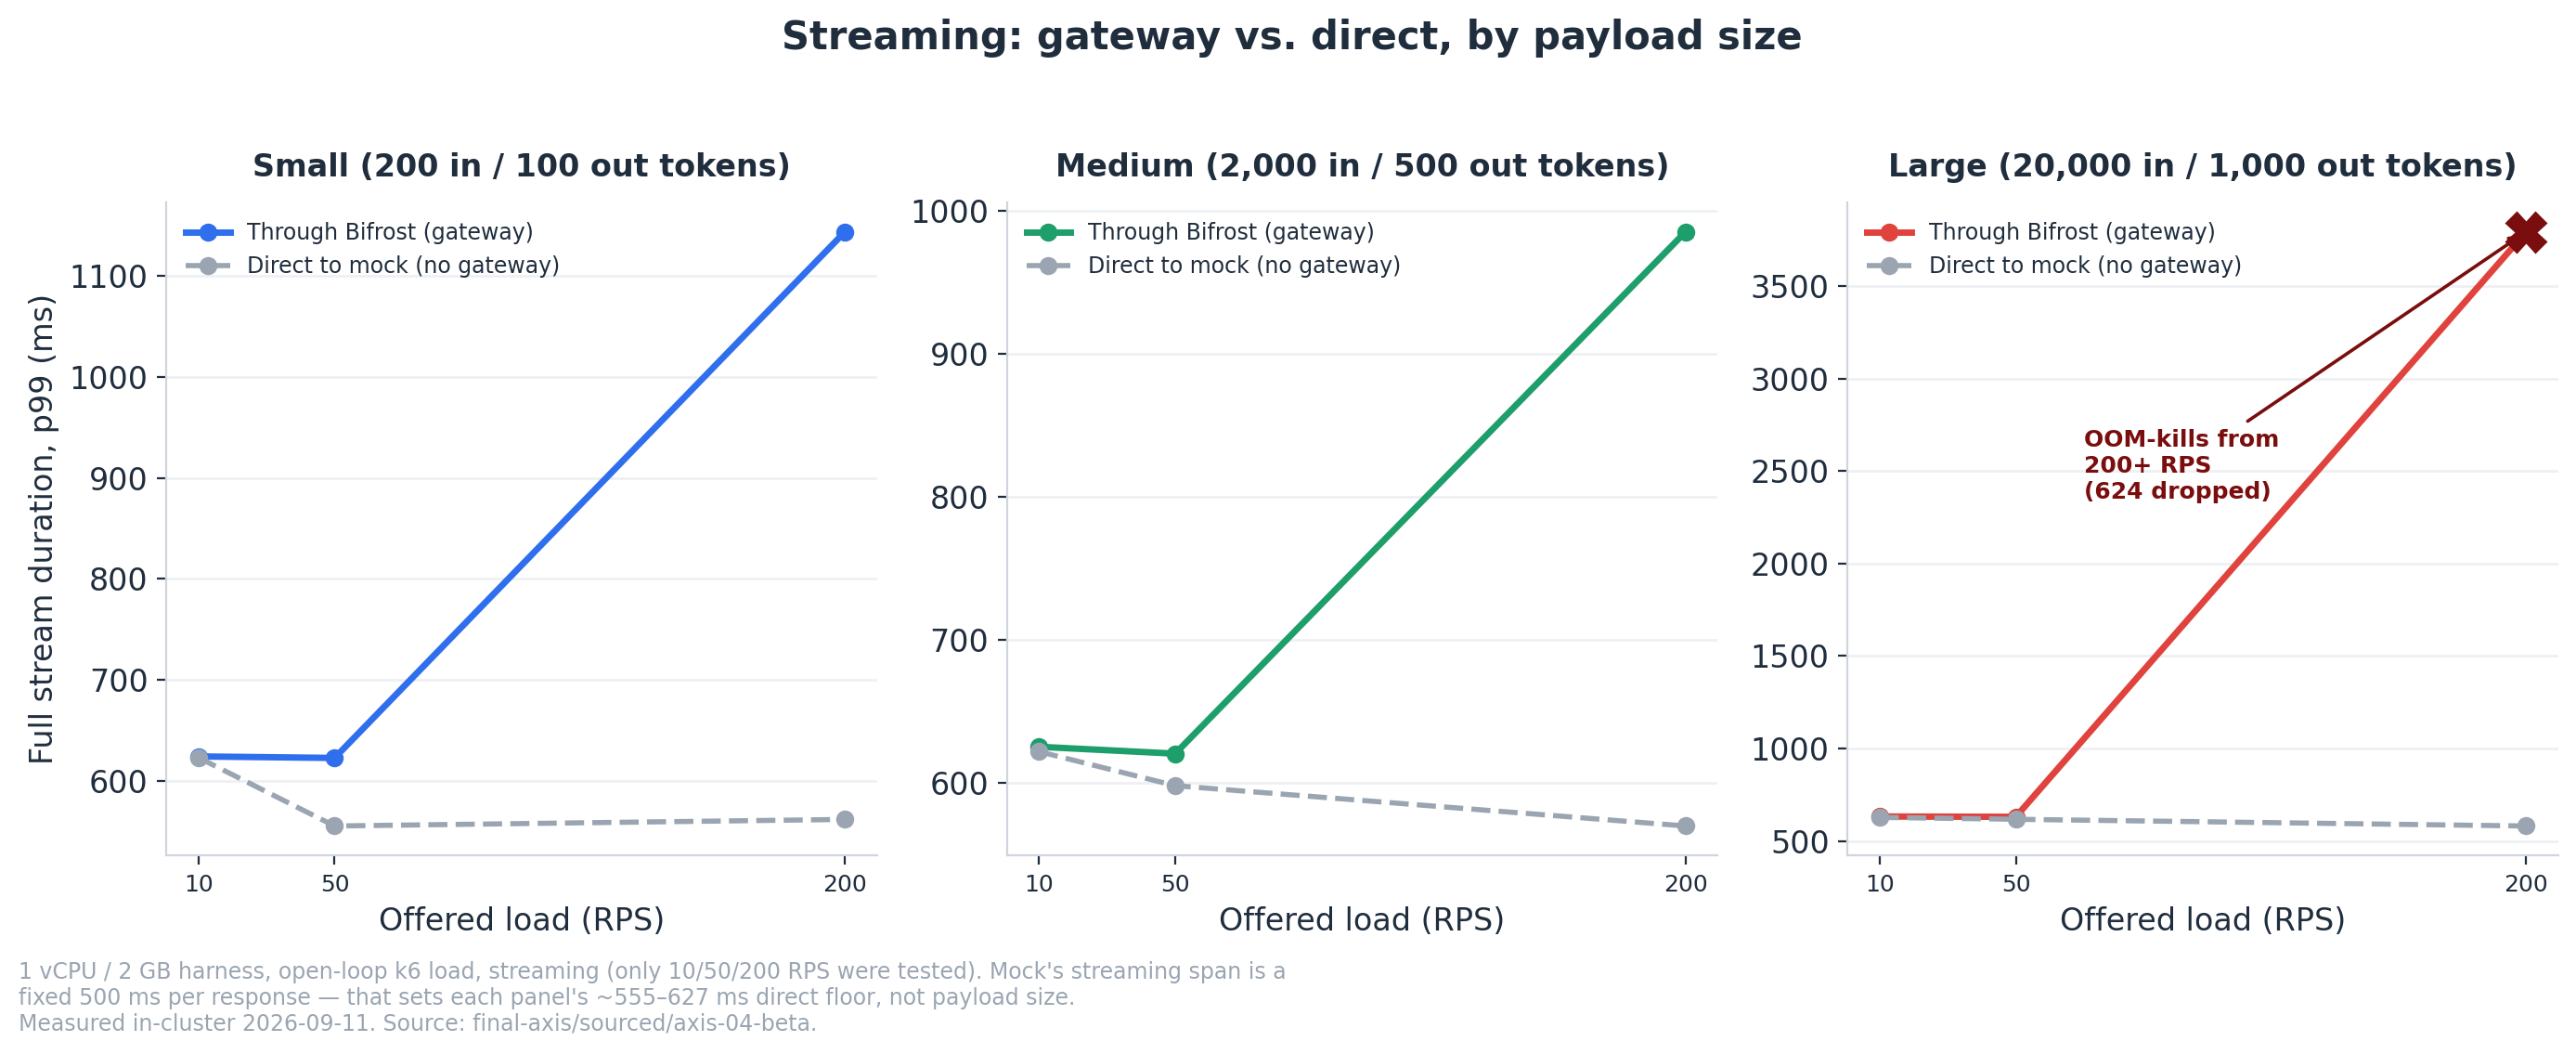
Tanto el streaming pequeño como el mediano siguen de cerca su propio suelo directo de ~555–627 ms hasta los 50 RPS, y luego empiezan a subir hacia los 200 RPS (el p99 del pequeño alcanza ~1.14 s y el del mediano ~985 ms; en ambos casos se debe a colas de espera, no a falta de memoria OOM). El streaming grande tampoco experimenta esa subida gradual: a los 200 RPS colapsa por OOM a mitad de la ejecución, cayéndose 624 de los 12 001 streams y disparando el p99 a ~3.8 segundos. Si su carga de trabajo transmite documentos grandes, 200 RPS en una sola vCPU no es un nivel «más lento»: es un nivel en el que «todo se cae».
Sin embargo, la duración total del stream no es la cifra relevante si su interfaz de usuario solo necesita mostrar el primer token. Por ello, lo medimos por separado mediante una sonda asíncrona emparejada que mide el tiempo hasta el primer token de contenido real, no el TTFB de k6 (que aquí no es válido para SSE, ya que el mock purga las cabeceras antes de que exista token alguno):
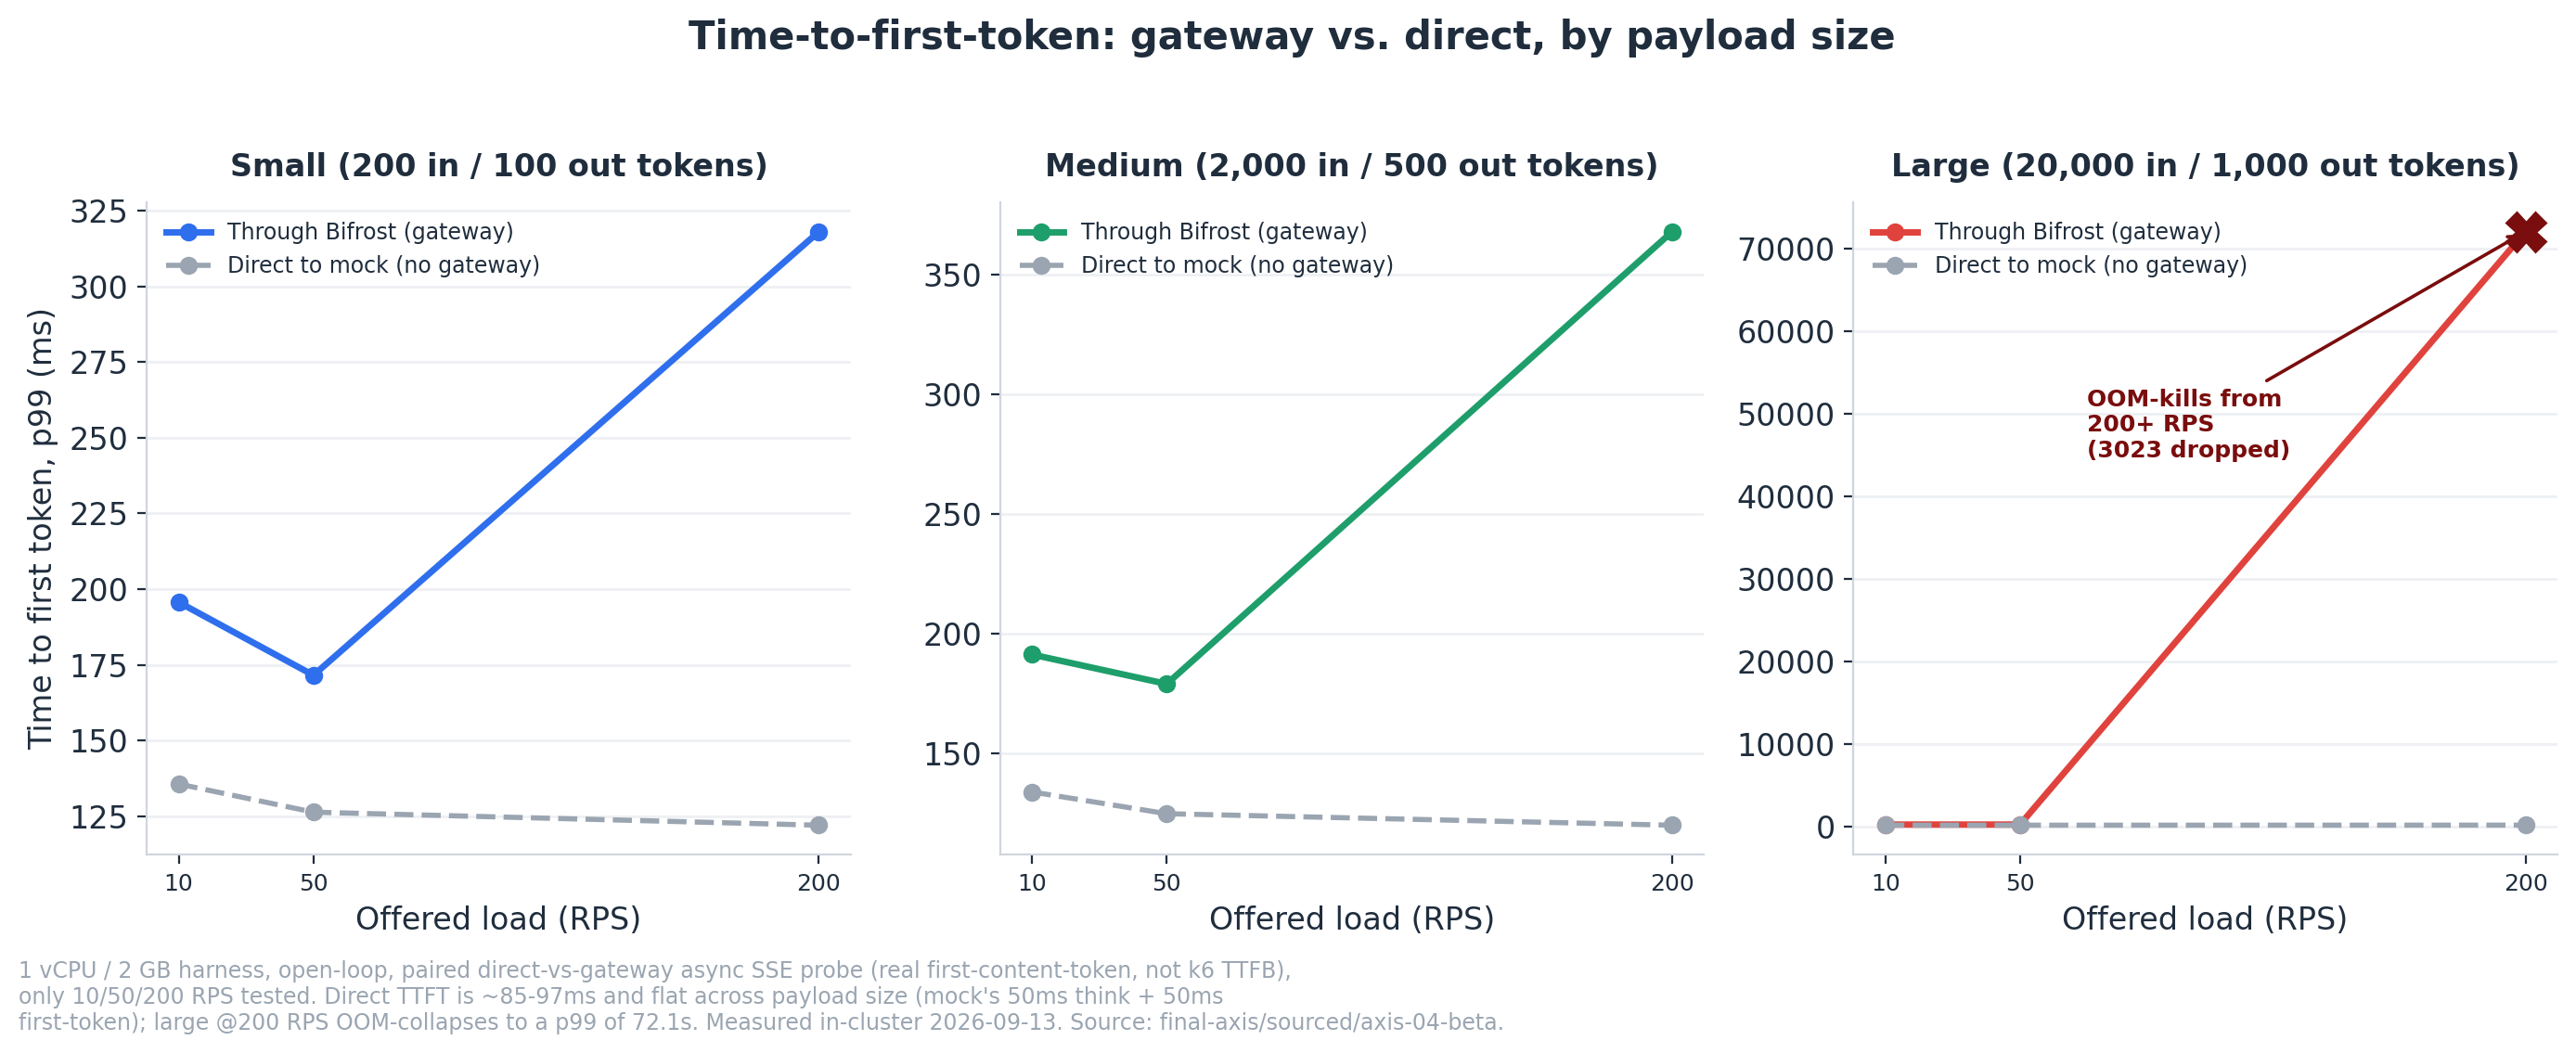
El TTFT directo es de ~85–97 ms y se mantiene plano en los tres tamaños de carga útil, lo que confirma que la longitud de entrada no altera el tiempo hasta el primer token. Por tanto, todo lo que supere ese suelo es el coste de configuración del streaming por petición propio de Bifrost. Ese coste añadido es de ~27–46 ms e independiente del tamaño a 10–50 RPS (grande a 10 RPS añade +46 ms, pequeño a 10 RPS añade +43 ms: mismo orden, distinta carga útil). A 200 RPS, las medianas del pequeño y el mediano aún se mantienen (+57 a +71 ms), pero la cola se dispara (el p99 añadido alcanza +196 a +248 ms) y entre el 10 y el 13 % de los streams del gateway fallan por completo, mostrando el mismo punto de inflexión por colas observado en el gráfico de stream completo anterior. El grande a 200 RPS no tiene un problema de cola, tiene un colapso: solo se atienden 128.8 de los 200 RPS ofrecidos, el p99 del TTFT se dispara a 72.1 segundos y fallan 3023 de los 12 001 streams; el muro de OOM, visto esta vez desde el lado del primer token en lugar del lado de la respuesta completa.
Bajo una ráfaga de sobrecarga deliberada, los dos modos de Bifrost se mantuvieron seguros en cuanto a memoria: «blocking» atiende a todos eventualmente (la petición más lenta esperó ~5 segundos) y «drop» falla rápidamente con un error 503 limpio.
El límite de la carga útil grande tiene una causa completamente diferente a la de las cargas pequeña y mediana. No es la CPU, y la forma más clara de verlo es examinar la memoria y la CPU por separado, desglosadas por tamaño de carga útil y carga ofrecida, en lugar de mostrar un único valor de pico por carga útil:
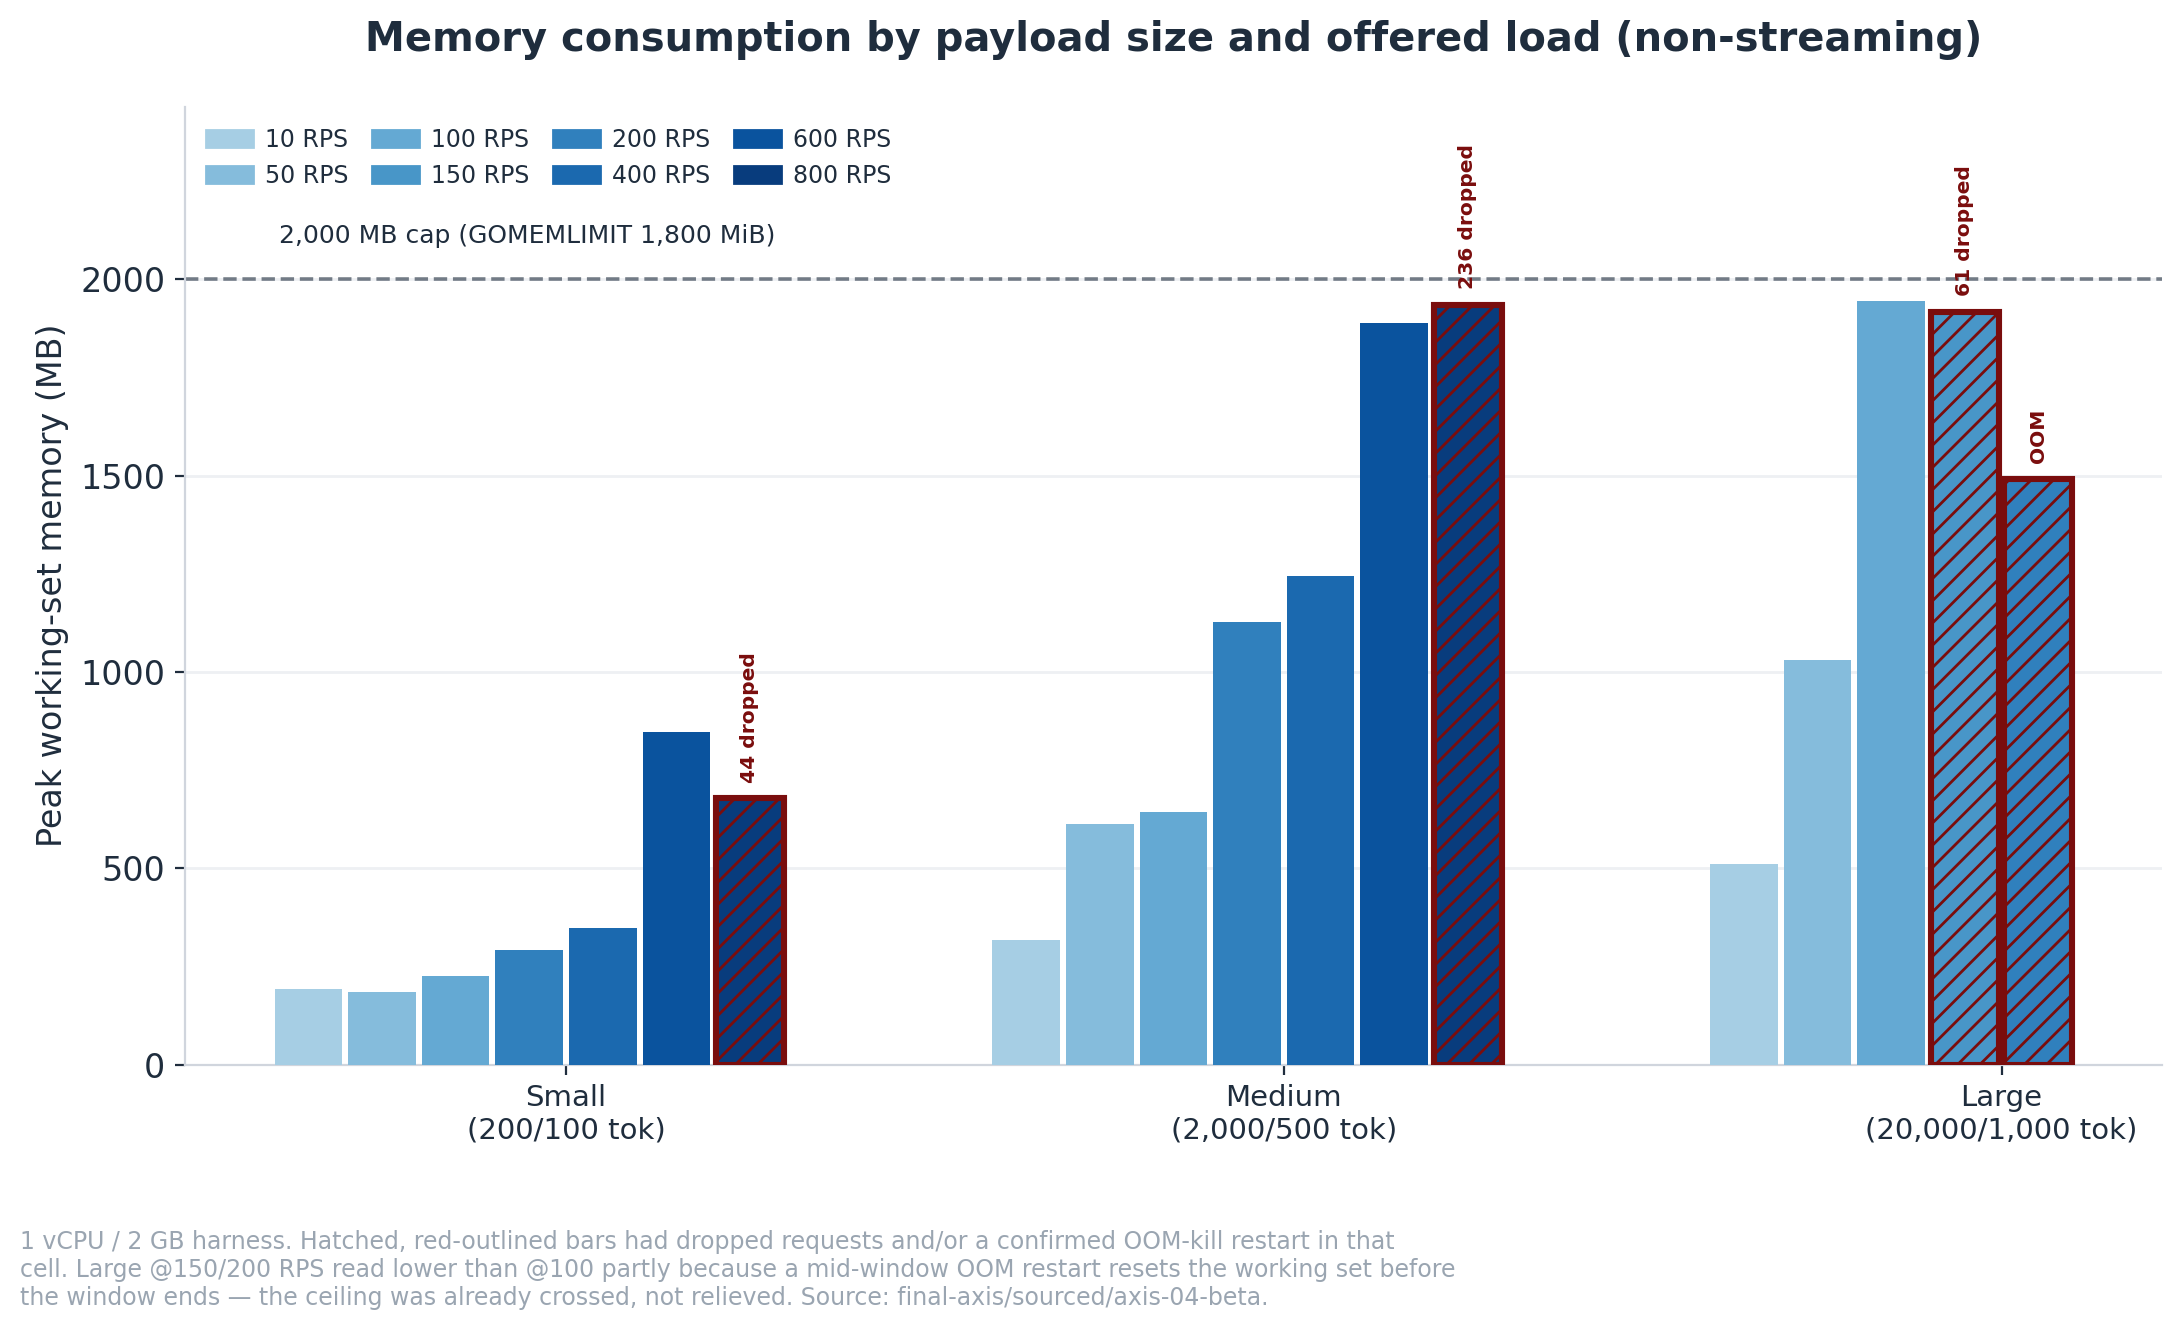
Las cargas pequeña y mediana suben de forma gradual y nunca se acercan al límite de 2000 MB, ni siquiera en sus RPS probados más altos (848 MB y 1935 MB respectivamente). La carga grande es otra historia: ya está en 1944 MB (el 97 % del límite) a 100 RPS, entre 50 y 700 RPS antes de su «límite» medido. Las barras delimitadas y sombreadas en rojo (grande a 150 y 200 RPS) muestran en realidad valores inferiores a la barra de 100 RPS, lo que parece una recuperación pero no lo es: un OOM-kill a mitad de la ventana reinicia el pod y restablece el contador del conjunto de trabajo antes de que termine la ventana de medición, por lo que esas barras subestiman el pico real en lugar de sobreestimarlo.
La CPU muestra la historia opuesta, lo cual es precisamente el punto clave:
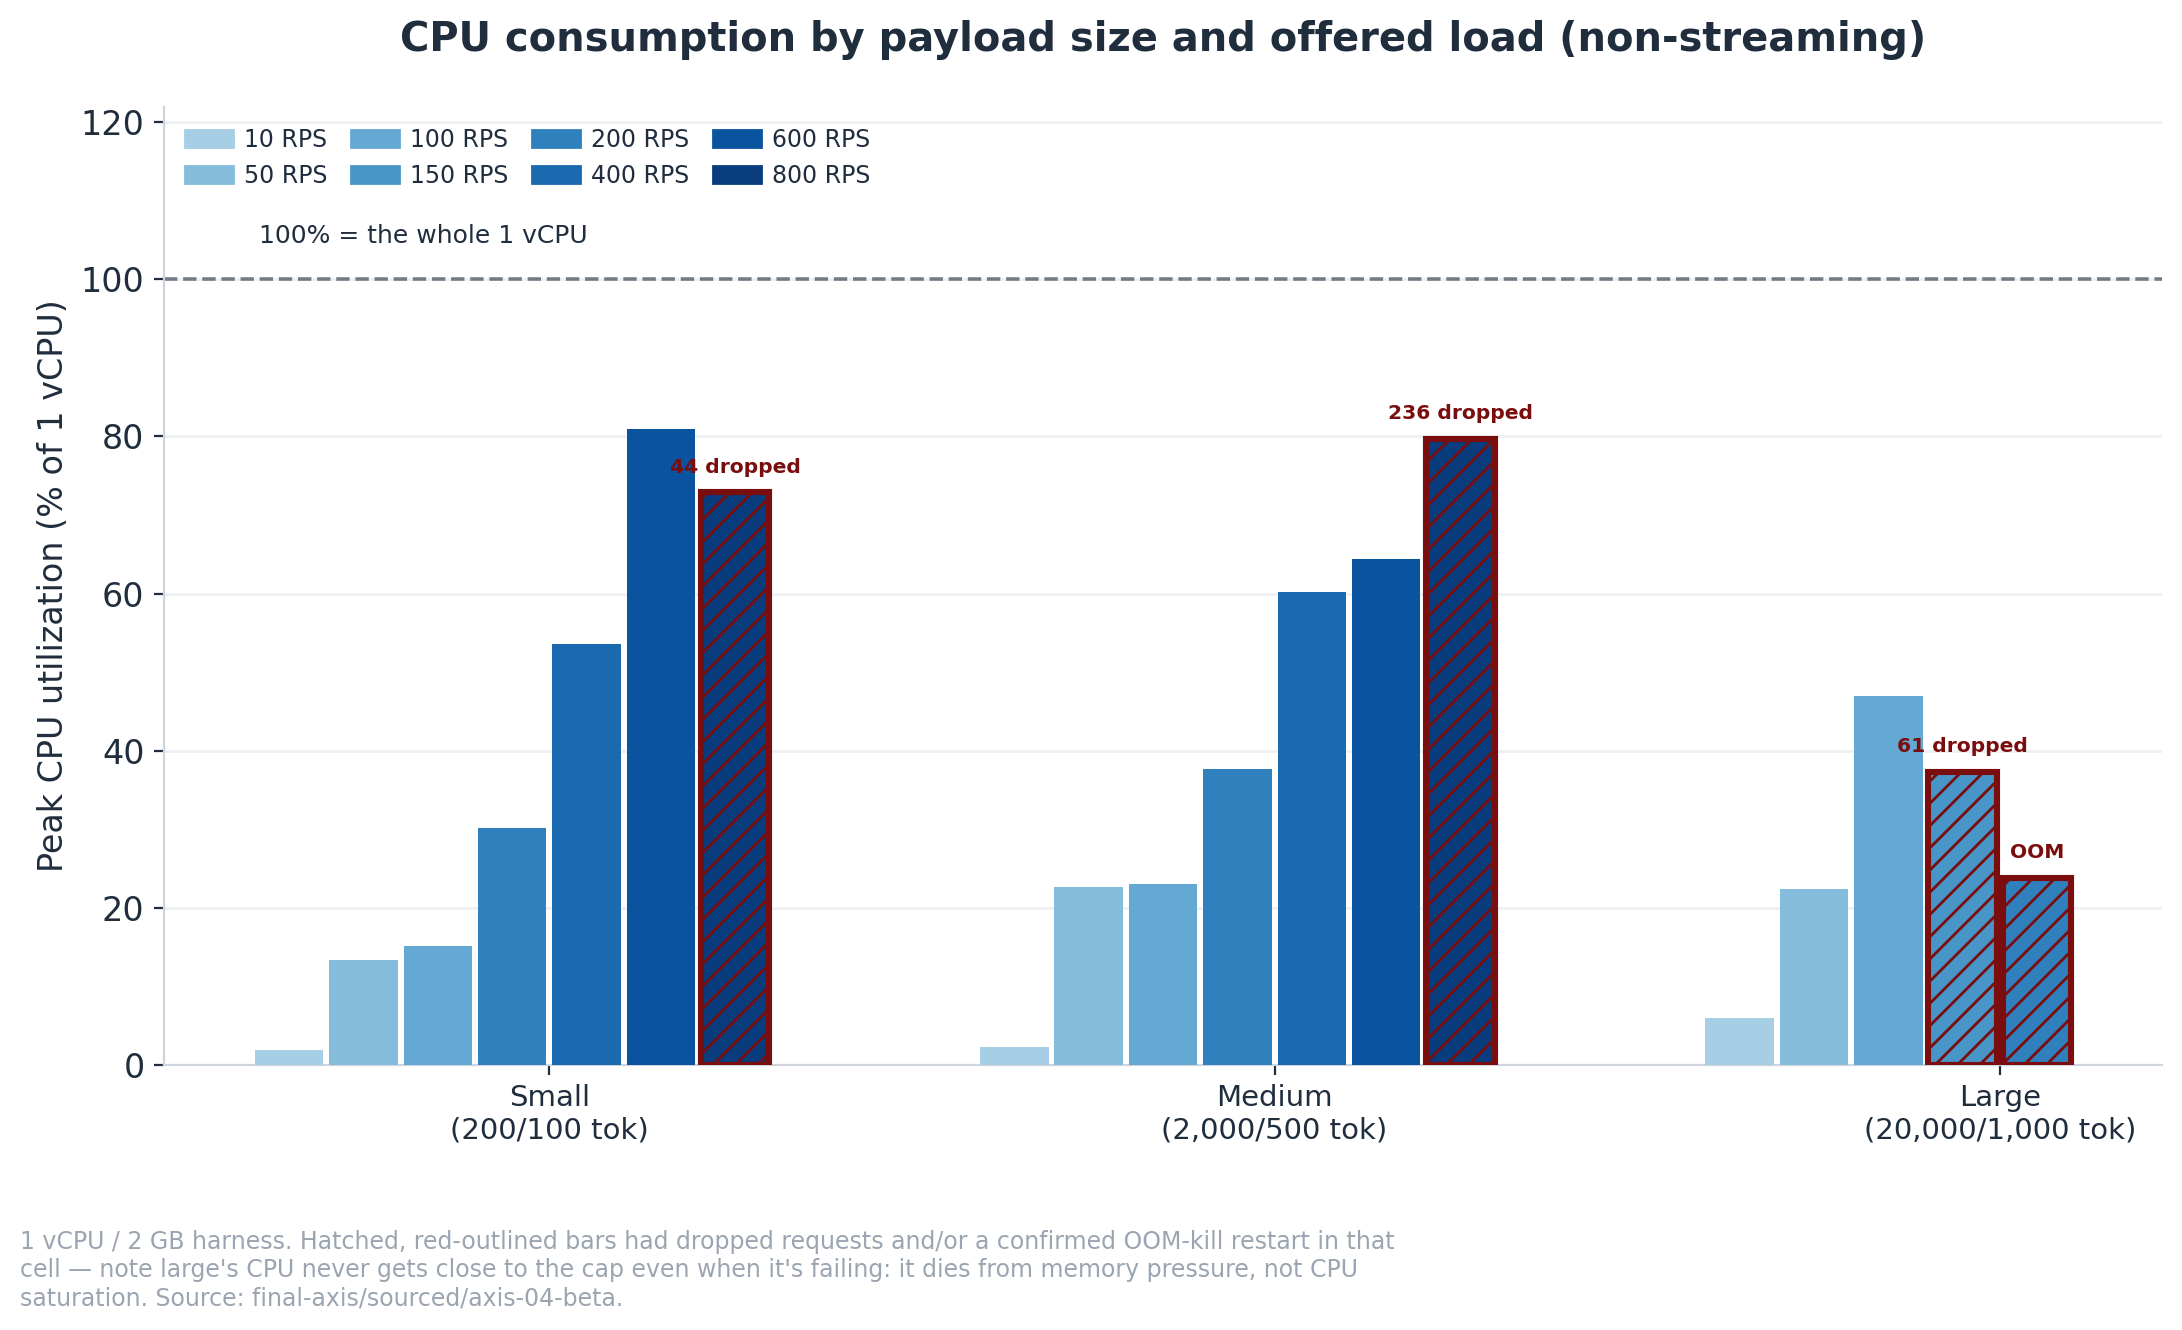
Las cargas pequeña y mediana aumentan hasta el rango del 73–80 % en sus RPS más altos, estando realmente limitadas por la CPU y exigiendo al máximo a la única vCPU. La carga grande nunca lo hace: incluso en las celdas donde está descartando peticiones de forma activa y sufriendo reinicios por OOM (delimitadas y sombreadas en rojo), su pico de CPU alcanza un máximo del 37 % y 24 %. La carga grande no falla porque la CPU se haya quedado sin espacio; falla porque la memoria sí lo hizo, mientras a la CPU aún le quedaba capacidad de sobra. Si su carga de trabajo consta de documentos largos, esa es la cifra a tener en cuenta para la planificación, no el número de vCPU.
Un acierto por coincidencia exacta convierte una llamada de ~59 ms en una de ~4 ms. La caché semántica (detectar una repetición con diferente redacción de la misma pregunta) conlleva un coste real de embedding, pero aun así supera a una llamada nueva reduciendo el tiempo a la mitad:
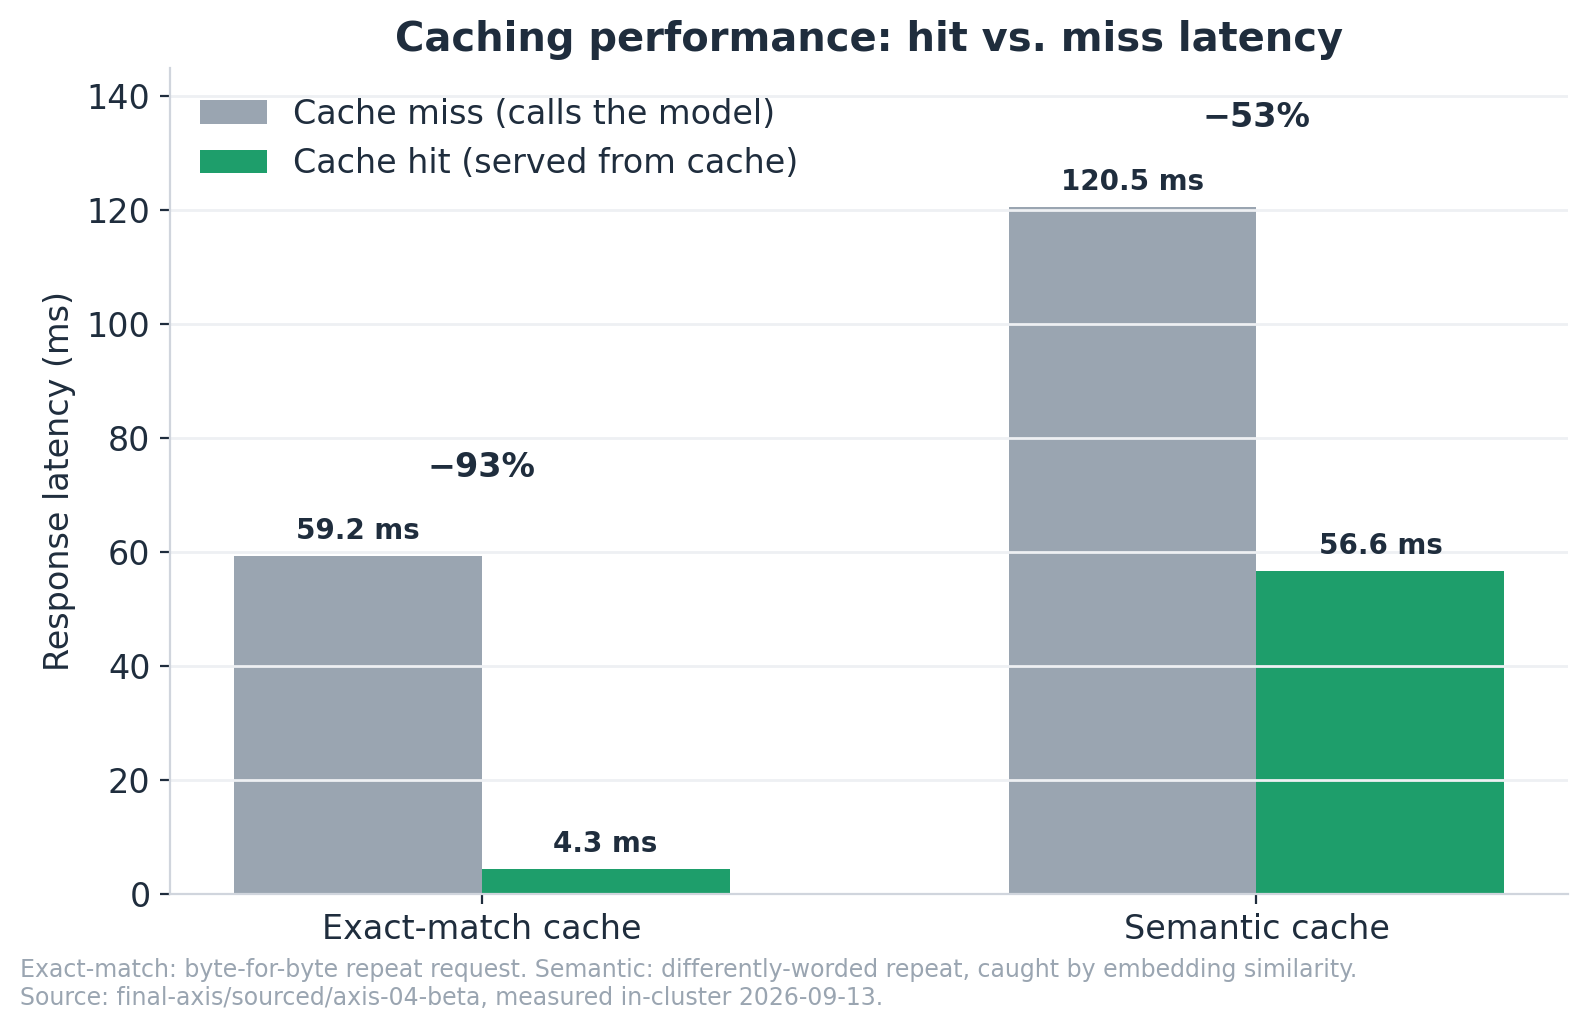
Ninguno de los dos resultados es sorprendente por sí solo: se supone que almacenar en caché es más rápido que llamar al modelo, y lo es. Las cifras mostradas aquí son simplemente la medición práctica de cuánto más rápido es exactamente: un 93 % para un acierto de coincidencia exacta y un 53 % para un acierto semántico una vez pagado el coste del embedding.
Dos cifras más antes de continuar: el arranque en frío tiene una mediana de 8.7 segundos, y 8.2 de esos segundos corresponden a una descarga obligatoria del catálogo en cada reinicio en una configuración típica en contenedores (solucionable con almacenamiento persistente, no vuelto a probar de forma independiente aquí).
Una nota de transparencia sobre los números anteriores: específicamente en la celda de carga útil pequeña, detectamos y corregimos un error en nuestro propio entorno de pruebas (una interacción de red del algoritmo de Nagle que introducía ruido en nuestra referencia base). Tras corregirlo, el límite de la carga útil pequeña de Bifrost en realidad aumentó, pasando de ~400 a ~600–800 RPS. Lo mencionamos porque es el tipo de detalle en el que es fácil equivocarse al realizar pruebas de rendimiento en cualquier gateway, incluido Bifrost, y preferimos mostrar nuestro trabajo en lugar de ocultar la corrección.
En una sola máquina, la sobrecarga de Bifrost es realmente baja en la mediana: 2–6 ms por encima de una llamada ascendente de ~55 ms, constante entre tamaños de carga útil y casi constante bajo la carga. Esa es la versión defendible de la afirmación del «gateway más rápido», y tiene su valor: como proporción de una llamada real a un LLM, equivale a ruido insignificante. Los valores extremos de la cola son otra historia. El p99 añadido es sensible a la carga, alcanzando de +41 a +75 ms en los límites que medimos, y las cargas útiles grandes no se ralentizan de forma gradual, sino que directamente se detienen: sufren OOM-kill a 150 RPS y descartan peticiones. El almacenamiento en caché funciona como se anuncia (reducciones de latencia del 93 % y 53 %, medidas). La cifra del proveedor de 5000 RPS describe una máquina más grande y una carga de trabajo diferente a la que ejecutan la mayoría de los equipos. Por lo tanto, para un solo nodo: la velocidad mediana no es el problema; la latencia en la cola bajo carga y el margen de memoria en tráfico denso en documentos sí lo son.
La pregunta más difícil es qué sucede cuando se ejecuta más de un nodo. Un gateway en producción debe escalar horizontalmente, reducir su escala y sobrevivir a la caída de un pod sin que nadie lo note. En la versión de código abierto, ahí es donde la situación se complica. Los cambios de configuración no se propagan en directo entre las réplicas; el patrón documentado es un archivo de configuración compartido junto con un reinicio. Por tanto, cada cambio de enrutamiento, rotación de claves o actualización de presupuesto se convierte en un despliegue coordinado entre los pods del gateway en lugar de un simple ajuste de configuración. Si a esto se le añade un panel de administración abierto a cualquiera que pueda acceder a él hasta que se cree la primera cuenta de administrador, la versión de código abierto resulta más adecuada para un solo nodo supervisado de cerca que para una flota.
Bifrost Enterprise recorta gran parte de esa brecha: su malla gRPC transmite los cambios de configuración a cada réplica en cuestión de segundos, sin necesidad de reiniciar. Sin embargo, incluso Enterprise sigue siendo una infraestructura que debes desplegar, escalar, parchear y monitorizar por ti mismo. Comprar la licencia no traslada la carga operativa a otra persona.
Por tanto, la verdadera decisión no es tanto "¿es rápido Bifrost?", sino más bien "¿quién lo va a ejecutar?". Un equipo con capacidad dedicada de plataforma/DevOps, o con requisitos estrictos de mantener todo dentro de su propio entorno, puede ejecutar Bifrost adecuadamente, idealmente en Enterprise si necesita más de una réplica. Un equipo pequeño que solo necesite un gateway fiable frente a sus llamadas a LLM obtendrá, por lo general, más rendimiento de una oferta gestionada que de asumir las operaciones del propio gateway.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada


















