



November 10, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Ambas son plataformas de GPU serverless, ambas escalan a cero por defecto y ambas gestionan tráfico en producción para empresas de renombre. Es una comparativa justa, pero no tienen la misma estructura. Baseten construyó una plataforma de servicio de modelos y la fue ampliando. Modal construyó una plataforma de cómputo general en la que la inferencia es solo uno de seis productos. Esto se refleja en el SDK, en lo que contabiliza la tarifa pública y en la posibilidad de ejecutarla en tu propia cuenta.
El aspecto más útil a continuación es la metodología de precios, ya que las tarifas publicadas de GPU por hora no son comparables entre ambas plataformas y el margen de error es lo suficientemente amplio como para cambiar una decisión. Cifras verificadas el 25 de septiembre de 2026.
Baseten ofrece inferencia en producción para modelos de código abierto, personalizados y ajustados (fine-tuned), a través de despliegues dedicados (Dedicated Deployments), API de modelos por token y entrenamiento (consulte los precios).
Fundada en 2019 por Tuhin Srivastava (CEO), Amir Haghighat (CTO), Phil Howes y Pankaj Gupta. La financiación pasó por las series B, C, D y una Serie E de 300 M$ a una valoración de 5000 M$, hasta alcanzar una Serie F de 1500 M$ a una valoración de 13 000 M$ el 22 de junio de 2026 (anuncio); el total recaudado supera los "2000 M$". Según informes, los ingresos se multiplicaron por 20 año tras año; los ingresos anuales recurrentes (ARR) no se han publicado [VERIFY]. Entre sus clientes se encuentran Cursor, Notion, Harvey, HubSpot, OpenEvidence y Vercel.
Respecto a una cifra que quizás haya visto: los informes de prensa de finales de septiembre de 2026 (Axios 22 sep, Bloomberg 23 sep) describen conversaciones sobre una ronda mucho mayor cercana a unos 26 000 M$. Baseten no ha publicado nada al respecto. 13 000 M$ es la última cifra confirmada y la que utilizamos aquí.
[SCREENSHOT: Baseten — the Dedicated Deployments dashboard showing replica states, autoscaling config and latency percentiles for a live model]
Baseten también adquirió Blaxel, una empresa de infraestructura de microVM y entornos de aislamiento para agentes, según se anunció el 10 de septiembre de 2026 (términos no revelados, anuncio): una entrada directa en el terreno de los Sandboxes de Modal, tan reciente que aún no hay productos desplegados para evaluar.
Objetivamente mejor para: compradores en sectores regulados que necesitan inferencia dentro de su propia VPC (donde Modal no ofrece equivalente); cualquier entidad que gestione PHI, ya que HIPAA se incluye desde el nivel gratuito; equipos que buscan optimización de nivel TensorRT-LLM sin necesidad de construirla; y cargas de trabajo fijadas a una región específica o con GPU pequeñas.
Modal se define a sí misma como «un cloud construido para la IA. No un cloud de GPU con un solo propósito, sino una plataforma con las primitivas adecuadas» (publicación de la Serie C). Productos: Inference, Sandboxes, Training, Notebooks, Batch y Core Platform. Esta lista respalda su propuesta: la inferencia es solo un elemento más.
Fundada en 2021 por Erik Bernhardsson y Akshat Bubna (el año de fundación procede de TechCrunch, no de la página de Modal [VERIFY]). El equipo desarrolló su propio sistema de archivos, runtime de contenedores, programador (scheduler) y generador de imágenes, lo que se refleja en sus cifras de arranque en frío. La financiación pasó por una fase semilla, Serie A y una Serie B de 87 M$ a 1100 M$, hasta alcanzar una Serie C de 355 M$ a una valoración posterior de 4650 M$ anunciada el 21 de mayo de 2026; el total supera los «466 M$». Modal hace público lo que Baseten oculta: «superando los 300 millones de dólares en ingresos anualizados» y que «los Sandboxes representan ya más de un tercio de nuestros ingresos». Entre sus clientes se encuentran Cognition, DoorDash, Suno y Ramp.
[SCREENSHOT: Modal — the app dashboard showing container counts, GPU utilisation and cold-start timing for a deployed Function]
[SCREENSHOT: Modal — the pricing page showing the GPU table alongside the separate CPU and memory line items]
Objetivamente mejor para: cualquier proceso que no sea un servidor de modelos: entornos de aislamiento (sandboxes), código no confiable, entornos de aprendizaje por refuerzo (RL), lotes (batch) y notebooks. Ergonomía en Python. Cargas de trabajo con GPU de gran tamaño, no vinculadas a región y con picos de uso. Variedad de GPU, dado que L40S, A100 de 40 GB y B300 no tienen equivalente en Baseten. Y cold starts prolongados por inicializaciones pesadas dominadas por JIT e importaciones en lugar de la carga de pesos.
El análisis honesto sobre los arranques en frío: resuelven dos mitades distintas del mismo problema. Baseten aborda la entrega de pesos y excluye la transferencia del tiempo facturable. Modal aborda el estado del proceso mediante la restauración de snapshots, lo cual no acelera la carga de pesos. Si tu arranque en frío implica cargar 140 GB de pesos, el enfoque de Baseten es el adecuado; si está dominado por importaciones, JIT y captura de grafos CUDA, el de Modal resulta más efectivo.
Metodología. Baseten publica tarifas por minuto para SKU de instancias integradas (la GPU incluye vCPU y RAM fijas). Modal publica tarifas por segundo exclusivamente para la GPU, facturando la CPU y la memoria por separado. Para realizar una comparativa equivalente, convertimos ambas tarifas a coste por hora (Baseten x60, Modal x3600) y añadimos a la tarifa de GPU de Modal la CPU y memoria que Baseten incluye en sus paquetes, aplicando las tarifas propias de Modal: 0,04716 $ por hora de núcleo físico (un núcleo equivale a dos vCPU) y 0,007992 $ por GiB-hora. Se excluyen los multiplicadores por vinculación a región e instancias no interrumpibles; al incluirlos, Modal resulta aún más costoso. Fuentes: baseten.co/pricing, docs.baseten.co/deployment/resources, modal.com/pricing.
Las GPU L40S y A100 de 40 GB no disponen de un SKU equivalente en Baseten con el que realizar el ajuste.
Conclusión: la afirmación de que «Modal es un 40 % más barato en H100» se reduce a aproximadamente un 19 % una vez que se añade la CPU y la memoria equivalentes; se sitúa en casi la paridad en la A100 de 80 GB y se invierte en GPU pequeñas, donde Baseten resulta entre un 9 % y un 22 % más económico. Si se añade la vinculación a región o el multiplicador de 3x por instancias no interrumpibles, Baseten resulta más ventajoso en cualquier carga de trabajo con recursos garantizados.
Un detalle importante para quienes realizan pruebas de rendimiento: la configuración básica gpu="A100" en Modal puede actualizarse automáticamente a 80 GB sin aviso, y gpu="H100" puede asignarse en una H200. Fije la tarjeta de forma estricta mediante gpu="H100!".
1. La tarifa publicada no refleja la factura final. Los equipos suelen estimar el presupuesto basándose únicamente en el coste por hora de la GPU, para luego encontrarse con cargos adicionales de CPU, memoria, volúmenes, multiplicadores de región y una tarifa triple para sandboxes. El modelo integrado de Baseten facilita la previsión presupuestaria, mientras que el desglose detallado de Modal refleja con mayor precisión el consumo real. Ninguno de los dos se puede comparar directamente sin realizar el cálculo expuesto anteriormente.
2. La selección de región no garantiza la residencia de datos. Modal puede vincular un contenedor a eu-west y, aun así, almacenar los registros, el almacenamiento duradero y cualquier carga útil superior a 2 MiB en EE. UU. Si debe responder ante un organismo regulador, la región del contenedor no es suficiente.
3. El servidor de modelos es solo una parte del sistema. Una arquitectura completa también requiere gestionar API de modelos comerciales, autenticación, atribución de costes, límites de tasa (rate limits), barreras de protección (guardrails) y registros de auditoría. Ninguna de estas dos plataformas cubre esa capa de forma integral, por lo que su implementación sigue dependiendo de su equipo.
Presentamos una perspectiva directa en lugar de forzar una comparativa a tres bandas. Baseten y Modal son clouds de inferencia hospedados. TrueFoundry se ejecuta directamente en tu propia cuenta de cloud. Está dirigido a un perfil de comprador diferente y resuelve un problema distinto.
Baseten y Modal responden a la pregunta: «¿cómo puedo servir este modelo sin gestionar la infraestructura de GPU?». TrueFoundry responde a: «ya disponemos de capacidad de GPU, compromisos de gasto (committed spend) o exigencias regulatorias, y necesitamos una plataforma sobre nuestra propia infraestructura». Si tu necesidad es la primera, elige una de ellas; la modalidad autohospedada de Baseten es el punto de coincidencia más cercano.
TrueFoundry se despliega como SaaS en más de 12 regiones a través de tres proveedores de cloud, o de forma autohospedada dentro de tu VPC mediante Helm y OpenTofu/Terraform, en instalaciones locales (on-premise) o en entornos aislados (air-gapped). En la modalidad autohospedada, todo el tráfico de los LLM permanece dentro de tu infraestructura y TrueFoundry no se sitúa en la ruta de transmisión en vivo. El servicio de modelos admite vLLM, SGLang, Triton, TorchServe, MLflow y LitServe, además de un registro de modelos, autoescalado por CPU, RPS o programación cron, junto con fraccionamiento de GPU mediante multiprocesamiento espacio-temporal (time-slicing) y MIG; esto resulta crítico cuando se dispone de hardware propio y asignar una H100 completa a un modelo pequeño supone un desperdicio de recursos.
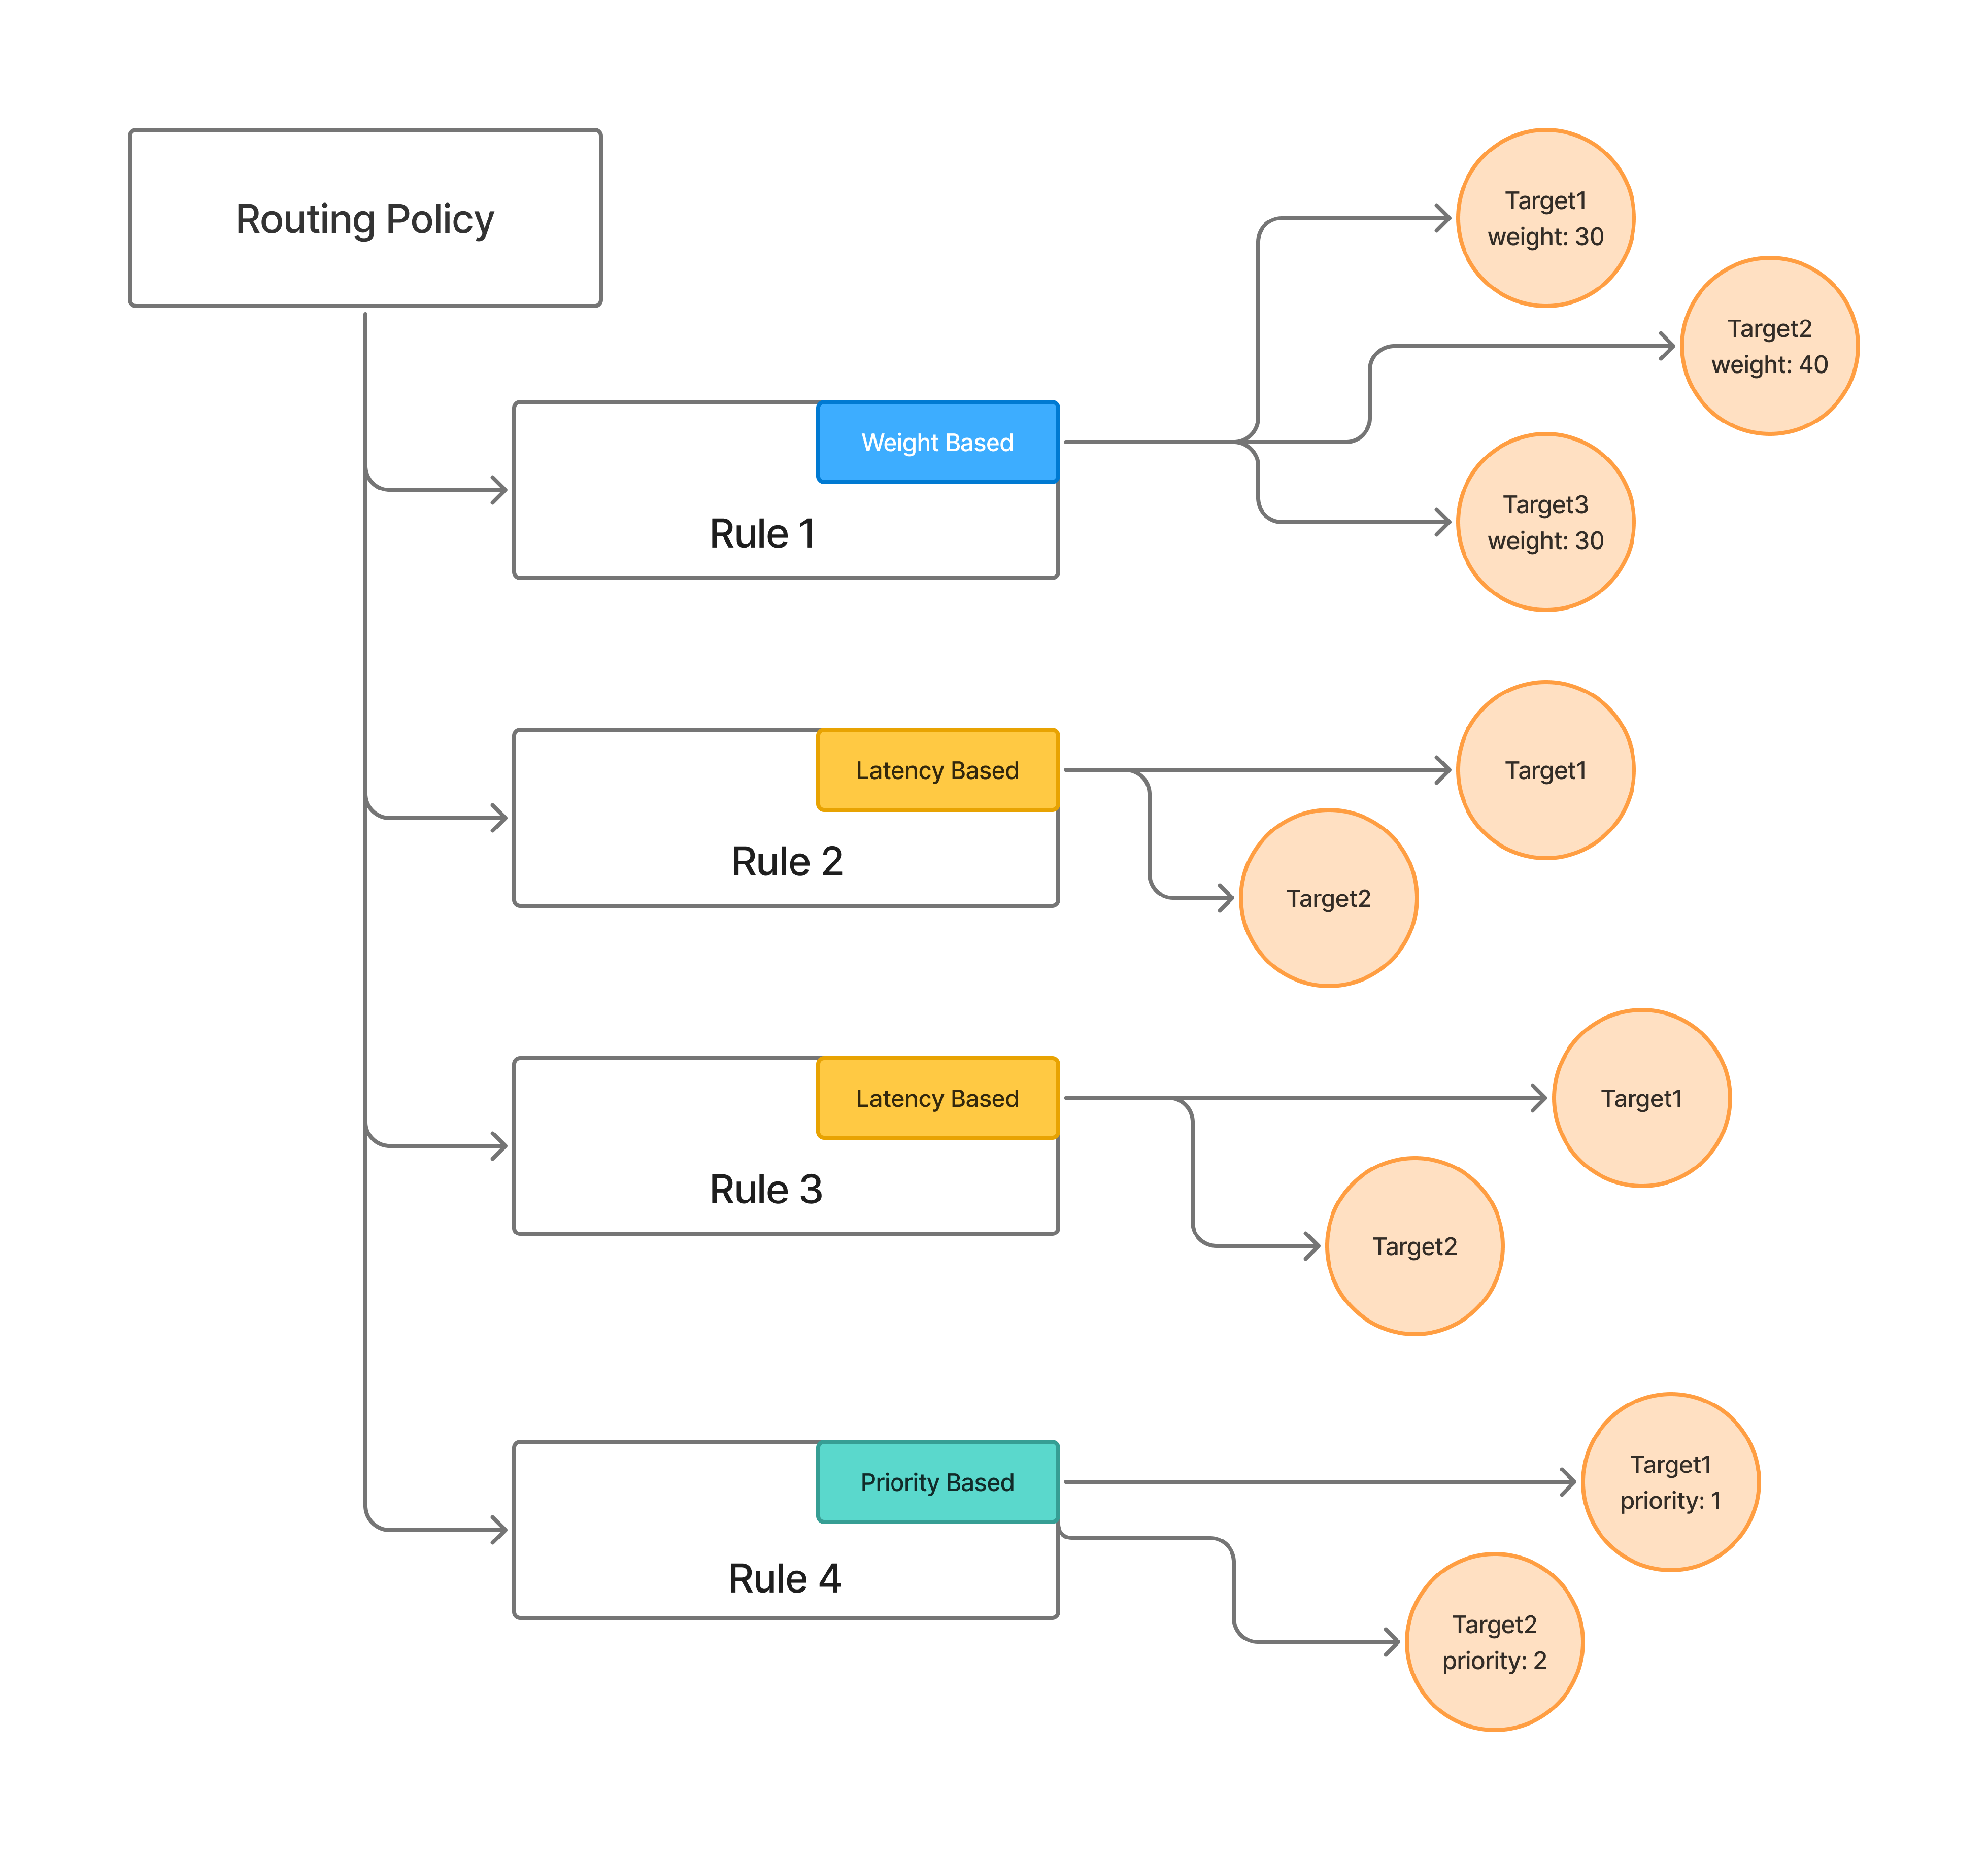
El otro componente fundamental es el AI Gateway, donde la inferencia autohospedada y la hospedada dejan de ser problemas independientes. Actúa como fachada para más de 1000 LLM bajo una única API compatible con OpenAI, añadiendo solo entre 3 y 4 ms de latencia y gestionando más de 350 RPS en 1 vCPU. De este modo, tu endpoint de Baseten, tu endpoint de Modal y tu clave de OpenAI se gestionan desde una sola interfaz con atribución de costes compartida, límites de tasa y registro de auditoría. El enrutamiento automático (Auto Routing) permite optimizar los costes: en una prueba con 550 prompts, el enrutamiento por complejidad redujo el gasto un 69 % manteniendo el 98 % de la calidad, y reduciendo la latencia media de 7,6 s a 4,0 s.
Una aclaración transparente: TrueFoundry no es un marketplace de GPU serverless; la capacidad la aporta el cliente. Si no dispones de GPU ni deseas gestionarlas, la opción adecuada es Baseten o Modal.
Tanto Baseten como Modal son excelentes soluciones. La comparativa es ajustada en el aspecto que suele evaluarse en primer lugar —el precio—, pero muestra diferencias claras en los factores clave que determinan la adquisición corporativa.
Si la carga de trabajo debe ejecutarse dentro de tu propia VPC, si gestionas datos con normativa PHI, si necesitas optimización TensorRT-LLM sin asumir el desarrollo del motor, o si utilizas GPU pequeñas y vinculadas a región, Baseten es la opción adecuada. Si requieres entornos de aislamiento (sandboxes), procesamiento por lotes (batch) y notebooks junto con la inferencia, o si la ergonomía en Python es tu prioridad principal, la elección correcta es Modal.
Nuestra recomendación es no tomar la decisión basándose únicamente en la tarifa pública de la GPU. Las tarifas no son comparables directamente entre ambas plataformas; al realizar el ajuste adecuado, la ventaja teórica del 40 % se reduce al 19 %, llega a la paridad o se invierte a favor del otro proveedor.
Si el requisito fundamental es que la carga de trabajo permanezca en la infraestructura que ya posees y financias, ninguna de las plataformas hospedadas resuelve el problema. Se trata de un desafío de plano de control, y ese es precisamente el propósito de la plataforma que desarrollamos.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Depende de la GPU, y las tarifas publicadas inducen a error. Con las cifras de cabecera, Modal parece entre un 37 y un 40 % más barato en H100 y A100 de 80 GB. Si se suman la CPU y la memoria que Baseten incluye, la diferencia en H100 se reduce a cerca del 19 %, en A100 de 80 GB hay paridad, y en T4 y A10 Baseten es entre un 9 y un 22 % más barato. Los multiplicadores de pinning y de capacidad no interrumpible de Modal inclinan aún más la balanza hacia Baseten, y su cuota Team de 250 $/mes es un coste fijo que Baseten no cobra.
Starter, 0 $/mes con 30 $/mes de cómputo gratuito; Team, 250 $/mes con 100 $/mes de cómputo gratuito; Enterprise, a medida. El cómputo se factura por segundo y desglosado: la GPU a su propia tarifa, la CPU a 0,04716 $ por núcleo físico-hora y la memoria a 0,007992 $ por GiB-hora. El cómputo de Sandbox y Notebook cuesta 3 veces la tarifa de Function, y el pinning y la capacidad no interrumpible llevan multiplicadores.
Basic cuesta 0 $/mes en pago por uso, sin cuota de plataforma, e incluye SOC 2 Type II y HIPAA; Pro y Enterprise son bajo presupuesto. El cómputo de GPU se factura por minuto según SKU de instancia con todo incluido que agrupan vCPU y RAM: 6,4998 $/h por una H100 de 80 GB. Las tarifas por token de la Model API están publicadas; el importe del crédito gratuito, no.
Los contenedores arrancan en aproximadamente un segundo, y los Memory Snapshots ofrecen restauraciones entre 3 y 10 veces más rápidas, según la documentación de Modal. La cifra de «100x» de la publicación sobre la Serie C de Modal no está respaldada por su propia documentación, así que planifique con 3-10x. Los snapshots de GPU están en Alpha y no aceleran la carga de pesos desde el almacenamiento.
No está confirmado. La última valoración que Baseten ha publicado es de 13.000 millones de dólares, procedente de una Serie F de 1.500 millones de dólares del 22 de junio de 2026. Las informaciones de prensa de finales de septiembre de 2026 hablan de conversaciones sobre una ronda mayor, pero se trata de información en fase de negociación y la empresa no ha publicado nada.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















