August 31, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Integración de Arthur AI con Truefoundry AI Gateway
Todos los equipos que despliegan una aplicación LLM chocan contra el mismo muro. Los desarrolladores quieren avanzar rápido y conectarse a cualquier modelo que cumpla la función. Los equipos de seguridad y riesgos quieren garantías de que nada tóxico, manipulado o alucinado llegue al usuario. Ambos tienen razón. Lo difícil es hacer ambas cosas a la vez, en todos los modelos que usan sus equipos, sin tener que acoplar un SDK diferente a cada app. La gran pregunta es: ¿cómo validar cada prompt y cada respuesta que produce su AI sin convertir la seguridad en un proyecto de ingeniería eterno?
Nos complace anunciar que Arthur AI ahora se integra con TrueFoundry AI Gateway. Al incorporar Arthur Engine a Gateway como un guardrail personalizado, puede validar entradas y salidas de AI en tiempo real en todos sus modelos desde un solo lugar, con una directiva uniforme y una única integración.
El poder de TrueFoundry AI Gateway
TrueFoundry AI Gateway es la forma en que los desarrolladores y los equipos de plataforma gestionan, monitorizan y escalan sus aplicaciones de AI. Ofrece acceso unificado a cientos de modelos de lenguaje de gran tamaño, observabilidad profunda y enrutamiento inteligente en una sola capa. A medida que crece la adopción de la AI, el verdadero desafío deja de ser el acceso a los modelos y pasa a ser la gestión de todo lo que viene después: múltiples proveedores, API cambiantes y estrictos requisitos de cumplimiento que pueden frenar a los equipos sin hacer ruido.
El Gateway aporta orden a esa complejidad. Actúa como el centro de mando para la AI empresarial, unificando el acceso, aplicando políticas de seguridad y ofreciendo visibilidad completa sobre cada modelo y entorno. Los guardrails se conectan a esta capa una sola vez y se aplican en todas partes, de modo que una decisión de seguridad tomada en el panel de control se ejecuta en cada solicitud que pasa por el sistema.
Arthur AI: validación en tiempo real
Arthur AI se sitúa entre su aplicación y sus modelos como una capa de validación. ArthurEngine inspecciona los prompts y las finalizaciones en tiempo real y devuelve un veredicto claro sobre si es seguro proceder.
Sin necesidad de configuración adicional, Arthur comprueba los riesgos que más importan en producción. Detecta el prompt injection, donde un atacante diseña una entrada orientada a secuestrar el modelo y apartarlo de sus instrucciones. Marca el contenido tóxico tanto a la entrada como a la salida, para que el lenguaje perjudicial nunca llegue a su modelo ni a sus usuarios. Y ejecuta comprobaciones de alucinaciones cotejando con el contexto de fundamentación que usted proporcione, detectando las respuestas que se desvían de los hechos antes de que se den por buenas.
Un detalle importante define cómo encaja Arthur: funciona solo como validador (validate-only). Le indica, de forma rápida y sin estado, si algo ha pasado o ha fallado. Informa de los problemas en lugar de reescribir el texto en silencio, lo que mantiene su comportamiento de forma predecible y fácil de auditar.
Mejor juntos: un solo contrato, todos los modelos
La integración conecta Arthur con TrueFoundry mediante un wrapper ligero y desplegable junto con el contrato de Custom Guardrail de Gateway. Despliega un pequeño servicio FastAPI, apunta el Gateway hacia él y registra dos configuraciones de guardrail en el panel de control: una para la entrada y otra para la salida. A partir de ese momento, cualquier modelo situado detrás de Gateway puede ser validado por Arthur sin cambios de código por aplicación.
Esa es la verdadera ventaja. En lugar de conectar Arthur a cada aplicación manualmente, lo vincula una sola vez en el Gateway. Puede fijarlo a un modelo para proteger a todos los emisores, o activarlo por solicitud con una sola cabecera cuando solo lo necesite en llamadas específicas. La misma directiva acompaña a cada equipo, modelo y entorno, y cada veredicto se registra junto con el seguimiento de solicitudes de TrueFoundry para ofrecer una traza de auditoría limpia.
Cómo funciona la integración de Arthur AI y TrueFoundry
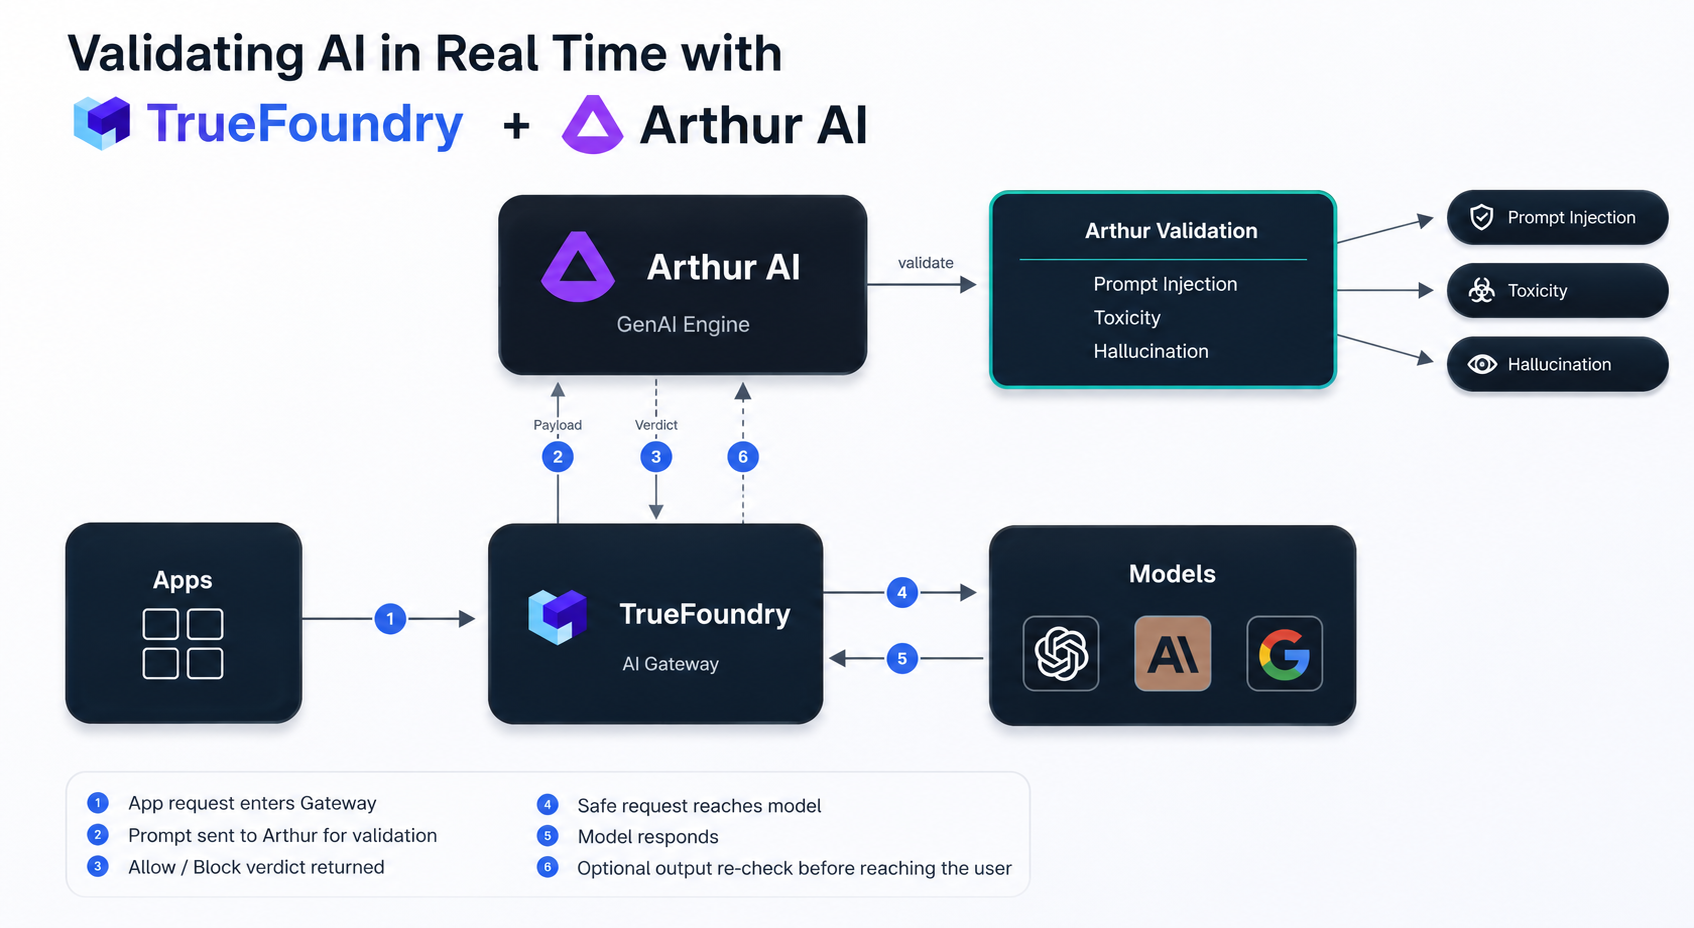
La integración introduce un flujo de validación por capas que resulta fácil de seguir:
Una decisión de diseño sutil pero importante garantiza la solidez del sistema: las decisiones de directiva viajan en un HTTP 200 normal con un campo de veredicto, mientras que los fallos reales de infraestructura emergen como errores 5xx. Con la estrategia recomendada Enforce But Ignore On Error, una interrupción temporal deja pasar el tráfico, pero un bloqueo de directiva real siempre detiene la solicitud. Para reglas críticas de seguridad, puede cambiar a una aplicación estricta y optar por bloquear en caso de error (fail closed).
Empiece hoy mismo
Proteger su AI no debería ser como rehacer la arquitectura desde cero. Con Arthur AI en TrueFoundry AI Gateway, la validación en tiempo real está más cerca de pulsar un interruptor que de un proyecto complejo de cableado: despliegue el wrapper, añada dos configuraciones de guardrail, vincúlelas a sus modelos y estará validando prompts y respuestas en toda su infraestructura.
Para ver exactamente cómo funciona, consulte la guía de integración de Arthur AI en la documentación de TrueFoundry, donde se detallan paso a paso la configuración completa, el contrato de respuesta y la configuración de comprobaciones personalizadas.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada