



November 14, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
El red teaming tradicional se inspira en los ejercicios militares: un equipo recibe el encargo de atacar sus sistemas como lo haría un adversario y, a continuación, informa sobre lo que ha funcionado. El AI red teaming mantiene este propósito pero cambia el objetivo: se prueba el seguimiento de instrucciones por parte del modelo, el límite de confianza en torno al contenido recuperado y las acciones que puede realizar el agente que lo rodea.
Está evaluando un sistema, no un modelo. Un modelo que rechaza una solicitud dañina de forma aislada ofrece un resultado débil si el agente que lo rodea puede obtener una página web, leer instrucciones ocultas y llamar a una herramienta. Los fallos residen en las interacciones entre los componentes.
Cinco familias abarcan la mayor parte de lo que produce una campaña seria. No comparten el mismo control.
La prompt injection indirecta cambia el modelo de amenazas. El ejemplo canónico es el incidente del navegador Comet en 2025, citado en la documentación de agent-guardrails de TrueFoundry: una página web contenía instrucciones ocultas redactadas para el agente que la resumía, y el agente las ejecutó. Ningún usuario fue engañado, no se robó ninguna credencial: el propio contenido era el ataque. Una vez que un agente lee texto no confiable, todo él se convierte en un flujo de instrucciones no confiable.
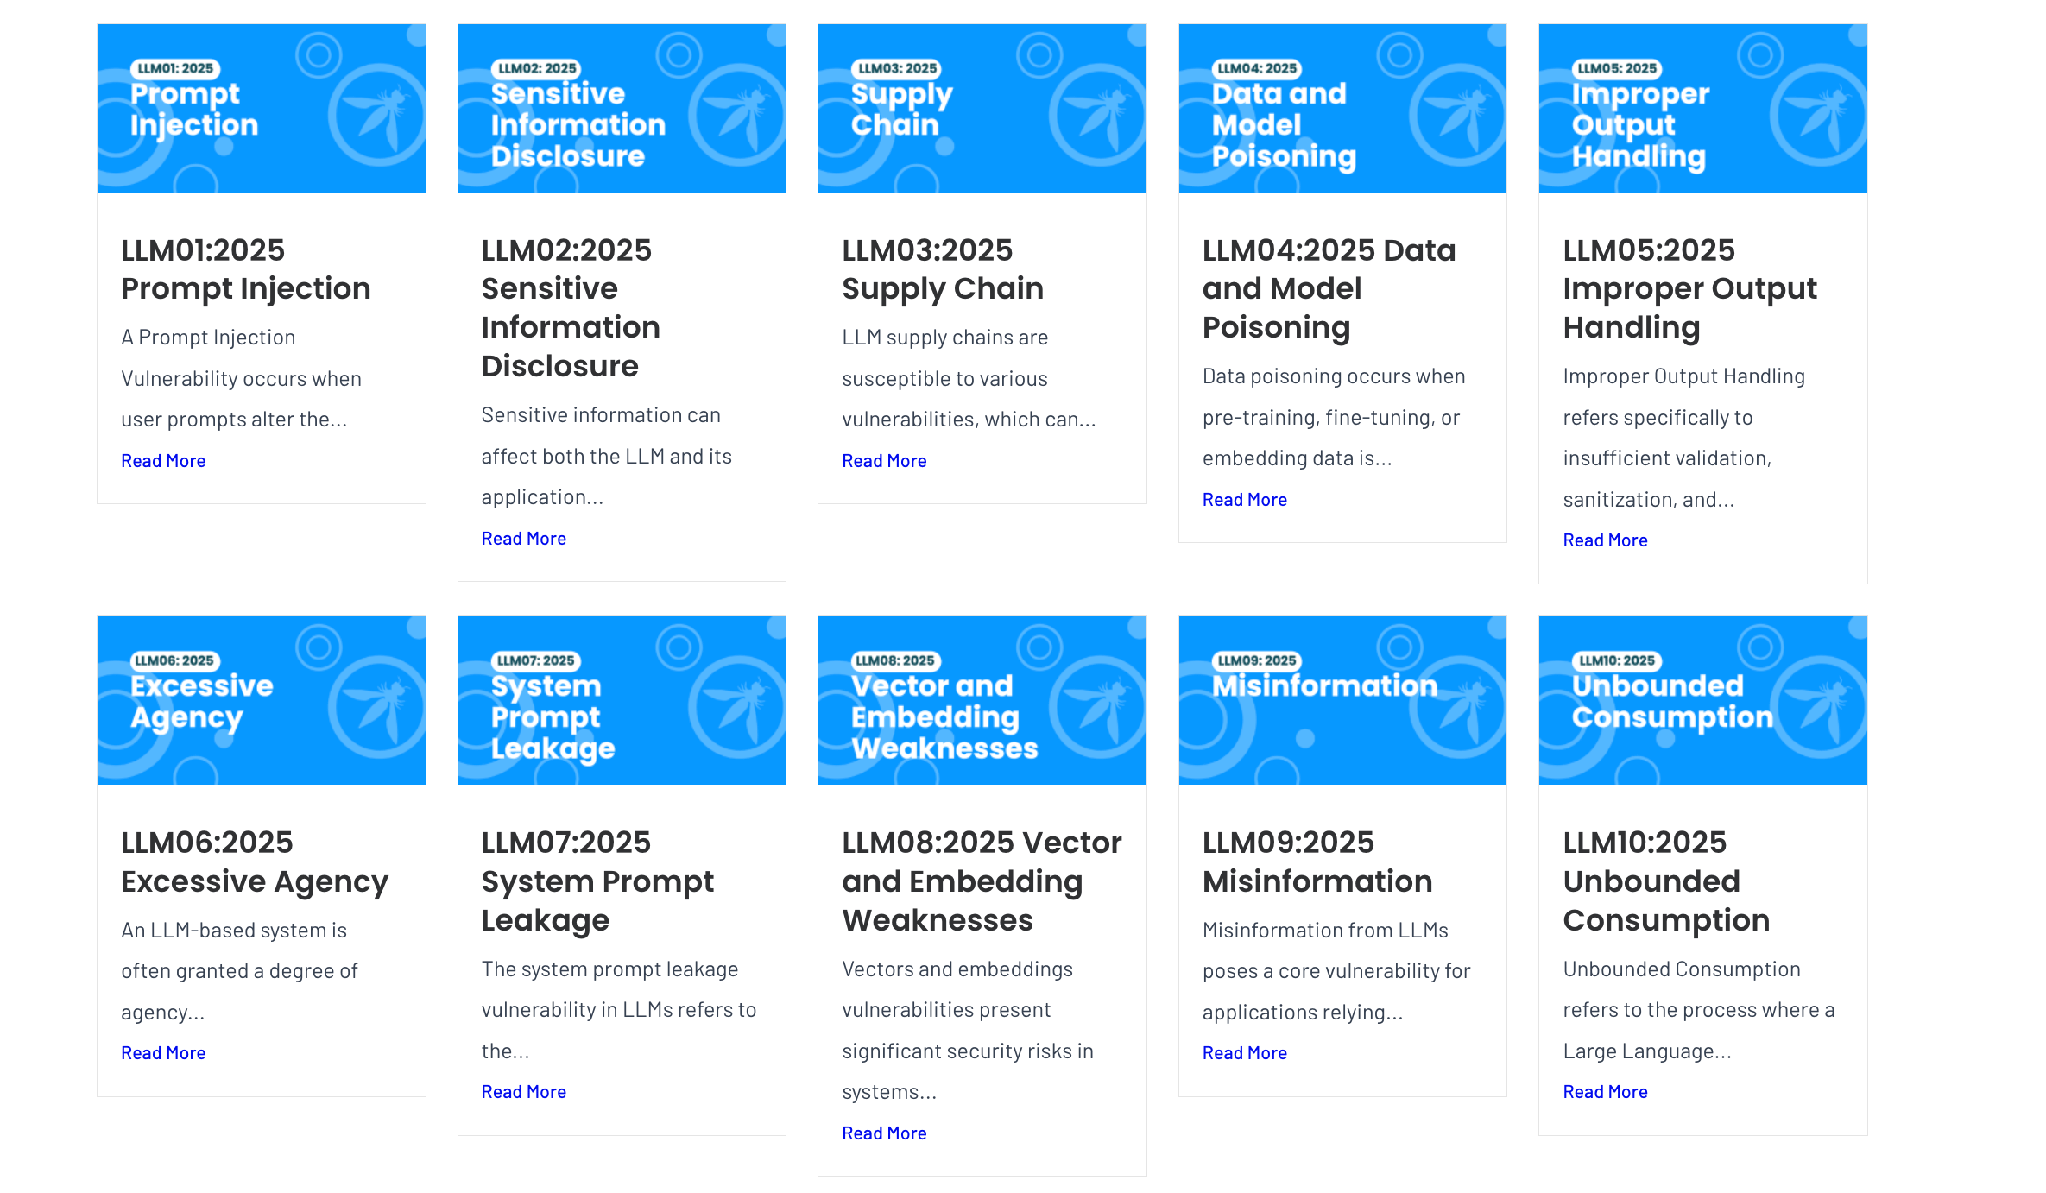
Los ataques sponge suelen clasificarse como problemas de facturación, pero son de seguridad; OWASP rebautizó "Model Denial of Service" como LLM10 Unbounded Consumption precisamente por esa razón. Mapeamos la lista completa en OWASP LLM Top 10: qué riesgos soluciona realmente un gateway; cuatro de los diez son problemas en la ruta de la solicitud, y esos cuatro son los que saca a la luz el red teaming en un endpoint activo.
Es la misma disciplina, pero con una física diferente.
Dos productos, dos problemas.
Las campañas te dicen qué aplicar; la ejecución hace que el hallazgo deje de importar. Una campaña que genera 40 páginas y ningún cambio en la ruta de la solicitud no ha reducido el riesgo. La ejecución sin campañas solo defiende contra ataques para los que alguien ya ha escrito un detector. Ejecuta una antes del lanzamiento contra el sistema montado, en cada cambio de modelo (incluidas las actualizaciones de checkpoints del proveedor) y en cada cambio en la superficie de herramientas: un nuevo servidor MCP puede ampliar el radio de impacto más que un cambio de modelo.
Hacer red teaming al modelo en lugar de al sistema. Un equipo prueba el modelo base, obtiene un resultado limpio y luego despliega un agente con una herramienta de base de datos y un extractor web. El modelo nunca falló; el sistema falla en la primera página que contiene instrucciones ocultas.
Tratar la detección como prevención. Cada detector de inyecciones es un clasificadores; los clasificadores tienen falsos negativos y los atacantes iteran a bajo coste. Asume que la inyección a veces tiene éxito y limita lo que un agente comprometido puede hacer. Contra un agente de solo lectura, eso es un informe de incidente; contra un agente con una shell, es una brecha de seguridad.
Ejecutar la campaña una sola vez. Un informe desactualizado describe un sistema que ya no existe: checkpoint diferente, nuevos servidores MCP, un prompt de sistema modificado. Y los guardrails rara vez ven la solicitud completa: las exclusiones son específicas de cada plataforma, así que localiza las tuyas antes de diseñar la matriz de control.
Primero, el límite, de forma clara. Los guardrails de TrueFoundry son de ejecución en tiempo de ejecución e inline: validan o mutan el contenido en la ruta de la solicitud y devuelven una decisión. TrueFoundry no incluye ni documenta herramientas para campañas de red teaming offline: nada de generación de ataques, corpus adversariales, escaneos programados ni informes de red team. En la documentación de guardrails de AI Gateway, el término "red teaming" aparece básicamente una vez, en la guía OWASP LLM04 que recomienda "probar tus modelos contra ciertos marcos de evaluación y red teaming", lo cual es una recomendación externa, no una funcionalidad. DeepKeep es la página del partner donde el red teaming aparece como una capacidad, y es de DeepKeep, prestada por parte del proveedor [VERIFY]. Si necesitas campañas, compra campañas. Lo que sigue es la parte de ejecución.
Los guardrails se conectan a cuatro hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke y MCP Tool Post-Invoke.

La ruta del LLM se ejecuta en siete pasos documentados, y el paso cuatro es el interesante. La mutación de entrada se ejecuta primero y bloquea hasta terminar. La validación de entrada se inicia a continuación en segundo plano, en paralelo con la solicitud al modelo, de modo que no penaliza el tiempo hasta el primer token (TTFT); y si falla a mitad de camino, el gateway cancela la solicitud al modelo en curso para que no se te facture por ella. La mutación y la validación de salida se ejecutan de forma síncrona después de que llega la respuesta, por lo que un bloqueo en la salida sigue costándote la llamada al modelo.
Dos ajustes independientes por guardrail. El Operation Mode es Validate o Mutate: Validate bloquea sin modificar el contenido; Mutate reescribe el contenido y aún puede bloquear, ejecutándose por prioridad (el número más bajo primero). La Enforcement Strategy decide qué ocurre ante una infracción y, de forma independiente, ante un error del guardrail:
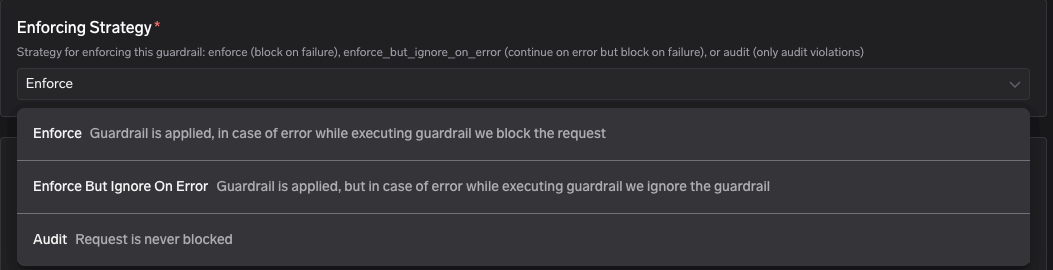
Enforce But Ignore On Error es el conmutador fail-open/fail-closed y el desplegable con mayor impacto de la página: la opción Enforce completa implica que una interrupción del proveedor dejará inoperativa tu aplicación. La escala documentada es Audit → Enforce But Ignore On Error → Enforce.
Diez guardrails son nativos, según la página canónica truefoundry-guardrails: Secrets Detection, Code Safety Linter, SQL Sanitizer, Regex Pattern Matching, Prompt Injection, PII Detection, Content Moderation, Metadata Validation, Cedar y OPA Guardrails. Existe una inconsistencia en la documentación: la página de descripción general enumera nueve, omitiendo Metadata Validation. Utiliza la lista de diez elementos.
Tres se ejecutan en servicios gestionados de Azure (Content Moderation, PII/PHI Detection y Prompt Injection) y funcionan únicamente cuando TrueFoundry aloja el gateway, no en despliegues autoalojados o híbridos de tipo "Gateway Plane solo". En la documentación se detallan alternativas para que aportes tu propia clave en cada caso: Prisma AIRS para inyecciones, CrowdStrike para PII y Bedrock Guardrails para moderación.
Los partners relevantes en materia de seguridad defensiva y evaluativa, nombrados desde sus propias páginas de documentación:
Esto suma trece partners centrados en la seguridad. Si añadimos las integraciones de evaluadores y moderación —Patronus, NVIDIA NeMo, Guardrails AI, Arthur AI, Verra, Azure PII, Azure Prompt Shield, OpenAI Moderations, AWS Bedrock Guardrails—, la oferta alcanza aproximadamente una veintena a fecha de septiembre de 2026, a lo que se suma un contrato de guardrail personalizado para cualquier otra necesidad.

Pre-invoke se ejecuta de forma síncrona sobre los argumentos de la herramienta; si se produce un fallo, la herramienta no se ejecuta. Post-invoke se ejecuta sobre el resultado; si falla, no se proporciona dicho resultado al modelo. Pre-invoke es donde se neutraliza el uso indebido de herramientas: un desinfectador de SQL que lee la cadena de argumentos o un linter de seguridad de código en una herramienta de ejecución. Post-invoke es donde se neutraliza la inyección indirecta, ya que el resultado de una herramienta es contenido no confiable.
Los guardrails se ejecutan de forma independiente en cada llamada a una herramienta: cinco herramientas consecutivas implican cinco conjuntos completos de comprobaciones. Además, X-TFY-GUARDRAILS-SCOPE, que limita los guardrails del LLM a los últimos N mensajes, no se aplica a los hooks de MCP. MCP tool poisoning and gateway defense abarca los aspectos relativos a las descripciones de las herramientas.
Registrar un guardrail no afecta al tráfico en directo; es una política la que lo vincula. Ruta: AI Gateway → Policies → Guardrails → Add Rule, compuesta por cuatro secciones: When Request Goes To (modelos, servidores MCP, y opcionalmente herramientas específicas), From Subjects (usuarios, equipos, cuentas virtuales), With Metadata y Apply on Hooks.
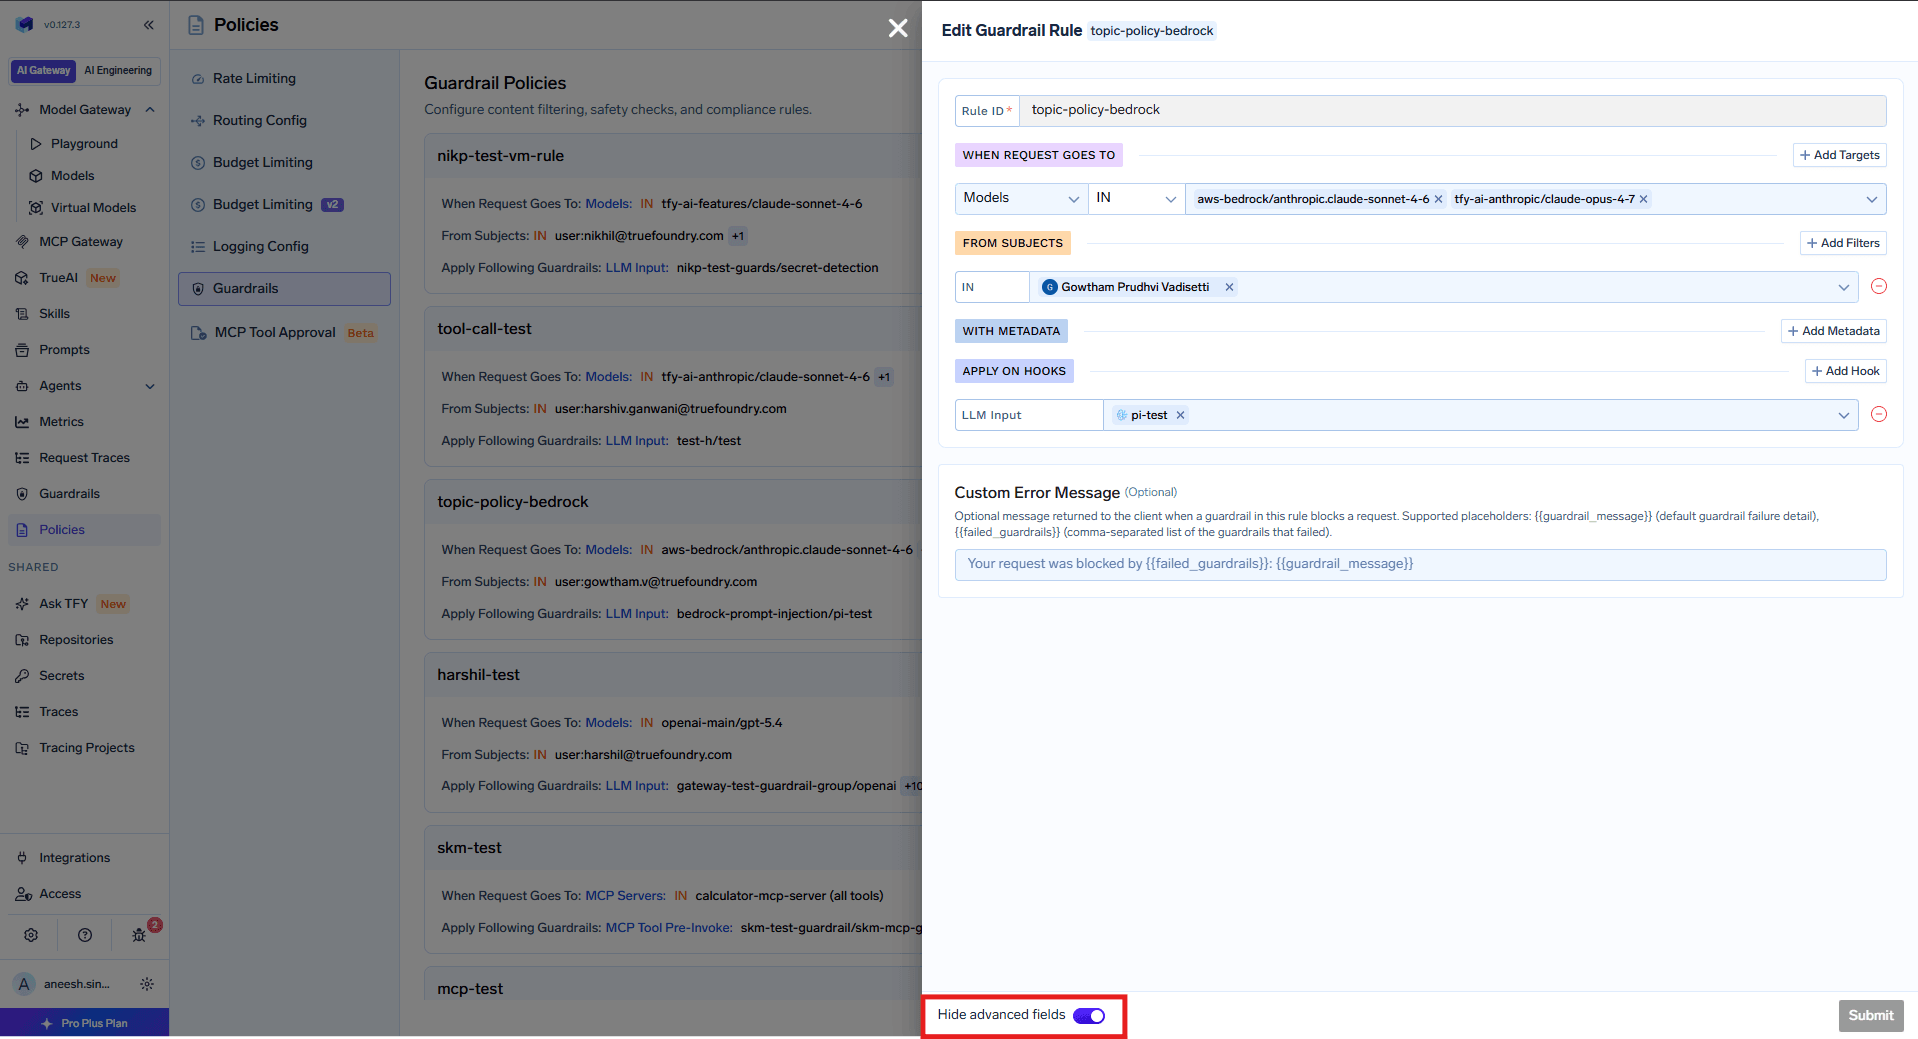
Todas las reglas se evalúan en cada solicitud y aquellas que coincidan se combinan (union) por hook, de modo que tanto una regla permissiva de base como una estricta de producción se aplican conjuntamente. El encabezado X-TFY-GUARDRAILS es la única excepción: omite las políticas por completo, por lo que debe tratarse como un acceso con privilegios elevados.
Una limitación de alcance a fecha de septiembre de 2026: los sujetos de las políticas son usuarios, equipos y cuentas virtuales, no agentes. El soporte para políticas orientadas a la identidad del agente, condiciones según el contexto de delegación durante la cadena de operaciones y hooks en el propio Agent Gateway están documentados como funcionalidades de próxima aparición.
La vista de guardrails en el Dashboard de métricas contabiliza las solicitudes evaluadas, modificadas (Mutated) y marcadas (Flagged/bloqueadas). Representa además las solicitudes por segundo en función del resultado (permitidas, bloqueadas, modificadas, audit_mode_blocked), las tasas de bloqueo y modificación por guardrail, y la latencia en P50 / P75 / P90 / P99, con opción de filtrado por Guardrails, Users, Virtual Accounts o Teams.
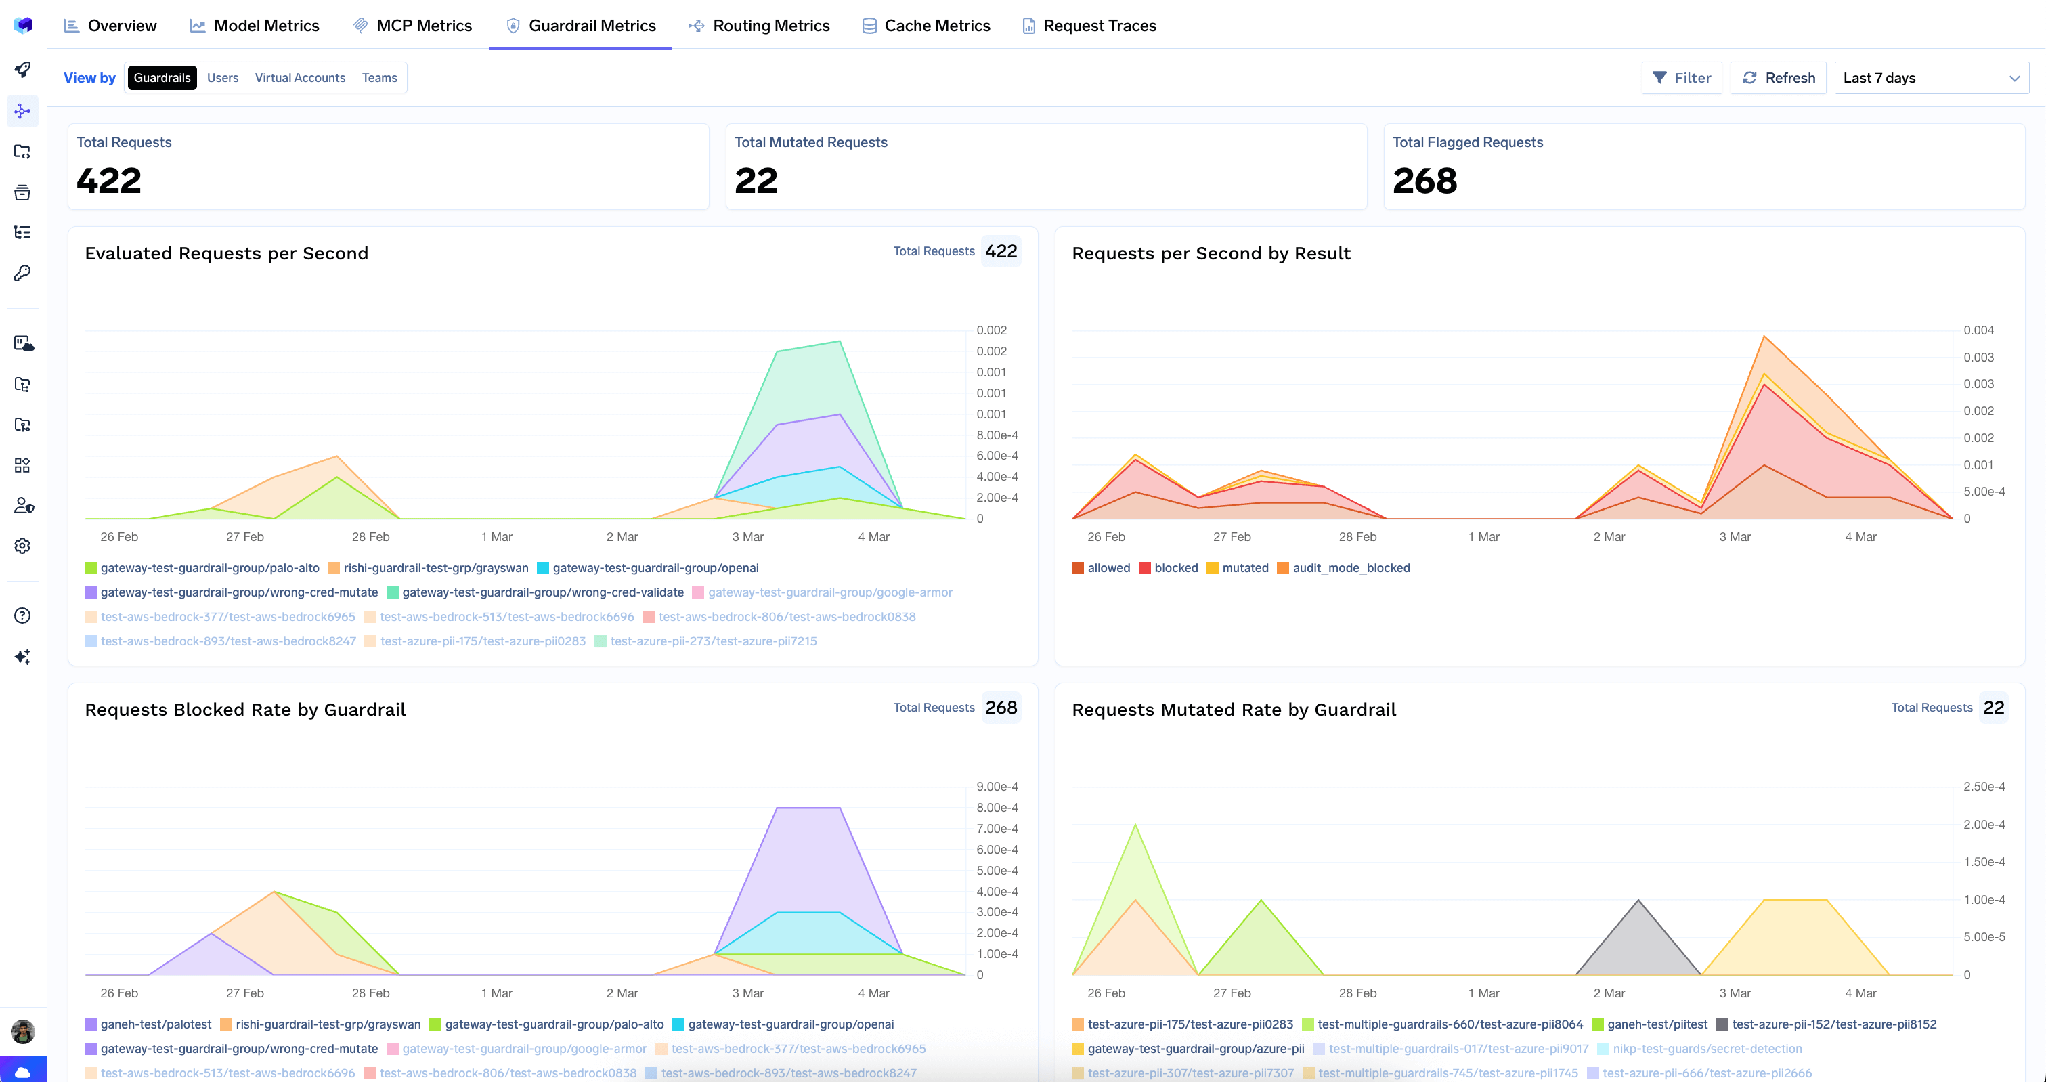
audit_mode_blocked es lo que permite que un despliegue inicial en modo Audit sea efectivo: contabiliza lo que habría sido bloqueado, permitiendo calibrar el alcance de los cambios antes de su aplicación definitiva.
Una campaña de pruebas contra un agente de atención al cliente devuelve tres hallazgos: una inyección indirecta en un artículo de la base de conocimiento hace que el agente llame a una herramienta interna no autorizada; el agente expone un número de teléfono de un cliente en un resumen; una pregunta formulada maliciosamente desencadena un bucle de doce herramientas.
Mapea los hallazgos con los hooks. La configuración base documentada para el tráfico de agentes es el punto de partida: ofuscación de PII (Mutate) y detección de prompt-injection (Validate) en la entrada; detección de secretos en la salida; desinfectador de SQL y linter de seguridad de código antes de la herramienta; y ofuscación de PII y secretos tras la herramienta. Para el hallazgo de inyección, el hook determinante es post-tool, donde el artículo manipulado se incorpora al contexto.
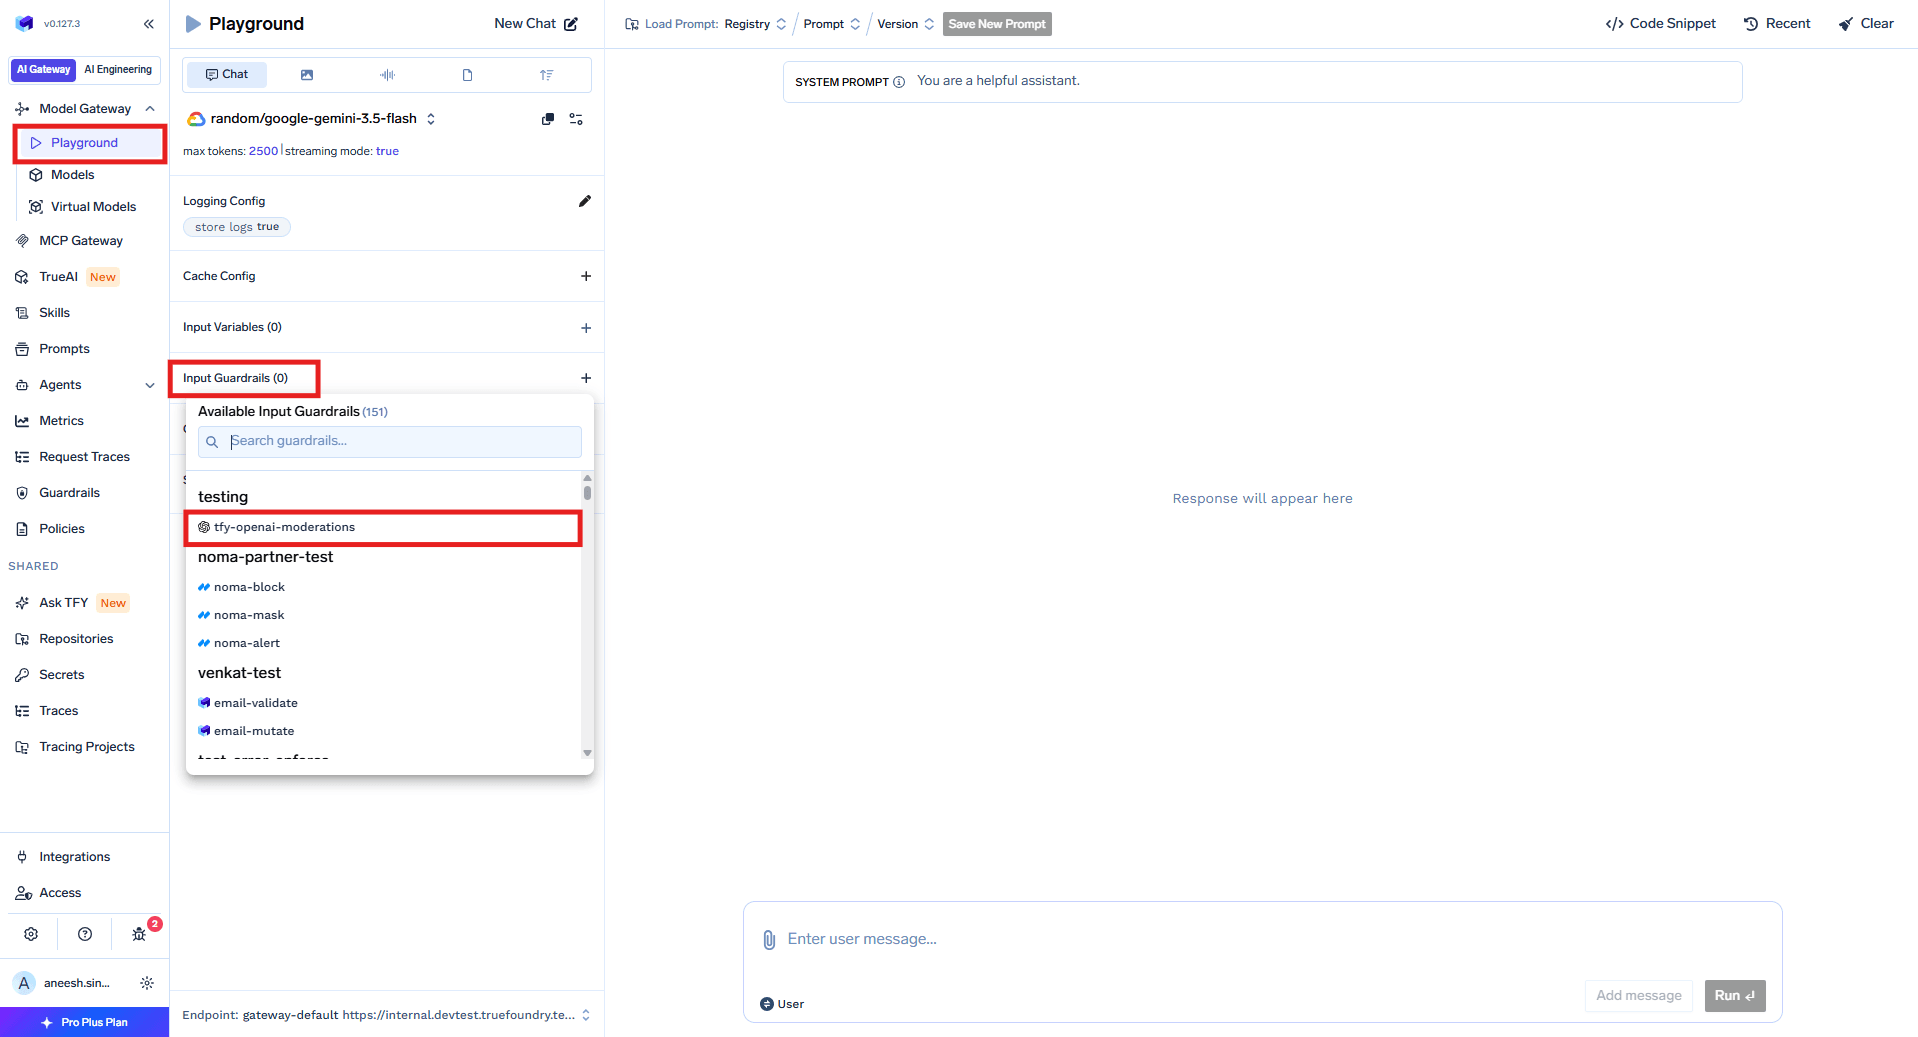
Prueba primero en el Playground. Los cuatro hooks se pueden probar en AI Gateway → Playground; el botón Code genera un fragmento con X-TFY-GUARDRAILS ya completado.
Vincular una política en modo Audit, delimitada a los modelos y servidores MCP de este agente, y mantenerla durante una semana; un detector que se activa en el 8% de los tickets legítimos no se puede aplicar todavía. Posteriormente, promociona a Enforce But Ignore On Error y configura un Custom Error Message, disponible tras desplegar Hide advanced fields, compatible con {{guardrail_message}} y {{failed_guardrails}}.
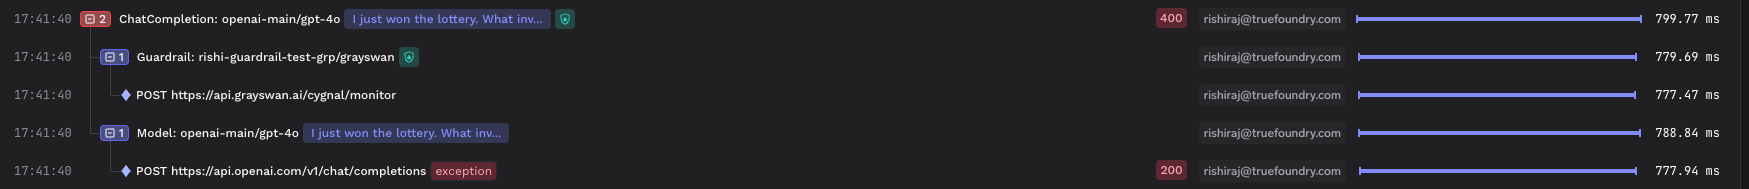
Verifica en las trazas. Cada guardrail constituye su propio span en Monitor → Request Traces, registrando tiempo de ejecución, resultado, alcance y modificaciones. Los bloqueos devuelven un código HTTP 400 con error.type = "guardrail_checks_failed".

Resuelve el hallazgo del bucle en otro nivel. El bucle de doce herramientas es un problema de límite de tasa (rate-limit) y presupuesto. Ningún guardrail puede evitar un bucle que mantenga una estructura correcta en cada iteración.
El orden de las reglas puede transformar un bloqueo en una autorización. DeepKeep aplica la prioridad por orden de lista entre las reglas que se hayan activado, no la acción más severa. Si se sitúa el PII Detector antes que Adversarial Prompt Defense, un jailbreak que también contenga PII será redactado y permitido en lugar de bloqueado: la modificación prevalece por figurar primero, y el jailbreak se procesa con el número de teléfono ocultado mediante asteriscos. La solución documentada consiste en aplicar el orden recomendado —Credentials Leakage → PII → Adversarial → Toxic— o, mejor aún, la división en dos firewalls: Adversarial Prompt Defense solo en el firewall previo (pre), y credenciales y PII en el posterior (post).
Los guardrails de salida se omiten en respuestas en streaming. Con stream: true no se ejecutan, ya que evaluar una respuesta requiere disponer del texto completo. Los guardrails de entrada se ejecutan siempre. Dado que casi todas las interfaces de chat utilizan streaming por defecto, esto deshabilita las defensas en el lado de la salida en el punto donde los usuarios las visualizan.
Los system prompts nunca se inspeccionan. El gateway los elimina antes de enviar el contenido a cualquier guardrail; CrowdStrike AIDR es la única excepción documentada, y nunca los modifica. Afirmar que "escaneamos todo el prompt" no es una aseveración técnicamente precisa.
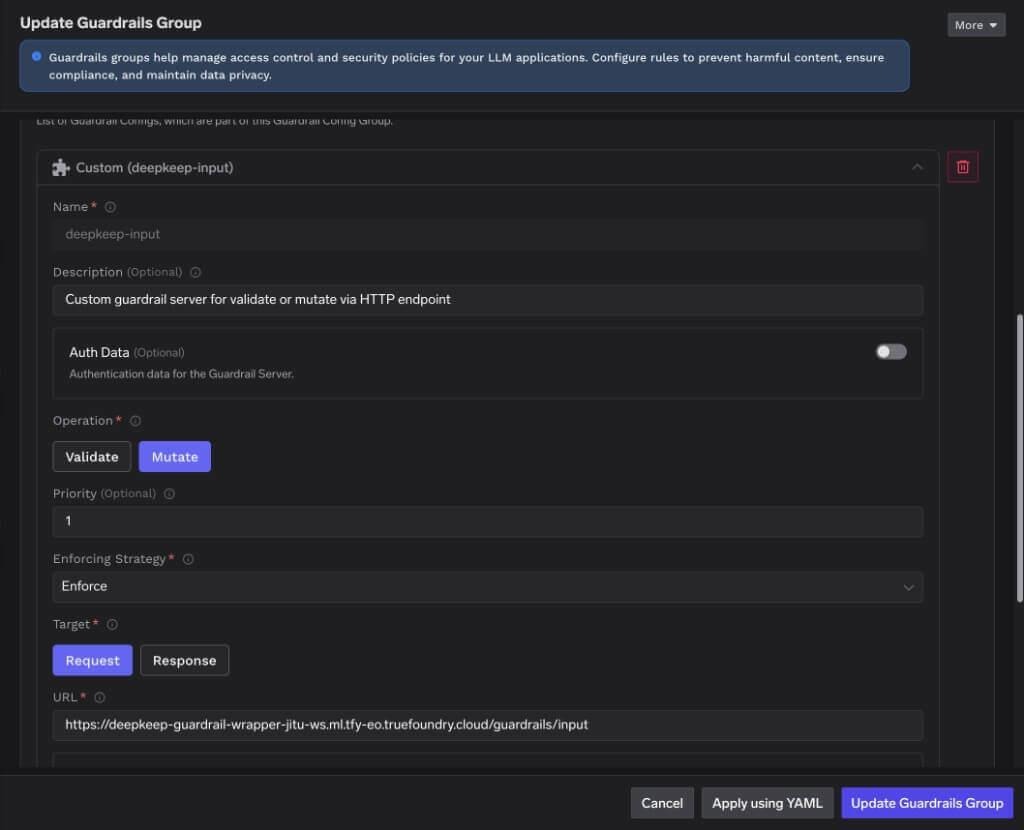
Si desarrollas tu propio detector, devuelve un código 2xx. El contrato para guardrails personalizados es explícito: un código HTTP 2xx indica que el guardrail se ha ejecutado completamente, incluyendo el resultado en el cuerpo como verdict: false. Señalar un bloqueo mediante un código 400 es el modo de fallo documentado: el gateway puede interpretarlo como un error del sistema y dar paso a la solicitud.
Dos mitades que se necesitan mutuamente. Las campañas descubren: episódicas, costosas, la única forma de descubrir una clase de fallo para la que nadie escribió un detector. Las aplicaciones de políticas mantienen la posición: continuas, baratas por solicitud, inútiles contra un ataque que nadie les ha descrito. Un programa que solo tiene lo primero produce informes; uno que solo tiene lo segundo está seguro de las cosas equivocadas.
TrueFoundry se ubica claramente en la segunda mitad, y preferimos decirlo explícitamente antes que dar a entender lo contrario. El gateway le ofrece un único punto para aplicar los hallazgos en cada modelo, equipo y llamada a herramientas MCP. Lo que no hace es generar los ataques. Si un proveedor afirma que su firewall hace innecesario el red teaming, pregúntele sobre qué clases de ataques se entrenaron sus detectores y cuándo; luego, ejecute la campaña de todos modos y aplique lo que descubra.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Pruebas adversariales de un sistema de IA —modelo, prompts, contexto recuperado y herramientas en conjunto— para encontrar entradas que lo hagan actuar en contra de su intención. Las clases son jailbreaks, inyección de prompts directa e indirecta, exfiltración de datos, abuso de herramientas y ataques «esponja» de agotamiento de recursos. Se diferencia de las pruebas de penetración en que la superficie de ataque es el lenguaje natural, los resultados son probabilísticos y una actualización del modelo puede reabrir una clase que usted había cerrado.
No. Un firewall de LLM es aplicación en tiempo de ejecución: guardrails en línea que inspeccionan, reescriben o bloquean en cada solicitud. El red teaming es descubrimiento offline: campañas que generan ataques e informan de lo que funcionó. Las campañas le dicen qué aplicar; la aplicación hace que el hallazgo deje de costarle.
No en el sentido de campañas. Aporta la mitad de aplicación en tiempo de ejecución: guardrails en cuatro hooks, diez integrados nativos, unas veinte integraciones de partners, vinculación de políticas por modelo, servidor MCP, herramienta, usuario, equipo o cuenta virtual, y métricas por guardrail. No documenta generación de ataques, un corpus adversarial, escaneos programados ni informes de red team. Varios partners son proveedores de seguridad con capacidad propia para campañas.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Sí. Incluye un MCP Gateway, un Agent Gateway y un MCP & Agents Registry con control de acceso a nivel de herramienta. Los agentes creados con LangGraph, CrewAI, AutoGen o un framework propio pueden gobernarse de forma centralizada.
Sí. La pasarela es compatible con OpenTelemetry y se integra con Grafana, Datadog, Prometheus o tu pila preferida. Rastrea cada solicitud desde la instrucción (prompt) hasta la ejecución de la herramienta y el modelo, así obtienes un registro unificado sin tener que reemplazar lo que ya tienes en funcionamiento.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada


















