



October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!

In diesem Beispiel trainieren wir ein Modell, das eine Blume der Gattung Iris basierend auf Größenmessungen ihrer Kron- und Kelchblätter in eine von drei Arten klassifizieren kann.
Sie können diesem Beispiel auch in einem Google Colaboratory Notebook folgen.
Der Iris-Datensatz enthält drei verschiedene Arten:
Wir müssen einen Klassifikator bauen, der die Art der Blume anhand der folgenden Parameter identifizieren kann:
TrueFoundry bietet zwei Bibliotheken zur Vereinfachung Ihrer ML-Workflows:
Die mlfoundry-Bibliothek wird verwendet, um ML-Trainings-Experimente zu tracken.
Warum benötigen Sie Experiment-Tracking? Wenn Sie mehrere ML-Modelle trainieren, um ein Problem zu lösen, werden Sie wahrscheinlich mehrere Modelle mit mehreren Frameworks, Hyperparametern und mehreren Datensätzen trainieren. Das Tracking Ihres Experiments mit einer Bibliothek wie mlfoundry kann Ihnen helfen, Ihre ML-Experimente zu organisieren.
Sie können MLFoundry verwenden, um Hyperparameter, Metriken, Datensätze und Modelle zu loggen. Sie können dann verschiedene Experimente auf dem TrueFoundry Dashboard vergleichen und ein Modell für das Deployment in der Produktion auswählen oder sich für ein erneutes Training des Modells entscheiden.
Wir werden in diesem Beispiel 5 verschiedene APIs von MLFoundry verwenden. Diese sind:
Mit der servicefoundry-Bibliothek können Sie ein Modell einfach verpacken, containerisieren und in einem Kubernetes-Cluster deployen.
Öffnen Sie ein IPython Notebook – Sie können entweder Jupyter lokal auf Ihrem Rechner oder ein Google Colab Notebook in der Cloud verwenden.
Installieren Sie die erforderlichen Bibliotheken.
Melden Sie sich bei TrueFoundry an. Erstellen und kopieren Sie einen API-Schlüssel von der Einstellungsseite. Verwenden Sie diesen API-Schlüssel, um den MLFoundry-Client zu initialisieren und einen Run zu erstellen. Ein Run ist eine Entität, die ein einzelnes Experiment repräsentiert.
Rufen Sie den Iris-Datensatz mit dem sklearn.datasets-Modul ab. Wir teilen ihn dann in Test- und Trainings-Datensätze auf.
Lassen Sie uns einen Blick auf die Target-Namen werfen. Wir werden diese verwenden, um die Ganzzahl-Ausgabe des Modells den tatsächlichen Namen der Arten zuzuordnen.
Initialisieren Sie ein Modell. Verwenden Sie dann MLFoundry, um die Parameter des Modells zu loggen und einige Tags für diesen aktuellen Experiment-Run zu erstellen.
Als Nächstes trainieren wir das Modell auf unserem Trainings-Datensatz. Sobald das Training abgeschlossen ist, berechnen wir die verschiedenen Metriken und loggen sie mit log_metrics in MLFoundry.
Wenn wir mit den Accuracy Scores und anderen Metriken zufrieden sind, können wir uns dafür entscheiden, das aktuelle Modell zu deployen. Dafür müssen wir das Modell speichern und die aktuelle Run-ID kopieren.
Sie können alle Ihre Runs sehen und Metriken über das TrueFoundry Experiment-Tracking-Dashboard vergleichen.

Um das Modell mit ServiceFoundry zu deployen, müssen wir eine Python-Datei erstellen, die die Funktion enthält, die wir als Endpunkt bereitstellen möchten.
In dieser Python-Datei rufen wir das Modell ab, das wir gerade trainiert und gespeichert haben, unter Verwendung der Run-ID mit mlfoundry. Beachten Sie, dass der von mlfoundry benötigte API-Schlüssel als Umgebungsvariable TFY_API_KEY verfügbar sein wird.
Erstellen Sie in Ihrem IPython Notebook einen Block mit den folgenden Inhalten und führen Sie ihn aus, um eine Python-Datei namens predict.py zu erstellen. Wir verwenden den Jupyter-Magic-Befehl %%writefile, um die Datei in der Notebook-Umgebung zu erstellen.
Innerhalb der species-Funktion laden wir die Features in einen pandas DataFrame und führen die Vorhersage mit dem Modell durch. Wir übersetzen von der Ganzzahl-Klasse in Artnamen unter Verwendung von target_names, die wir während des Trainings ausgegeben haben.
Das ist im Wesentlichen die gesamte Arbeit, die Sie erledigen müssen. Lassen Sie uns dieses Modell nun als API-Service deployen. Installieren und importieren Sie zuerst servicefoundry in Ihrem Notebook. Melden Sie sich bei servicefoundry an.
Gehen Sie zum TrueFoundry Dashboard und erstellen Sie einen Workspace, um den Service zu deployen. Workspaces sind eine Möglichkeit, zusammengehörige Projekte innerhalb von TrueFoundry zu gruppieren. Sobald der Workspace erstellt ist, kopieren Sie den FQN, damit wir servicefoundry mitteilen können, wo das Modell deployt werden soll.

Die servicefoundry-Bibliothek ermöglicht es Ihnen, alle Abhängigkeiten der gerade erstellten Datei mit der Funktion gather_requirements zu erfassen.
Erstellen Sie nun ein sfy.Service-Objekt, geben Sie den Workspace-FQN an und deployen Sie es durch Aufruf von .deploy()
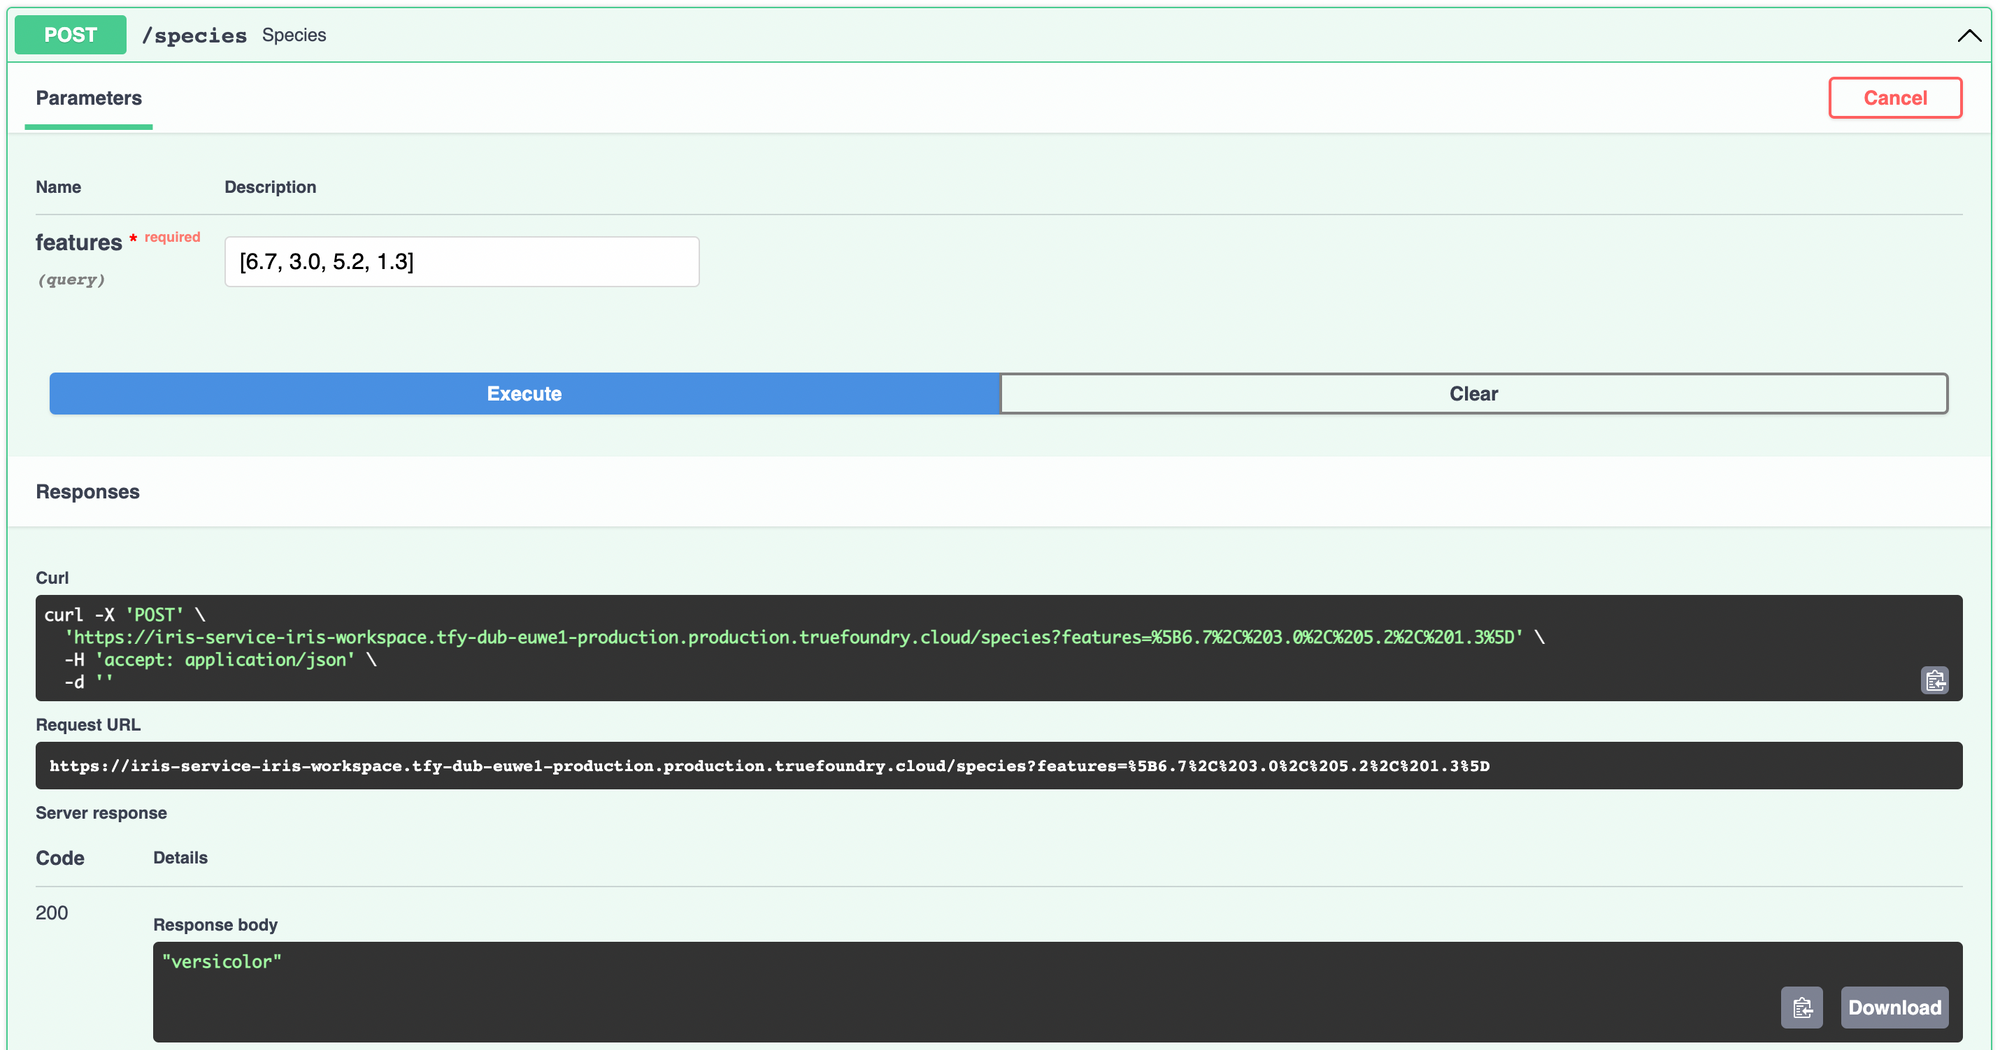
Sie können den Fortschritt dieses Deployments auf dem Dashboard verfolgen. Sobald das Deployment abgeschlossen ist, können Sie von dort auf den deployten Service zugreifen und ihn ausprobieren.
Das TrueFoundry Dashboard verlinkt auch auf Metriken und Logs, die bei TrueFoundry Deployments direkt in Form von Grafana Dashboards enthalten sind. Sie können hier mehr darüber lesen.

Sie können auch interaktive UI-Anwendungen und Gradio-Anwendungen einfach aus einem IPython Notebook heraus mit servicefoundry deployen. Lesen Sie dieser Anleitung, um zu sehen, wie.
Wir arbeiten daran, die Integration zwischen Experiment-Tracking und Deployment noch enger und das Erlebnis noch angenehmer zu gestalten. Sie können über andere Dinge, die Sie mit TrueFoundry tun können, in unserer Dokumentation nachlesen. Wenn Sie Machine-Learning-Modelle trainieren, um ein Problem zu lösen, hilft Ihnen TrueFoundry dabei, verschiedene Experimente zu tracken, und macht es einfach und intuitiv, Modelle mit Best Practices zu deployen und sie innerhalb von Minuten für die öffentliche Nutzung verfügbar zu machen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















