August 26, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Transformer haben sich als bahnbrechende Technologie etabliert, die die Art und Weise, wie Computer menschliche Sprache verstehen, grundlegend verändert hat. Im Gegensatz zu herkömmlichen Modellen, die Wörter nacheinander verarbeiten, können Transformer einen ganzen Satz auf einmal erfassen, was sie unglaublich effizient bei der Erfassung sprachlicher Nuancen macht. Der Transformer wurde erstmals in der Arbeit mit dem Titel Attention Is All You Needvorgestellt. Sie wurden hauptsächlich entwickelt, um Aufgaben zu lösen, bei denen eine Eingabesequenz in eine Ausgabesequenz umgewandelt wird, wie etwa bei der Sprachübersetzung oder der Umwandlung von Text in Sprache.
Sprachmodelle haben einen langen Weg zurückgelegt und sich von einfachen, regelbasierten Algorithmen zu hochentwickelten neuronalen Netzen entwickelt. Anfangs konnten diese Modelle nur vordefinierte Regeln befolgen oder die Häufigkeit von Wörtern zählen. Dann kamen statistische Modelle, die Wörter basierend auf den vorangegangenen vorhersagten, aber bei längeren Sätzen an ihre Grenzen stießen. Die Einführung neuronaler Netze, insbesondere RNNs und LSTMs, markierte eine deutliche Verbesserung, da die Modelle nun mehr Kontext speichern konnten. Sie verarbeiteten Text jedoch weiterhin sequenziell, was ihr Verständnis komplexer Sprachstrukturen einschränkte.
Transformer haben die Sprachverarbeitung durch ihre Fähigkeit revolutioniert, alle Teile eines Satzes gleichzeitig zu verarbeiten. Dies beschleunigt nicht nur die Verarbeitungszeit, sondern ermöglicht auch ein tieferes Verständnis des Kontexts, unabhängig davon, wie weit Wörter in einem Satz voneinander entfernt sind. Die Grundidee hinter Transformern ist der „Self-Attention-Mechanismus“, der es dem Modell ermöglicht, die Bedeutung jedes Wortes in einem Satz im Verhältnis zu allen anderen zu gewichten. Dieser Technologiesprung hat Fortschritte bei der maschinellen Übersetzung, der Inhaltserstellung sowie beim Verständnis und der Generierung menschenähnlicher Texte vorangetrieben und einen neuen Standard im Bereich NLP gesetzt.
In diesem Blogbeitrag werden wir die Architektur des ursprünglichen Transformers im Detail untersuchen.
Transformer, eine neuartige KI-Architektur, haben neue Maßstäbe dafür gesetzt, wie Maschinen Sprache verstehen und generieren. Im Kern gibt es mehrere entscheidende Konzepte, die sie außergewöhnlich gut bei der Verarbeitung riesiger Textdatenmengen machen. Lassen Sie uns in diese Kernkonzepte eintauchen und die Architektur sowie die Schlüsselkomponenten, die Transformer definieren, aufschlüsseln.
Die Architektur von Transformern ruht auf zwei Säulen: dem Encoder und dem Decoder. Der Encoder liest und verarbeitet den Eingabetext und wandelt ihn in ein Format um, das das Modell verstehen kann. Stellen Sie es sich so vor, als würde er einen Satz aufnehmen und ihn in seine Essenz zerlegen. Auf der anderen Seite nimmt der Decoder diese verarbeiteten Informationen und arbeitet sie Schritt für Schritt durch, um die Ausgabe zu erzeugen, etwa bei der Übersetzung des Satzes in eine andere Sprache. Dieses Zusammenspiel macht Transformer so leistungsfähig für Aufgaben wie die Übersetzung, bei denen das Verständnis von Kontext und die Generierung präziser Antworten entscheidend sind.
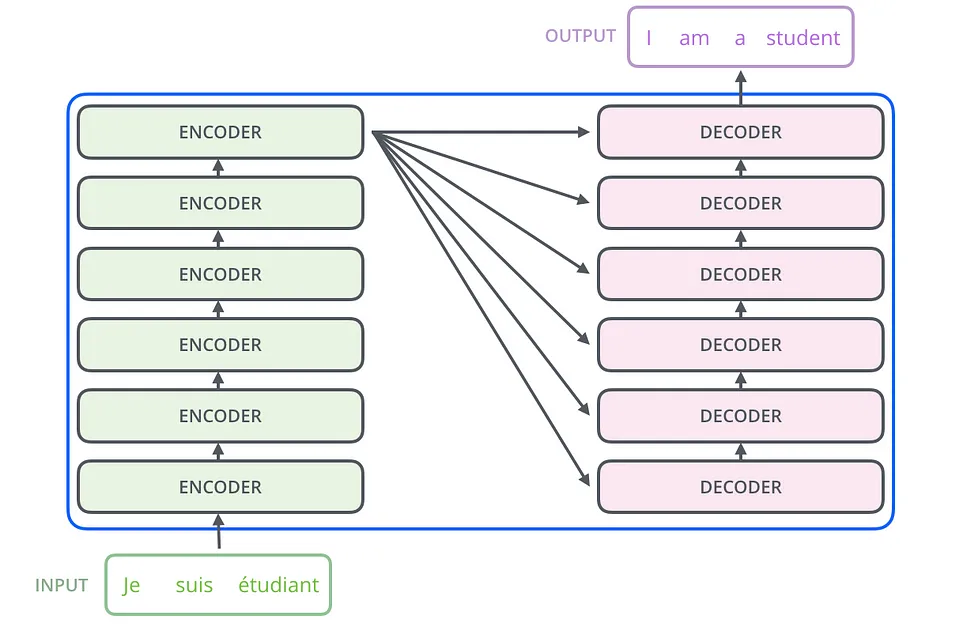
Das Herzstück des Encoders und Decoders eines Transformers ist der Self-Attention-Mechanismus. Er ermöglicht es dem Modell, die Bedeutung jedes Wortes in einem Satz im Verhältnis zu jedem anderen Wort zu gewichten. Im Gegensatz zu älteren Modellen, die bei langen Sätzen den Überblick über frühere Wörter verlieren könnten, behalten Transformer daher ein umfassendes Verständnis des gesamten Kontexts bei.

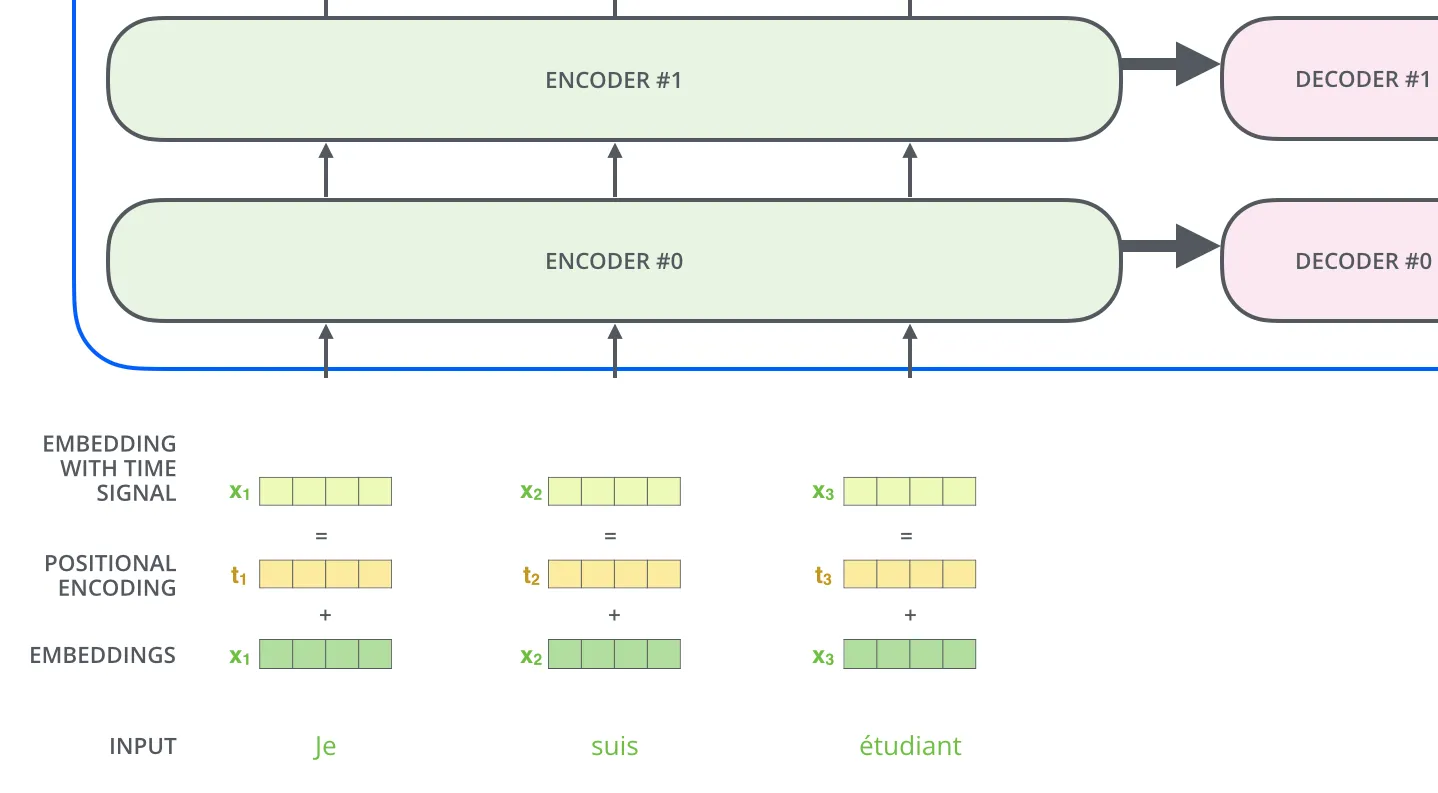
Da Transformer alle Wörter eines Satzes gleichzeitig verarbeiten, benötigen sie eine Möglichkeit, die Wortreihenfolge zu verstehen – hier kommt das Positional Encoding ins Spiel. Jedes Wort erhält einen eindeutigen Code, der seine Position im Satz repräsentiert. Dadurch kann das Modell den Fluss und die Struktur der Sprache erfassen, was für das Verständnis der Satzbedeutung entscheidend ist.
Aufbauend auf dem Konzept der Self-Attention ermöglicht Multihead Attention dem Modell, den Satz aus verschiedenen Perspektiven zu betrachten. Durch die Aufteilung des Attention-Mechanismus in mehrere „Köpfe“ können Transformer verschiedene Aspekte des Textes, wie Grammatik und Semantik, gleichzeitig verarbeiten, was zu einem tieferen Verständnis der Eingabe führt.

Ein tieferer Einblick in die Mechanik von Transformern offenbart eine elegante Architektur, die für komplexes Sprachverständnis und die Generierung von Sprache entwickelt wurde. Hier untersuchen wir die Feinheiten von Encoder und Decoder sowie ihr Zusammenspiel bei der Verarbeitung und Erzeugung von Sprache.
Die Hauptaufgabe des Encoders besteht darin, die Eingabesequenz zu verarbeiten. Jedes Wort im Eingabesatz wird in Vektoren umgewandelt – gehaltvolle numerische Repräsentationen, die den Kern der Wortbedeutung enthalten. Doch die Arbeit des Encoders endet hier nicht. Er muss auch den Kontext jedes Wortes verstehen – also wie es sich auf die Wörter davor und danach bezieht.
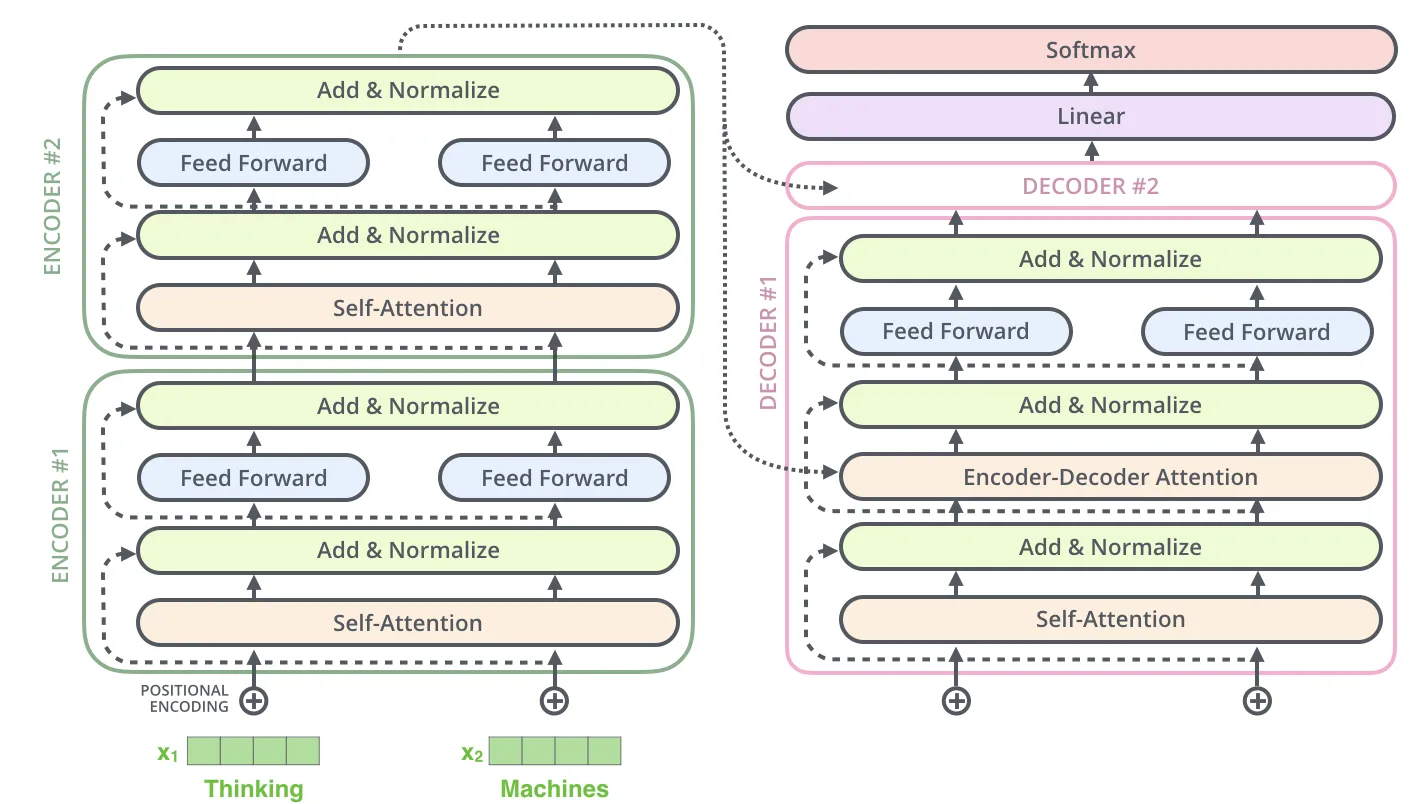
Um dies zu erreichen, nutzt der Encoder eine Reihe von Schichten, die jeweils aus Self-Attention-Mechanismen und Feed-Forward-Neuronalen Netzen bestehen. Der Self-Attention-Mechanismus ermöglicht es dem Encoder, die Bedeutung anderer Wörter im Satz zu gewichten, wenn ein bestimmtes Wort betrachtet wird. Dieser Prozess wird mathematisch durch die Generierung von Q- (Query), K- (Key) und V-Vektoren (Value) dargestellt, was ein dynamisches Verständnis des Satzkontexts ermöglicht.

Der Decoder übernimmt die Aufgabe vom Encoder und ist für die Generierung der Ausgabesequenz zuständig. Er beginnt mit einem speziellen Token, das den Anfang der Ausgabe markiert, und nutzt den vom Encoder bereitgestellten Kontext, um Wort für Wort zu generieren. Die Self-Attention-Schicht des Decoders stellt sicher, dass jedes generierte Wort basierend auf den vorangegangenen Wörtern passend gewählt wird, während die Encoder-Decoder-Attention-Schicht es dem Decoder ermöglicht, sich auf relevante Teile der Eingabesequenz zu konzentrieren.
In dieser Phase des Transformer-Modells findet die eigentliche Sprachgenerierung statt, sei es beim Übersetzen eines Satzes in eine andere Sprache, beim Zusammenfassen eines Textes oder beim Erstellen kreativer Inhalte. Die Fähigkeit des Decoders, sowohl den unmittelbaren Kontext (vorherige Wörter in der Ausgabe) als auch den breiteren Kontext (die vom Encoder verarbeitete Eingabesequenz) zu berücksichtigen, ist entscheidend für die Erzeugung kohärenter und kontextuell relevanter Sprache.
Die wahre Stärke von Transformern liegt in der Synergie zwischen Encoder und Decoder. Während der Encoder ein tiefes Verständnis des Eingabesatzes liefert, nutzt der Decoder diese Informationen, um eine präzise und relevante Ausgabe zu erzeugen. Diese Interaktion wird durch den Encoder-Decoder-Attention-Mechanismus vermittelt, der es dem Decoder ermöglicht, bei jedem Schritt des Generierungsprozesses die Ausgabe des Encoders abzufragen.
Dieser kollaborative Mechanismus stellt sicher, dass das Ergebnis nicht nur sprachlich sinnvoll ist, sondern auch eine getreue Darstellung oder Transformation der Eingabe darstellt. Genau diese Synergie zwischen Encoder und Decoder ermöglicht es Transformern, bei einer Vielzahl von Sprachverarbeitungsaufgaben zu glänzen – von der maschinellen Übersetzung bis hin zur Inhaltserstellung.
Transformer haben nicht nur das Feld der natürlichen Sprachverarbeitung (NLP) revolutioniert, sondern auch ihre Vielseitigkeit unter Beweis gestellt, indem sie ihren Anwendungsbereich auf andere Domänen ausgeweitet haben. Hier erfahren Sie, wie sie Wirkung zeigen:
Übersetzung: Transformer haben die maschinelle Übersetzung maßgeblich verbessert und bieten ein nahezu menschliches Niveau an Sprachfluss und Verständnis. Google Übersetzer ist ein Paradebeispiel dafür, wie Transformer-Modelle wie BERT und GPT entscheidend dazu beigetragen haben, die Übersetzungsqualität in zahlreichen Sprachen zu steigern.

Textzusammenfassung: Automatisierte Zusammenfassungstools, die auf Transformer-Modellen basieren, können heute prägnante Zusammenfassungen von langen Artikeln, Berichten und Dokumenten erstellen, wobei der Kontext und die Nuancen des Originaltextes erhalten bleiben. Tools wie die GPT-Serie von OpenAI waren maßgeblich an der Weiterentwicklung dieses Bereichs beteiligt und bieten Nutzern schnelle Einblicke in umfangreiche Inhalte.
Transformer haben die Grenzen von Texten durchbrochen und sind in die visuelle Welt vorgedrungen. Vision Transformer (ViT) wenden die Prinzipien der Self-Attention auf Bildpixel an und erzielen damit modernste Ergebnisse bei der Bilderkennung. Dieser Ansatz stellt herkömmliche faltende neuronale Netze (CNNs) in Frage und bietet eine neue Perspektive auf die Verarbeitung visueller Informationen.

Die Suchmaschine von Google wurde durch BERT (Bidirectional Encoder Representations from Transformers) optimiert, wodurch sie den Kontext von Suchanfragen besser verstehen kann. Dies hat die Relevanz der Suchergebnisse erheblich verbessert und die Informationssuche für Nutzer weltweit präziser gemacht.
KI-gestützte Chatbots, die auf Transformer-Technologie basieren, bieten ansprechendere und menschenähnlichere Interaktionen. Unternehmen haben diese fortschrittlichen Chatbots in ihren Kundenservice integriert, um sofortigen, kontextbezogenen Support zu bieten, was die Kundenzufriedenheit und die betriebliche Effizienz steigert.
GPT-3.5 und GPT-4 von OpenAI sind ein Meilenstein in großen Sprachmodellen, da sie eine verblüffende Fähigkeit zeigen, menschenähnliche Texte zu generieren, Fragen zu beantworten und sogar zu programmieren. Ihre Anwendungen reichen von der Inhaltserstellung bis zur Unterstützung bei Programmieraufgaben und verdeutlichen das enorme Potenzial von Transformern in verschiedenen Branchen.
Während wir uns durch die sich entwickelnde Landschaft der künstlichen Intelligenz bewegen, stehen Transformer an der Spitze dieser Reise und versprechen eine Zukunft voller Möglichkeiten. Ihre rasante Entwicklung und Integration in verschiedene Bereiche deuten auf einen Weg zu noch bahnbrechenderen Innovationen hin. Hier befassen wir uns mit den Fortschritten und zukünftigen Richtungen sowie den Herausforderungen und Chancen, die vor uns liegen.
Die Vorstellung von GPT-4 durch OpenAI stellt einen monumentalen Sprung im Bereich der großen Sprachmodelle dar und verschiebt die Grenzen dessen, was KI beim Sprachverständnis und der Textgenerierung erreichen kann. GPT-4 übertrifft seine Vorgänger nicht nur in der Größe, sondern auch in der Komplexität und bietet eine noch nuanciertere Textgenerierung, Problemlösungsfähigkeiten und ein verbessertes Verständnis für die Feinheiten der menschlichen Sprache. Der Horizont für GPT-4 erstreckt sich auf die Verbesserung der Mensch-KI-Interaktion, die Automatisierung komplexer Aufgaben und die Bereitstellung innovativer Lösungen für unzählige Anwendungen. Wenn wir über GPT-4 hinausblicken, liegt der Fokus verstärkt darauf, diese Modelle effizienter, interpretierbarer und fähiger zu machen, eine noch größere Bandbreite an Aufgaben zu bewältigen, was einen bedeutenden Schritt in Richtung wirklich intelligenter Systeme darstellt.
Wenn wir mit Modellen wie GPT-4 in die Zukunft blicken, stehen wir vor wesentlichen Herausforderungen und Chancen in Bezug auf Skalierbarkeit, Interpretierbarkeit und Ethik. Diese leistungsstarken Modelle größer und komplexer zu machen, erfordert viel Rechenleistung und Energie, was Fragen zu Kosten und Umweltauswirkungen aufwirft. Gleichzeitig ist es wichtig, dass wir verstehen können, wie diese Modelle Entscheidungen treffen, insbesondere wenn sie in wichtigen Bereichen wie dem Gesundheitswesen oder dem Finanzwesen eingesetzt werden. Darüber hinaus müssen wir die ethische Seite berücksichtigen, etwa wie die Verbreitung von Falschinformationen verhindert werden kann und welche Auswirkungen der Ersatz von Arbeitsplätzen durch KI hat. Die Bewältigung dieser Probleme erfordert Anstrengungen aller an der KI beteiligten Akteure, von Entwicklern bis hin zu Regierungsvertretern, um sicherzustellen, dass das Wachstum von Transformer-Modellen verantwortungsvoll und zum Wohle der Gesellschaft erfolgt.
Zusammenfassend lässt sich sagen, dass Transformer die Landschaft der künstlichen Intelligenz und der natürlichen Sprachverarbeitung maßgeblich verändert haben. Ihre einzigartige Architektur, die in der Lage ist, den Kontext und die Nuancen von Sprache zu verstehen, hat zu bemerkenswerten Fortschritten bei Aufgaben wie Übersetzung, Textzusammenfassung und sogar über den Bereich des Textes hinaus bei der Bilderkennung und mehr geführt.
Zu den wichtigsten Erkenntnissen gehören die Bedeutung des Self-Attention-Mechanismus, der es Transformern ermöglicht, ganze Datensequenzen gleichzeitig zu verarbeiten, sowie die innovative Verwendung von Positionskodierungen, um die Reihenfolge der Sequenzen bei der Datenverarbeitung beizubehalten. Darüber hinaus skizzieren die Skalierbarkeit dieser Modelle sowie die Notwendigkeit von Interpretierbarkeit und ethischen Überlegungen den Fahrplan für zukünftige Entwicklungen auf diesem Gebiet.
Transformer sind nicht nur ein technologischer Fortschritt; sie stellen einen Wandel in unserer Vorstellung von den Fähigkeiten der KI dar. Sie bieten einen Einblick in eine Zukunft, in der KI die menschliche Sprache mit beispielloser Tiefe und Flexibilität verstehen und mit ihr interagieren kann, was neue Wege für Automatisierung, Kreativität und Effizienz in allen Branchen eröffnet. Während wir die Grenzen der Transformer-Technologie weiter erforschen und erweitern, bleibt ihre Rolle bei der Gestaltung der Zukunft der KI entscheidend und verspricht eine Landschaft, in der die Partnerschaft zwischen Mensch und Maschine neue Höhen der Zusammenarbeit und Innovation erreicht.
Die LLM-Transformer-Architektur ist ein revolutionäres neuronales Netzwerkdesign, das gesamte Eingabesequenzen gleichzeitig verarbeitet. Im Gegensatz zu älteren Modellen nutzt es einen Self-Attention-Mechanismus, um den Kontext von Wörtern tiefgreifend zu verstehen. Dies ermöglicht es großen Sprachmodellen, menschenähnliche Texte effizient zu erfassen und zu generieren, was Fortschritte bei der maschinellen Übersetzung und der Inhaltserstellung vorantreibt.
Ja, große Sprachmodelle (LLMs) stützen sich bei der heutigen LLM-Entwicklung stark auf die Transformer-Architektur. Transformer haben die Sprachverarbeitung revolutioniert, indem sie ganze Sätze gleichzeitig verarbeiten, was das Kontextverständnis und die Verarbeitungsgeschwindigkeit verbessert. Diese Kerninnovation bleibt für moderne LLMs entscheidend, um menschenähnliche Texte zu generieren und komplexe Sprachaufgaben effizient für Benutzer auszuführen.
Ein Transformer in einem LLM ist eine KI-Architektur, die ganze Sätze gleichzeitig verarbeitet. Er verwendet einen Self-Attention-Mechanismus, um Wortbeziehungen und Kontext tiefgreifend zu verstehen. Diese bahnbrechende Technologie hat die Art und Weise revolutioniert, wie große Sprachmodelle lernen und menschenähnliche Texte generieren, was für fortschrittliche Anwendungen und ein effizientes Sprachverständnis entscheidend ist.
Die Architektur hinter Large Language Models (LLMs) ist als Transformer-Architektur bekannt. Dieses intelligente Design ermöglicht es den Modellen, menschenähnliche Texte zu verstehen und zu generieren, indem Informationen auf einzigartige Weise verarbeitet werden. Dadurch können sie komplexe Muster aus riesigen Datenmengen erlernen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet