



October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Konfigurationsmanagement ist ein wichtiger Aspekt des Software Engineerings. Dieser Artikel beleuchtet das Warum und Was des Problems und geht auf die verschiedenen existierenden Lösungen ein.

Der Ansatz zur Verwaltung der Konfiguration ändert sich mit der Skalierung der App — sowohl hinsichtlich des Datenverkehrs als auch der Größe des Entwicklerteams. Um diesen Weg zu veranschaulichen, beginnen wir mit einer einfachen App.
Dies ist eine einfache Server-App, die eine Verbindung zu MongoDB herstellt und die Liste der Benutzer zurückgibt. Der Code ist lediglich Pseudocode und soll nicht an eine bestimmte Sprache gebunden sein.

Konfiguration in der App hartcodieren: Ein SOFORTIGES NEIN!

Das Hartcodieren der MongoDB-URI in die App macht es extrem schwierig, die Anwendung in einer anderen Umgebung auszuführen — etwa auf den Laptops von Teamkollegen oder in der Production-Umgebung. Wir sollten hier der 12-Factor-App-Methodik folgen, um Konfiguration von Code zu trennen.
„TRENNEN SIE DIE KONFIGURATION VOM CODE“
Nun stellt sich die Frage: Woraus besteht die Konfiguration einer App? Zitat von https://12factor.net/config
Die Konfiguration einer App umfasst alles, was sich zwischen Deploys wahrscheinlich ändert (Staging, Production, Entwicklerumgebungen usw.). Dazu gehören:
1. Ressourcen-Handle zur Datenbank, zu Memcached und anderen Backing Services
2. Zugangsdaten zu externen Diensten wie Amazon S3 oder Twitter
3. Pro-Deploy-Werte wie der kanonische Hostname für das Deploy
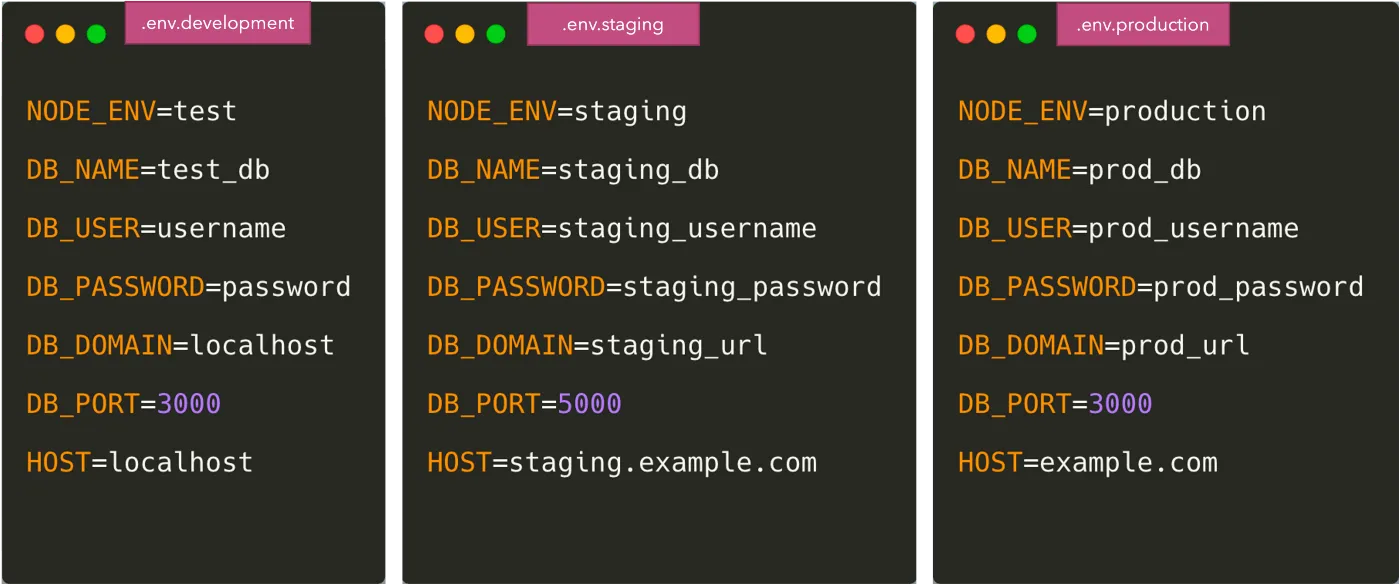
Der einfachste und gebräuchlichste Weg, die Konfiguration vom Code zu trennen, besteht darin, die Variablen in eine .env-Datei einzufügen.

Sobald wir dies tun, müssen wir die Variablen im Code aus der .env-Datei laden. Dafür gibt es verschiedene Packages wie dotenv und dotenv-expand. Die .env-Datei wird in diesem Fall nicht nach Git gepusht, und jeder Entwickler überschreibt die Variable entsprechend seiner eigenen Umgebung. Um allen Entwicklern eine Vorstellung davon zu geben, welche Umgebungsvariablen hinzugefügt werden müssen, committen wir gewöhnlich eine Datei wie .env.example nach Git.

Wir müssen auch Werte dieser Variablen in den Staging- und Production-Umgebungen bereitstellen. Fast alle Deployment-Systeme bieten eine Möglichkeit, Umgebungsvariablen zu speichern und bereitzustellen, wie ConfigMap und Secrets in Kubernetes oder S3 für Elastic Container Service.
Wir müssen diese Variablen in diese Umgebungen kopieren und sie synchron halten, wann immer Entwickler Umgebungsvariablen hinzufügen oder entfernen. Ein möglicher Ansatz besteht darin, eine separate .env-Datei für Staging-, Production- und andere Umgebungen zu haben.

Man könnte vorschlagen, diese Dateien in Git zu speichern, aber in diesem Fall gibt es ein großes Sicherheitsrisiko — insbesondere bei einigen der sensiblen Zugangsdaten in den env-Dateien.
Es werden hier unterschiedliche Ansätze genutzt — einige der bekanntesten Methoden sind jedoch:

Bei der Verwendung eines dieser externen Systeme haben wir die Konfiguration nun zwischen den .env-Dateien und den SecretManagern aufgeteilt. Einige der nicht-sensiblen Parameter stammen aus den .env-Dateien und einige aus dem Remote-Speicher für Zugangsdaten. Man kann argumentieren, dass wir alle Parameter im Remote-Speicher ablegen könnten — aber das kann manchmal zu viel des Guten sein. Was wir also letztendlich erhalten, ist:

Unsere Anwendung muss nun über Code verfügen, um aus beiden Konfigurationsquellen zu lesen. Das Lesen aus den .env-Dateien kann mit dem dotenv-Package erfolgen, das Abrufen der Umgebungsvariablen aus den SecretManagern erfordert jedoch die Nutzung der entsprechenden APIs, um die Werte zu erhalten.

Dies löst das Problem, unsere Konfiguration sicher zu halten und gleichzeitig der 12-Factor-Methodik zu folgen.
Das Schreiben von Anwendungscode zum Abrufen von Secrets wird jedoch zu einer sich wiederholenden Praxis, bei der jede Anwendung nun SecretManager-spezifischen Code hinzufügen muss, um die Werte aus der API zu erhalten. Dies bedeutet auch, dass sich der Code in allen Anwendungen ändern muss, falls wir jemals unseren SecretManager-Anbieter wechseln. Um dieses Problem zu lösen, gibt es einige Ansätze:
Konfigurationsmanagement ist komplex und sollte von Anfang an ordnungsgemäß durchgeführt werden, um sicherzustellen, dass die Entwicklergeschwindigkeit hoch bleibt, ohne Sicherheitsaspekte zu opfern. Kubernetes, das heute am häufigsten für das Deployment von Anwendungen eingesetzt wird, bringt sein eigenes Konfigurations- und Secret-Management mit, auf das ich in einem anderen Artikel näher eingehen werde. Wenn Sie außerdem eine andere Methode für das Konfigurationsmanagement nutzen, erwähnen Sie diese bitte in den Kommentaren — ich würde gerne mehr darüber erfahren und von Ihnen lernen!
TrueFoundry ist ein AI Gateway für Unternehmen, das ein LLM-, MCP- und Agent Gateway umfasst. Es ermöglicht Unternehmen, den Zugriff auf Modelle, Tools, Guardrails und Agenten über eine einzige Control Plane sicher zu verbinden, zu beobachten und zu steuern. Das AI Gateway ermöglicht Agentic Workloads, die wie folgt sind:
a) Sicher — Lösung für Schlüsselverwaltung, Authentifizierung und Autorisierung
b) Effizient — Optimierung von Kosten, Latenz und regionsübergreifenden Failovern
c) Zukunftssicher — Ermöglicht einheitliche und zusammensetzbare Verbindungen über LLMs, MCPs und Guardrails jedes Anbieters hinweg
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















