



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Large Language Models (LLMs) bieten leistungsstarke Funktionen, bringen jedoch auch hoheInfrastrukturkosten, unvorhersehbare Nutzungsmuster und das Potenzial für Missbrauch mit sich. Da Unternehmen LLMs in kundenorientierte Tools, interne Copiloten und API-Plattformen integrieren, wird die Notwendigkeit eines kontrollierten und zuverlässigen Zugriffs entscheidend. Hier spielt Rate Limiting eine Schlüsselrolle.
Im Kontext der LLM-Inferenz reicht das herkömmliche Rate Limiting auf Basis von Anfragen pro Sekunde (RPS) nicht aus. LLMs sind ressourcenintensiv, tokenbasiert und weisen eine stark schwankende Rechenlast auf. Eine einzelne Eingabeaufforderung an ein Modell mit 70 Milliarden Parametern kann Tausende von Token verbrauchen und die GPU-Latenz erheblich beeinflussen. Ohne angemessene Kontrollen kann eine gemeinsam genutzte Infrastruktur schnell instabil oder unbezahlbar werden.
Dieser Artikel erläutert, wie Rate Limiting in einemAI Gatewayfunktioniert, warum es für eine skalierbare KI-Infrastruktur unerlässlich ist und wie TrueFoundry es standardmäßig ermöglicht, um faire Nutzung, Kosteneffizienz und produktionsreife Leistung bei Multi-Tenant-Bereitstellungen sicherzustellen.
Rate Limiting ist ein Mechanismus zur Steuerung der Anzahl von Anfragen, die ein Client innerhalb eines bestimmten Zeitfensters an ein System senden kann, und ist eine Kernfunktion modernerAI Gatewayszur Verwaltung von LLM-Datenverkehr. Es sorgt für Fairness, verhindert Überlastungen und erhält die Verfügbarkeit aufrecht, insbesondere in Umgebungen mit vielen Benutzern. Herkömmliche APIs wenden oft einfache Grenzwerte an, wie z. B. 100 Anfragen pro Minute und Benutzer, was für Standard-REST-Dienste gut funktioniert.
LLMs funktionieren jedoch ganz anders. Jede Anfrage kann je nach Eingabegröße, Modelltyp und erwarteter Ausgabe eine völlig unterschiedliche Last auf die Infrastruktur ausüben. Beispielsweise kann eine Eingabeaufforderung mit 20 Token an ein 7B-Modell schnell abgeschlossen sein, während eine Anfrage mit 2000 Token an ein 65B-Modell GPUs für mehrere Sekunden blockieren könnte. Selbst zwei identische Anfragen an unterschiedliche Modelle können sich in den Rechenkosten um das Fünffache oder mehr unterscheiden.
Dies macht anfragebasierte Grenzwerte unzureichend. Moderne LLM-Gateways müssen für jedesLLM-Tool, das sie bereitstellen, ein token-basiertes Rate Limiting einführen, das die tatsächlich verarbeitete Anzahl an Token und die Rechenlast pro Aufruf berücksichtigt.
Zu den Schlüsselfaktoren, die beim token-basierten Rate Limiting berücksichtigt werden, gehören:
Im Vergleich zu festen Anfragelimits bieten tokenbasierte Limits:
In generativen KI-Workflows wird die Ratenbegrenzung noch kritischer. Ein einzelner Nutzer kann durch lange Prompts, das Einlesen von Dokumenten oder mehrstufige Agenten eine umfangreiche Backend-Verarbeitung auslösen. Ohne entsprechende Kontrollen kann dies zu GPU-Überlastungen, hoher Latenz oder unerwarteten Kosten führen.
Die tatsächliche Nutzung ist oft unvorhersehbar und wird durch Front-End-Apps, Testschleifen oder Automatisierungen gesteuert. Die Ratenbegrenzung stellt sicher, dass diese Interaktionen stabil und effizient bleiben, selbst wenn die Infrastruktur von mehreren Nutzern oder Mandanten gemeinsam genutzt wird.
Für jede produktionsreife Bereitstellung muss dieDas beste LLM-Gatewayeine intelligente Ratenbegrenzung als grundlegende Voraussetzung für Skalierbarkeit, Zuverlässigkeit und Kostenkontrolle bieten.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |

Ratenbegrenzung ist mehr als nur eine Absicherung des Backends. Für Plattformen, die LLMs bereitstellen – insbesondere solche mit öffentlichen oder mandantenfähigen APIs –, fungiert sie als strategische Ebene für Stabilität, Governance und geschäftliche Ausrichtung. Ob bei OpenAI, Anthropic oder Plattformen, die auf TrueFoundry basieren: Ratenbegrenzungen erfüllen mehrere wichtige Zwecke.
Schutz der Infrastruktur vor Missbrauch
Die Inferenz generativer KI ist ressourcenintensiv. Ein plötzlicher Anstieg langer Prompts oder gleichzeitiger Anfragen kann GPU-Warteschlangen überlasten, die Latenz erhöhen oder sogar Dienste zum Absturz bringen. Ratenbegrenzungen stellen sicher, dass der Datenverkehr kontrolliert und priorisiert verarbeitet wird, um eine Erschöpfung der Ressourcen zu verhindern.
Gewährleistung von Fairness gegenüber Nutzern oder Mandanten
In Systemen mit mehreren Nutzern sollte die Aktivität eines Clients die Leistung für andere nicht beeinträchtigen. Ratenbegrenzungen helfen dabei, eine Isolierung zwischen Nutzern, Teams oder API-Schlüsseln durchzusetzen. Dies garantiert ein konsistentes Serviceniveau, unabhängig davon, wie viele Nutzer gleichzeitig aktiv sind.
Anpassung der Nutzung an Preismodelle
Viele Gen-KI-Plattformen monetarisieren auf Basis von Token oder Nutzungskontingenten. Ratenbegrenzungen helfen dabei, diese Grenzen durchzusetzen. Zum Beispiel:
Vermeidung von Kostenüberraschungen und Budgetüberschreitungen
Die Nutzung von LLMs kann unbemerkt und schnell skalieren. Ohne angemessene Begrenzungen können der Token-Verbrauch und die GPU-Auslastung explodieren. Rate Limiting hilft Plattformen dabei, unerwartete Infrastrukturkosten zu vermeiden und das Budget unter Kontrolle zu halten.
Zuverlässigkeit und Benutzererfahrung verbessern
Wenn die Nutzung kontrolliert wird, bleiben Systemwarteschlangen stabil. Dies führt zu geringerer Latenz, höheren Erfolgsraten und einer konsistenteren Benutzererfahrung, was besonders in Produktionsumgebungen mit SLAs wichtig ist.
In LLM-basierten Systemen hat nicht jede Anfrage die gleiche Auswirkung. Ein kurzer Prompt an ein kleines Modell verbraucht möglicherweise nur minimale Ressourcen, während eine lange Abfrage an ein großes Modell erhebliche GPU-Zeit beanspruchen kann. Aufgrund dieser Variabilität wenden moderne Plattformen Rate Limits über mehrere Dimensionen hinweg an, anstatt sich nur auf die Anzahl der Anfragen zu verlassen.
Hier sind die gängigsten Dimensionen für ein effektives Rate Limiting:
Die Nutzung dieser Dimensionen gibt Plattform-Teams die Flexibilität, den Ressourcenverbrauch mit Infrastrukturbeschränkungen, Benutzeranforderungen und Service-Level-Erwartungen in Einklang zu bringen.
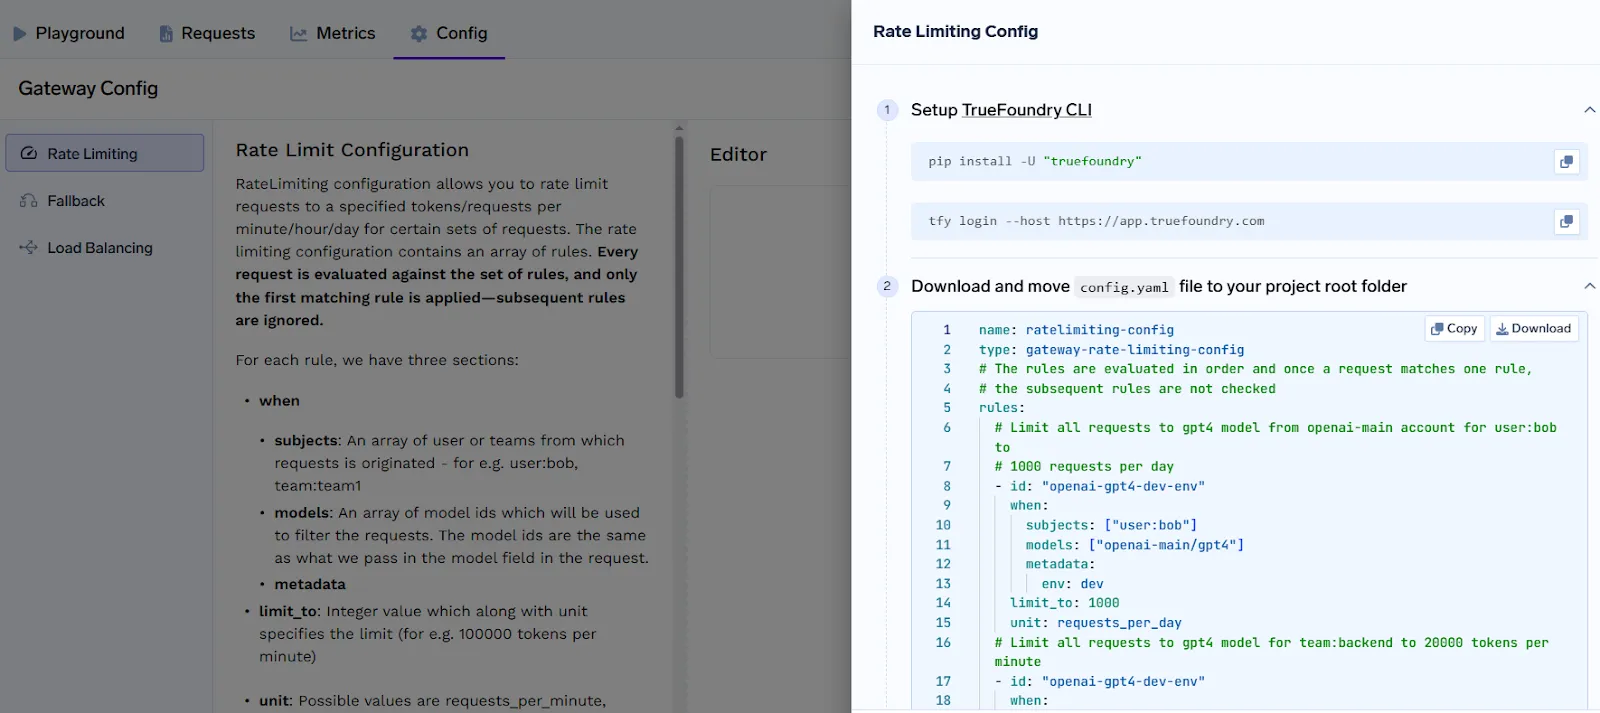
TrueFoundry bietet ein robustes und flexibles Rate-Limiting-System, mit dem Plattformteams den Zugriff auf LLM-Endpunkte basierend auf Anfragen oder Token-Verbrauch steuern können. Dies gewährleistet eine faire Zuteilung von Rechenressourcen, verhindert Missbrauch und stellt sicher, dass die Nutzung den Unternehmensrichtlinien oder Abrechnungsplänen entspricht.
Das Herzstück des Rate-Limiting-Mechanismus von TrueFoundry ist ein regelbasiertes Konfigurationssystem, mit dem Teams präzise Richtlinien für Benutzer, Teams, virtuelle Konten, Modelle und Anfragemetadaten definieren können.
Regelbasierte Konfiguration
Das Rate-Limiting in TrueFoundry wird über eine Liste von Regeln definiert, die jeweils Folgendes festlegen:
Regeln werden in der angegebenen Reihenfolge ausgewertet. Spezifischere Regeln sollten daher über allgemeineren Regeln platziert werden, um eine korrekte Zuordnung zu gewährleisten.
Unterstützte Limit-Typen
TrueFoundry unterstützt sowohl anfragebasierte als auch tokenbasierte Limits über verschiedene Zeitintervalle hinweg:
Dies ermöglicht die Durchsetzung von Richtlinien, die den tatsächlichen Rechenverbrauch widerspiegeln – besonders wichtig bei der Verarbeitung von Prompts unterschiedlicher Länge für Modelle verschiedener Größen.
Häufige Anwendungsfälle
Die Flexibilität des Konfigurationssystems unterstützt eine Vielzahl von Anwendungsfällen:
Beispielkonfiguration
name: ratelimiting-config
type: gateway-rate-limiting-config
Regeln:
- id: "specific-rule"
when:
subjects: ["user:bob@email.com"]
models: ["openai-main/gpt4"]
limit_to: 1000
unit: requests_per_day
Dieses Beispiel begrenzt die GPT-4-Nutzung eines bestimmten Benutzers auf 1.000 Anfragen pro Tag. Das Rate-Limiting-System von TrueFoundry ist leistungsstark und einfach zu verwalten. Dank token-basierter Steuerung, granularer Zielgruppenansprache und klarer YAML-Richtlinien können Teams ihre LLM-Nutzung sicher skalieren und gleichzeitig die Kontrolle über Infrastruktur und Kosten behalten.
So wenden Sie die Konfiguration an
1. Installieren Sie das TrueFoundry CLI:
pip install -U "truefoundry"
tfy login --host https://app.truefoundry.com
2. Legen Sie Ihreconfig.yamlin Ihr Projektverzeichnis.
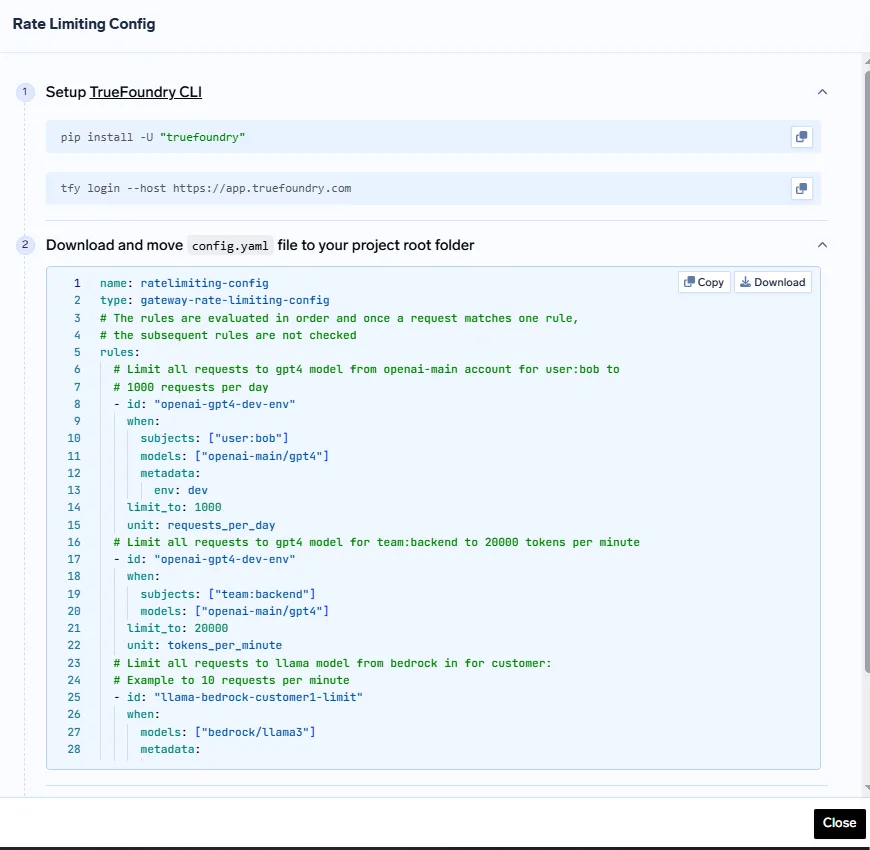
3. Wenden Sie die Konfiguration mit folgendem Befehl an:
tfy apply -f config.yaml
Dieser deklarative Ansatz stellt sicher, dass Ratenbegrenzungen versionskontrolliert, reproduzierbar und im Einklang mit GitOps-Best-Practices sind.
Echtzeit-Feedback zu Ratenbegrenzungen
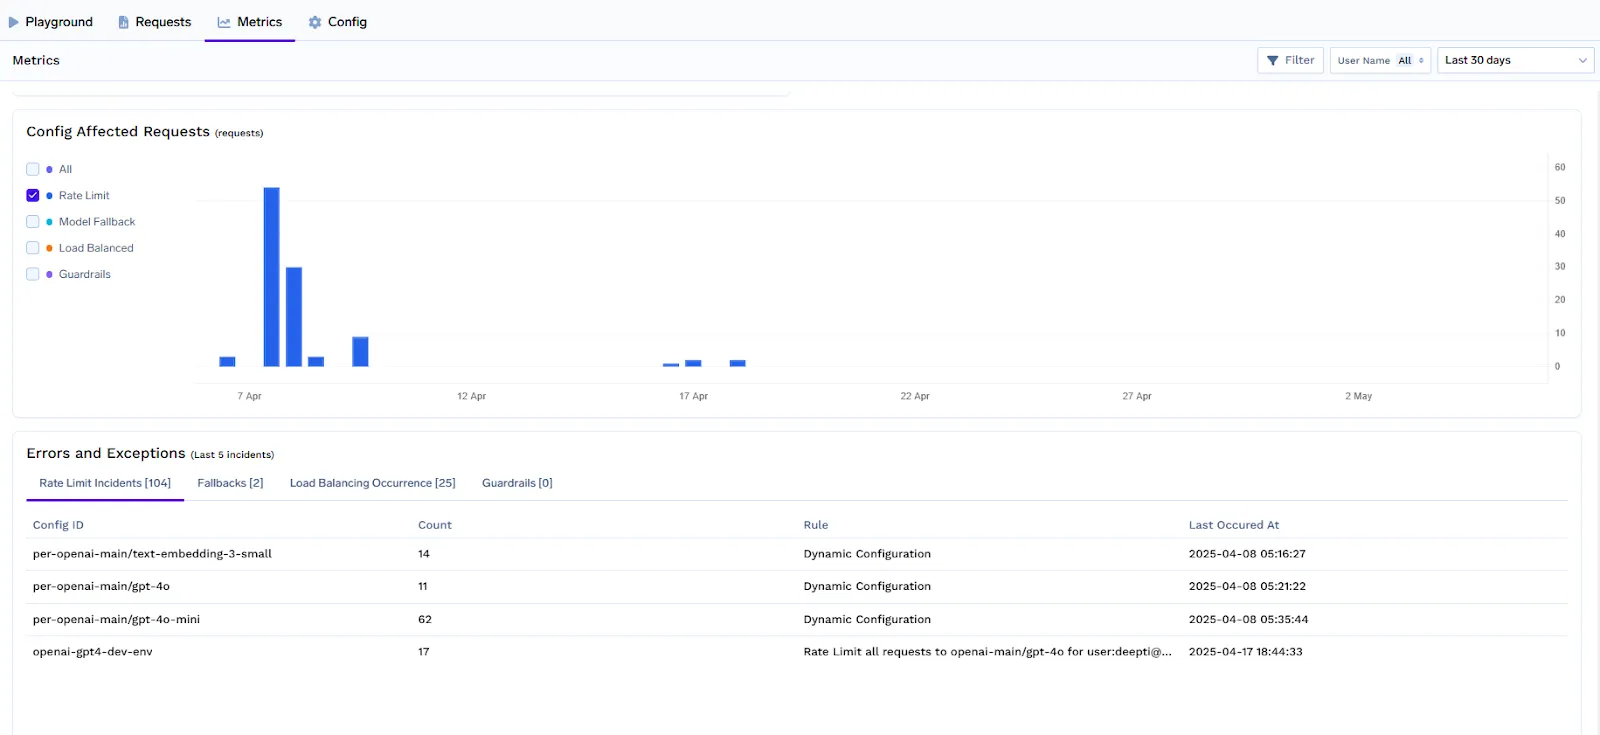
Das Rate-Limiting-System von TrueFoundry bietet Clients sofortiges und transparentes Feedback, wenn Limits überschritten werden oder kurz vor der Ausschöpfung stehen. Dies hilft Entwicklern, Nutzungsgrenzen zu verstehen und Drosselungen in ihren Anwendungen elegant zu handhaben.
Wenn eine Anfrage das definierte Ratenlimit überschreitet:
Dieser Feedback-Mechanismus unterstützt ein besseres Client-Verhalten, ermöglicht automatisierte Wiederholungslogiken und stellt sicher, dass die Nutzung ohne Rätselraten innerhalb der Kontingentgrenzen bleibt.
Dashboards & Warnmeldungen
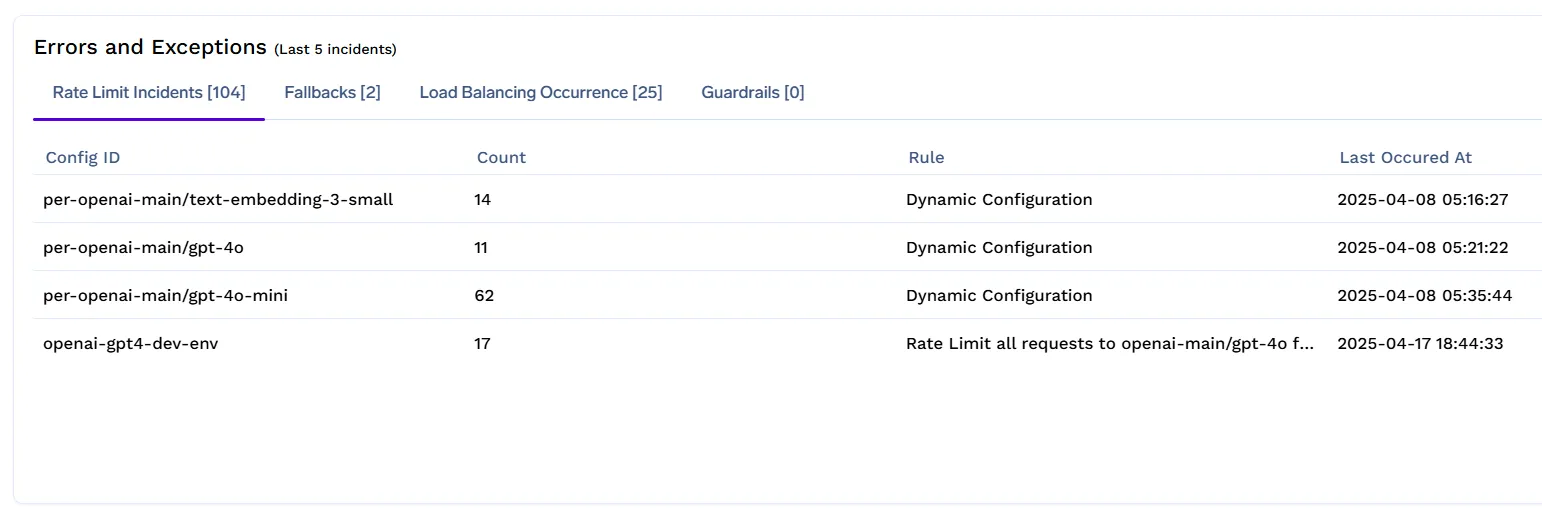
TrueFoundry bietet integrierte Observability-Funktionen, mit denen Plattform-Teams Ratenlimit-Richtlinien in Echtzeit überwachen und optimieren können.
Über das LLM Gateway-Dashboard können Sie Folgendes nachverfolgen:
Diese Erkenntnisse helfen dabei, Missbrauch zu erkennen, Limits proaktiv anzupassen und sicherzustellen, dass wichtige Nutzer einen konsistenten Service erhalten.
Wenn LLM-APIs ausfallen – sei es aufgrund von Ratenbegrenzungen, internen Fehlern oder vorübergehenden Ausfällen –, sorgen Fallback-Mechanismen dafür, dass Ihre Anwendungen reibungslos weiterlaufen. Anstatt Fehlermeldungen an den Endnutzer zurückzugeben, kann TrueFoundry die Anfrage automatisch an ein Ersatzmodell oder einen anderen Anbieter weiterleiten und so die Verfügbarkeit mit minimaler Unterbrechung aufrechterhalten.
Fallback-Regeln werden basierend auf spezifischen Bedingungen ausgelöst, wie z. B. der Modell-ID, dem anfragenden Nutzer oder Team sowie Antwortcodes wie 429 oder 500. Wenn eine Anfrage diese Bedingungen erfüllt, wird sie an eines oder mehrere alternative Modelle weitergeleitet, die in der Fallback-Konfiguration festgelegt sind. Diese Fallback-Ziele können optional Anpassungen für Parameter wie „Temperature“ oder „Max Tokens“ enthalten, wodurch das Verhalten je nach Modellanbieter fein abgestimmt werden kann. Während der Auswertung wird nur die erste zutreffende Regel angewendet, was eine vorhersehbare und deterministische Fehlerbehandlung gewährleistet.
Eine typische Fallback-Regel in TrueFoundry umfasst die folgenden Komponenten:
Beispiel für eine Fallback-Konfiguration:
name: model-fallback-config
type: gateway-fallback-config
# Die Regeln werden der Reihe nach ausgewertet. Sobald eine Anfrage einer Regel entspricht, werden die nachfolgenden Regeln nicht mehr geprüft.
Regeln:
# Fallback auf gpt-4 bei Azure oder AWS, falls openai-main/gpt-4 mit 500 oder 503 fehlschlägt.
# Das Ziel openai-main überschreibt zudem einige Anfrageparameter wie temperature und max_tokens.
- id: "openai-gpt4-fallback"
when:
models: ["openai-main/gpt4"]
response_status_codes: [500, 503]
fallback_models:
- target: openai-main/gpt-4
override_params:
temperature: 0.9
max_tokens: 800
# Fallback auf LLaMA3 bei Azure oder AWS, falls bedrock/llama3 für customer1 mit 500 oder 429 fehlschlägt.
- id: "llama-bedrock-customer1-fallback"
when:
models: ["bedrock/llama3"]
metadata:
customer-id: customer1
response_status_codes: [500, 429]
fallback_models:
- target: aws/llama3
- target: azure/llama3
Das LLM Gateway von TrueFoundry unterstützt nativ eine deklarative Fallback-Einrichtung als Teil seines Konfigurationssystems. Dies ermöglicht es Teams, fehlertolerante Routing-Richtlinien zu definieren und die Betriebszeit ohne manuelles Eingreifen aufrechtzuerhalten, insbesondere bei der Arbeit mit mehreren Anbietern. Zusammen bilden intelligentes Rate Limiting und automatisiertes Fallback das Fundament für hochverfügbare Gen-AI-Dienste.
In jeder Multi-Tenant-KI-Plattform ist Rate Limiting entscheidend, um Stabilität, Fairness und Kostenkontrolle zu gewährleisten. Es ermöglicht Teams, Zugriffsgrenzen nicht nur für einzelne Benutzer, sondern auch für Teams, virtuelle Konten und spezifische Modelle festzulegen, ohne dass benutzerdefinierte Logik erforderlich ist.
Das Gateway von TrueFoundry unterstützt deklaratives Rate Limiting über eine YAML-Konfiguration, bei der Regeln in der angegebenen Reihenfolge ausgewertet werden. Die erste zutreffende Regel wird angewendet; daher sollten spezifischere Regeln oben und allgemeinere Regeln weiter unten in der Konfiguration platziert werden. Diese Struktur sorgt für eine abgestufte Kontrolle bei gleichzeitig übersichtlichen und lesbaren Konfigurationen.
Jede Regel kann die folgenden Komponenten enthalten:
Beispiele für Multi-Tenant Rate Limiting
Begrenzung von Benutzeranfragen:Angenommen, Sie möchten alle Anfragen an das Modell gpt4 vom Konto openai-main für die Benutzer bob@email.com und jack@email.com auf 1000 Anfragen pro Tag begrenzen:
- id: "user-gpt4-limit"
when:
subjects: ["user:bob@email.com", "user:jack@email.com"]
models: ["openai-main/gpt4"]
limit_to: 1000
unit: requests_per_day
Teamweite Limits anwenden:Wenn Sie die Gesamtzahl der Anfragen für das Team 'frontend' auf 5000 pro Tag begrenzen möchten
- id: "team-frontend-limit"
when:
subjects: ["team:frontend"]
limit_to: 5000
unit: requests_per_day
Virtuelle Konten einschränken:Wenn Sie die Anzahl der Anfragen für das virtuelle Konto 'va-james' auf 1500 pro Tag begrenzen möchten
- id: "va-james-limit"
when:
subjects: ["virtualaccount:va-james"]
limit_to: 1500
unit: requests_per_day
Globale Obergrenzen für alle Benutzer und Modelle festlegen:
- id: "{user}-{model}-daily-limit"
when: {}
limit_to: 1000000
unit: tokens_per_day
Mit dieser Konfiguration können Plattformteams die Nutzung nach Geschäftsbereichen segmentieren, Kontingente pro Umgebung durchsetzen und teure Modell-Endpunkte schützen, während gleichzeitig skalierbare und zuverlässige KI-Workloads unterstützt werden.
Rate Limiting ist mehr als nur eine Backend-Kontrolle. Es ist ein entscheidender Faktor für die zuverlässige, kosteneffiziente und faire Nutzung von LLM-Infrastruktur in großem Maßstab. Egal, ob Sie eine Multi-Tenant-Plattform betreiben, Kunden gestaffelten Zugriff anbieten oder interne KI-Workloads für verschiedene Teams ausführen: Die Implementierung intelligenter, token-basierter Ratenbegrenzungen stellt sicher, dass Ihr System auch unter Last berechenbar bleibt.
Neben dem Rate Limiting bieten Funktionen wie Fallback-Routing, Echtzeit-Feedback und granulare Konfigurationsmöglichkeiten den Engineering-Teams die Werkzeuge, um Leistung und Kontrolle in Einklang zu bringen. Das LLM Gateway von TrueFoundry vereint diese Funktionen in einer deklarativen Schnittstelle, die es Plattformteams ermöglicht, Richtlinien zu definieren, die transparent, prüfbar und auf die Unternehmensziele abgestimmt sind.
Da die Einführung generativer KI immer schneller voranschreitet, werden Systeme, die eine intelligente Zugriffskontrolle durchsetzen, ohne die Benutzererfahrung oder Verfügbarkeit zu beeinträchtigen, die nächste Generation der Infrastruktur-Resilienz definieren. Wenn Sie ein KI-Gateway aufbauen oder skalieren, ist Rate Limiting nicht nur eine Option – es ist etwas, das von Anfang an richtig umgesetzt werden muss.
Rate Limiting in einem LLM-Gateway bezeichnet den Mechanismus zur Steuerung der Häufigkeit eingehender Anfragen oder des Token-Volumens, das ein Benutzer, ein Team oder eine Anwendung innerhalb eines bestimmten Zeitfensters verarbeiten kann. Im Gegensatz zum herkömmlichen API-Throttling ist es token-bewusst und berücksichtigt die tatsächliche Rechenlast verschiedener Modellarchitekturen, um sicherzustellen, dass ressourcenintensive Abfragen das System nicht überlasten.
Die Implementierung von Rate Limiting in LLM-Gateway-Umgebungen hilft bei der Kostenkontrolle, indem unerwartete Spitzen beim Token-Verbrauch und außer Kontrolle geratene Skripte verhindert werden. Durch die Festlegung granularer täglicher oder stündlicher Kontingente können Unternehmen die Ausgaben für bestimmte Benutzer oder Nicht-Produktionsumgebungen deckeln. So bleiben KI-Experimente innerhalb eines vorhersehbaren Budgets und teure Überraschungen bei der Abrechnung werden vermieden.
Rate Limiting in LLM-Gateway-Setups ist unerlässlich, um die Infrastruktur vor Missbrauch zu schützen und eine hohe Verfügbarkeit für alle Benutzer zu gewährleisten. Es verhindert, dass ein einzelner "Noisy Neighbor" die Kontingente des Anbieters oder die GPU-Kapazität erschöpft, was andernfalls zu erhöhter Latenz und häufigen 429-"Too Many Requests"-Fehlern führen würde. Diese Management-Ebene ist entscheidend für die Aufrechterhaltung stabiler SLAs in der Produktion.
Zu den gängigen Strategien für das Rate Limiting in LLM-Gateways gehören Limits für Anfragen pro Minute (RPM) und Token pro Minute (TPM), die ein präzises Maß für die Ressourcennutzung liefern. Fortschrittliche Gateways unterstützen zudem gestaffelte Limits basierend auf Benutzerrollen oder Modelltypen. Dadurch erhalten geschäftskritische Aufgaben eine höhere Priorität, während Workloads mit niedrigerer Priorität in Zeiten hoher Auslastung gedrosselt werden können.
Obwohl ein minimaler Verarbeitungsschritt hinzugefügt wird, verursacht das Rate Limiting in einem LLM-Gateway in der Regel einen Overhead von weniger als 4 Millisekunden. Dies ist vernachlässigbar im Vergleich zu den Sekunden, die für die Modellgenerierung benötigt werden. Tatsächlich verbessert es oft die wahrgenommene Latenz, da es verhindert, dass Backend-Warteschlangen gesättigt werden, und so sicherstellt, dass Anfragen reibungslos verarbeitet werden, ohne Timeouts oder Dienstausfälle zu verursachen.
Ja, TrueFoundry bietet eine produktionsreife Implementierung von Rate Limiting im LLM-Gateway durch eine deklarative, regelbasierte Konfiguration. Teams können damit token-basierte Limits über mehrere Modellanbieter und Mandanten hinweg mithilfe einfacher YAML-Dateien durchsetzen. Dieses System bietet Echtzeit-Feedback und detaillierte Dashboards, die es Plattformteams ermöglichen, KI-Workloads zu skalieren und gleichzeitig eine strikte Kosten- und Ressourcen-Governance aufrechtzuerhalten.
Das AI-Rate-Limiting funktioniert, indem es nachverfolgt, wie häufig ein Benutzer Anfragen an eine KI-API sendet. Das System zählt die Anfragen oder Token innerhalb eines Zeitfensters. Wenn der Benutzer das zulässige Limit überschreitet, blockiert die API vorübergehend neue Anfragen oder gibt eine Fehlermeldung aus, bis das Limit zurückgesetzt wird. Dies schützt Server vor Überlastung.
Absolut. Durch die Begrenzung von Token-Nutzung und Anfrageraten verhindern Gateways eine unerwartete Überlastung der GPUs oder zu hohe Cloud-Ausgaben. Unternehmen können die Nutzung an ihre Budgets anpassen, gestaffelte Zugriffsmodelle planen und kostspielige Überkapazitäten reduzieren, während sie gleichzeitig einen konsistenten Service für kritische Workloads aufrechterhalten.
Ja. Moderne KI-Gateways wie TrueFoundry ermöglichen es Teams, Rate-Limit-Regeln in Echtzeit oder über automatisierte Skripte zu aktualisieren. So wird sichergestellt, dass die Infrastruktur unerwartete Lastspitzen ohne Ausfallzeiten oder Leistungseinbußen bewältigen kann. Dynamische Anpassungen sorgen für einen reaktionsschnellen Service und gewährleisten gleichzeitig eine faire Nutzung durch alle Mandanten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















