



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Gateways entwickeln sich zur operationalen Control Plane von GenAI-Systemen. Sie vereinheitlichen den Datenverkehr für Drittanbieter-APIs (OpenAI, Anthropic, Mistral, Bedrock) sowie selbst gehostete Modelle, setzen Richtlinien durch und bieten eine zentrale Übersicht über Latenz, Fehler, Token-Verbrauch und Ausgaben. Genau dieser engpassfreie Schnittpunkt ist der ideale Ort, um Traces zu erfassen, Analysen auf Modell- und Benutzerebene zu berechnen sowie Guardrails und Warnmeldungen auszulösen – ohne zusätzliche Latenz im Request-Pfad zu erzeugen.
Unternehmen haben dies auf die harte Tour gelernt. Betrachten wir einen Support-Copiloten, der Tausende von Agenten unterstützt. An einem Nachmittag erhöht eine scheinbar harmlose Prompt-Aktualisierung die Ausgabelänge um ~40 %. Die Zufriedenheit der Agenten sinkt, da Antworten verzögert eingehen; die Finanzabteilung bemerkt die steigende Rechnung. Mit Gateway-Observability würden Sie sehen, wie die p95-Latenz und die Output-Tokens für die betroffene Route steigen, dies mit dem Deployment oder der Prompt-Version korrelieren und einen Rollback durchführen – idealerweise mit einer automatisierten Warnmeldung, die eingerichtet ist, um das Problem beim nächsten Mal sofort abzufangen.
Dieser Beitrag fasst zusammen, was ein AI Gateway ist, warum Observability von entscheidender Bedeutung ist und welche konkreten Metriken, Dashboards und Workflows Teams einrichten sollten. Wir zeigen auch, wie das AI Gateway von TrueFoundry den Observability-Stack von Haus aus mitliefert: einheitliche Analysen (Latenz, TTFT/ITL, Fehler), granulares Kosten-Tracking, Aufschlüsselungen auf Kunden-/Benutzerebene, Transparenz bezüglich intakter/fehlgeschlagener Routen und eine skalierbare Erfassung mit geringem Overhead, die direkt in die Architektur integriert ist.
Ein AI Gateway ist eine schlanke, hochperformante Schicht, die Anwendungsanfragen an einen oder mehrere LLM-Anbieter oder selbst gehostete Modelle weiterleitet. Es vereinheitlicht APIs, zentralisiert Authentifizierung und RBAC (Role Based Access Control), wendet Rate Limits und Guardrails an, führt Load Balancing sowie Failover aus und erfasst Observability- und Kostendaten für jede Anfrage. Stellen Sie es sich als die „Ingress + Policy + Telemetrie“-Schicht für GenAI vor.
Betrieblich unterstützen moderne Gateways gewichtetes und latenzbasiertes Routing, Health Checks und automatische Fallbacks, wenn ein Modell oder eine Region beeinträchtigt ist – sodass Anfragen selbst bei Anbieterausfällen nahtlos weiterlaufen. Da jede Anfrage das Gateway passiert, können Teams Anbieter nach Latenz und Kosten vergleichen, was den Vergleich OpenRouter vs. AI Gateway zu einer praktischen Evaluierung macht, wenn es darum geht, Routing, Observability und Steuerung skaliert zu verwalten.
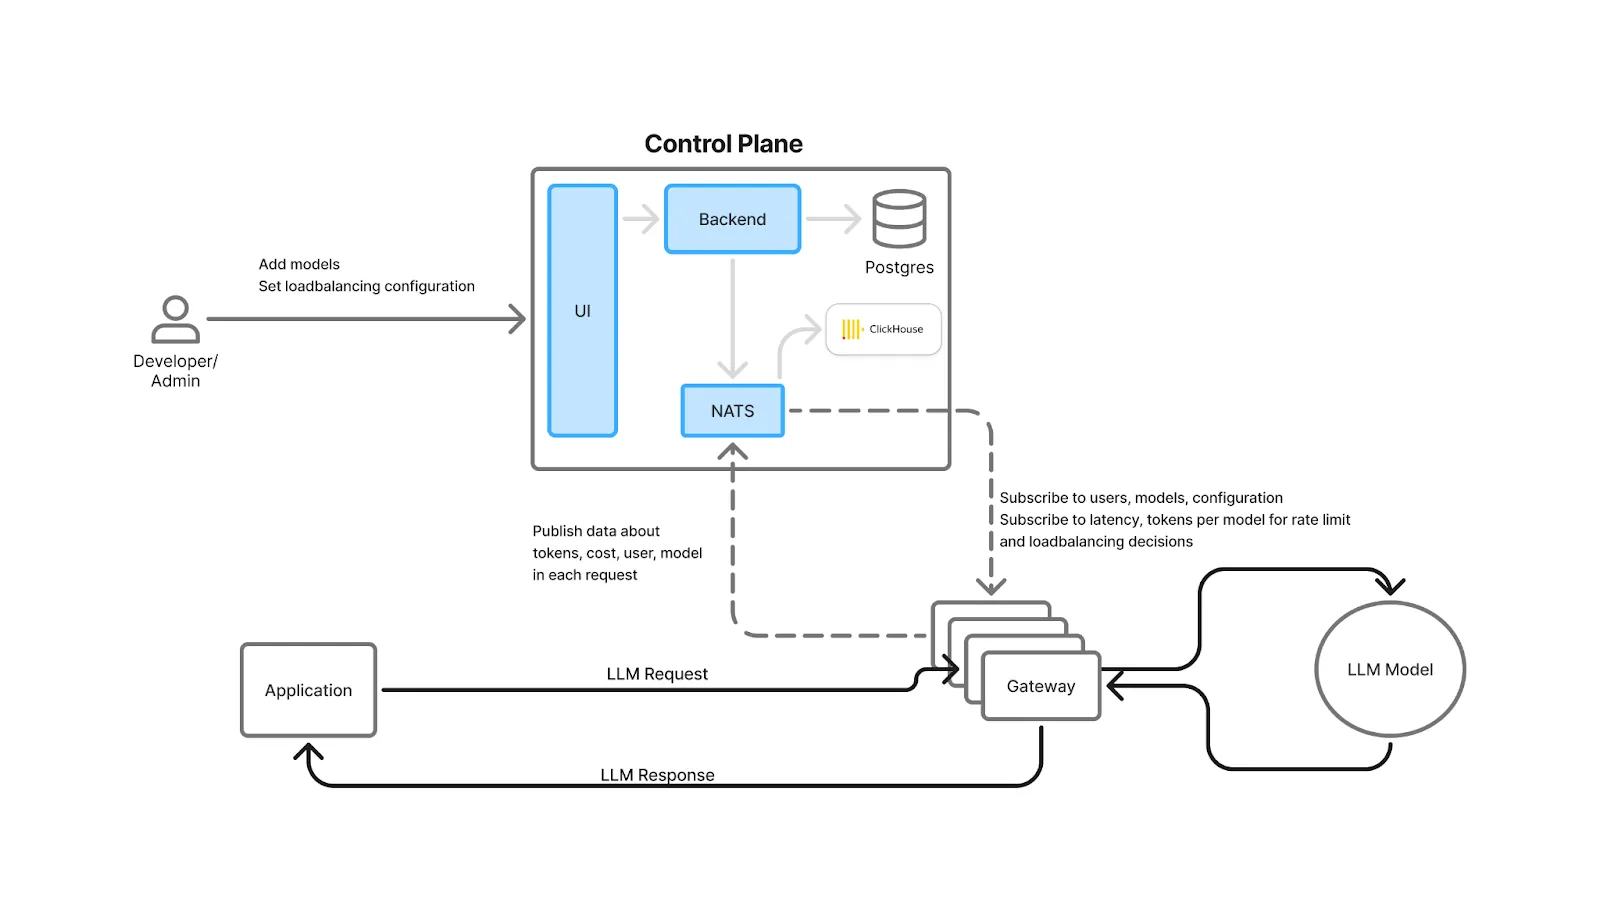
Die Architektur von TrueFoundry ist so konzipiert, dass diese Steuerungen und Metriken nur minimalen Overhead verursachen: Prüfungen für Authentifizierung, Rate Limiting und Load Balancing erfolgen im Arbeitsspeicher; Protokolle/Metriken werden asynchron in eine Warteschlange geschrieben; und der Request-Pfad vermeidet externe Aufrufe (sofern Sie sich nicht für Caching entscheiden). Das Gateway ist horizontal skalierbar und CPU-gebunden, wodurch der Latenz-Overhead für die Gesamtausführung im einstelligen Millisekundenbereich bleibt.
LLM-Latenz ist multimodal: Es gibt die Time to First Token (TTFT), die Inter-Token Latency (ITL) für Streaming und die Gesamtlatenz der Anfrage. Jede wirkt sich unterschiedlich auf die wahrgenommene UX aus. Gateways, die alle drei erfassen, helfen Ihnen zu diagnostizieren, ob Verlangsamungen von Anbieterschlangen, Modellberechnungen, dem Netzwerk oder der Prompt-Länge stammen – und die beste Routing-Strategie zu wählen.
Tokens sind die neuen CPU-Zyklen. Ein einzelner Prompt kann sich auf mehrere Tools oder Retrieval-Schritte verteilen, und die Kosten summieren sich über verschiedene Anbieter hinweg. Observability muss die Ausgaben nach Modell, Anbieter, Umgebung, Anwendung, Mandant und Benutzer zuordnen können und stets mit den öffentlichen Preisen der Anbieter synchron bleiben, um manuelle Tabellenkalkulationen zu vermeiden.
Produktivanwendungen benötigen Schutzmaßnahmen gegen Anbieterausfälle, Drosselungen und Modell-Regressionen. Observability, die mit Health Checks, Aufschlüsselungen nach 4xx/5xx-Codes, Retry-/Fallback-Raten und Rate-Limit-Auslastung verknüpft ist, ermöglicht es Ihnen, SLOs durchzusetzen und automatisch ein Failover auszulösen, wenn sich die Performance verschlechtert.
Unternehmen benötigen vollständige Request/Response-Aufzeichnungen mit Zugriffssteuerungen und Richtlinien für PII/Inhaltsmoderation. Ein Gateway zentralisiert diese Durchsetzung und Protokollierung, sodass Teams nachweisen können, wer welches Modell mit welchen Daten aufgerufen hat und was zurückgegeben wurde – ohne Anbieter-API-Schlüssel breit zu teilen.
Modellqualität, Preise und Kontingente ändern sich häufig. Organisationen, die Gateways instrumentieren, können Anbieter direkt miteinander vergleichen und den Datenverkehr auf der Grundlage aktueller Latenz-, Kosten- und Fehlerdaten verlagern – um Performance und Margen bei sich ändernden Marktbedingungen aufrechtzuerhalten.
Externe Empfehlungen unterstreichen diese Anforderungen: Branchenführer betonen AI-Observability für schnelle Reaktionen auf Drift, Ausfälle und Kostenspitzen; OpenAI und Azure empfehlen strukturiertes Logging und exponentiellen Backoff für Rate Limits, was ein Gateway über Anwendungen hinweg standardisieren kann.
Nachfolgend finden Sie Funktionen, die Sie von einem enterprise-tauglichen AI Gateway erwarten sollten – und die TrueFoundry nativ bereitstellt.
Wichtige Metriken zur Evaluierung eines Gateways
| Kriterium | Was sollten Sie evaluieren? | Priorität | TrueFoundry |
|---|---|---|---|
| Latenz | Verursacht <10 ms p95-Overhead für Time-to-First-Token? | Must Have | ✅ Unterstützt |
| Datenresidenz | Behält Protokolle innerhalb Ihrer Region (EU/US)? | Anwendungsfallabhängig | ✅ Unterstützt |
| Latenzbasiertes Routing | Leitet automatisch basierend auf Echtzeit-Latenz/Ausfällen um? | Must Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must Have | ✅ Unterstützt |

So integriert TrueFoundry Observability direkt in den Request-Pfad und stellt einen vollständigen Analytics-Stack out-of-the-box bereit – ohne den Produktionsdatenverkehr zu verlangsamen.

Das Analytics-Dashboard zeigt: Anfragelatenz (p50/p95/p99), Time to First Token (TTFT/TTFS), Inter-Token Latency (ITL), Kosten pro Modell/Anbieter, Input/Output-Tokens, Fehlercodes und Richtlinienaktivitäten (Rate Limit, Load Balancing, Fallbacks, Guardrails, Budgets). Die Sichten lassen sich nach Modell, Benutzer, Team, ruleId und benutzerdefinierten Metadaten filtern; Rohdaten können zudem als CSV heruntergeladen werden.
Aktivieren Sie Public Cost, um Preise pro Token automatisch aus den veröffentlichten Tarifen der Anbieter (OpenAI, Anthropic, Bedrock usw.) zu beziehen. Für verhandelte oder feineingestellte Modelle legen Sie Private Cost mit benutzerdefinierten Input/Output-Token-Preisen fest. Beide fließen in die Kostenanalysen pro Anfrage sowie aggregierte Auswertungen ein.
Fügen Sie Geschäftskontext hinzu (Kunde, Feature, Umgebung) und schlüsseln Sie Tokens, Latenz und Ausgaben nach beliebigen Dimensionen auf – ideal für Weiterverrechnungen (Chargebacks), die Erkennung von Noisy-Neighbor-Problemen und die Priorisierung von Optimierungen.

Definieren Sie Kontingente nach Tokens oder Anfragen pro Minute/Stunde/Tag, abgegrenzt auf Benutzer, Modelle oder Segmente, die über Metadaten identifiziert werden. Dashboards zeigen die Auslastung und Drosselungen, sodass Sie Limits optimal anpassen und shared Kapazitäten schützen können.
Nutzen Sie gewichtete Aufteilungen für Experimente oder latenzbasiertes Routing für den Regelbetrieb. Health Checks markieren Backends bei Erreichen von Fehler-/Latenz-Schwellenwerten als beeinträchtigt und schließen sie automatisch aus. Fallback-Ketten starten bei Ausfällen erneute Versuche, wobei Spans und Metriken genau zeigen, welcher Pfad gewählt wurde und welche Latenz-/Kostenauswirkungen entstanden sind.
Zentralisieren Sie Anbieter-Schlüssel, stellen Sie zugriffsdefinierte Access Tokens aus, setzen Sie RBAC durch und bewahren Sie unveränderliche Request/Response-Protokolle für Compliance-Zwecke auf – über LLMs und MCP-Server hinweg.
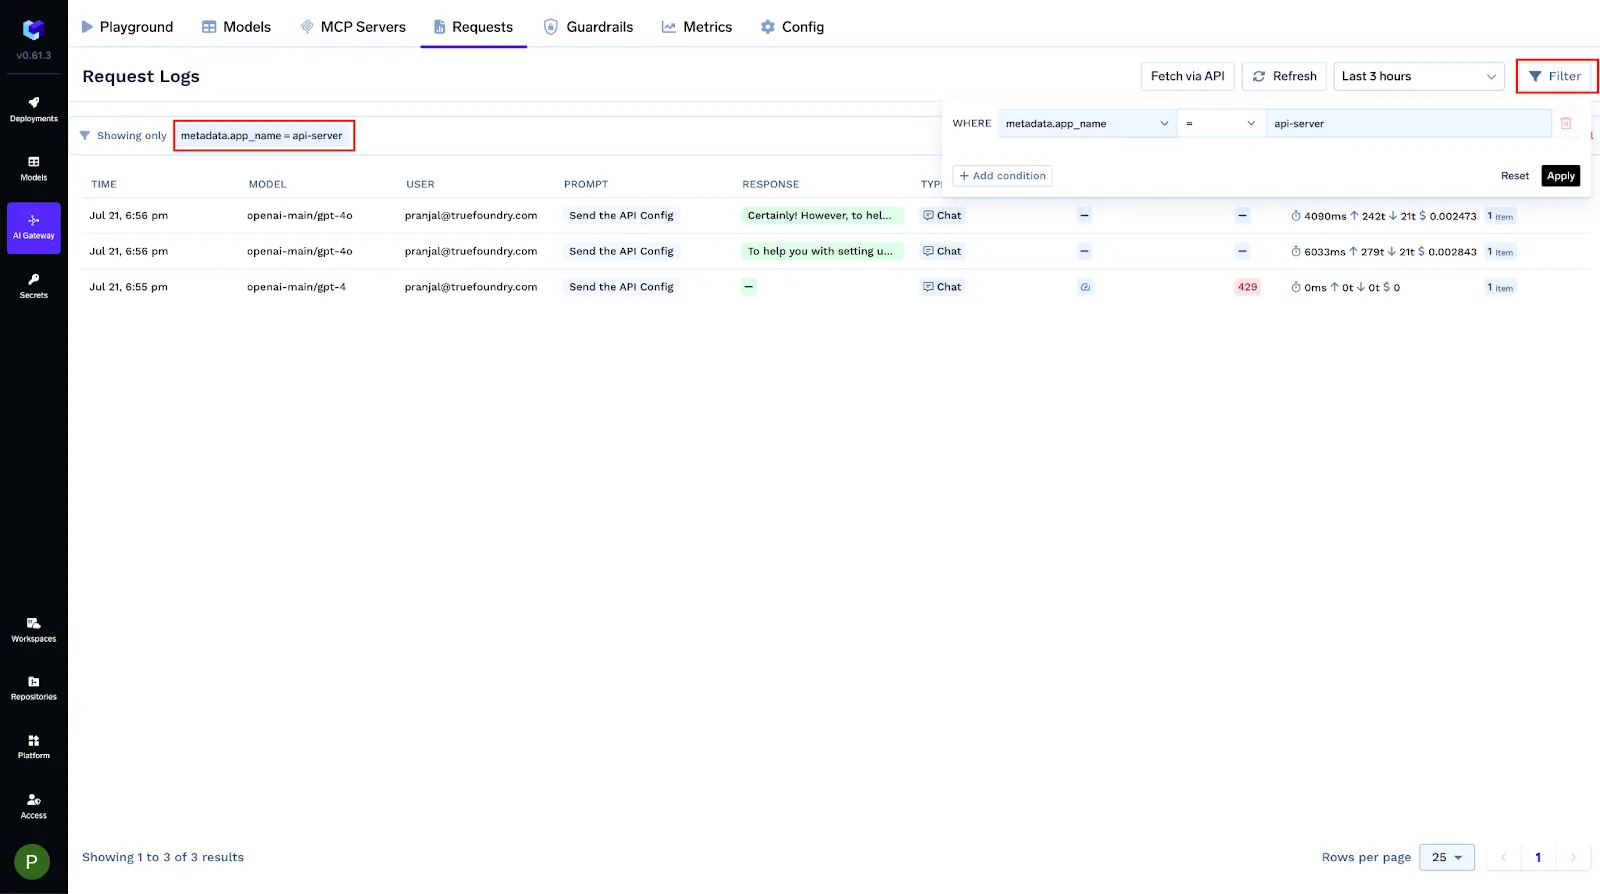
Sie können jede Anfrage mit strukturierten Metadaten über den X-TFY-METADATA Header taggen. Protokollierte Schlüssel werden zu abfragbaren Filtern, Grafana-Labels und Bedingungen in Gateway-Konfigurationen (Rate Limits, Load Balancing, Fallbacks, Guardrails). Die Werte sind Zeichenketten (≤128 Zeichen).
Das gleiche Metadaten-Muster gilt für Load-Balancing- und Fallback-Regeln.
Das Gateway ist OpenTelemetry-konform. Aktivieren Sie den OTLP-Export und senden Sie Traces an ein beliebiges Backend (Tempo, Jaeger, Datadog/New Relic via Collector, TrueFoundry Tracing). Spans enthalten genai-Attribute – Modell, Tokens, TTFT, ITL, Parameter, Tool Calls, Fehler – sowie detaillierte Spans für Rate Limiting, Load Balancing, Fallbacks und MCP-Server-/Tool-Aufrufe, sodass Sie Anbieterverhalten direkt mit Spans auf Anwendungsebene korrelieren können.
Tracing aktivieren
Repräsentative Spans

In LLM_GATEWAY_METADATA_LOGGING_KEYS aufgelistete Metadaten-Schlüssel werden zu Prometheus-Labels llm_gateway_metadata_<key>, was Kosten- und Latenzdiagramme pro Kunde/Feature ermöglicht. (TrueFoundry Docs)
Wichtige Metrik-Familien (Auszug)
Ein vorgefertigtes Grafana-Dashboard JSON wird von TrueFoundry bereitgestellt, gegliedert in Ansichten für Model, User, Config und MCP Invocation. Fügen Sie Variablen für Ihre benutzerdefinierten Metadaten hinzu, z. B.:

Das Model Context Protocol (MCP) von Anthropic – angekündigt am 25. November 2024 – standardisiert, wie Assistenten eine Verbindung zu Tools, Prompts und Ressourcen herstellen. Das Ökosystem hat sich im Jahr 2025 mit vielen vorgefertigten Servern (GitHub, Slack, Google Maps, Puppeteer usw.) schnell weiterentwickelt.
TrueFoundry integriert MCP nativ:
Dies macht das Gateway zur operationalen Control Plane für agentische Workloads – indem es Richtlinien, Authentifizierung, Routing und End-to-End-Transparenz sowohl für LLM-Aufrufe als auch für Tool-Ausführungen vereinheitlicht.
Nachfolgend finden Sie eine praktische Checkliste. Jede Metrik enthält Informationen darüber, was sie aussagt, wie sie verwendet wird und wie TrueFoundry sie darstellt.
Eine Prompt-Änderung erhöht die Ausführlichkeit der Antworten für Unternehmenskunden. Symptome: steigende Output-Tokens, höhere p95-Latenz und steigende Tagesausgaben. Maßnahme mit TrueFoundry: Analytics zeigt einen Anstieg der Output-Tokens für die Umgebung „support-prod“ und einen Kostensprung beim Primärmodell. Sie vergleichen einen alternativen Anbieter, der eine niedrigere TTFT und günstigere Output-Tokens aufweist; Sie verlagern 30 % des Datenverkehrs über gewichtetes Routing und richten eine Warnmeldung für „Kosten pro Konversation“ ein.
Um 10:00 Uhr IST stiegen die Fehlerraten auf 429-Statuscodes an. Maßnahme mit TrueFoundry: Rate-Limit-Dashboards bestätigen Drosselungen von der Upstream-Seite. Fallback-Ketten greifen ein, und das Routing verlagert sich auf ein intaktes Backend. Sie halten die Benutzererfahrung stabil und passen später Token-Kontingente sowie Backoff-Parameter an.
Benutzer berichten: „Die Antwort startet schnell, wird dann aber sehr langsam.“ Maßnahme mit TrueFoundry: TTFT ist unauffällig, aber die ITL ist beim Primärmodell erhöht. Das latenzbasierte Routing bevorzugt automatisch einen Anbieter mit besserem Streaming-Durchsatz; zusätzlich richten Sie eine Warnmeldung für ITL p95 ein.
Der Batch-Job eines einzelnen Kunden verbraucht übermäßig viele Tokens und verlangsamt das System für alle anderen. Maßnahme mit TrueFoundry: Tokenbasierte Rate Limits pro Kunde setzen eine faire Verteilung durch und schützen SLOs; Analysen bestätigen die Auslastung und die Anzahl abgelehnter Anfragen, sodass Sie höhere Kontingente anbieten können.
LLM-Anwendungen sind dynamische Systeme. Modelle entwickeln sich weiter, Anbieter ändern Kontingente und Preise, Prompts verändern sich und das Benutzerverhalten überrascht immer wieder. Das beste AI Gateway ist dort, wo Sie all das beobachten, steuern und optimieren können – vorausgesetzt, Sie erfassen die richtigen Signale und leiten daraus Maßnahmen ab.
Das AI Gateway von TrueFoundry bietet Ihnen genau diese operative Steuerungszentrale. Es erfasst Latenz (TTFT/ITL), Tokens, Kosten und Fehler mit geringem Overhead, setzt Token-basierte Rate Limits, RBAC und Guardrails durch und bietet Transparenz über Routing, Health und Fallbacks, damit Ihre Anwendungen schnell, zuverlässig und kosteneffizient bleiben. Mit detaillierten Kunden-/Benutzeranalysen und automatisierter, aktueller Kostenzuordnung können Teams vom reaktiven Feuerlöschen zur proaktiven Optimierung übergehen.
Wenn Sie Ihren GenAI-Stack zentralisieren – oder ein Gewirr aus einmaligen Integrationen entwirren – beginnen Sie damit, den Datenverkehr über das Gateway zu leiten, aktivieren Sie die oben genannten Dashboards und richten Sie ein paar SLO-konforme Warnmeldungen ein. Sie gewinnen die nötige Transparenz, um schneller zu deployen, Kosten einzudämmen und Ihre Agents und Benutzer dauerhaft zu begeistern.
Observability im AI Gateway hilft dabei, komplexe mehrstufige Reasoning-Prozesse und Tool-Aufrufe nachzuverfolgen, die andernfalls undurchsichtig bleiben. Die Überwachung von Agent-Ausführungspfaden hilft, Endlosschleifen, Halluzinationen und uneffiziente Tool-Nutzungen in Echtzeit zu erkennen. Diese Transparenz stellt sicher, dass autonome Agents zuverlässig, vorhersehbar und innerhalb des Budgets agieren, während sie mit verschiedenen externen Systemen und APIs interagieren.
AI Gateway Observability optimiert die LLM-Performance durch die Echtzeit-Überwachung von Latenz, Durchsatz und Fehlerraten über verschiedene Modellanbieter hinweg. Durch die Erfassung detaillierter Metriken wie Time to First Token (TTFT) und Inter-Token Latency (ITL) können Teams gezielt Engpässe in der Inference-Kette identifizieren. Diese Erkenntnisse ermöglichen es Entwicklern, Modellgeschwindigkeiten objektiv zu vergleichen und intelligentes Routing zu implementieren, um eine hohe Performance für die Endbenutzer zu gewährleisten.
AI Gateway Observability reduziert Kosten durch eine detaillierte Transparenz des Token-Verbrauchs über Modelle, Teams und Benutzer hinweg. Die Nachverfolgung der Ausgaben pro Anfrage und Workspace ermöglicht es Teams, ausufernde Prompts oder uneffiziente Workflows sofort zu erkennen. Diese Daten unterstützen automatisierte Kosteneinsparungsstrategien wie semantisches Caching, Token-basiertes Rate Limiting und das Routing von Anfragen zu günstigeren Modellen ohne manuelles Eingreifen.
AI Gateway Observability unterstützt Compliance-Audits, indem sie ein zentrales, unveränderliches Log jeder Anfrage und Antwort führt. Moderne Systeme zeichnen detaillierte Audit-Trails auf, einschließlich Benutzer-IDs, Zeitstempeln und PII-Maskierungsereignissen zum Schutz sensibler Daten. Diese Logs stellen sicher, dass Unternehmen regulatorische Standards wie DSGVO und SOC 2 erfüllen, indem sie vollständige Transparenz über Modellinteraktionen bieten – oft während die gesamte Telemetrie in der sicheren Cloud-Umgebung der Organisation verbleibt.
TrueFoundry vereinfacht das AI-Infrastrukturmanagement, indem es mehrere Modellanbieter über Observability in AI Gateways auf einer einzigen Control Plane zusammenführt. TrueFoundry korreliert Telemetrie auf Anfrageebene mit der GPU- und CPU-Auslastung, um die Ressourcenzuweisung zu optimieren und Verschwendung zu reduzieren. Dieser integrierte Ansatz ermöglicht es Platform-Teams, Deployments, Skalierung und Sicherheitsrichtlinien über verschiedene Umgebungen hinweg nativ innerhalb ihrer AWS-, GCP- oder Azure-Konten zu verwalten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















