November 1, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Systeme mit einem einzelnen Agenten rufen Modelle und Tools auf. Multi-Agenten-Systeme fügen etwas Neues hinzu: Agenten, die andere Agenten aufrufen. Dieser East-West-Traffic – ein Orchestrator, der Aufgaben an Unteragenten delegiert, oder Agenten, die sich gegenseitig Arbeit über das noch junge Agent2Agent-Protokoll zuspielen – ist der Bereich, in dem Kosten explodieren, der Wirkungsbereich von Fehlern wächst und die Frage „Welcher Agent hat was getan?“ unbeantwortbar wird. Die Protokolle standardisieren zwar, wie Agenten einander entdecken und Aufgaben austauschen, und bieten Sicherheits-Hooks – sie schreiben jedoch nicht Ihr unternehmensweites Identitätsmodell, Ihren Policy-Graphen, Ihr Budgetmodell oder Ihre Observability- und Control-Plane vor. Dieser Beitrag beschreibt diese Governance-Ebene und warum sie an das Gateway gehört.
Tomás, ein Platform Engineer, wurde von einem Kostenalarm und einem Rätsel überrascht. Über Nacht hatte der neue Multi-Agenten-Forschungsworkflow des Unternehmens mehr verbraucht als im gesamten Vormonat. Ein Orchestrator-Agent delegierte Teilaufgaben an eine Reihe von Unteragenten; ein Unteragent stieß auf einen vorübergehenden Fehler und versuchte es erneut, indem er den Orchestrator wieder aufrief, der erneut delegierte – eine Schleife, die stundenlang lief. Bis zum Morgen hatten sich die Agenten zehntausende Male gegenseitig aufgerufen. Tomás wollte wissen, welcher Agent den Prozess gestartet hatte und wo die Schleife entstanden war, konnte es aber nicht herausfinden: Jeder Agent authentifizierte sich mit demselben gemeinsamen Dienstschlüssel, die Aufrufe zwischen den Agenten wurden nicht als Graph aufgezeichnet und es gab kein pro Agent definiertes Ratenlimit, das hätte greifen können. Das System verfügte über eine Governance für Aufrufe an den Modellanbieter, aber fast keine für Aufrufe zwischen den eigenen Agenten.
Dies ist die Lücke, die Multi-Agenten-Systeme aufreißen. In dem Moment, in dem Agenten beginnen, Aufgaben aneinander zu delegieren, entsteht ein neues internes Netzwerk – eines ohne Identität, ohne Richtlinien und standardmäßig ohne Tracing. Die Agenten-Frameworks helfen beim Aufbau des Workflows, sie steuern ihn jedoch nicht. Dieser Beitrag zeigt, wie Sie diesem internen Netzwerk dieselbe Identität, dieselben Limits und dieselbe Observability verleihen, die Sie bei einem Microservice-Mesh als selbstverständlich voraussetzen würden.
Bisher war der Traffic am Gateway meist North-South: Eine Anwendung ruft ein Modell auf, möglicherweise über ein Tool. Multi-Agenten-Systeme fügen East-West-Traffic hinzu – Agenten, die andere Agenten aufrufen. Ein Orchestrator delegiert an Spezialisten; ein Spezialist konsultiert einen anderen; Ergebnisse fließen zurück. Das noch junge Agent2Agent (A2A) Protokoll verleiht dem eine Standardform, bei der Agenten Fähigkeitsbeschreibungen (Agent Cards) veröffentlichen, die andere entdecken können, und Aufgaben sowie Nachrichten über eine gemeinsame Schnittstelle austauschen – ähnlich wie MCP standardisiert hat, wie Agenten auf Tools zugreifen.
Die Analogie zum Übergang vom Monolithen zu Microservices ist hier sehr hilfreich. Sobald Ihre Agenten miteinander kommunizieren, haben Sie ein verteiltes System mit dessen typischen Fehlermodi: kaskadierende Wiederholungsversuche, Endlosschleifen, Fan-out-Verstärkung und der Verlust eines klaren Call-Stacks. Und wie bei Microservices besteht die Lösung nicht darin, sich zu wünschen, die Aufrufe gäbe es nicht, sondern sie hinter eine Ebene zu legen, die jedem Aufrufer eine Identität, jedem Aufruf eine Richtlinie und jedem Ablauf ein Trace zuweist. Diese Ebene ist für Agenten das Agent-Gateway.
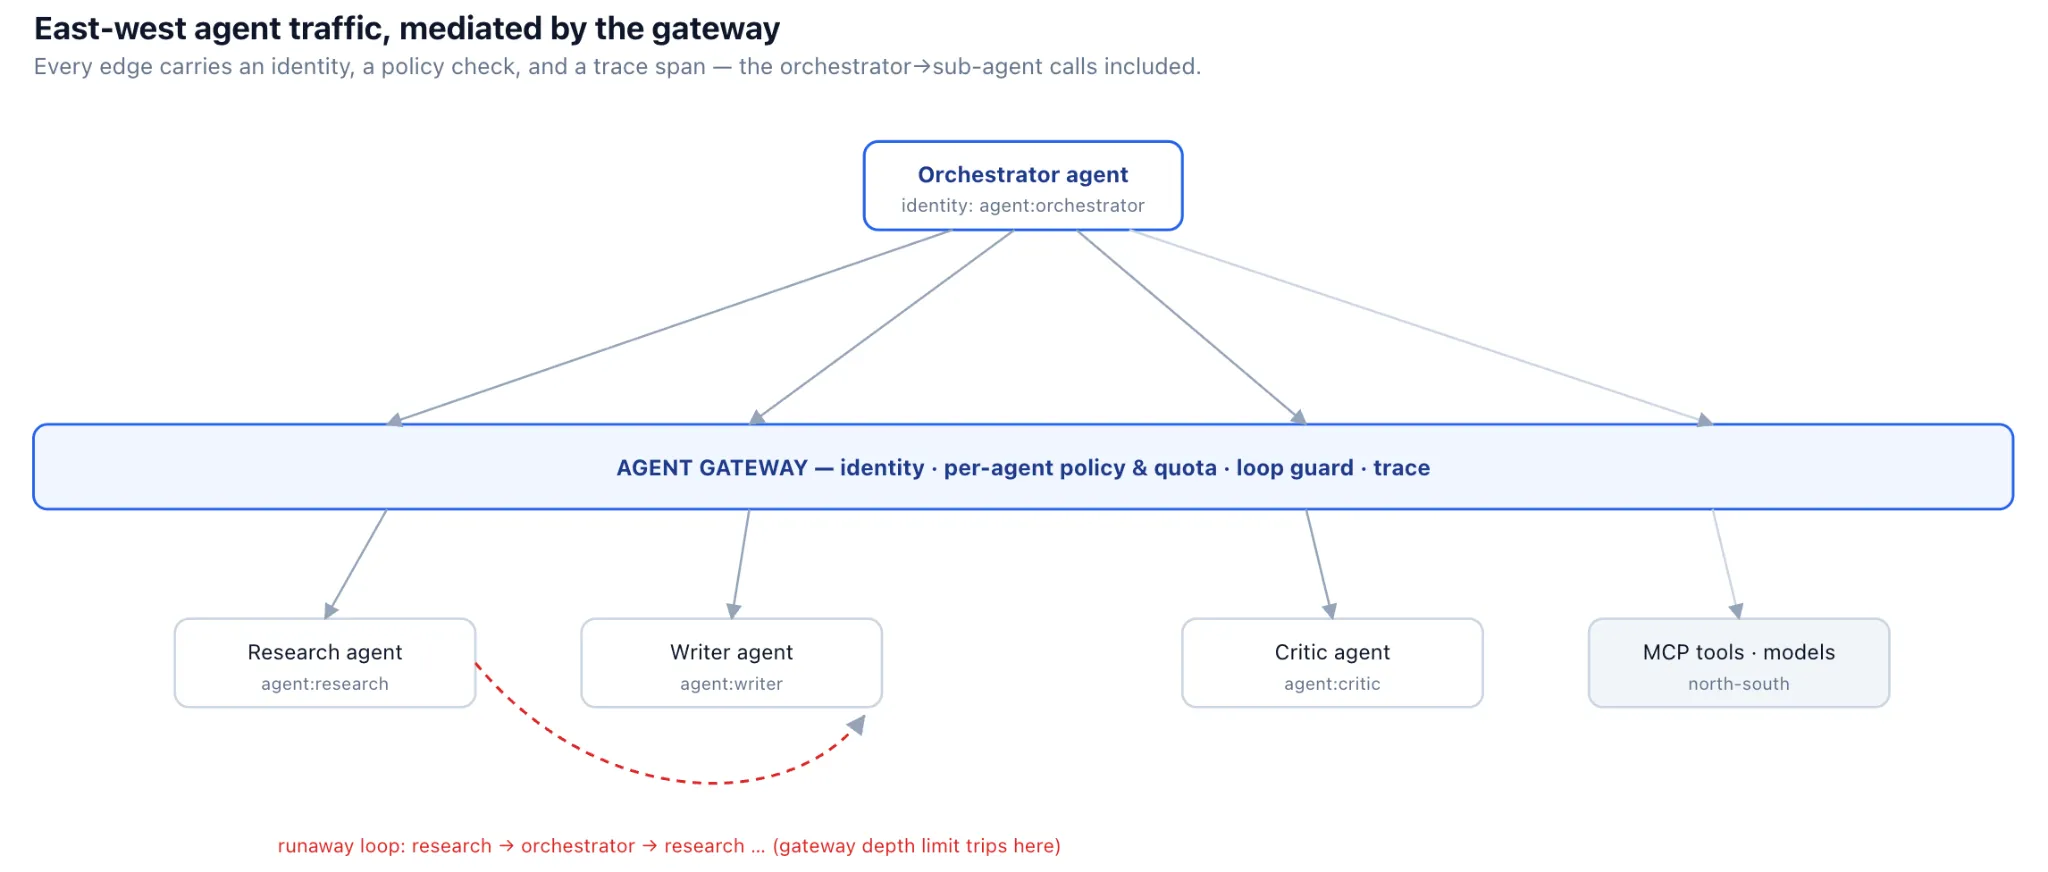
Das Grundproblem von Tomás war die Identität. Wenn sich jeder Agent mit einem gemeinsamen Dienstschlüssel authentifiziert, kann das System seine Agenten buchstäblich nicht voneinander unterscheiden – was bedeutet, dass es sie nicht unterschiedlich autorisieren, Kosten nicht separat zuordnen und nicht nachvollziehen kann, welcher Agent gehandelt hat.
Die Lösung besteht darin, jedem Agenten eine eigene Identität zu geben, die am Gateway ausgestellt und verifiziert wird, und diese bei jedem Aufruf des Agenten weiterzugeben – sei es an ein Modell, ein Tool oder einen anderen Agenten. Diese Identität ist der Ankerpunkt für alle nachgelagerten Kontrollmechanismen: Autorisierungsentscheidungen, Ratenlimits, Kostenzuordnung und Trace-Attribution basieren alle auf der Frage „Welcher Agent?“.
Jeder Agent trägt bei jedem Hop seine eigene Identität (illustrativ)
# The gateway issues and verifies a per-agent identity, not a shared key.
ctx = AgentContext(
    agent_id="agent:research",          # this agent's own identity
    on_behalf_of="user:tomas",          # the human principal, preserved end-to-end
    run_id="run_4f9c",                  # correlates every hop of one workflow
    depth=2,                            # how deep in the delegation chain we are
)

# Propagated when this agent delegates to another agent or calls a tool:
gateway.invoke(target="agent:writer", context=ctx, payload=task)
Die Zentralisierung der Identität im Agent Gateway von TrueFoundry – das Authentifizierung, Identität und Service-Account-Management für Agenten auf der Gateway-Ebene verwaltet – bedeutet, dass die Identität einmalig etabliert und überall downstream als vertrauenswürdig eingestuft wird, anstatt dass jedes Agenten-Framework sein eigenes Schema erfindet. Die Beibehaltung des menschlichen Prinzipals (in dessen Namen der Workflow ausgeführt wird) neben der Agenten-Identität stellt sicher, dass die Autorisierung und Auditierung für Endbenutzer selbst bei drei Delegationsstufen intakt bleibt.
Identität ermöglicht Autorisierung, und in einem Multi-Agenten-System sind die Fragen dazu konkret. Darf der Forschungs-Agent den Schreib-Agenten aufrufen oder nur der Orchestrator? Darf ein Sub-Agent externe Tools direkt aufrufen oder nur über seinen übergeordneten Agenten? Welche Agenten dürfen welches Budget beanspruchen? Wenn man dies als Policy-as-Code ausdrückt – nach demselben Cedar- oder OPA-Ansatz wie in den Beiträgen zu Governance und Routing –, werden die erlaubten Kanten des Agenten-Graphen explizit und überprüfbar, anstatt implizit im Code verborgen zu sein.
Autorisierung pro Agent für East-West-Aufrufe (beispielhafte Richtlinie)
# Default-deny: an agent may only invoke agents it is explicitly allowed to.
allow if principal.agent_id == "agent:orchestrator"
      and action == "invoke"
      and resource.agent_id in ["agent:research", "agent:writer", "agent:critic"]

# Sub-agents may NOT invoke the orchestrator — this edge is what created the loop.
deny  if principal.agent_id in ["agent:research", "agent:writer"]
      and resource.agent_id == "agent:orchestrator"

# Only the research agent may reach external search tools.
allow if principal.agent_id == "agent:research"
      and resource.kind == "mcp_tool"
      and resource.name == "web_search"
Beachten Sie die zweite Regel: Eine Richtlinie, die Sub-Agenten untersagt, den Orchestrator erneut aufzurufen, hätte Tomás' Schleife bereits beim ersten Sprung unterbrochen, unabhängig von jeglichem Ratenlimit. Autorisierung ist hier nicht nur eine Sicherheitskontrolle; die Einschränkung der Struktur des Agenten-Graphen ist auch der Weg, um ganze Klassen von außer Kontrolle geratenem Verhalten zu verhindern. Das Gateway wird zum Durchsetzungspunkt, wenn es der einzige Ort ist, über den jeder East-West-Aufruf geleitet wird.
Es ist hilfreich, präzise zu definieren, was die Protokolle entscheiden und was sie Ihnen überlassen. Discovery und Transport sind standardisiert; das Identitätsmodell, die Richtlinien, Budgets und der Durchsetzungspunkt hingegen nicht:
Selbst mit einer guten Autorisierung scheitern Multi-Agenten-Systeme auf eine Weise, wie es bei einzelnen Aufrufen nicht der Fall ist, da die Einheit des Schadens die Kaskade ist. Ein Retry, der erneut delegiert, kann einen Zyklus bilden; ein Agent, der sich auf viele Kinder ausweitet, kann eine Anfrage in Tausende vervielfachen; ein langsamer Sub-Agent kann einen gesamten Workflow blockieren. Dies sind die auf Agenten skalierte Versionen der Probleme „Thundering Herd“ und „Silent Escalation“, die man bereits kennt aus Routing und Failover auf der Modellebenehandelt.
Eindämmung erfolgt in Schichten. Ein Limit für die Delegationstiefe begrenzt, wie tief die Kette rekursiv verlaufen kann, und bricht Zyklen strukturell auf. Ratenlimits pro Agent begrenzen, wie oft ein Agent andere aufrufen kann, sodass eine Schleife an eine Obergrenze stößt, anstatt die ganze Nacht durchzulaufen. Timeouts und die Erkennung von Blockaden verhindern, dass ein Agent ewig auf ein Kind wartet. Und ein globales Budget pro Lauf begrenzt die Gesamtkosten eines Workflows, unabhängig von seiner Form. Das Agent Gateway von TrueFoundry dokumentiert die relevanten Primitive – Retry-Richtlinien, Fallback-Pfade, Timeouts und Schutzmaßnahmen gegen Endlosschleifen oder blockierte Agenten sowie token- und kostenbasierte Kontingente pro Agent, Workflow oder Umgebung. Die genaue Konfigurationsstruktur unten ist illustrativ; die Primitive sind das, was auf der Produktseite beschrieben wird.
Kontrollen des Schadensradius für einen Multi-Agenten-Lauf (beispielhafte Gateway-Konfiguration)
run_limits:
  max_delegation_depth: 5          # breaks cycles structurally
  max_total_tokens: 500000         # whole-run budget, force-stop past this
  max_wall_clock_seconds: 600

per_agent:
  invoke_rate_limit: 60/min        # one agent can't call others without bound
  timeout_seconds: 45              # stall detection on a child call
  on_breach: halt_and_alert        # stop the run, page a human
Der Mentalitätswandel besteht darin, einen Multi-Agenten-Lauf als begrenzte Transaktion mit einem Budget und einer Tiefe zu betrachten, nicht als ergebnisoffenes Gespräch. Wenn diese Grenzen am Gateway durchgesetzt werden, führt Tomás' nächtliche Schleife zu einem erreichten Limit und einem Alarm um 2 Uhr morgens, anstatt zu einer fünfstelligen Rechnung um 9 Uhr morgens.
Metriken pro Anfrage – Latenz, Token, Fehler bei jedem einzelnen Aufruf – sind für Multi-Agenten-Systeme notwendig, aber nicht ausreichend, da sie das verlieren, was Sie am meisten brauchen: die Form des Laufs. Wenn drei Delegationsebenen tief etwas schiefgeht, benötigen Sie den gesamten Baum – welcher Agent hat wen in welcher Reihenfolge mit welchen Ein- und Ausgaben aufgerufen und wo sind die Kosten entstanden? Das ist ein End-to-End-Trace, der Agentenschritte, Modellaufrufe und Tool-Aufrufe umfasst, zusammengehalten durch die Lauf-Kennung, die jeder Sprung mit sich führt.
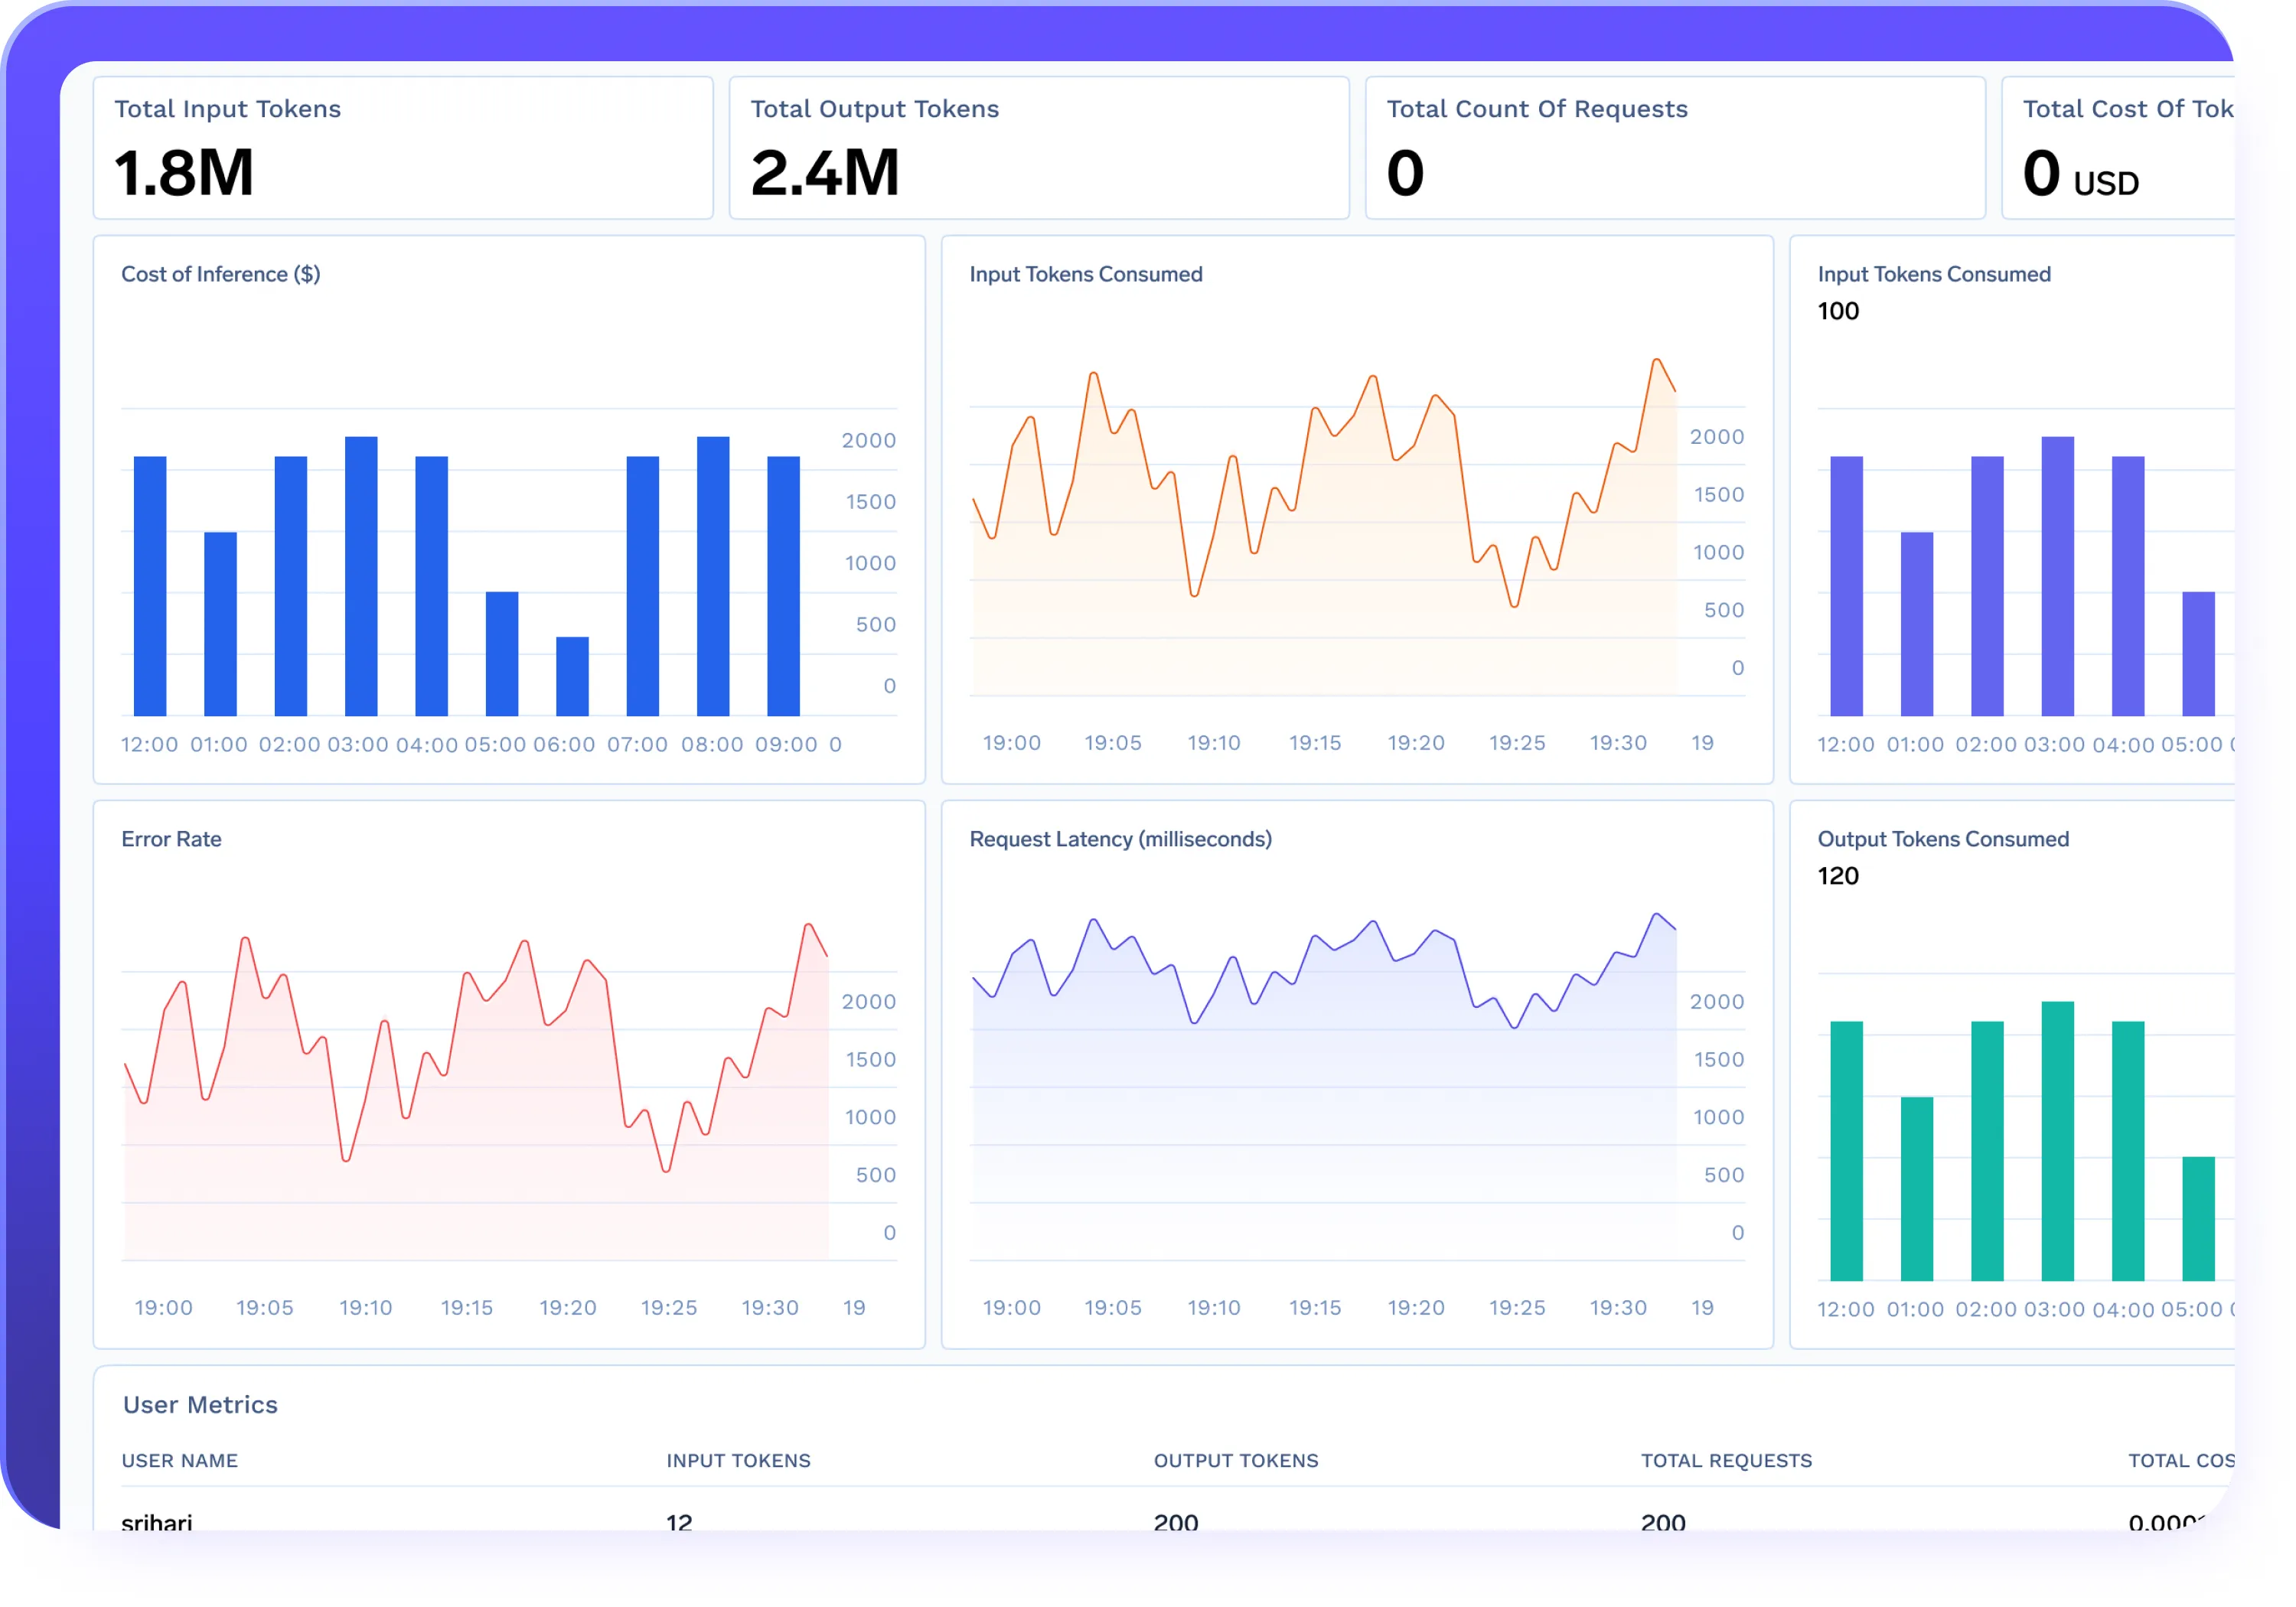
Dies baut direkt auf dem Tracing aus unserem OpenTelemetry-Beitragauf: dasselbe Span-Modell, wobei der Agent als erstklassige Dimension fungiert und der Lauf als Trace, der die Spans miteinander verbindet. Agent Gateway von TrueFoundry erfasst diese End-to-End-Ausführungstraces und ermöglicht es Ihnen, die Logs pro Schritt zu untersuchen, um Fehler zu diagnostizieren – und macht aus „die Agenten haben letzte Nacht zu viel ausgegeben“ ein „diese Kante hat bei Tiefe vier einen Zyklus gebildet“, was den Unterschied zwischen einem Rätsel und einer Lösung ausmacht.
Kosten in einem Multi-Agenten-System sind ohne Identität bedeutungslos. „Der Workflow hat X gekostet“ verrät Ihnen nicht, ob die Ausgaben durch die Planungsaufrufe des Orchestrators, die teure Modellwahl eines Sub-Agenten oder eine Schleife entstanden sind. Die Zuordnung von Token und Kosten zum spezifischen Agenten, Workflow und Lauf – basierend auf der Identität aus Abschnitt 2 – macht die Ausgaben nachvollziehbar und das außer Kontrolle geratene Verhalten diagnostizierbar.
Dies ist dieBeitrag zur Kostenzuordnung's Buchhaltung pro Team, erweitert auf den Agenten als Einheit. Das Agent Gateway ordnet den Token-Verbrauch und die Kosten spezifischen Agenten, Workflows, Teams und Umgebungen zu, was doppelt nützlich ist: Es beantwortet die Finanzfrage (welcher Agent treibt die Kosten) und deckt betriebliche Anomalien auf (die Kostenexplosion eines einzelnen Agenten ist oft das erste sichtbare Anzeichen einer Schleife, lange vor der monatlichen Rechnung). Kombinieren Sie dies mit dem Budget pro Lauf aus Abschnitt 4, und die Kosten werden sowohl beobachtbar als auch begrenzt.
Multi-Agenten-Systeme eröffnen Prompt Injection neue Verbreitungswege. Wie in unserem Beitrag zu Prompt-Injectionbeschrieben, kann ein Agent, der nicht vertrauenswürdige Inhalte liest – etwa ein abgerufener Datensatz oder ein Tool-Ergebnis –, durch darin versteckte Anweisungen gesteuert werden. In einem Multi-Agenten-System kommuniziert dieser kompromittierte Agent dann mit anderen Agenten, und seine Ausgabe wird zu deren Eingabe. Eine Injection, die den Recherche-Agenten erreicht, kann sich auf die nachgelagerten Schreib- und Prüf-Agenten ausbreiten, da diese den Recherche-Agenten als vertrauenswürdigen Partner und nicht als unsichere Quelle betrachten.
Deshalb ist die Abwehr von Injections eine Aufgabe, die zwischen Agenten stattfinden muss und nicht nur an der Eingabeschnittstelle. Genau deshalb ist eine Zentralisierung am Gateway so wichtig: Wenn der Datenverkehr zwischen Agenten über das Gateway geleitet wird, kann es jede Ost-West-Kommunikation überwachen und Sicherheitsrichtlinien einheitlich anwenden, anstatt sich darauf zu verlassen, dass jeder Agent seine Partner selbst überprüft.
Alle hier diskutierten Punkte laufen auf eine Erkenntnis hinaus: Ein Multi-Agenten-System ist ein verteiltes System. Wie jedes verteilte System benötigt es eine Control Plane, die jedem Aufrufer eine Identität, jedem Aufruf eine Richtlinie, jedem Datenfluss eine Nachverfolgung und jedem Durchlauf ein Budget zuweist. Dies in jedes Agenten-Framework über verschiedene Endbenutzer-Computing Umgebungen hinweg zu integrieren – hier LangChain, dort CrewAI, anderswo ein benutzerdefinierter Orchestrator –, führt zwangsläufig zu Inkonsistenzen und Sicherheitslücken, genau dort, wo Tomás' Schleife durchschlüpfen konnte.
Das Agenten-Gateway fungiert als diese Control Plane. Agent Gateway von TrueFoundry Es führt framework-unabhängige Agenten über eine einzige, kontrollierte Ausführungsschicht aus: Identität und RBAC pro Agent, Token- und Kostenkontingente pro Agent und Workflow, Wiederholungsversuche, Timeouts und Schutzmechanismen gegen Endlosschleifen, End-to-End-Tracing sowie MCP-gesteuerter Tool-Zugriff – und vereinheitlicht so den Modell-Datenverkehr des AI Gateway, den Tool-Datenverkehr des MCP Gatewayund den Datenverkehr zwischen Agenten in Multi-Agenten-Systemen an einem zentralen Ort. Für einen tieferen Einblick in die Orchestrierungsmuster selbst ist der Multi-Agenten-Orchestrierungsleitfaden von TrueFoundry eine nützliche Ergänzung; dieser Beitrag konzentriert sich darauf, wie man sie im laufenden Betrieb steuert.
Ist A2A nicht noch am Anfang? Warum jetzt schon regulieren?
A2A steckt als Unternehmensstandard noch in den Kinderschuhen – auch wenn das Protokoll mittlerweile eine formale v1.0-Spezifikation besitzt. Da sich die Konventionen im Ökosystem weiterentwickeln werden, sollten spezifische Details als vorläufig betrachtet werden. Doch der Bedarf an Governance wartet nicht, bis sich die Einführung etabliert hat: Sobald Ihre Agenten Aufgaben aneinander delegieren, entsteht – unabhängig vom Mechanismus – ein Ost-West-Datenverkehr ohne Identitätsprüfung oder Begrenzungen. Die hier genannten Kontrollmechanismen – Identität pro Agent, Autorisierung, Begrenzung des Schadensradius, Tracing – greifen unabhängig davon, ob Agenten über A2A, die native Delegation eines Frameworks oder einfaches HTTP kommunizieren.
Wie unterscheidet sich das von dem Beitrag über die verwaltete Agenten-Schicht?
Jener Beitrag plädierte für die Trennung von Agenten-Logik und Laufzeitumgebung – also wo Agenten-Code ausgeführt und wie er bereitgestellt wird. Dieser Beitrag befasst sich mit der Steuerung der Kommunikation zwischen Agenten im laufenden Betrieb: Identität bei jedem Zwischenschritt, wer wen aufrufen darf, Eindämmung von Kaskadeneffekten und Nachverfolgung der Abläufe. Es sind verwandte Ebenen, aber unterschiedliche Probleme: Die Trennung der Laufzeitumgebung betrifft den Agenten als bereitstellbare Einheit; dies hier betrifft den Agenten als Netzwerkteilnehmer.
Welche einzelne Kontrollmaßnahme hätte den Vorfall zu Beginn verhindert?
Zwei, wenn sie zusammenwirken. Eine Autorisierungsregel, die Unter-Agenten untersagt, den Orchestrator erneut aufzurufen, hätte die Schleife strukturell bereits beim ersten Schritt unterbunden. Ein Limit für die Delegationstiefe und eine Ratenbegrenzung pro Agent hätten zudem jeden Zyklus abgefangen, der die Richtlinie hätte umgehen können. Da beides nicht das Verständnis der Workflow-Absicht erfordert, sondern lediglich dessen Form begrenzt, gehören diese Kontrollen ins Gateway und nicht in die Logik des einzelnen Agenten.
Benötigen Agenten wirklich jeweils eine eigene Identität?
Für alles, was Sie pro Agent autorisieren, zuordnen oder prüfen müssen – ja. Ein gemeinsamer Schlüssel fasst alle Agenten zu einem einzigen Principal zusammen, weshalb Tomás nicht feststellen konnte, welcher Agent die Schleife ausgelöst hat oder was jeder einzelne gekostet hat. Die Identität pro Agent, bei der der menschliche Principal beibehalten wird, ist das Fundament, von dem alle anderen Kontrollmechanismen in diesem Beitrag abhängen.
Gateway oder Framework für Multi-Agent-Governance?
Das Framework erstellt den Workflow; das Gateway steuert ihn. Identität, Autorisierung, Raten- und Tiefenbegrenzungen, Tracing und Kostenzuordnung sind übergreifende Aspekte, die über alle Agenten und Frameworks hinweg konsistent sein müssen. Genau das bietet eine zentrale Steuerungsebene, was eine Implementierung pro Framework nicht garantieren kann.
Der Vorfall bei Tomás war kein raffinierter Fehler; es war ein ungeregeltes internes Netzwerk, das tat, was ungeregelte Netzwerke eben tun. Multi-Agenten-Systeme sind leistungsstark, weil Agenten frei delegieren können – und genau diese Freiheit ist der Grund, warum sie Identität, Limits und eine Nachverfolgung an jeder Schnittstelle benötigen. Wenn Sie diese Steuerungsebene vor den Agenten-Traffic schalten, bleibt die Delegation ein Feature, anstatt zu einem Vorfall um 2 Uhr morgens zu werden.
Northwind und Tomás dienen der Veranschaulichung. Eine Klarstellung ist ausdrücklich wichtig: Agent2Agent (A2A) ist ein offenes Kommunikationsprotokoll, während das TrueFoundry Agent Gateway das Produkt und die Implementierung der Steuerungsebene von TrueFoundry zur Verwaltung von Agenten-Workflows ist – es handelt sich um unterschiedliche Dinge. Dieser Beitrag verwendet A2A als Standardvokabular für den Datenverkehr, den das Gateway steuert. Die Funktionen des TrueFoundry Agent Gateways sind gemäß der öffentlichen Produktdokumentation vom Juni 2026 zusammengefasst und werden sich weiterentwickeln; einige Funktionen befinden sich möglicherweise in der Vorschau. A2A ist als Muster für die Unternehmensanwendung noch jung und die Konventionen des Ökosystems werden sich weiterentwickeln. Daher werden die Protokollspezifikationen hier auf einer hohen Ebene beschrieben und sollten anhand der aktuellen Spezifikation überprüft werden. Code- und Richtlinienbeispiele dienen der Veranschaulichung der dokumentierten Muster und sind nicht aus einer Referenzimplementierung kopiert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet