



October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Experimentation Tracking ist ein kritischer Aspekt der Entwicklungsarbeit im Machine Learning, der es Entwicklern ermöglicht, den Fortschritt ihrer Experimente effizient zu verwalten und zu verfolgen. Experimentation Tracking umfasst das Aufzeichnen und Überwachen verschiedener Faktoren wie Modellleistung, Hyperparameter und Trainingsdaten, um Einblicke in die Performance des Machine Learning Modells zu gewinnen.
Das Verwalten von Experimenten und Verfolgen von Ergebnissen kann für Machine Learning Spezialisten aufgrund der Komplexität der Modelle, der großen Datenmengen und der Vielfalt der verwendeten Tools und Frameworks eine anspruchsvolle Aufgabe sein. Hier sind einige der zentralen Herausforderungen bei der Verwaltung von Experimenten und der Nachverfolgung von Ergebnissen:
Weights & Biases (W&B) ist eine Plattform, die Entwicklern im Bereich Machine Learning dabei hilft, ihre Experimente effektiv zu verwalten und zu verfolgen. Sie bietet eine Suite von Tools für Experiment-Tracking, Visualisierung und Kollaboration, was die Entwicklung robuster und skalierbarer Machine Learning Modelle erleichtert.
Die Hauptfunktionen und Vorteile der W&B-Plattform sind:
Das Einrichten von W&B zum Nachverfolgen von Experimenten umfasst mehrere Schritte:
wandb.init() initialisieren. Diese Funktion initialisiert die W&B-Bibliothek und richtet einen neuen Run ein.wandb.log() aufruft. Diese Funktion nimmt ein Dictionary von Metriken als Eingabe entgegen und protokolliert sie im W&B-Dashboard.wandb.config aufruft. Diese Funktion nimmt ein Dictionary von Hyperparametern als Eingabe entgegen und protokolliert sie im W&B-Dashboard.wandb.log() mit den entsprechenden Visualisierungsdaten aufruft. W&B bietet eine breite Palette an Visualisierungswerkzeugen, darunter 3D-Visualisierungen, Konfusionsmatrizen, Streudiagramme und mehr.Hier ist ein Beispiel dafür, wie Sie Metriken, Modelle, Hyperparameter und Visualisierungen mit W&B protokollieren:
import wandb
import numpy as np
import matplotlib.pyplot as plt
import tensorflow as tf

# Step 1: Initialize W&B
wandb.init(project="my-project")

# Step 2: Log hyperparameters
config = {
    "learning_rate": 0.001,
    "batch_size": 32,
    "epochs": 10
}
wandb.config.update(config)

# Step 3: Train model and log metrics
model = tf.keras.models.Sequential([
    tf.keras.layers.Dense(10, activation='relu', input_shape=(10,)),
    tf.keras.layers.Dense(1)
])
model.compile(optimizer=tf.keras.optimizers.Adam(config['learning_rate']),
              loss=tf.keras.losses.MeanSquaredError(),
              metrics=[tf.keras.metrics.MeanAbsoluteError()])
for epoch in range(config['epochs']):
    # ... train model ...
    history = model.fit(x_train, y_train, batch_size=config['batch_size'])
    loss = history.history['loss'][-1]
    mae = history.history['mean_absolute_error'][-1]
    wandb.log({"epoch": epoch, "loss": loss, "mae": mae})

# Step 4: Log visualizations and model
x = np.linspace(0, 10, 100)
y = np.sin(x)
fig, ax = plt.subplots()
ax.plot(x, y)
wandb.log({"my_plot": wandb.Image(fig)})
wandb.save('my_model.h5')

# Step 5: Finish run
wandb.finish()
c
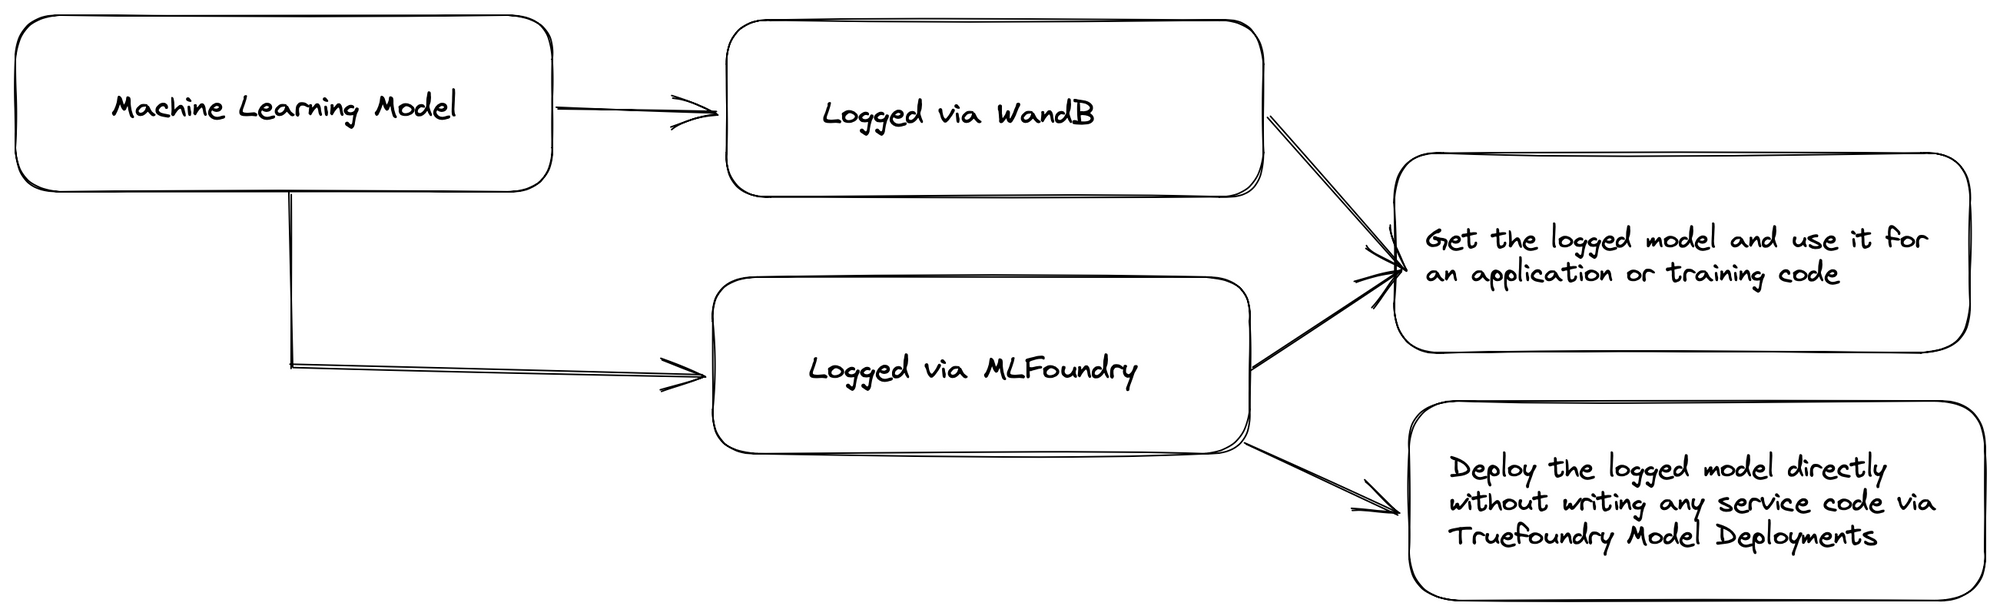
TrueFoundry integriert nahtlos mit der Weights & Biases Model Registry, damit Sie in Weights & Biases protokollierte Modelle mithilfe von TrueFoundry in Ihrem Kubernetes Cluster bereitstellen können.
📌
Neben der Nutzung von Weights & Biases für Modellmanagement und Experimentation Tracking können Sie auch das Experimentation Tracking MLFoundry von TrueFoundry verwenden.
📌
Sie können dem folgenden Code auch über dieses Colab Notebook folgen:
Colab Notebook
Schritt 1 – Installation und Einrichtung:
pip install wandb -qU
import wandb
wandb.login()
pip install -U "servicefoundry"
sfy login
Schritt 2 – Modell trainieren und protokollieren:
Wir werden zuerst wandb.init() verwenden, um das Projekt zu initialisieren
Dann trainieren wir unser ML-Modell und speichern es als joblib-Datei
Anschließend speichern wir unsere joblib-Datei über wandb.save() in wandb
import wandb
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib

# Initialize W&B
wandb.init(project="iris-logistic-regression")

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Log the model and the evaluation metrics to W&B
joblib.dump(clf, "model.joblib")
wandb.save("model.joblib")

# Finish the run
wandb.finish()
Schritt 3 – Inferenz-Anwendung und Abhängigkeitsdatei erstellen:
Wir müssen zwei Dateien erstellen, um auf TrueFoundry zu deployen: eine app.py-Datei, die unseren Anwendungscode enthält, und eine requirements.txt-Datei, die unsere Abhängigkeiten enthält.
.
├── app.py
├── deploy.py
└── requirements.txt
c
wandb.restore() übergeben: <name_of_saved_file> und "username/project/run_id"wandb.restore("model.joblib", "adityajha-tfy/iris-logistic-regression/00r5xvyv")import os
import wandb
import joblib
import pandas as pd
from fastapi import FastAPI
wandb.login(key=os.environ["WANDB_API_KEY"])
# Retrieve the model from W&B
model_joblib = wandb.restore(
'model.joblib',
run_path="adityajha-tfy/iris-logistic-regression/00r5xvyy",
)
model = joblib.load(model_joblib.name)
# Load the model
app = FastAPI(root_path=os.getenv("TFY_SERVICE_ROOT_PATH"))
@app.post("/predict")
def predict(
sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
data = dict(
sepal_length=sepal_length,
sepal_width=sepal_width,
petal_length=petal_length,
petal_width=petal_width,
)
prediction = int(model.predict(pd.DataFrame([data]))[0])
return {"prediction": prediction}
fastapi
joblib
numpy
pandas
scikit-learn
uvicorn
wandb
Schritt 4 – Python-SDK von TrueFoundry nutzen und das Deployment konfigurieren
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
parser.add_argument("--wandb_api_key", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
    env={
        "WANDB_API_KEY": args.wandb_api_key
    }
)
service.deploy(workspace_fqn=args.workspace_fqn)
Schritt 5 – Service über Truefoundry deployen
Führen Sie den folgenden Befehl aus und übergeben Sie Ihre
python deploy.py --workspace_fqn "<Your Workspace FQN>" --wandb_api_key "<Your Wandb API Key>"
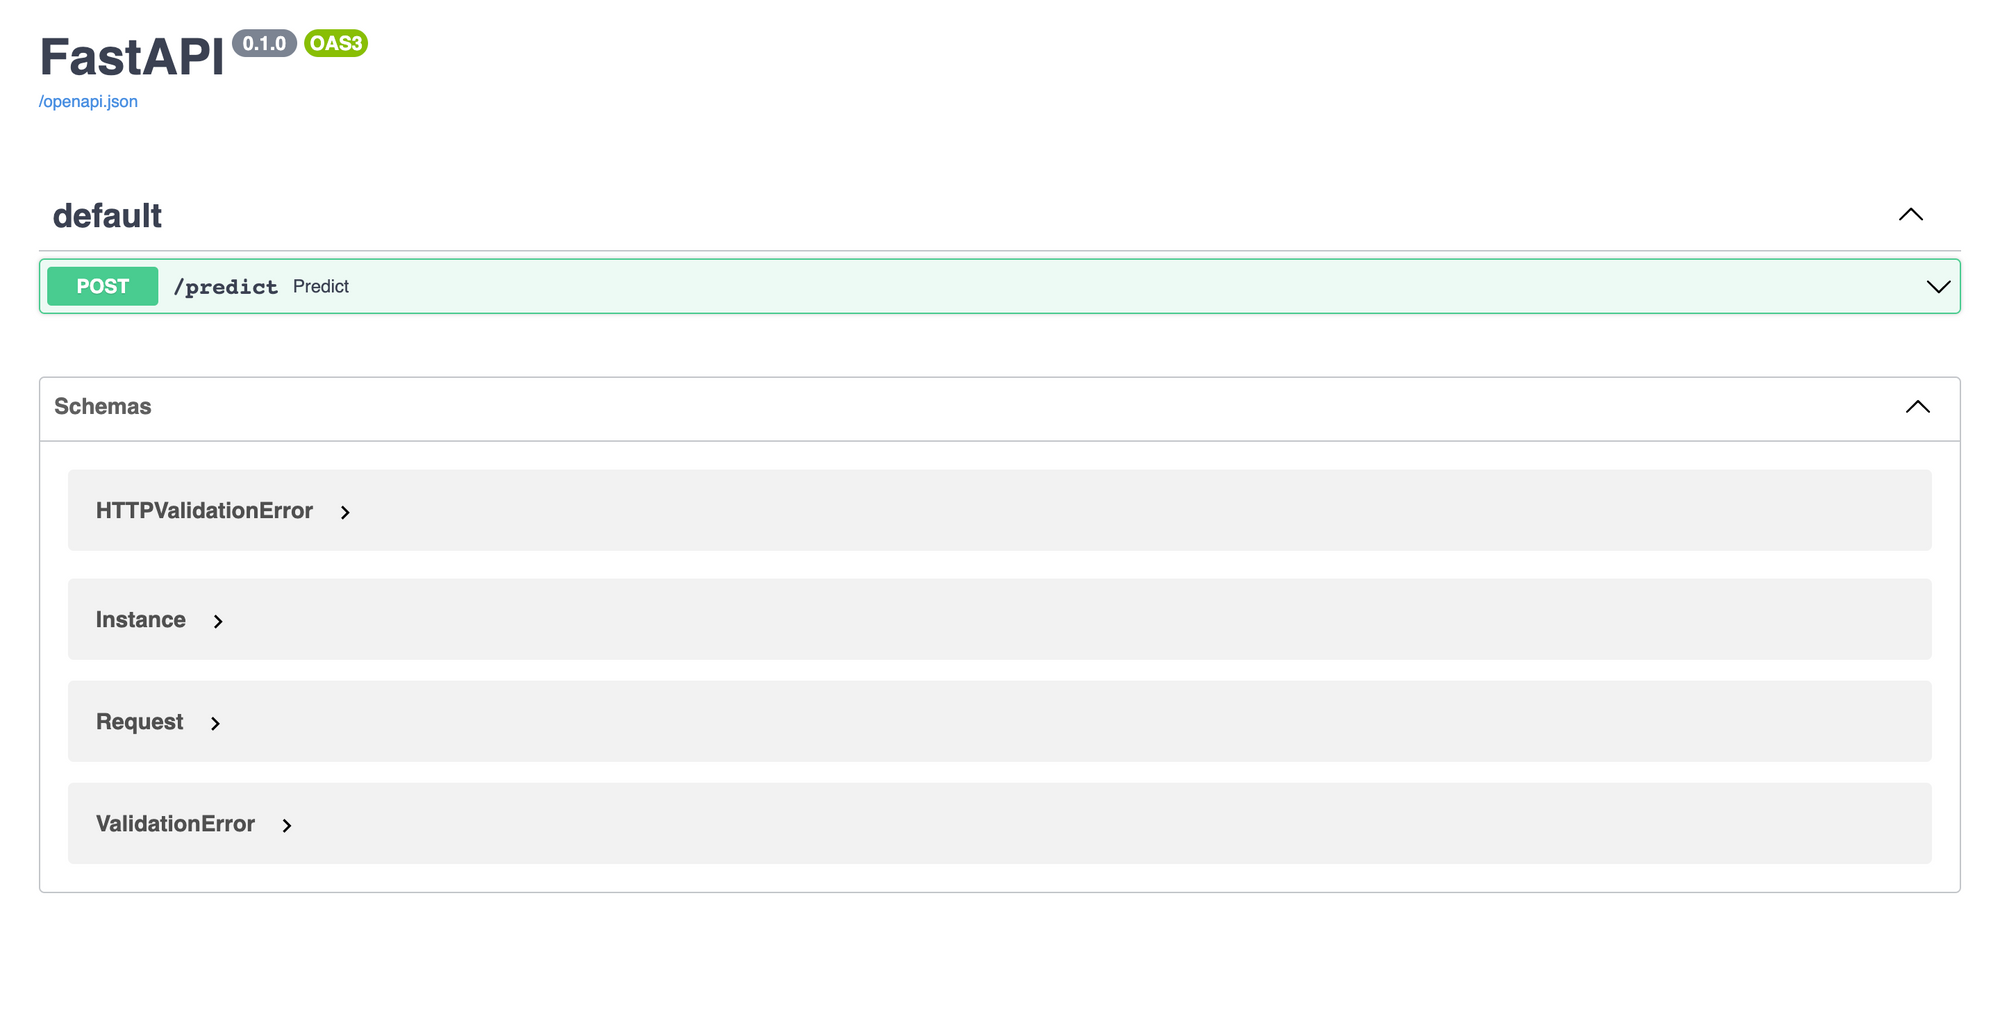
Und voila!!! In den Logs finden Sie das Dashboard Ihres bereitgestellten Service. Oben rechts finden Sie dann den Endpunkt Ihrer bereitgestellten Anwendung.
TrueFoundry ist eine ML Deployment PaaS auf Kubernetes, um Entwickler-Workflows zu beschleunigen und ihnen volle Flexibilität beim Testen und Deployen von Modellen zu bieten, während gleichzeitig volle Sicherheit und Kontrolle für das Infra-Team gewährleistet werden. Über unsere Plattform ermöglichen wir Machine Learning Teams, Modelle in 15 Minuten mit 100 % Zuverlässigkeit, Skalierbarkeit und der Möglichkeit zum Rollback in Sekunden zu deployen und zu überwachen – so können sie Kosten sparen und Modelle schneller in Produktion bringen, was echten Geschäftswert schafft.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















