October 31, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Während der Großteil der Ära der KI-Agenten war die Kontextstrategie wie ein Umzugswagen: Man lud alles, was der Agent möglicherweise brauchen könnte – das Handbuch mit den Konventionen, den gesamten Tool-Katalog, das Referenzmaterial – vorab in das Fenster und hoffte, dass das Modell die relevanten Teile findet. Ein wachsendes Muster im Kontext-Engineering kehrt dies nun um. JIT-Kontext – JIT steht für „Just-in-Time“, genau wie bei den Just-in-Time-Compilern in Ihrem Browser – ist das Muster, das Anthropic in seinem Leitfaden zum Kontext-Engineering in den Mittelpunkt der Disziplin stellt: Es hält das Fenster nahezu frei von Payloads und stattdessen gefüllt mit Verweisen: Der Agent weiß, was existiert – Skills anhand ihrer Metadaten, Daten anhand ihrer Referenzen, Tools anhand eines schlanken Index – und die umfangreichen Inhalte werden erst in dem Moment geladen, in dem sie benötigt werden, um danach wieder freigegeben zu werden. Für viele langlebige Agenten entwickelt sich JIT-Kontext zum sichereren Standard, während das Vorabladen von allem zur bewussten Ausnahme wird. Dieser Beitrag beschreibt das Engineering dieser Umkehrung – was man spät laden sollte, was zwingend vorab geladen bleiben muss und warum JIT-Kontext letztlich eine Laufzeiteigenschaft und keine Prompting-Gewohnheit ist.
Lucia, eine Plattform-Ingenieurin, erbte einen Agenten, dessen Systemkontext wie ein Dachboden zugemüllt war. Jemand hatte das vollständige technische Handbuch vorab geladen, „damit er die Konventionen befolgt“. Jemand anderes hatte alle vierzig Tool-Beschreibungen eingefügt, „damit er seine Optionen kennt“, und dann dreitausend Zeilen API-Referenz, „damit er aufhört, Schemata zu erraten“. Jede Ergänzung hatte ihren Grund; das Ergebnis war ein Agent, der jeden Durchlauf mit einem bereits fast vollständig belegten Fenster begann, für dieses tote Gewicht bei jedem seiner dreißig Schleifenschritte erneut bezahlte und – der Teil, der schließlich Aufmerksamkeit erregte – eine schlechtere Leistung erbrachte als ein abgespeckter Prototyp bei denselben Aufgaben. Die Lösung, die funktionierte, fühlte sich in ihrer Einfachheit fast beleidigend an: Entfernen Sie fast alles, lassen Sie nur einzeilige Beschreibungen dessen zurück, was existiert und wo es zu finden ist, und lassen Sie den Agenten den Handbuchabschnitt, das Schema oder das Verfahren in dem Moment abrufen, in dem ein Schritt es tatsächlich erfordert. Gleiches Wissen, andere Zeitform. Der Dachboden wurde zu einer Bibliothek mit einem Katalog.
Dieses Refactoring hat jetzt einen Namen – JIT-Kontext – und es konvergiert aus drei Richtungen: Anthropic's Leitfaden zum Kontext-Engineering (September 2025) machte das Abrufen zur Laufzeit gegenüber dem Vorabladen zu einem Kernprinzip; das Skills-Ökosystem machte „Progressive Disclosure“ zum Lademodell für verpacktes Wissen; und Entwickler von Frameworks machten das Auslagern und die Isolierung zum Standard-Laufzeitverhalten. Dieser Beitrag verbindet diese Fäden Schicht für Schicht und endet bei der Frage, die Kontext-Beiträge in dieser Serie immer aufwerfen: Wer sollte diese Arbeit erledigen – Ihre Prompt-Autoren oder die Laufzeitumgebung unter ihnen?
Der Instinkt zum Vorabladen ist in einer Chat-Welt rational. Ein Austausch in einem einzigen Schritt hat nur eine Chance auf Kontext, also lädt man alles vorab; im schlimmsten Fall ignoriert das Modell den Überschuss. Agenten haben beide Annahmen gebrochen. Eine Schleife sendet ihr Fenster bei jedem jedem Schritt erneut, sodass der Überschuss wiederholt und nicht nur einmal berechnet wird. Und der Überschuss wird nicht ignoriert – Forschung zu langem Kontext und die Erfahrung von Praktikern bestätigen, dass Modelle an Qualität verlieren, wenn Fenster mit wenig relevantem Text gefüllt sind, ein Fehlerzustand, den die Community als „Kontext-Fäulnis“ bezeichnet. Der Ansatz des Bedienungsanleitung-Stils – alles lesen, bevor man auf Start klickt – führt dazu, dass ein Agent gleichzeitig langsamer, teurer und dümmer wird.
JIT-Kontext kehrt den Standard um. Der ständige Inhalt des Fensters schrumpft auf das wirklich immer Benötigte (Aufgabe, Kernanweisungen, aktuelle Schritte) plus einen Katalog – kompakte Beschreibungen dessen, was existiert und wie man es bekommt: ein Skill als Name und ein Satz, ein Datensatz als Pfad, ein früheres Ergebnis als Handle. Wenn ein Schritt die Payload benötigt, ruft der Agent (oder das Framework in seinem Namen) sie ab, verwendet sie und lässt sie danach wieder aus dem aktiven Fenster fallen. Die Formulierung von Anthropic ist diejenige, die man verinnerlichen sollte: Behalten Sie leichtgewichtige Identifikatoren bei, laden Sie Daten zur Laufzeit. Das Fenster hört auf, ein Lagerhaus zu sein, und wird zu einer Werkbank.
Das Muster ist nicht neu – es ist bewusst aus dem Interface-Design entlehnt. „Progressive Disclosure“ ist das UX-Prinzip aus den 1990er Jahren, nach dem Benutzer, denen fünfzig Einstellungen gezeigt werden, erstarren, während Benutzer, denen drei Einstellungen und ein „Erweitert“-Schalter gezeigt werden, erfolgreich sind; man enthüllt Komplexität im Moment der Absicht, nicht vorher. Die Community hat sich explizit zu dieser Übertragung geäußert: Ein Agent, dessen Fenster mit allem vollgestopft ist, was er möglicherweise brauchen könnte, verliert genau wie ein Benutzer vor einem überladenen Bildschirm an Effektivität, und das Heilmittel ist dieselbe Staffelung der Informationen. Der Agent weiß, dass eine Fähigkeit existiert – das sind die Metadaten, immer sichtbar, kostengünstig. Das volle Gewicht der Fähigkeit – Anweisungen, Skripte, Referenzdateien – bleibt hinter dem Schalter, bis der Agent entscheidet, sie zu verwenden.
Der Name selbst trägt eine Abstammung, von der es sich lohnt zu lernen. Wenn Sie einen Informatik-Hintergrund haben, ist die engste Analogie JIT-KompilierungAnstatt ein gesamtes Programm im Voraus zu kompilieren, übersetzt ein JIT-Compiler jedes Teil erst in dem Moment, in dem es ausgeführt wird – wenn die Laufzeitumgebung weiß, dass der Codepfad tatsächlich beschritten wird, und über aktuelle Informationen zu dessen Verwendung verfügt. Der Gewinn ist zweifach: Man zahlt nicht für die Kompilierung von Code, der nie ausgeführt wird, und die Kompilierung, die man durchführt, ist fundierter, da sie mit dem Kontext der Laufzeitumgebung erfolgt. JIT-Kontext lässt sich fast eins zu eins darauf übertragen. Vorladen ist eine Kompilierung im Voraus: Man investiert Aufmerksamkeit und Token für alles, was vielleicht benötigt wird, und entscheidet dies, bevor die Aufgabe offenbart, was sie tatsächlich erfordert. JIT-Kontext verschiebt das Laden auf den Moment der Verwendung – der Verweis im Fenster ist das Symbol, das die Laufzeitumgebung auflösen kann, und die Aktivierung des Agenten ist die Aufrufstelle, die die Auflösung auslöst. Die Lektion ist dieselbe, die Compiler-Entwickler vor Jahrzehnten gelernt haben: Alles im Voraus bereitzuhalten ist teurer als das Abrufen bei Bedarf, und das Abrufen ist, wenn es richtig gemacht wird, kostengünstig und zielgerichteter, weil es erst dann geschieht, wenn man endlich weiß, was die Aufgabe benötigt.
Was die Übertragung über eine bloße Metapher hinaushebt, ist die Tatsache, dass die Ladegrenze softwareseitig durchsetzbar ist. Eine Benutzeroberfläche kann Benutzer nur zur richtigen Offenlegung ermutigen; ein Framework kann diese implementieren – und mechanisch entscheiden, was wann in das Fenster gelangt, genau wie ein System für virtuellen Speicher entscheidet, was im Arbeitsspeicher resident ist. Diese Analogie (Kontextfenster als RAM, externe Speicher als Festplatte, das Framework als Pager) ist die systemtechnische Sichtweise, um alles Folgende zu verstehen: JIT-Kontext ist Paging für Aufmerksamkeit.
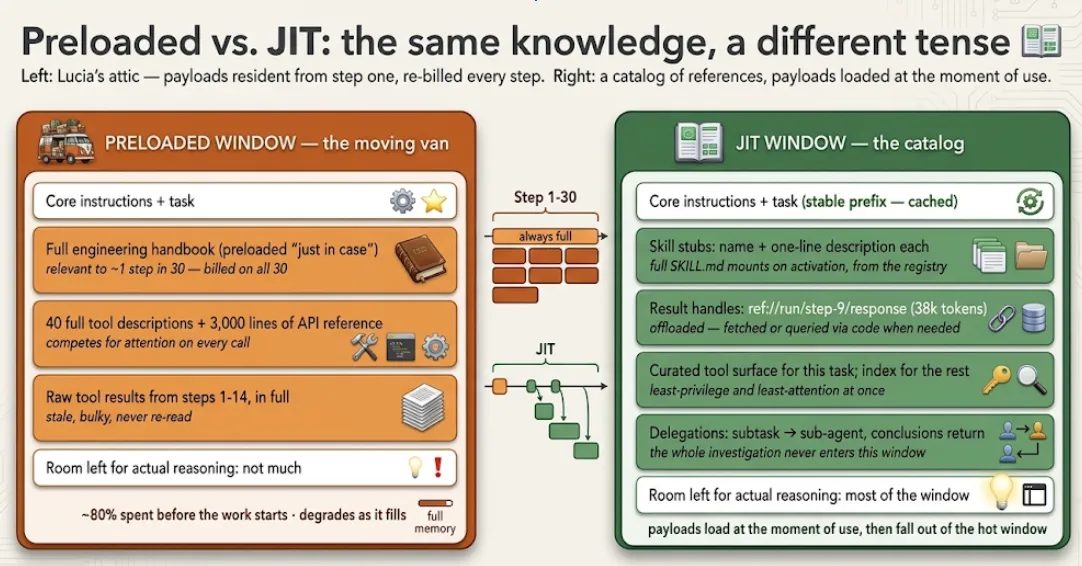
Drei sich verstärkende Effekte rechtfertigen dieses Muster. Aufmerksamkeit: Jedes vorgeladene Token konkurriert mit der Aufgabe um den Fokus des Modells, und die Verschlechterung ist kein linearer Prozess – irrelevante Datenmengen beeinträchtigen die Leistung bei den wichtigen Dingen aktiv. Das ist der Grund, warum Lucias abgespeckter Prototyp den geladenen Produktions-Agenten übertraf. JIT ist die architektonische Verteidigung gegen Kontext-Verfall: Das Fenster enthält nur relevante Signale, weil Rauschen gar nicht erst zugelassen wurde. Kosten: In einer Schleife wird das Fenster bei jedem Schritt erneut gesendet, sodass ein vorgeladenes Handbuch nicht einmal, sondern dreißigmal bezahlt wird; die Arithmetik unseres Token-Verbrauchs greift hier, und JIT setzt am größten Kostenfaktor an – dem stehenden Gewicht, das überall mitgeschleppt wird. Aktualität: Eine vorgeladene Kopie ist ein Schnappschuss, der mit fortschreitendem Ablauf veraltet, während sich ein Verweis auf den aktuellen Stand der Datei, des Tickets oder der Datenbank im Moment der Verwendung bezieht – für langlebige Agenten ist spätes Laden nicht nur günstiger, sondern auch korrekter.handelt.
Die ehrliche Bilanz: JIT erkauft sich diese Vorteile durch eine Abruflatenz bei den Schritten, die geladen werden (meist vernachlässigbar im Vergleich zu einem Modellaufruf, aber vorhanden), einen neuen Fehlertyp (ein nicht auflösbarer Verweis muss als ehrlicher Fehler und nicht als halluzinierter Payload erscheinen) und eine Abhängigkeit von der Beschreibungsqualität – der Agent lädt basierend auf den Einzeilern des Katalogs, sodass ein schlechter Stub einen guten Payload verdeckt. Nichts davon entkräftet das Urteil; all dies gehört in das Design.
Skills sind der Bereich, in dem das Muster am deutlichsten wird, da das SKILL.md-Ökosystem genau darauf ausgelegt wurde. Ein Skill liegt als Verzeichnis brach; was der Agent standardmäßig sieht, sind die Metadaten – ein Name und eine prägnante Beschreibung – und die umfangreichen Inhalte (Schritt-für-Schritt-Anleitungen, Referenzdateien, Skripte) werden erst injiziert, wenn der Agent den Skill aktiviert, weil die Aufgabe dazu passt. Das ist progressive Offenlegung als Lademodell, und es verändert, was eine Skill-Bibliothek sein kann: Ein Unternehmen kann Dutzende tiefgreifender Prozeduren pflegen, ohne dass ein Agent für mehr als den Katalog bezahlen muss, da Tiefe nichts kostet, bis sie tatsächlich genutzt wird. Die Schlussfolgerung, die Anwender schnell lernen: Die Beschreibung ist tragend – sie ist die gesamte Grundlage, auf der der Agent entscheidet, ob er lädt. Daher ist ein langweiliger, präziser Stub besser als ein cleverer.
Auf TrueFoundry ist dies das native Verhalten der Skills Registry: versionierte SKILL.md-Artefakte, veröffentlicht mit RBAC, referenziert per Name und bei Bedarf eingebunden in den Ablauf. Die Registry ergänzt, was der Laptop-Version fehlt – die Herkunft der JIT-geladenen Payloads: Mit Versionierung, RBAC und Audit-Historie können Teams die Frage „Welche Prozedurversion wurde für diesen Durchlauf verwendet?“ zu einem nachvollziehbaren Fakt machen, statt zu raten. Das ist genau deshalb wichtig, weil der Inhalt nicht statisch in einem überprüfbaren Prompt liegt. JIT-Laden ohne Versionierung ist dynamisches Verhalten ohne Audit-Trail; die Registry schließt diese Lücke.
Die zweite Ebene sind Werkzeugergebnisse – bei langen Abläufen oft der Großteil des Fensters. Die naive Schleife fügt eine 38.000-Token-API-Antwort in den Kontext ein, weil Ergebnisse dort nun einmal landen; JIT kehrt dies um mit Auslagerung großer Ergebnisse: Das Payload landet im Speicher, das Fenster erhält ein kompaktes Handle (was es ist, wie groß, wo es liegt), und der Inhalt wird nur abgerufen, wenn ein späterer Schritt ihn tatsächlich lesen muss. Dasselbe Prinzip findet sich in modernen Agentensystemen: Sperrige Ausgaben werden extern gehalten, während das Modell mit prägnanten Vorschauen oder Referenzen statt mit Rohdaten arbeitet, und alte Werkzeugausgaben werden durch Zeiger ersetzt.
Code-Modus ist die stärkere Form: Viele Schritte vom Typ „Daten lesen“ benötigten die Daten im Fenster überhaupt nicht – sie benötigten eine Berechnung darüber. Zehntausend Log-Zeilen filtern, zwei Exporte zusammenführen, Fehler nach Typ zählen: Der Agent schreibt Code, der auf dem ausgelagerten Payload in einer Sandbox ausgeführt wird und das Ergebnis zurückgibt – drei Zeilen im Kontext statt zehntausend. Das Fenster enthält Schlussfolgerungen; die Sandbox enthält die Datenmengen. Beide Verhaltensweisen sind Standard der Context-Engineering-Suite des Harness, wo sie auch hingehören: Kein Modell kann durch Prompting dazu gebracht werden, kein Payload zu empfangen – nur die Laufzeitumgebung, die das Modell speist, kann entscheiden, was hineingelangt.
Auf grundlegender Ebene ist die Mechanik unspektakulär, aber einmal sehenswert. Der Harness fängt das Werkzeugergebnis ab, bevor es zu einer Nachricht wird; überschreitet es den Inline-Schwellenwert, wandert das Payload in einen laufzeitgebundenen Speicher und das Modell erhält das Handle – typisiert, bemessen, adressierbar –, sodass die vom API geforderte Konversationsstruktur intakt bleibt, während der Token-Fußabdruck um drei Größenordnungen schrumpft:
Was das Modell tatsächlich sieht: Auslagerung und Code-Modus auf Nachrichtenebene (illustrativ)
// Step 9, naive loop: the raw payload becomes the message — 38,120 tokens,
// re-sent on every subsequent step of the run.

// Step 9, JIT loop: the harness offloads and substitutes a handle — 41 tokens.
{ "role": "tool", "content": {
    "offloaded": true,
    "ref": "tfy://runs/8c2e/steps/9/result",
    "content_type": "application/json",
    "tokens": 38120,
    "preview": "orders[] — 4,212 records, fields: id, status, region, total"
} }

// Later step, code mode: the agent computes over the payload in the sandbox
// — the answer enters the window; the 4,212 records never do.
df = read_ref("tfy://runs/8c2e/steps/9/result")
failed = df[df.status == "failed"].groupby("region").total.sum()
print(failed.to_dict())   # → {"emea": 41230.50, "apac": 9120.00}
Zwei Implementierungsdetails unterscheiden eine robuste Version hiervon von einer fragilen. Die Vorschauzeile leistet echte Arbeit – sie ist der Katalogeintrag, der dem Modell erlaubt zu entscheiden, ob ein späterer Abruf gerechtfertigt ist; daher sollte sie Schema und Struktur enthalten, nicht nur eine Byte-Anzahl. Und in einer robusten Implementierung sollten Handles laufzeitgebunden und zugriffsgeschützt sein wie jede andere Ressource: Eine Referenz, die das Modell ausgeben kann, ist eine Referenz, die ein injizierter Prompt abfragen kann. Die Auflösung erfolgt daher über dieselbe Gateway-Autorisierung wie ein Werkzeugaufruf.
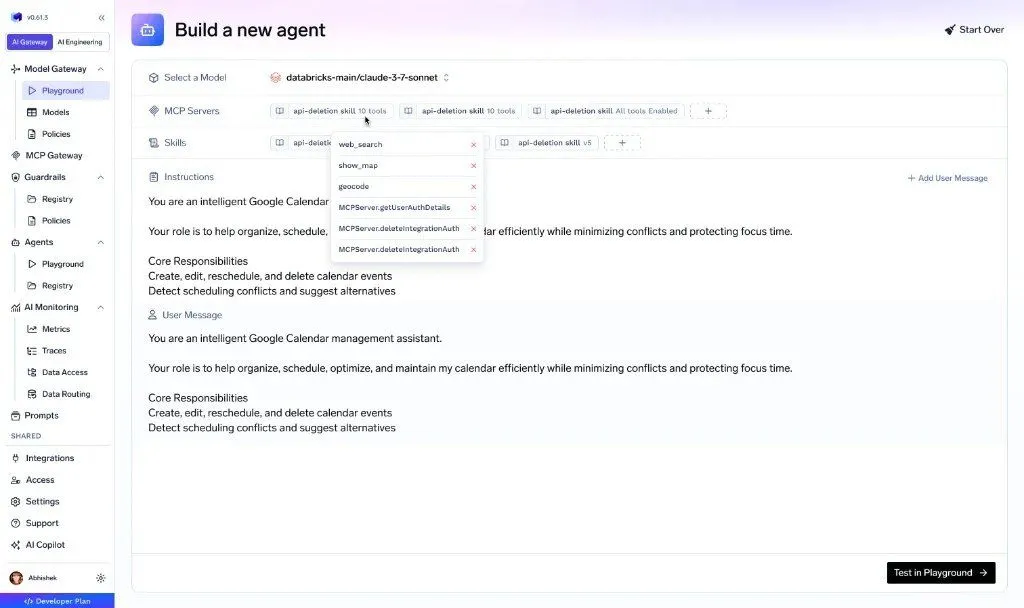
Das Muster lässt sich von Inhalten auf Arbeit übertragenEine kontextintensive Teilaufgabe – etwa die Untersuchung eines Log-Bestands oder das Durchsuchen von Dateien – kann JIT-delegiert werden an einen Sub-Agenten: Ein frisches, isoliertes Fenster übernimmt die Exploration, und nur das destillierte Ergebnis kehrt zurück. Das Fenster des übergeordneten Prozesses enthält niemals die Untersuchung selbst, so wie ein JIT-Fenster niemals das ungelesene Handbuch enthält – die Delegationsebene unseres Spektrums aus Tools, Fähigkeiten und Sub-Agenten, verstanden als Kontextinstrument. Die gleiche Logik gilt für Tool-Oberflächen: Vierzig vorinstallierte Beschreibungen sind vierzig ständige Ansprüche auf Aufmerksamkeit. Daher ist die JIT-Haltung ein kuratiertes, aufgabenrelevantes Set (gesteuert durch die Preload-Tools des Harness), bei dem der „Long Tail“ bei Bedarf abrufbar ist – wodurch minimale Aufmerksamkeit und das Prinzip der geringsten Rechte zur gleichen Konfiguration werden.
Und wenn die Historie eines langen Laufs selbst zum Ballast wird, ist Kompaktierung das Gegenstück zur oben genannten Prävention: Fassen Sie das Transkript zusammen, bewahren Sie Entscheidungen und offene Themen auf, verwerfen Sie verbrauchte Details. Ein verwalteter Lauf atmet – Referenzen sammeln sich an, Payloads kommen hinzu, Zusammenfassungen ersetzen die Historie –, anstatt monoton in Richtung der Verrottungsschwelle zu wachsen.
JIT-Kontext als Konfiguration, nicht als Prompting-Heldentum (illustrativ)
agent:
  name: support-investigator
  model: claude-sonnet-4-6
  instructions: ./core.md@v6          # the stable prefix — small, cached, preloaded
  skills:                              # catalog resident; SKILL.md mounts on activation
    - refund-policy@v7
    - incident-runbook@v3
  mcp_servers:
    - support-db: [lookup_ticket]      # curated surface resident; long tail on demand
  subagents:
    - { name: log-analyzer, mcp_servers: [logs-readonly] }   # JIT a whole subtask
  harness:
    tool_results: { max_inline_tokens: 4000 }   # larger results offloaded, handle in window
    code_mode: enabled                 # compute over payloads instead of reading them
    compaction: { trigger_fill: 0.6 }  # history summarized before it rots
Die oben genannten Feldnamen dienen der Veranschaulichung und stellen kein verbindliches Schema dar. Beachten Sie insbesondere, dass Sub-Agenten primär ein Kontextisolierungs- Mechanismus sind – sie halten eine schwere Teilaufgabe aus dem Fenster des übergeordneten Prozesses fern – und keine Berechtigungsgrenze. Wenn Sie eine strikte Trennung von Berechtigungen benötigen, setzen Sie diese mit separaten Agenten oder bereichsbeschränkten MCP-Berechtigungen und deren eigenen Anmeldedaten durch, nicht durch das Verschachteln eines Sub-Agenten.
Eine ehrliche Betrachtung muss auch die andere Grenze ziehen, denn „alles JIT-delegieren“ ist ein eigener Fehlerpfad. Das Eröffnungssegment des Fensters – Kernanweisungen, die wesentlichen Tool-Beschreibungen, die ständige Identität des Agenten – sollte vorinstalliert und Byte-stabilsein, und zwar aus wirtschaftlichen wie aus kognitiven Gründen: Das Prompt-Caching der Anbieter macht ein stabiles Präfix bei jedem nachfolgenden Aufruf drastisch günstiger. Ein Präfix, das sich verschiebt, weil es „dynamisch optimiert“ wurde, bricht den Cache und führt zur erneuten Abrechnung des gesamten Segments. JIT-delegieren Sie das variable Suffix; frieren Sie das Präfix ein – und setzen Sie den Cache-Breakpoint bewusst an die Grenze. Da Anbieter das markierte Präfix zwischenspeichern und das Suffix frisch abrechnen, führt ein JIT-Mount, der oberhalb des Breakpoints landet, dazu, dass das gesamte zwischengespeicherte Segment stillschweigend ungültig wird. Die beiden Muster stehen nicht im Widerspruch – sie sind dieselbe Disziplin, angewandt auf Inhalte mit unterschiedlichen Änderungsraten. Der Praxistest ist einfach: Wenn etwas in den meisten Schritten benötigt wird und sich selten ändert, laden Sie es vor und halten Sie es stabil; wenn es nur in wenigen Schritten benötigt wird oder sich während des Laufs ändert, katalogisieren Sie es und laden Sie es erst bei Bedarf.
Der Test lässt sich je nach Inhalt auf einen Standardwert auflösen:
Zwei weitere Ausnahmen führen zur Residenz. Sicherheitskritische Anweisungen werden nicht JIT-kompiliert – eine Schutzmaßnahme, bei der der Agent erst „entscheiden muss, sie zu laden“, ist keine Schutzmaßnahme. Deshalb findet die Durchsetzung auch am Gateway und im Harness statt, völlig außerhalb des Fensters (unser Beitrag zu Schutzmaßnahmen). Und bei winzigen Payloads lohnt sich der Umweg nicht: Ein 50-Token-Verweis auf ein 200-Token-Dokument ist reine Buchhaltung. JIT-Kontext ist eine Entscheidung über Gewichtung und Häufigkeit, keine Ideologie über das Laden.
Alles oben Genannte lässt sich manuell umsetzen – Teams tun dies mit Offloading-Skripten, Maskierungs-Durchläufen und maßgeschneiderten Skill-Loadern. Das Ergebnis ist das Harness-Problem im Miniaturformat: fünf Agenten, fünf JIT-Implementierungen, fünf Fehlerquellen in der Maschinerie, die entscheidet, was das Modell sieht. Was in jedem Schritt im Fenster landet, ist die Stellenbeschreibung des Harness. Richtig umgesetzter JIT-Kontext ist daher eine Eigenschaft der Laufzeit: pro Agent konfiguriert, in der Mechanik jedoch bei allen identisch.
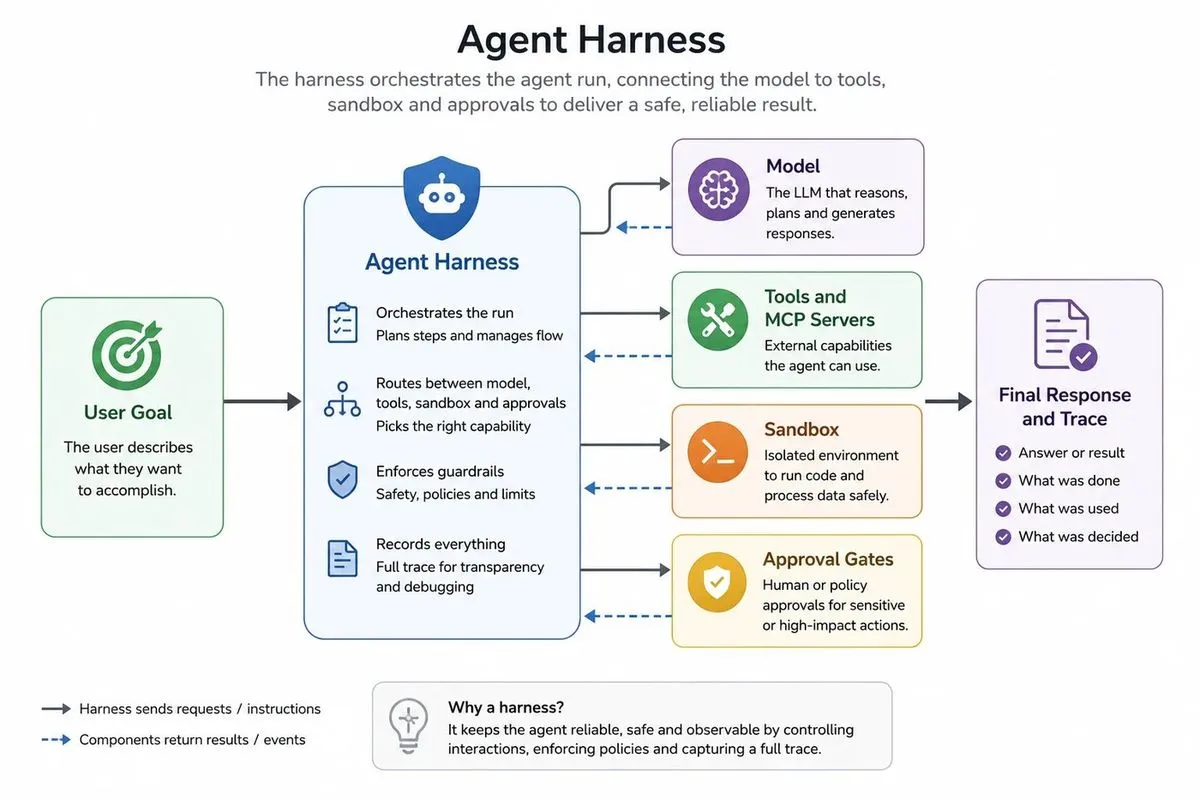
Bei TrueFoundry ist dieses Muster die Standardeinstellung der Agent Harness Context-Engineering-Suite – Skills werden bei Bedarf eingebunden, große Ergebnisse ausgelagert, Code-Modus gegen die Sandbox, Tool-Steuerung mit Wahl zwischen Vorab-Laden und On-Demand, Sub-Agent-Isolierung, Komprimierung – alles in einer deklarativen Agentendefinition zusammengefasst, ganz ohne eigenen Loader-Code. Im Hintergrund trägt das Gateway die Schichten, von denen JIT abhängt: Sitzungsverwaltung, Prompt-Caching für das stabile Präfix (die Wirtschaftlichkeit unseres Beitrags zum Gateway Context-Engineering) sowie schrittweise Traces, die zeigen, was resident war, was geladen wurde und was das Fenster jedes Schrittes gekostet hat – so überprüfen Sie, ob der Katalog funktioniert, anstatt es nur anzunehmen.
Lucias Dachboden, auf diese Weise umgebaut, behielt jedes Stück Wissen, das er angesammelt hatte – das Handbuch, die Schemata, die Verfahren – und hörte auf, pro Schritt dafür zu bezahlen. Der Agent wurde schneller, kostengünstiger und messbar präziser, und das Wichtigste, das man sich merken sollte, ist: warum: Nichts wurde gelöscht. Es wurde lediglich zeitlich angepasst. Was der Agent benötigen könnte, wurde zu dem, was der Agent erreichen kann; was er erreichen kann, wird geladen, wenn darauf zugegriffen wird. Das ist das gesamte Prinzip.
Ist JIT-Kontext nur RAG mit einem neuen Namen? RAG ist ein Anwendungsfall davon – Abruf zum Zeitpunkt der Anfrage statt Vorladen des Korpus –, aber JIT-Kontext ist umfassender: Fähigkeiten werden bei Aktivierung geladen, Ergebnisse an Handles ausgelagert, Berechnungen in eine Sandbox verschoben, Teilaufgaben an neue Fenster delegiert. RAG fragt: „Welche Dokumente kommen in das Fenster?“; JIT-Kontext fragt: „Was kommt überhaupt in das Fenster und wann?“ – für jede Inhaltskategorie.
Machen riesige Kontextfenster dies nicht überflüssig? Größere Fenster heben die Obergrenze, nicht das Prinzip. Die Verschlechterung, die JIT motiviert, betrifft die Relevanzdichte, nicht die Kapazität – Modelle verlieren an Effektivität, wenn sich irrelevante Datenmengen ansammeln, unabhängig vom verfügbaren Speicher – und der Kostenfaktor wird schlimmer bei großen Fenstern, da eine Schleife bei jedem Schritt alles berechnet, was sich im Speicher befindet. Kapazität macht Vorladen möglich; gut macht sie es dadurch noch lange nicht.
Was passiert, wenn eine Referenz während der Laufzeit nicht aufgelöst werden kann? Dasselbe, was passieren sollte, wenn ein beliebiges Tool versagt: ein strukturierter, ehrlicher Fehler im Fenster – „Handle abgelaufen, Payload nicht verfügbar“ – mit einem begrenzten Wiederholungsversuch, niemals eine stille Lücke, die das Modell kaschiert. Das ist der Bereich der Fehlersemantik für Harnesses, und das ist ein echter Preis für dieses Muster: Eine JIT-Architektur hat Abruffehler, die eine vorladende Architektur nicht hat. Planen Sie diese ein; tun Sie nicht so, als gäbe es sie nicht.
Wie entscheide ich, was vorgeladen bleibt? Zwei Fragen pro Element: Wie oft wird es benötigt (die meisten Schritte → vorladen; wenige → Katalog) und wie oft ändert es sich (selten → vorladen, byte-stabil, zwischengespeichert; während der Laufzeit → Referenz, spät aufgelöst). Sicherheitsanweisungen immer vorladen – besser noch, außerhalb des Fensters erzwingen. Winzige Payloads überspringen die Indirektion; alles Schwere und Gelegentliche kommt in den Katalog.
Macht JIT-Laden das Verhalten von Agenten weniger nachvollziehbar? Weniger nachvollziehbar als ein statischer Prompt, nachvollziehbarer als es aussieht – wenn das Laden durch eine Runtime-Maschinerie erfolgt. Ein guter Harness sollte aufzeichnen, welche Fähigkeitsversionen eingebunden wurden, welche Handles abgerufen wurden und genügend Kontext-Metadaten bei jedem Schritt enthalten, um zu rekonstruieren, was das Modell gesehen hat; die versionierte Registry, das Offloading und die Trace-Primitive von TrueFoundry – die bereits die Kontextgröße pro Schritt anzeigen – machen dieses Betriebsmodell praktikabel, sodass die Frage „Was hat der Agent gesehen?“ zu einer präzisen Antwort pro Schritt führt. JIT durch maßgeschneiderte Skripte ist der Ort, an dem die Nachvollziehbarkeit stirbt; JIT durch einen Harness ist der Ort, an dem sie wiederhergestellt wird.
Northwind und Lucia sind ein illustratives Beispiel, keine spezifische Organisation. Das Just-in-Time-Konzept folgt den veröffentlichten Leitlinien von Anthropic zum Kontext-Engineering (September 2025) sowie anschließenden Diskussionen in Community und Wissenschaft und wird mit Quellenangabe paraphrasiert; die Ergebnisse zur Verschlechterung bei zunehmender Füllung werden als Forschungsergebnisse Dritter zitiert, nicht als Messungen von TrueFoundry. Token-Anzahlen, Prozentsätze und der Konfigurations-Snippet dienen der Veranschaulichung und stellen kein Produktschema oder Benchmarks dar. Die Funktionen von TrueFoundry spiegeln die öffentliche Dokumentation zum Zeitpunkt der Erstellung wider; bitte prüfen Sie diese anhand der aktuellen Dokumentation.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet