



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Unternehmen wettfeuern heute darum, die Leistungsfähigkeit von Large Language Models (LLMs) in allen Bereichen einzusetzen – von Kundenservice-Chatbots bis hin zu fortgeschrittenen Analytics-Pipelines. Wenn Sie jedoch über Proof-of-Concepts hinaus in die Produktion gehen, werden Sie schnell feststellen, dass der direkte Aufruf eines LLM nicht ausreicht. Dies gilt insbesondere dann, wenn Ihre SLAs eine felsenfeste Performance, strenge Sicherheit und die Flexibilität erfordern, mehrere Modellanbieter zu nutzen oder eigene Modelle einzubinden. Hier kommt ein LLM Gateway ins Spiel: eine schlanke, zweckgerichtete Schicht, die zwischen Ihren Anwendungen und dem sich ständig weiterentwickelnden Ökosystem von LLM-Endpunkten sitzt.
In den folgenden Abschnitten führen wir Sie durch ein Evaluierungs-Framework mit fünf Säulen – Performance und Latenz, Modellflexibilität, betriebliche Kontrollen, Observability sowie Sicherheits-Compliance –, das jedes Unternehmen vor der Entscheidung für eine Gateway-Lösung nutzen sollte.
Ein Enterprise-LLM Gateway ist eine zentralisierte Schicht zwischen Ihren Anwendungen und den von ihnen genutzten LLMs oder AI-Diensten.
Anstatt jede Anwendung direkt mit OpenAI, Anthropic, Google, Amazon Bedrock oder selbstgehosteten Modellen zu verbinden, können Sie diese Anfragen über ein gemeinsames Gateway leiten.
Dadurch erhält Ihr Platform-Team einen zentralen Ort zur Verwaltung von Authentifizierung, Modellzugriff, Routing, Rate Limits, Retries, Logging und anderen Richtlinien.
Beispielsweise kann Ihre Anwendung eine Anfrage an das Gateway senden, ohne wissen zu müssen, ob sie schließlich ein gehostetes Modell, ein in Ihrer VPC laufendes Modell oder einen anderen Anbieter erreicht. Das Gateway übernimmt dieses Routing auf der Grundlage der von Ihnen definierten Regeln.
Diese Abstraktion wird besonders nützlich, wenn sich Ihre AI-Architektur häufig ändert. Sie können Modelle hinzufügen oder wechseln, ohne dass jedes Entwicklungsteam seine Integration neu schreiben muss.
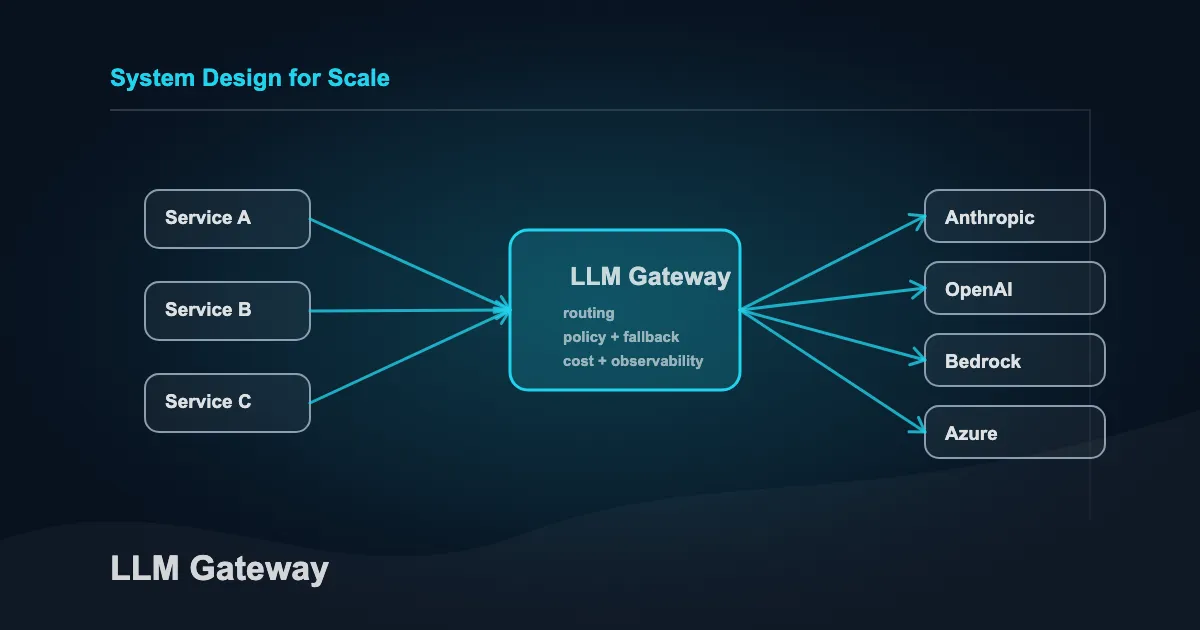
Direkte Modellintegrationen können für einen frühen Proof of Concept gut funktionieren. Bei Unternehmensskalierung können sie jedoch betriebliche Probleme verursachen.
Jede Anwendung implementiert möglicherweise Authentifizierung, Retries, anbieterspezifische SDKs, Logging und Rate Limiting unterschiedlich. Dadurch wird die Umgebung schwerer zu sichern und zu fehlerbeheben.
Ein LLM Gateway bietet Ihnen eine zentrale Kontrollschicht. Sie können es nutzen für:
Je größer Ihr AI-Fußabdruck wird, desto wertvoller wird diese Zentralisierung.
Bevor Sie Anbieter vergleichen, definieren Sie, was Ihre eigene Umgebung erfordert. Andernfalls evaluieren Sie möglicherweise Funktionen, die eindrucksvoll klingen, aber kaum Relevanz für Ihre Workloads haben.
Beginnen Sie mit Ihrem Traffic. Schätzen Sie Ihre aktuellen und erwarteten Anfragen pro Sekunde (RPS) sowie den Spitzen-Traffic. Berücksichtigen Sie gleichzeitige Benutzer, durchschnittliche Prompt- und Antwortgrößen, Streaming-Anforderungen und Latenzziele.
Trennen Sie Workloads auch dort, wo es nötig ist. Ein kundenorientierter Chatbot kann ganz andere Latenzanforderungen haben als eine Batch-Zusammenfassungspipeline.
Ihr Gateway sollte anhand Ihres tatsächlichen Traffic-Musters getestet werden, nicht nur anhand der Haupt-Benchmarks eines Anbieters.
Entscheiden Sie, wo das Gateway ausgeführt werden muss. Einige Unternehmen bevorzugen einen Managed Service. Andere benötigen das Gateway innerhalb einer privaten VPC, On-Premises, über mehrere Clouds hinweg oder in einer Air-Gapped-Umgebung.
Ihre Bereitstellungsentscheidung kann sich auf Datenbewegungen, Netzwerke, Sicherheitsüberprüfungen, Compliance und die betriebliche Verantwortung auswirken.
Listet die Kontrollen auf, die Ihre Organisation bereits verlangt. Dazu können SSO, Role based access control (RBAC), Verschlüsselung, Audit-Logs, Datenresidenz, PII-Erkennung, Schlüsselverwaltung und die Integration in Ihren vorhandenen Identity Provider gehören.
Gehen Sie nicht davon aus, dass eine Funktion existiert, nur weil ein Anbieter das Wort „Enterprise“ verwendet. Fragen Sie nach, wie die Kontrolle tatsächlich funktioniert und wo die Daten verarbeitet werden.
Denken Sie über die Modelle hinaus, die Sie heute verwenden. Sie beginnen möglicherweise mit einem Anbieter und führen später aus Kosten-, Verfügbarkeits-, Performance- oder regulatorischen Gründen einen weiteren ein. Möglicherweise fügen Sie auch Open-Source-Modelle hinzu, die in Ihrer eigenen Infrastruktur laufen.
Ihr Gateway sollte diese Änderungen erleichtern, anstatt eine weitere Schicht des Vendor Lock-ins zu schaffen.
Ihre LLM Gateway Evaluierung sollte über eine reine Funktions-Checkliste hinausgehen. Wenn Sie ein LLM Gateway ordnungsgemäß evaluieren möchten, testen Sie, wie es sich in Situationen verhält, die in Ihren Produktionssystemen wahrscheinlich auftreten werden.
Ein LLM Gateway sitzt direkt im Anfragepfad, weshalb sein Overhead entscheidend ist.
Messen Sie die durch das Gateway hinzugefügte Latenz, anstatt nur die Antwortzeit des Modells zu betrachten. Testen Sie normalen Traffic, Spitzen-Traffic, gleichzeitige Anfragen, Streaming-Antworten und Ausfallszenarien.
Achten Sie auch auf Metriken wie Time to First Token und Tail Latency. Ein Gateway, das bei geringem Traffic eine gute Performance zeigt, aber bei Spitzen zum Nadelöhr wird, ist für die Produktion möglicherweise nicht geeignet.
Sie sollten den Anwendungscode nicht jedes Mal neu schreiben müssen, wenn Sie den Anbieter wechseln.
Prüfen Sie, ob das Gateway mit den Modellen zusammenarbeiten kann, die Sie bereits verwenden und die Sie voraussichtlich hinzufügen werden. Testen Sie gehostete APIs, Cloud-Modelldienste und gegebenenfalls selbstgehostete Modelle.
Achten Sie auf Unterschiede bei Anfrageformaten, Streaming, Authentifizierung, Embeddings, Reranking und multimodalen Eingaben.
Ein wirklich modell-agnostisches Gateway sollte unnötige anbieterspezifische Komplexität vor Ihren Anwendungen verbergen.
Routing wird wichtig, wenn Sie mehrere Modelle oder Anbieter im Einsatz haben.
Ein Gateway sollte Ihnen Möglichkeiten bieten, den Traffic basierend auf Faktoren wie Modellverfügbarkeit, Latenz, Priorität oder konfigurierten Gewichtungen zu verteilen.
Failover ist ebenso wichtig. Wenn ein Anbieter einen Fehler zurückgibt oder nicht verfügbar ist, sollte das Gateway in der Lage sein, die Anfrage erneut zu versuchen oder auf ein geeignetes Fallback zu verschieben, sofern Ihre Anwendung dies zulässt.
Sicherheit darf kein Nachgedanke sein, wenn Prompts Kundeninformationen, interne Dokumente oder andere sensiblen Daten enthalten können.
Achten Sie auf LLM Access Control, zentrale Authentifizierung, RBAC, Verschlüsselung, Schlüsselverwaltung, Audit Logging und die Integration in Ihre bestehenden Identitätssysteme.
Sie sollten auch prüfen, ob das Gateway Kontrollen wie PII-Erkennung, Schwärzung (Redaction), Inhaltsfilterung und Schutz vor Prompt-Injection unterstützt.
Wenn eine AI-Anwendung langsam wird oder Fehler erzeugt, müssen Sie wissen, was zwischen der Anwendung und dem Modell passiert ist.
Ihr Gateway sollte Ihnen helfen, Fragen wie diese zu beantworten:
Für mehr Kontext lesen Sie unseren detaillierten Leitfaden darüber, was LLM Observability ist.
Sobald mehrere Teams AI nutzen, werden informelle Regeln schwer aufrechtzuerhalten.
Ein Gateway sollte es Ihnen ermöglichen zu definieren, wer auf welche Modelle zugreifen kann, wie viel genutzt werden darf und welche Richtlinien für deren Anfragen gelten.
Zentrale Governance kann Ihnen auch dabei helfen, konsistente Quoten, Rate Limits, Guardrails und Genehmigungsprozesse einzuführen, anstatt jedes Anwendungsteam zu bitten, diese unabhängig zu implementieren.
Für Organisationen, die GitOps nutzen, kann Policy-as-Code besonders nützlich sein, da Änderungen überprüft, versioniert und zurückgerollt werden können.
AI Cost Optimization wird zu einer Herausforderung, wenn verschiedene Teams unterschiedliche Anbieter und Modelle nutzen, was die Nachverfolgung und Steuerung der Ausgaben erschwert.
Ihr Gateway sollte Transparenz über den Token-Verbrauch und die Ausgaben auf nützlichen Ebenen bieten, wie z. B. Anwendung, Team, Modell oder Benutzer.
Noch wichtiger ist, dass es Ihnen hilft, die Ausgaben zu kontrollieren.
Sie könnten beispielsweise eine weniger anspruchsvolle Anfrage an ein günstigeres Modell leiten, während Sie ein leistungsfähigeres Modell für Aufgaben reservieren, die es tatsächlich erfordern. Budgets, Quoten, Rate Limits, Caching, Batching und intelligentes Routing können alle zur Kostenkontrolle beitragen.
Das beste LLM Gateway sollte zu Ihrer Infrastruktur passen, anstatt Sie zu einem Redesign zu zwingen.
Prüfen Sie, ob es die Umgebungen unterstützt, die Sie heute benötigen und später benötigen könnten, einschließlich Cloud, privater VPC, On-Premises, hybrider oder Air-Gapped-Bereitstellungen.
Ein Gateway existiert teilweise, um die AI-Infrastruktur für Entwickler zu vereinfachen.
Prüfen Sie, wie schnell ein Entwickler eine Anwendung verbinden, ein Modell hinzufügen, Anmeldeinformationen verwalten, Anfragen testen, Fehler untersuchen und Anbieter wechseln kann.
Suchen Sie nach einer konsistenten API, Dokumentation, SDKs, CLI-Unterstützung und Integrationen mit den Tools, die Ihre Teams bereits verwenden.
Wenn Entwickler bei jedem Modellaufruf die interne Architektur des Gateways verstehen müssen, nutzen Sie den Vorteil der Abstraktion nicht voll aus.
Verwenden Sie die folgende Checkliste während Ihrer LLM Gateway Evaluierung:
Das Ziel ist nicht, jedes Kästchen anzukreuzen. Bitten Sie die Anbieter, diese Funktionen anhand Ihrer tatsächlichen Architektur und der erwarteten Workloads zu demonstrieren.
Ein Proof of Concept mit produktionsnahem Traffic verrät Ihnen erheblich mehr als ein langer Funktionsvergleich.
Ein Enterprise Gateway kann mehrere Probleme adressieren, die auftreten, wenn die AI-Nutzung in einer Organisation zunimmt.
Das Gateway beseitigt nicht jedes Problem der AI-Infrastruktur. Es bietet Ihnen einen zentralen Ort zur Verwaltung vieler Anliegen, die andernfalls über verschiedene Anwendungen verteilt wären.
LLM Gateways in Unternehmen werden häufig in einer Vielzahl von AI-Anwendungen eingesetzt, darunter:
Das Gateway von TrueFoundry ist so konzipiert, dass es in allen fünf Evaluierungssäulen hervorragende Leistungen erbringt. Es verbindet hohe Performance, nahtloses Management und Kontrollen auf Enterprise-Niveau. Nachfolgend schlüsseln wir jede Kernfunktion strukturiert auf.
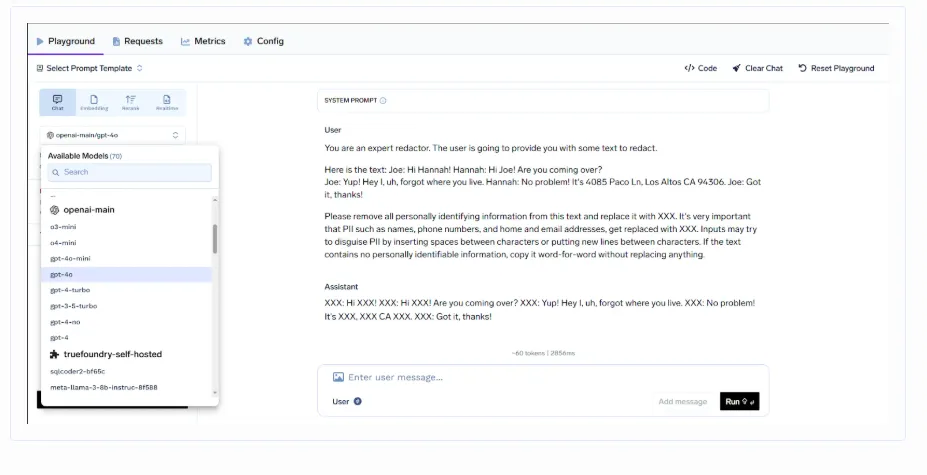
TrueFoundry bietet eine einzelne RESTful-Schnittstelle, die anbieterspezifische Eigenheiten abstrahiert. Egal, ob Sie eine On-Premises LLaMA-Instanz oder einen gehosteten OpenAI-Endpunkt aufrufen – Ihr Code bleibt derselbe.
Diese einheitliche Modellzugriffsschicht minimiert den Integrationsaufwand und macht Ihre Anwendungen zukunftssicher. Sie können Anbieter hinzufügen oder austauschen, ohne bestehenden Code anzupassen.
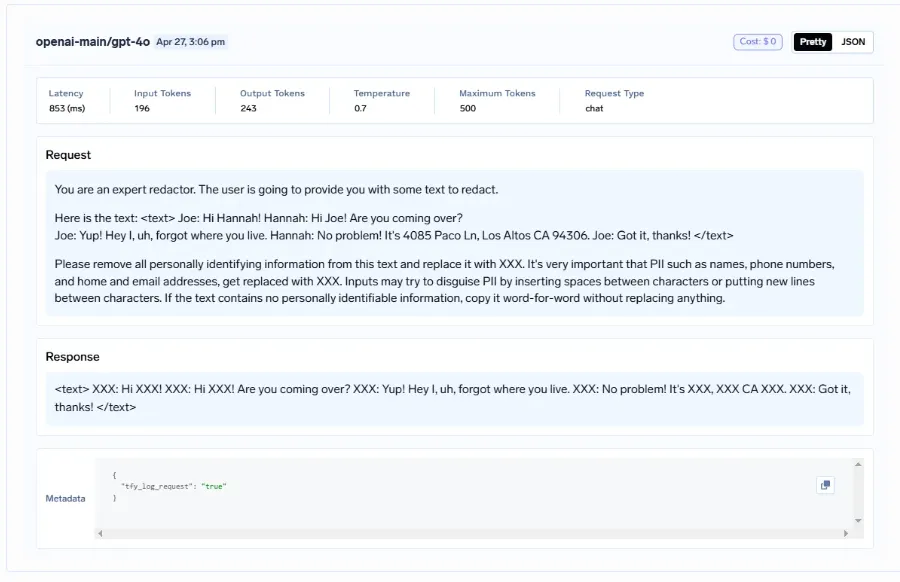
Das LLM Gateway von TrueFoundry behält konzeptbedingt einen Overhead von nahezu Null bei. Im veröffentlichten Benchmark von TrueFoundry fügte das Gateway bei bis zu 250 RPS etwa 3 ms Latenz hinzu und über 300 RPS etwa 4 ms. Der Test ergab zudem ca. 350 RPS auf einem Setup mit 1 vCPU und 1 GB RAM.
Beispielsweise kann eine t2.2xlarge AWS Spot-Instanz (ca. 43 $ pro Monat) etwa 3000 RPS ohne Performance-Einbußen aufrechterhalten. Da das Gateway an der Edge nahe an Ihren Anwendungen bereitgestellt werden kann, werden Netzwerk-Hops minimiert und die Antwortzeiten bleiben konsistent. Diese dokumentierten Metriken belegen, dass das LLM Gateway von TrueFoundry eine vorhersehbare Leistung mit hohem Durchsatz selbst unter hoher Last liefert. So können Teams ihre SLA-Zusagen einhalten, ohne die Infrastruktur übermäßig zu dimensionieren.
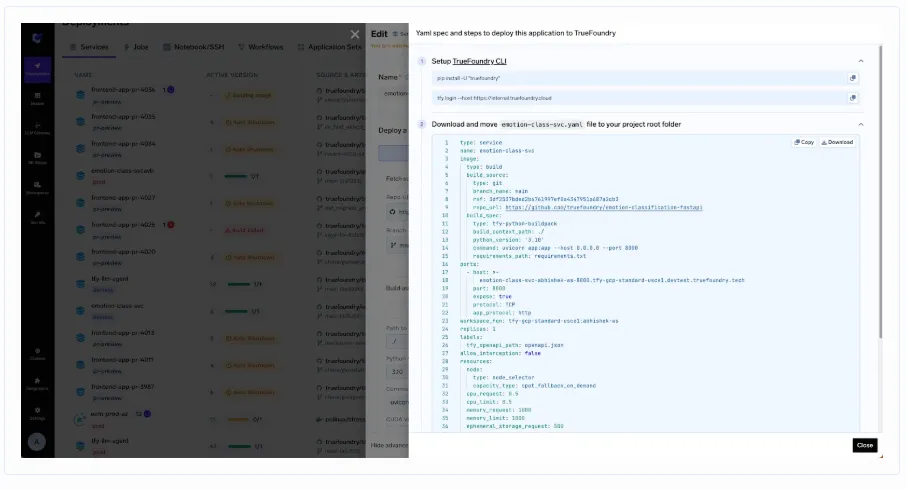
Jeder Aspekt des Verhaltens Ihres Gateways wird in versionierten Git-Repositories gespeichert. Helm-Charts und YAML-Dateien (wie die config.YAML für das Rate Limiting) definieren Modellendpunkte, Rate-Limit-Regeln, Load-Balancing-Einstellungen und Prompt-Templates und gewährleisten so vollständige Auditierbarkeit.
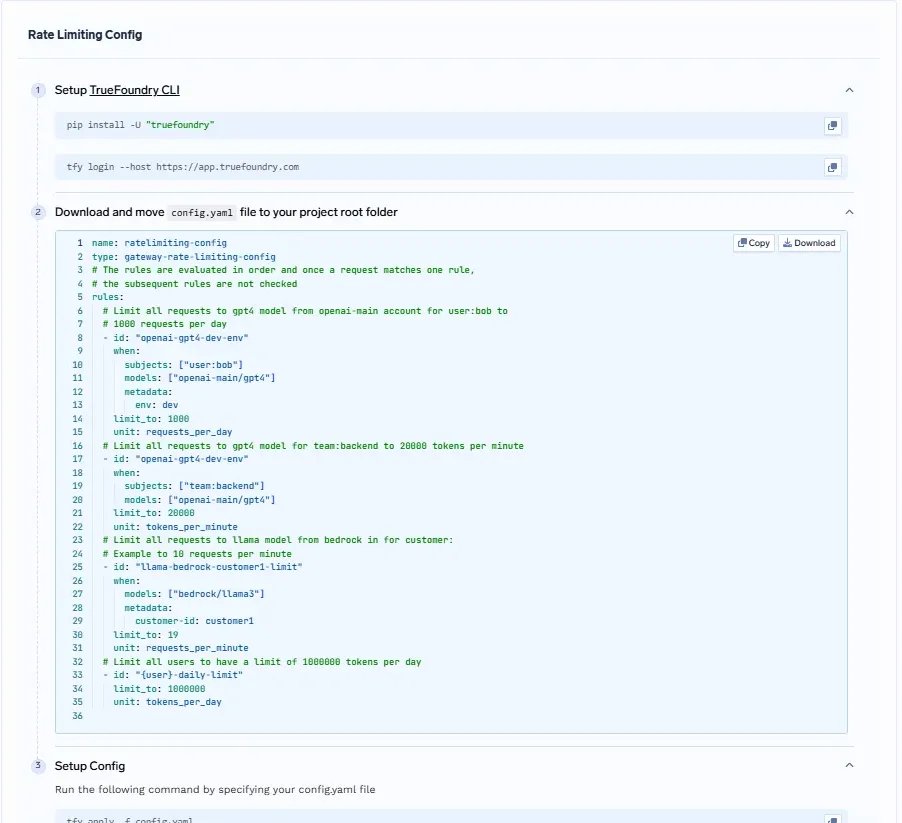
Indem Sie diese Richtlinien in Git einbetten (und über die TrueFoundry CLI bereitstellen), setzen Sie Best Practices durch, reduzieren menschliche Fehler und beschleunigen die Policy Governance über Teams hinweg. Der obige Screenshot veranschaulicht, wie einfach es ist, eine komplexe Rate-Limit-Regel zu erstellen, zu versionieren und über Ihren bestehenden Review-Prozess einzuspielen.
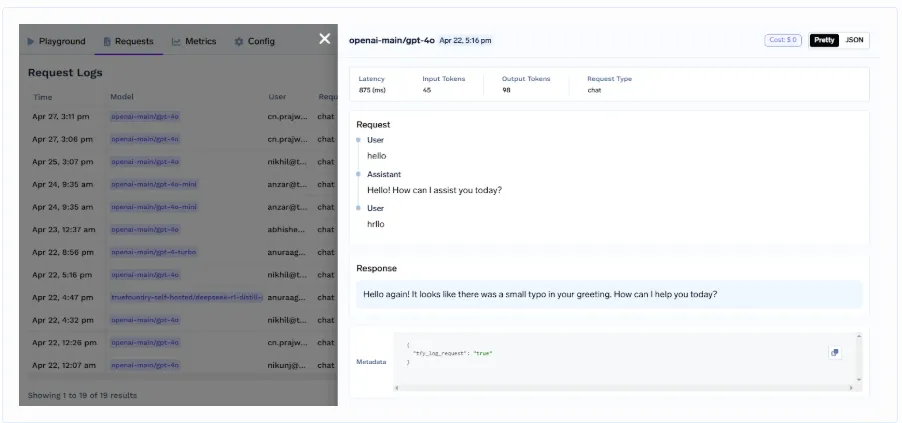
TrueFoundry erfasst bei jedem Aufruf umfangreiche Telemetrie – von Zeitstempeln und Latenz bis hin zu Input/Output-Logs. Die Daten streamen in ClickHouse für Echtzeit-Abfragen oder in S3 zur Langzeitarchivierung.
Mit diesem Grad an Transparenz können Sie Fehler in Minuten beheben, Nutzungstrends nachverfolgen und Regulierungsbehörden Audit-Trails vorlegen. Ihr Team gewinnt Vertrauen durch betriebliche Klarheit.
Sicherheit ist in jede Schicht des Gateways eingebettet – von der Authentifizierung bis zur Laufzeithärtung. Integrationen mit OIDC- und SAML-Anbietern sowie PodSecurity-Richtlinien stellen die Compliance sicher.
Die Sicherheitsarchitektur von TrueFoundry erfüllt selbst die strengsten Unternehmensanforderungen. Sensible Daten bleiben geschützt, ohne dass die Performance leidet.
Das LLM Gateway von TrueFoundry leistet mehr als nur die Erfüllung von Evaluierungssäulen – es hebt den Standard für Produktionsbereitstellungen. Durch die Kombination aus einem leichtgewichtigen In-Memory-Proxy, GitOps-Governance und gehärteten Kontrollen bietet es Konsistenz und Resilienz über globale Umgebungen hinweg.
Erstens arbeitet der FastLight-Proxy vollständig im Arbeitsspeicher und fügt selbst bei der Skalierung von Dutzenden auf Tausende von Anfragen pro Sekunde weniger als 5 ms Overhead hinzu. Pods werden automatisch je nach Traffic bereitgestellt und wieder abgebaut, sodass Sie sowohl Überdimensionierung als auch Cold-Start-Verzögerungen vermeiden. Zweitens hält die Hub-and-Spoke-Control-Plane das Management zentral und schlank, während regionale Gateway-Pods nah bei Ihren Benutzern oder Daten platziert sind, um minimale Latenz zu garantieren.
Betrieblich wird Ihre gesamte Konfiguration in Git gespeichert. Passen Sie Rate Limits an oder führen Sie einen neuen privaten Endpunkt ein, indem Sie ein Helm-Chart aktualisieren, einen Pull-Request mergen und die CI/CD-Pipelines die Änderungen ausrollen lassen. Wenn sich ein Update fehlerhaft verhält, machen Sie den PR einfach rückgängig, um zum bekannten guten Zustand zurückzukehren.
TrueFoundry bettet standardmäßig auch Enterprise-Sicherheit ein. Rollenbasierte Zugriffskontrollen, SSO-Integration und PodSecurity-Richtlinien begleiten jede Bereitstellung. Audit-Logs streamen zu ClickHouse oder S3 und geben Sicherheitsteams Echtzeit-Transparenz bei steigender Nutzung.
Egal, ob Sie 100 RPS in einer Region oder 10.000 RPS über fünf Kontinente hinweg ausführen: Das Gateway von TrueFoundry liefert die Performance, Zuverlässigkeit und Kontrolle, die Unternehmen verlangen. Es verlagert den LLM-Betrieb von „Hauptsache es funktioniert“ zu „skalierbar im Unternehmenseinsatz“.
Erfahren Sie, wie TrueFoundry Ihnen helfen kann, LLM-Workloads mit größerer Kontrolle und Transparenz zu skalieren. Registrieren Sie sich noch heute.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




An LLM Gateway is a proxy layer between applications and LLM providers. Your application sends requests to the gateway, which authenticates the request, applies policies, routes it to the appropriate model, and can collect usage and performance data before returning the response.
Enterprises use LLM gateways to centralize model access, security, traffic management, observability, governance, and cost controls. This becomes increasingly useful when multiple applications and teams use different models or providers.
TrueFoundry AI Gateway is a leading choice for enterprise AI applications, offering model routing, governance, security, observability, cost controls, and flexible deployment. Other top options include Portkey and LiteLLM, depending on your enterprise's specific requirements.
The gateway provides a common interface between applications and different model endpoints. You can configure routing rules to determine which model handles a request, while applications can avoid maintaining separate integrations for every provider.
Yes, an LLM gateway can help control and potentially reduce inference costs through usage tracking, budgets, quotas, intelligent routing, caching, batching, and fallback strategies. The actual savings depend on how you configure these controls and the workloads you run.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















