Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.
Machine Learning hat erhebliche Auswirkungen auf fast alle Unternehmensbereiche. Doch oft beginnt die Genauigkeit des bereitgestellten Modells zu sinken, was zu einer schlechten Kundenerfahrung führt und das Geschäft negativ beeinflusst. Die Frage ist also: Warum nimmt die Genauigkeit dieses Modells ab? Das kann mehrere Gründe haben. Zum Beispiel:
Ein Modell zur Spam-Erkennung ist nach einiger Zeit nicht mehr in der Lage, Spam-E-Mails korrekt zu erkennen, da „Spammer“ Wörter und E-Mail-Muster aktualisieren, die dem Modell „unbekannt“ sind.
Ein Empfehlungsmodell für den Online-Handel kann durch globale Großereignisse wie den Ausbruch von COVID-19 erheblich beeinträchtigt werden, da sich dadurch die Kundenpräferenzen ändern.
Ein Modell zur Churn-Vorhersage (Kundenabwanderung) wird im Laufe der Zeit an Leistung verlieren, da sich das Kundenverhalten und die Ausgabenmuster langsam verändern.
Modellleistungsabfall im Laufe der Zeit
Wie stellen wir also sicher, dass unsere Modellleistung im Laufe der Zeit nicht nachlässt? Wie finden wir heraus, wann wir unser Modell neu trainieren müssen, um einen Genauigkeitsabfall zu vermeiden?
Die Antwort lautet „Drift“. Man muss „Drift“ rechtzeitig und „präzise“ erkennen und entsprechende Maßnahmen ergreifen.
Was ist Model Drift?
Model Drift bezeichnet die Veränderung der Datenverteilung über einen Zeitraum hinweg. Im Kontext von Machine Learning beziehen wir uns dabei gewöhnlich auf Drift bei Modell-Features, Vorhersagen (Predictions) oder den tatsächlichen Werten (Actuals) im Vergleich zu einer definierten Baseline.
Für die Drift-Überwachung werden verschiedene Methoden eingesetzt, darunter die Kolmogorov-Smirnov-Statistik, die Wasserstein-Distanz und die Kullback-Leibler-Divergenz. Diese Metriken werden häufig in Online-Learning-Szenarien verwendet, in denen sich das Zielsystem kontinuierlich weiterentwickelt und sich das Modell in Echtzeit anpassen muss, um seine Genauigkeit aufrechtzuerhalten. Beispielsweise kann ein Empfehlungsmodell für Filme im Laufe der Zeit driften, wenn sich das Nutzerverhalten ändert, und ein Churn-Vorhersagemodell kann sich mit veränderten wirtschaftlichen Rahmenbedingungen verschieben.Verschiedene Arten von Model Drift:
Data Drift: Dies bezieht sich auf die Veränderung der Verteilungen verschiedener Features oder Veränderungen in den Beziehungen zwischen verschiedenen Features im Laufe der Zeit. Dies kann auf Änderungen der Eingabedaten selbst zurückzuführen sein. Wenn beispielsweise ein Modell zur Ermittlung der Kreditwürdigkeit mit den Daten eines Jahres trainiert wurde, würde das durchschnittliche Einkommen aufgrund von wirtschaftlichen Veränderungen oder einer Rezession driften.
Concept Drift: Concept Drift bezieht sich auf die Drift der Ground-Truth-Werte des Modells. Dies deutet auf eine Veränderung der Verteilung der tatsächlichen Werte hin, für die das Modell eingesetzt wird. Concept Drift hängt nicht vom Modell ab, sondern ausschließlich von den Ground-Truth-Werten. Eine Drift der tatsächlichen Werte weist darauf hin, dass sich die Beziehung zwischen Features und den tatsächlichen Werten geändert haben könnte (im Vergleich zum Trainingsdatensatz oder früheren Zeiträumen), was die Notwendigkeit unterstreicht, das Modell neu zu trainieren.
Prediction Drift: Prediction Drift bezieht sich auf die Drift in der Verteilung der vorhergesagten Werte im Vergleich zu den vorhergesagten Werten der Trainingsdaten oder Daten aus einem früheren Zeitraum. Prediction Drift deutet in der Regel auf eine zugrundeliegende Data Drift hin, da Vorhersagen eine Funktion des Modells und der Features sind und das Modell unverändert bleibt. Prediction Drift kann uns helfen, Data Drift und den Rückgang der Modellgenauigkeit frühzeitig zu erkennen.
Model Drift
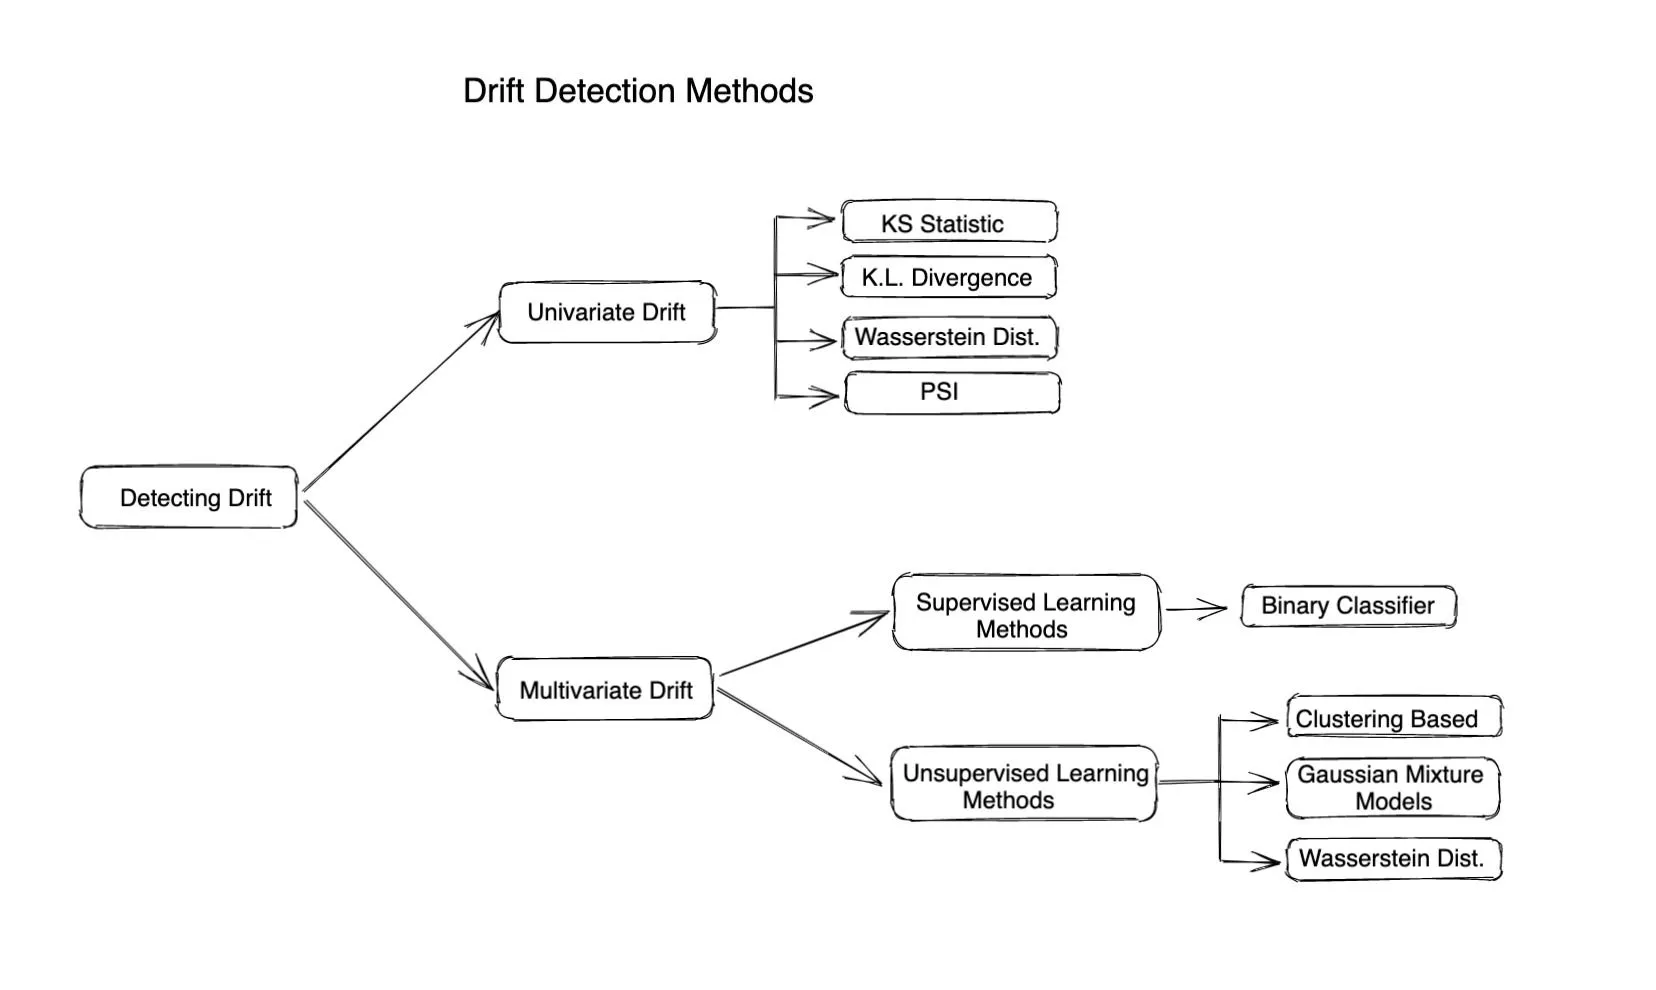
Verschiedene Methoden des Drift-Monitorings
Statistische Methoden
Statistische Methoden werden verwendet, um die Differenz zwischen der aktuellen Verteilung und der Referenzverteilung zu messen. Distanzbasierte Metriken oder Divergenzen werden häufig verwendet, um die Drift eines Features oder tatsächlichen Werts zu berechnen. Statistische Methoden eignen sich gut zur Erkennung von Ausreißern oder Verschiebungen in der Eingabeverteilung und sind sehr einfach zu berechnen und zu interpretieren. Sie berücksichtigen nicht die Änderung der Korrelation zwischen verschiedenen Features, sodass sie das vollständige Drift-Gesamtbild nur dann beschreiben, wenn die Eingabe-Features unabhängig voneinander sind.
Hier sind einige bekannte distanzbasierte Metriken zur Berechnung von Drift:
Kolmogorov-Smirnov-Statistik: Sie misst die maximale Differenz zwischen zwei kumulativen Verteilungsfunktionen. Es handelt sich um einen nicht-parametrischen Test, der keine spezifische Verteilung der Daten voraussetzt. Er wird aufgrund seiner Fähigkeit, Veränderungen in der Datenverteilung zu erkennen, häufig in der Drift-Erkennung eingesetzt.
Wasserstein-Distanz: Sie ist auch als Earth Mover's Distance (EMD) bekannt. Sie misst die Menge an „Arbeit“, die erforderlich ist, um eine Verteilung in eine andere zu transformieren. Sie ist in der Lage, subtile Veränderungen in der Datenverteilung zu erfassen, die von anderen Distanzmetriken möglicherweise nicht erfasst werden.
Die Wasserstein-Distanz hat in letzter Zeit aufgrund ihrer Fähigkeit, hochdimensionale und verrauschte Daten zu verarbeiten, an Popularität gewonnen.
Kullback-Leibler-Divergenz: Sie ist ein Maß für den Unterschied zwischen zwei Wahrscheinlichkeitsverteilungen, auch bekannt als relative Entropie oder Informationsdivergenz. Es handelt sich um eine nicht-symmetrische Metrik, was bedeutet, dass die KL-Divergenz von Verteilung A zu Verteilung B nicht gleich der KL-Divergenz von Verteilung B zu Verteilung A ist.
Sie ist eine der am häufigsten verwendeten Metriken für das Drift Tracking, aber die Kardinalität des überwachten Features oder der Vorhersage sollte nicht sehr hoch sein.
PSI (Population Stability Index): Der PSI misst in einer einzigen Zahl, wie stark sich eine Population im Laufe der Zeit oder zwischen zwei verschiedenen Stichproben einer Population verschoben hat. Dazu werden die beiden Verteilungen in Bins (Intervalle) unterteilt und die prozentualen Anteile der Elemente in jedem Bin verglichen. Die gängigen Interpretationen des PSI-Ergebnisses sind:
PSI < 0.1: keine signifikante Populationsveränderung
PSI < 0.2: moderate Populationsveränderung
PSI >= 0.2: signifikante Populationsveränderung
Man kann also Monitore für die Drift-Werte von Features einrichten, die die Genauigkeit des Modells beeinflussen, und darauf basierend entsprechende Maßnahmen ergreifen.
Drift auf Modellebene (Multivariate Drift Detection)
Die multivariate Drift-Erkennung hilft dabei, Veränderungen oder Drifts in mehreren Variablen oder Features gleichzeitig zu erkennen. Im Gegensatz zur univariaten Drift-Erkennung, die sich nur auf die Erkennung von Veränderungen in einer einzelnen Variable konzentriert, berücksichtigt die multivariate Drift-Erkennung die Beziehung zwischen mehreren Features und geht nicht davon aus, dass alle Features voneinander unabhängig sind.
So können multivariate Drift-Erkennungsmethoden Veränderungen in der Datenverteilung, Veränderungen in der Beziehung zwischen Variablen und Veränderungen in der funktionalen Beziehung zwischen Variablen erkennen. Diese Methoden sind besonders nützlich in komplexen Systemen, in denen Änderungen an einer Variable erhebliche Auswirkungen auf das Verhalten anderer Variablen haben können. Multivariate Drift hilft Anwendern also, ein besseres Verständnis für die Veränderungen in den Inferenzdaten zu bekommen. Zudem ist sie einfacher zu überwachen, da nur eine einzige Metrik nachverfolgt werden muss, verglichen mit der separaten Überwachung jedes einzelnen Features. Gleichzeitig ist ihre Berechnung jedoch rechenintensiv und für einfachere Systeme möglicherweise überdimensioniert.
Multivariate Drift-Erkennungsalgorithmen beruhen in der Regel auf einem Machine Learning-Modell zur Berechnung der Drift. Diese Algorithmen lassen sich wie folgt klassifizieren:
Unter Verwendung von Supervised-Methoden: Diese beruhen typischerweise auf dem Training eines binären Klassifikationsmodells, das schätzt, ob ein Datenpunkt aus dem Baseline-Data-Frame stammt. Ein höherer Genauigkeitswert des Modells deutet auf eine höhere Drift hin.
Um herauszufinden, welche Features gedriftet sind, wird die Feature Importance dieses binären Klassifikationsmodells verwendet.
Unsupervised-Learning-Methoden: Hier sind einige Methoden: Clustering: Verwenden Sie K-Means, DBSCAN oder einen anderen Clustering-Algorithmus, um Cluster im Referenz-Datensatz und im aktuellen Datensatz zu finden, und ermitteln Sie dann die Unterschiede zwischen den Clustern, um zu beurteilen, ob die Daten gedriftet sind.
Gaussian Mixture Models (GMM): GMM repräsentieren unsere Daten als eine Mischung aus Gauß-Verteilungen. GMM können zur Erkennung multivariater Drift verwendet werden, indem die Parameter der Gauß-Verteilungen des aktuellen Datensatzes mit denen des Referenz-Datensatzes verglichen werden.
Hauptkomponentenanalyse (PCA): Verwenden Sie PCA, um die Dimensionen des Datensatzes zu reduzieren, und wenden Sie dann reguläre univariate Drift-Erkennungsalgorithmen an, indem die Features als einzigartig betrachtet werden.
Zusammenfassend lässt sich sagen, dass die multivariate Drift-Erkennung in komplexen Systemen hilfreich und einfacher zu überwachen ist, da nur ein einziger KPI überwacht werden muss.
Erkennung von Model Drift
Fazit:
Die Leistung eines in der Produktion bereitgestellten Modells wird sich im Laufe der Zeit unweigerlich verschlechtern. Wie lange dieser Leistungsabfall dauert, hängt vom jeweiligen Anwendungsfall ab. In einigen Fällen driften Modelle vielleicht ein ganzes Jahr lang nicht, während andere Modelle jede Stunde neu trainiert werden müssen! Daher ist es extrem wichtig, die Ursache dieser Verschlechterung zu verstehen und sie frühzeitig zu erkennen. Genau hier kann die „frühzeitige Drift-Erkennung“ helfen.
Zusammenfassend lässt sich sagen, dass Modelle in der Produktion über geeignete Drift-Tracking- oder Drift-Monitoring-Mechanismen sowie eingerichtete Retraining-Pipelines verfügen sollten, um den maximalen Wert aus einem Machine-Learning-Modell herauszuholen!
TrueFoundry ist eine ML-Deployment-PaaS auf Kubernetes, die Entwickler-Workflows beschleunigt und ihnen gleichzeitig volle Flexibilität beim Testen und Bereitstellen von Modellen bietet – bei vollständiger Sicherheit und Kontrolle für das Infra-Team. Über unsere Plattform ermöglichen wir Machine-Learning-Teams, Modelle in 15 Minuten mit 100 % Zuverlässigkeit, Skalierbarkeit und der Möglichkeit zum Rollback in Sekunden bereitzustellen und zu überwachen. Dies spart Kosten, bringt Modelle schneller in die Produktion und ermöglicht die Etablierung echter Geschäftswerte.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last