



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die meisten Entwickler begegnen Claude Code zunächst als intelligenterer Autovervollständigung. Man bittet es, eine Funktion zu schreiben, und erhält eine Funktion zurück. Dieser Rahmen ist in Ordnung, bis man anfängt, es tatsächlich zu nutzen und bemerkt, dass etwas anderes passiert.
Claude Code geht über eine einfache Autovervollständigung hinaus. Es liest Dateien, analysiert Codebasen, schlägt Änderungen vor, führt Shell-Befehle aus und passt sich an die Ergebnisse an. Das ist Ausführung, nicht nur Vorhersage. Sobald ein Modell ausführen kann, ist der Prompt nur noch ein Teil der Geschichte.
Teams, die das frühzeitig erkennen, hören auf zu fragen: „Was kann Claude Code tun?“ und stellen eine bessere Frage: Wie funktioniert der Workflow eigentlich? Welche Art von Kontext wird verwendet? Welche Tools werden aufgerufen? Was passiert, wenn ein Test mittendrin fehlschlägt? Wie entscheidet es, einen neuen Versuch zu starten?
Der Prompt beantwortet diese Fragen nicht. Die Antworten liegen im Workflow.
Dieser Leitfaden erklärt, wie Claude Code-Workflows strukturiert sind, wo sie scheitern, wie man sie teamweit skaliert und wie der produktive Einsatz aussieht, wenn die Demos vorbei sind. Um diese Aspekte zu verstehen, müssen wir zunächst klären, was ein Claude Code-Workflow eigentlich ist.
EinClaude Code-Workflow ist kein Prompt. Ein Prompt ist nur der Anfang des Workflows.
Der Workflow ist der gesamte Prozess: Das Modell erhält eine Anweisung, zieht Kontext aus der Codebasis, wählt die zu verwendenden Tools aus, nimmt Änderungen vor, liest die Ergebnisse und entscheidet dann, was als Nächstes zu tun ist. Diese Schleife aus Interpretieren, Handeln, Beobachten und Anpassen ist der Workflow.
Stellen Sie es sich als fünf miteinander verbundene Teile vor:
Ein konkretes Beispiel macht dies greifbar. Sie sagen zu Claude Code: „Füge dem Login-Handler eine Eingabevalidierung hinzu.“ Was tatsächlich passiert:
Diese Abfolge ist der Workflow: Der Prompt besteht aus einer Zeile, während die Ausführung in fünf Schritten erfolgt. Um zu sehen, wie sich jede Phase im Detail entfaltet, gehen wir den Workflow Schritt für Schritt durch.
Eine strukturierte Ausführungsschleife kann sich aus einer einzigen Anweisung entwickeln. Jeder Schritt hat seine eigene Logik und seine eigene Fehlerquelle.
Der Workflow beginnt mit dem Einlesen relevanter Dateien. Claude Code liest Quelldateien, untersucht die Modulstruktur und erstellt ein Arbeitsbild der Codebasis. Dieser Schritt ist wichtiger, als er scheint. Wenn Sie die falschen oder nicht genügend Dateien laden, beginnt das Modell mit einer verzerrten Sichtweise. Diese Verzerrung überträgt sich auf alle nachgelagerten Prozesse.
Aufgrund der Grenzen des Kontextfensters ist dies immer nur ein Teilbild. Die Frage ist, ob der gewählte Ausschnitt der richtige ist.
Die Anweisung wird in einen Aktionsplan übersetzt. „Behebe den instabilen Test“ ist noch nicht umsetzbar; das Modell muss den Umfang ableiten, identifizieren, welche Dateien relevant sind, und feststellen, ob es sich um eine Debugging-Aufgabe, eine Testumschreibung oder ein Problem mit den Fixtures handelt. Mehrdeutigkeiten in diesem Schritt führen später meist zu Abweichungen.
Sobald die Aufgabe definiert ist, beginnt der Aufruf der Tools. Dateizugriffe. Symbolsuche. Patch-Erstellung. Shell-Befehle. An diesem Punkt hört der Workflow auf, passiv zu sein. Das Modell agiert nun im Repository, anstatt nur darüber nachzudenken. Hier spielen auch Berechtigungsgrenzen und Tool-Konfigurationen eine Rolle.
Die vorgeschlagene Änderung wurde angewendet. Danach liest der Workflow, was tatsächlich passiert: Tests laufen, Builds kompilieren oder schlagen fehl, Linter melden Probleme. Die Ausführung liefert Feedback. Genau dieses Feedback macht aus einer einmaligen Generierung eine agentische Schleife. Das Modell ist nicht fertig, wenn es einen Diff erstellt hat. Es ist erst dann abgeschlossen, wenn der Feedback-Kreislauf geschlossen ist.
Basierend auf den Rückmeldungen passt sich das Modell an. Es verfeinert möglicherweise den Patch, öffnet eine weitere Datei, ändert den Ansatz oder stellt fest, dass die Aufgabe erledigt ist. Bei klar definierten Aufgaben kann diese Schleife schnell enden. Bei schlecht eingegrenzten Aufgaben kann sie jedoch außer Kontrolle geraten, insbesondere wenn sich der Kontext während der Ausführung verschlechtert.
Der grobe Ausführungspfad sieht wie folgt aus:
Dateien lesen → Aufgabe interpretieren → Tools aufrufen → Patch anwenden → Tests ausführen → Ausgabe beobachten → iterieren oder stoppen.
Das Verständnis dieses Pfades hilft dabei, die Architektur hinter den Claude Code-Workflows zu verdeutlichen.
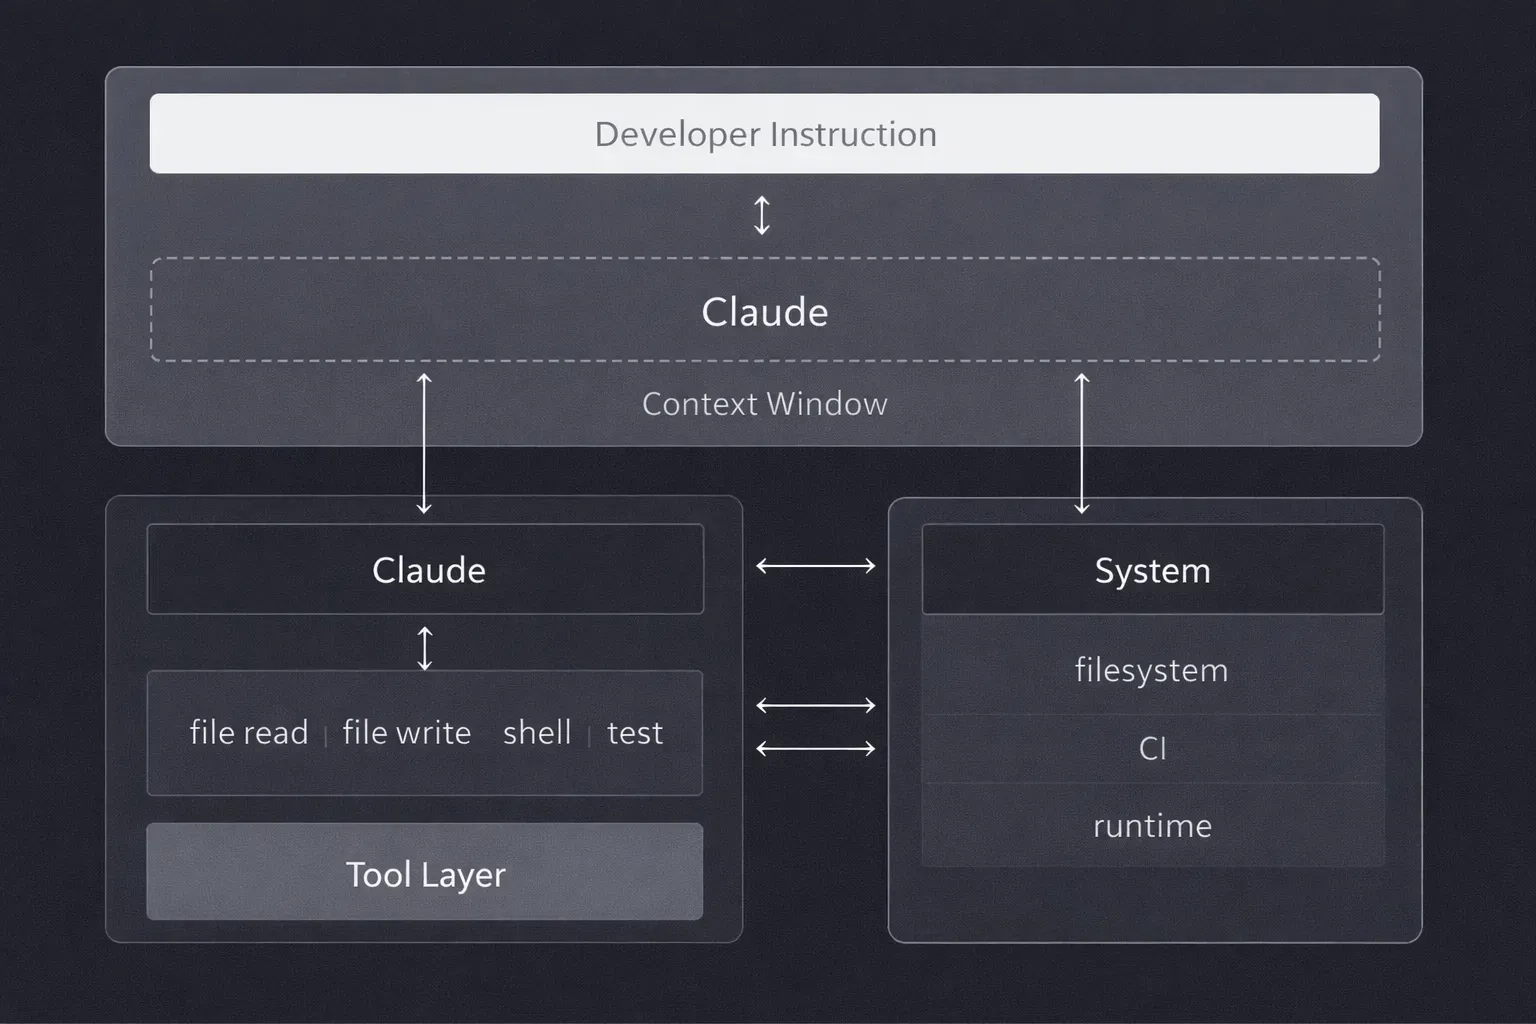
Auf der höchsten Ebene folgt die Architektur einem einfachen Pfad:
Entwickleranweisung → Claude → Tool-Ebene → Dateisystem und Laufzeitumgebung.
Doch jede Grenze bringt Einschränkungen mit sich, die das tatsächliche Verhalten des Workflows prägen.
Der schrittweise Workflow beschreibt, was Claude Code tut. Dieser Abschnitt erläutert, was unter diesen Schritten vor sich geht.
Claude arbeitet innerhalb eines begrenzten Kontextfensters. Es kann nicht die gesamte Codebasis auf einmal lesen. Es sieht einen Ausschnitt, der durch das bestimmt wird, was zu Beginn des Laufs geladen wurde und was sich während der Ausführung angesammelt hat. Dies ist kein Fehler, sondern eine grundlegende Eigenschaft. Es bedeutet jedoch, dass jede Entscheidung des Modells auf unvollständigen Informationen basiert, auch wenn es von außen nicht so aussieht.
Claude ändert Dateien nicht direkt und führt keine Befehle aus. Es ruft Tools auf, die dies tun. Dateizugriffe, Bearbeitungen und Shell-Ausführungen werden als strukturierte Schnittstellen bereitgestellt. Im Prinzip hält diese Abstraktion den Workflow kombinierbar und prüfbar. Sie können nachvollziehen, was das Modell angefordert hat. Es bedeutet aber auch, dass Fehler auf der Tool-Ebene (Timeouts, unvollständige Schreibvorgänge, unerwartete Ausgabeformate) als Probleme im Modellverhalten erscheinen, obwohl es sich eigentlich um Infrastrukturprobleme handelt.
Der Zustand existiert an zwei Orten. Ein impliziter Zustand baut sich innerhalb des Kontextfensters auf, während die Argumentation fortschreitet. Während der Ausführung wird ein expliziter Zustand in Dateien, Protokolle und Befehlsausgaben geschrieben. Wenn sich das Kontextfenster füllt oder gekürzt wird, verschlechtert sich der implizite Zustand. Das Modell führt die Arbeit zwar fort, verwendet jedoch ein anderes internes Bild als zu Beginn.
Claude Code fügt sich in verschiedene gängige Entwicklungsworkflows ein. Sie können es verwenden, um bestehenden Code zu verstehen, Änderungen vorzunehmen, Probleme zu untersuchen und Ihre Arbeit zu verifizieren, ohne zwischen mehreren Tools wechseln zu müssen.
Wenn Sie neu in einem Repository sind, lassen Sie Claude Code nachvollziehen, wie ein Feature oder eine Funktion funktioniert. Es kann relevante Dateien finden, Abhängigkeiten verfolgen und die bestehende Implementierung erklären, bevor Sie den Code anfassen.
Geben Sie für ein neues Feature einfach die Anforderungen an Claude Code weiter und bitten Sie es, die Codebasis zu untersuchen und einen Implementierungsplan zu erstellen. Sobald der Ansatz stimmt, kann es die Änderungen vornehmen und die entsprechenden Prüfungen durchführen.
Teilen Sie den Fehler, den fehlgeschlagenen Test oder das unerwartete Verhalten mit Claude Code. Es kann das Problem zurückverfolgen, die wahrscheinliche Ursache identifizieren, eine Korrektur vornehmen und testen, ob das Problem tatsächlich behoben ist.
Nutzen Sie Claude Code, wenn ein Refactoring mehrere Dateien umfasst oder wiederkehrende Änderungen erfordert. Es kann bestehende Muster bei der Umsetzung der Änderungen einhalten, woraufhin Sie das Diff überprüfen und Ihre Tests ausführen können.
Claude Code kann Tests für neues Verhalten schreiben und bestehende Tests nach einer Änderung ausführen. Wenn etwas fehlschlägt, kann es die Ursache untersuchen und die Implementierung entsprechend anpassen.
Bevor Sie einen Pull Request öffnen, bitten Sie Claude Code, die Änderungen auf Fehler, fehlende Tests und Inkonsistenzen zu prüfen. Es kann zudem die Arbeit zusammenfassen und Punkte hervorheben, die eine genauere menschliche Überprüfung erfordern.
Claude Code enthält verschiedene Funktionen, die diese Workflows einfacher zu verwalten, zu automatisieren und zu wiederholen machen. Jede davon löst einen anderen Teil des Entwicklungsprozesses.
CLAUDE.md gibt Claude Code projektspezifische Anweisungen und Kontext. Sie können damit Programmierkonventionen, häufig verwendete Befehle, Architekturhinweise und Regeln definieren, die der Agent befolgen soll.
Mit Skills können Sie wiederholbare Anweisungen für bestimmte Aufgaben bündeln. Anstatt denselben Prozess in jedem Prompt neu zu erklären, können Sie einen Skill erstellen, den Claude Code bei Bedarf abrufen kann.
Subagents ermöglichen es Claude Code, spezifische Aufgaben an separate Agenten zu delegieren. Dies ist nützlich, wenn ein Workflow parallele Untersuchungen, spezialisierte Analysen oder Aufgaben umfasst, die unabhängig voneinander bearbeitet werden können.
Hooks ermöglichen es Ihnen, Befehle automatisch an bestimmten Punkten im Workflow von Claude Code auszuführen. Sie können sie für Aufgaben wie Formatierung, Validierung, Protokollierung oder andere Prüfungen verwenden, die konsistent durchgeführt werden sollten.
Mit Git Worktrees können Sie in separaten Verzeichnissen an mehreren Branches arbeiten, ohne ständig zwischen denselben Arbeitsverzeichnissen wechseln zu müssen. Dies ist nützlich, wenn Claude Code parallele Aufgaben oder Experimente bearbeiten muss.
MCP verbindet Claude Codemit externen Tools und Datenquellen. MitMCP-Servernkönnen Sie Claude Code Zugriff auf Dienste wie Datenbanken, APIs, Issue-Tracker oder andere Tools geben, die in Ihrem Entwicklungsworkflow verwendet werden.
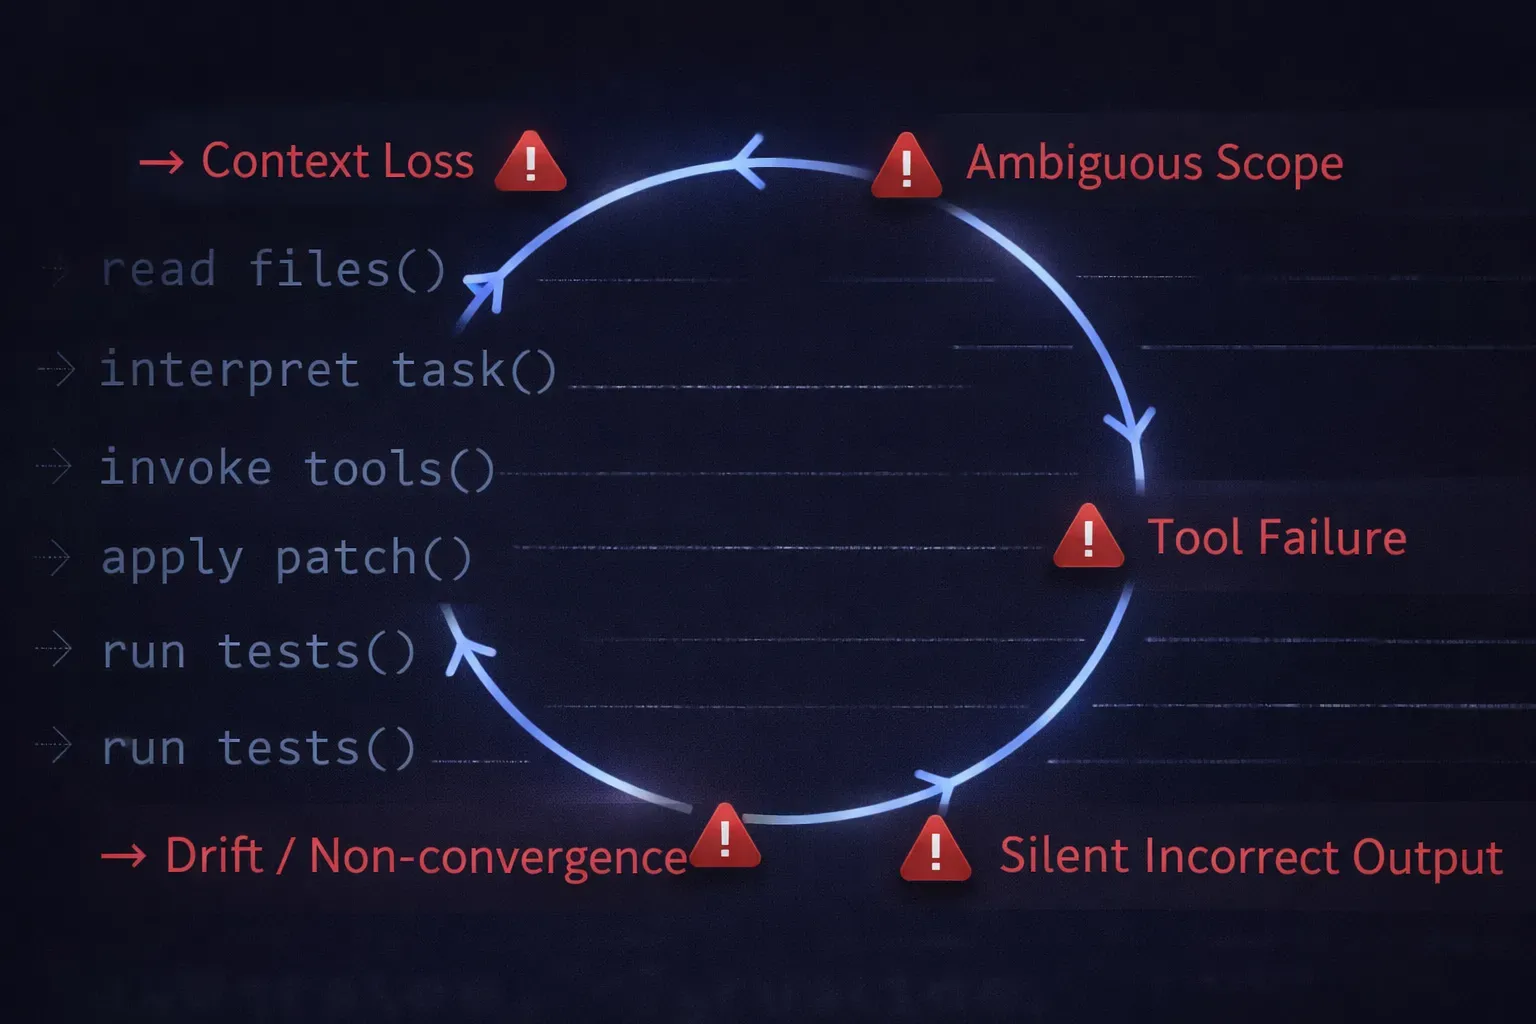
Dies ist der Teil, den Teams oft übersehen. Das Scheitern ist selten dramatisch. Claude Code produziert normalerweise keinen offensichtlich schlechten Code. Es scheitert im Stillen: mit plausibel aussehenden Änderungen, die subtil falsch sind, Änderungen, die zwar Tests bestehen, aber am Ziel vorbeigehen, und einer Argumentation, die während des Laufs ohne klares Signal abdriftet.
Der Workflow beginnt mit den richtigen Dateien. Dann werden mehr Kontext, zusätzliche Tool-Ausgaben, Zwischen-Patches und Befehlsergebnisse geladen. Das Kontextfenster füllt sich. Irgendetwas geht verloren. Das Modell setzt seine Argumentation fort, jedoch auf Basis eines anderen internen Bildes. Nichts sieht offensichtlich kaputt aus. Genau das macht es gefährlich.
Ein Funktionsaufruf im generierten Patch verweist auf ein nicht existierendes Objekt. Ein Refactoring führt eine Abhängigkeit ein, die nie erforderlich war. Das Diff liest sich fast zu sauber. Es kommt formatiert wie korrekter Code daher. Genau deshalb rutscht es durch die Überprüfung.
Sie sehen das finale Diff. Sie können jedoch nicht die Reihenfolge der Lese- und Wiederholungsversuche sehen, die dazu geführt haben. Wenn das Ergebnis falsch ist, gibt es keine verlässliche Spur, die erklärt, warum das Modell vom Kurs abgekommen ist. Das Debugging wird zu einer rückwärtsgewandten Archäologie statt zu einer zukunftsorientierten Instrumentierung.Observability-Tools für KI-Agentenkönnen hierbei helfen.
Wenn man dieselbe Aufgabe zweimal ausführt, weichen die Ergebnisse voneinander ab. Nicht immer dramatisch, aber gerade so sehr, dass das Debuggen von Mustern mühsam wird. Der Kontext variiert zwischen den Durchläufen leicht. Tool-Ausgaben unterscheiden sich. Das Modell wählt bei demselben Problem einen anderen Lösungsweg. Reproduzierbarkeit ist eine unterschätzte betriebliche Anforderung, besonders sobald diese Workflows kritische Codebereiche berühren.
Das Modell arbeitet mit dem, was die Tools zurückgeben. Ein Shell-Befehl läuft in ein Timeout. Ein Test-Runner beendet sich mit unvollständiger Ausgabe. Ein Schreibvorgang in eine Datei ist erfolgreich, aber der Inhalt ist abgeschnitten. Das Modell reagiert auf das, was es tatsächlich erhalten hat, nicht auf das, was es hätte erhalten sollen. Was bei lokalen Tests robust erschien, bricht schnell zusammen, sobald reale Infrastruktur im Spiel ist.
Die in Demos sichtbare Robustheit weicht bei realer Infrastruktur schnell einer gewissen Fehleranfälligkeit. Diese Ausfälle erschweren die Skalierung von Workflows über größere Teams und Systeme hinweg.
Wenn ein einzelner Entwickler einen Workflow ausführt, ist das ein Produktivitätsexperiment. Wenn ein Team von Ingenieuren überlappende Workflows auf einer gemeinsamen Codebasis ausführt, wird daraus ein betriebliches Problem. Die Fehler sind bei zunehmender Skalierung zwar leicht zu identifizieren, aber schwieriger zu isolieren.
In einem einzelnen Repository kann sich das Modell ein brauchbares Bild des Codes machen. Dieses Bild bricht zusammen, sobald man ein Service Mesh, mehrere Repositories, gemeinsam genutzte Bibliotheken und versionsgebundene Abhängigkeiten hinzufügt. Eine Änderung, die innerhalb eines Repositories korrekt aussieht, erzeugt eine subtile Inkonsistenz in einem anderen. Der Workflow weiß nicht, was er nicht sehen kann.
Zwei Ingenieure bitten Claude Code unabhängig voneinander um ähnliche Änderungen. Sie erhalten unterschiedliche Muster zurück. Keines davon ist direkt falsch, aber nun gibt es zwei Wege, dasselbe Problem in der Codebasis zu lösen. Ohne gemeinsamen Status oder Sichtbarkeit darüber, was der Agent bereits bearbeitet hat, bricht die Koordination auf Workflow-Ebene zusammen, nicht nur auf Code-Ebene.
Agentische Workflows, die Shell-Befehle ausführen können, bewegen sich nahe an Produktionsgrenzen. Zu weit gefasste Berechtigungen vergrößern den potenziellen Schaden. Zu eng gefasste Berechtigungen führen zu unvorhersehbaren Fehlern. Keines dieser Probleme lässt sich durch die Anpassung von Prompts lösen. Es erfordert eine gezielte Tool-Konfiguration und eine Zugriffskontrolle auf Infrastrukturebene.
Irgendwann wird jemand fragen: „Welcher Workflow hat diese Datei geändert? Welcher Befehl wurde als Teil dieser Aufgabe ausgeführt? Wer hat das genehmigt?“ Wenn das System diese Fragen nicht beantworten kann, fehlt es an Governance. Es gibt zwar Aktivität, aber keine Nachvollziehbarkeit. Dieser Unterschied ist wichtig, sobald diese Workflows Code berühren, der mit Geld, Authentifizierung oder Daten zu tun hat. Unser Artikel überGovernance für KI-Agentenerläutert das Konzept im Detail.
Das Debuggen eines einzelnen fehlgeschlagenen Durchlaufs ist bereits schwierig, da Ausführungsprotokolle oft unvollständig sind. Das Debuggen von Mustern über viele Durchläufe hinweg ist noch schwieriger. Die Ausgaben variieren leicht pro Durchlauf. Der Kontext unterscheidet sich. Das Verhalten der Tools ändert sich. Ohne ein stabiles, strukturiertes Ausführungsprotokoll ist die Reproduktion eines Fehlers eher eine Jagd als eine Untersuchung.
Der produktive Einsatz ändert die Prioritäten. In einer Demo ist das Ziel die Qualität der Ausgabe. In der Produktion ist das Ziel eine zuverlässige, auditierbare und wiederholbare Ausführung. Die Praktiken, die Sie dorthin führen, betreffen nicht das Modell selbst, sondern die Art und Weise, wie Sie das System darum herum strukturieren.
„Refaktoriere das Auth-Modul“ ist eine Anweisung. „Refaktoriere das Auth-Modul, um die Logik zur Token-Validierung zu konsolidieren, aber ändere dabei nicht die öffentlichen Methodensignaturen und fasse das Migrationsverzeichnis nicht an“ ist eine Einschränkung. Einschränkungen sind nützlicher als bloßer Enthusiasmus. Sie geben dem Workflow etwas Konkretes, an das er sich halten kann, statt nur ein allgemeines Ziel.
Mehr Kontext ist nicht immer besser. Das Laden des halben Repositories zusammen mit veralteten Protokollen und irrelevanten Ausgabedateien erhöht das Rauschen, ohne die Genauigkeit zu verbessern. Effektive Workflows sind selektiv: Füttern Sie das Modell mit genug Informationen, um die Aufgabe zu durchdringen, nicht mit allem, was nur entfernt damit zu tun haben könnte. Die Disziplin liegt hier im Weglassen, nicht im Hinzufügen.
Wenn der Workflow Tests generiert, benötigt er wahrscheinlich keinen Zugriff auf Deployment-Skripte. Wenn er Anwendungscode refaktoriert, ist ein umfassender Shell-Zugriff unnötig. Die Einschränkung des Tool-Zugriffs verringert den potenziellen Schaden und reduziert die Komplexität, die das Modell bewältigen muss. Engere Grenzen sind meist zuverlässiger.
Ein Schritt zur Überprüfung von Diffs, ein Dry-Run-Flag und eine Bestätigungsschranke, bevor Änderungen angewendet werden. Diese verlangsamen den Workflow zwar leicht, fangen aber schwache Annahmen ab, bevor sie zu Commits werden. In agentenbasierten Systemen ist der Prüfpunkt keine Bürokratie, sondern der Ort, an dem menschliches Urteilsvermögen in die automatisierte Ausführung einfließt. Ihn zu entfernen, ist die Wette darauf, dass das Modell niemals vom Kurs abweicht.
Zu wissen, dass der finale Code kompiliert wurde, reicht nicht aus. Sie müssen wissen, welche Dateien gelesen wurden, welche Befehle ausgeführt wurden, wie viele Wiederholungsversuche stattfanden und wie der Zwischenzustand aussah. Ein Workflow kann ein korrektes Ergebnis liefern und dennoch instabil sein. Diese Instabilität zeigt sich meist im Ausführungsprotokoll, bevor sie zu einem Vorfall wird.
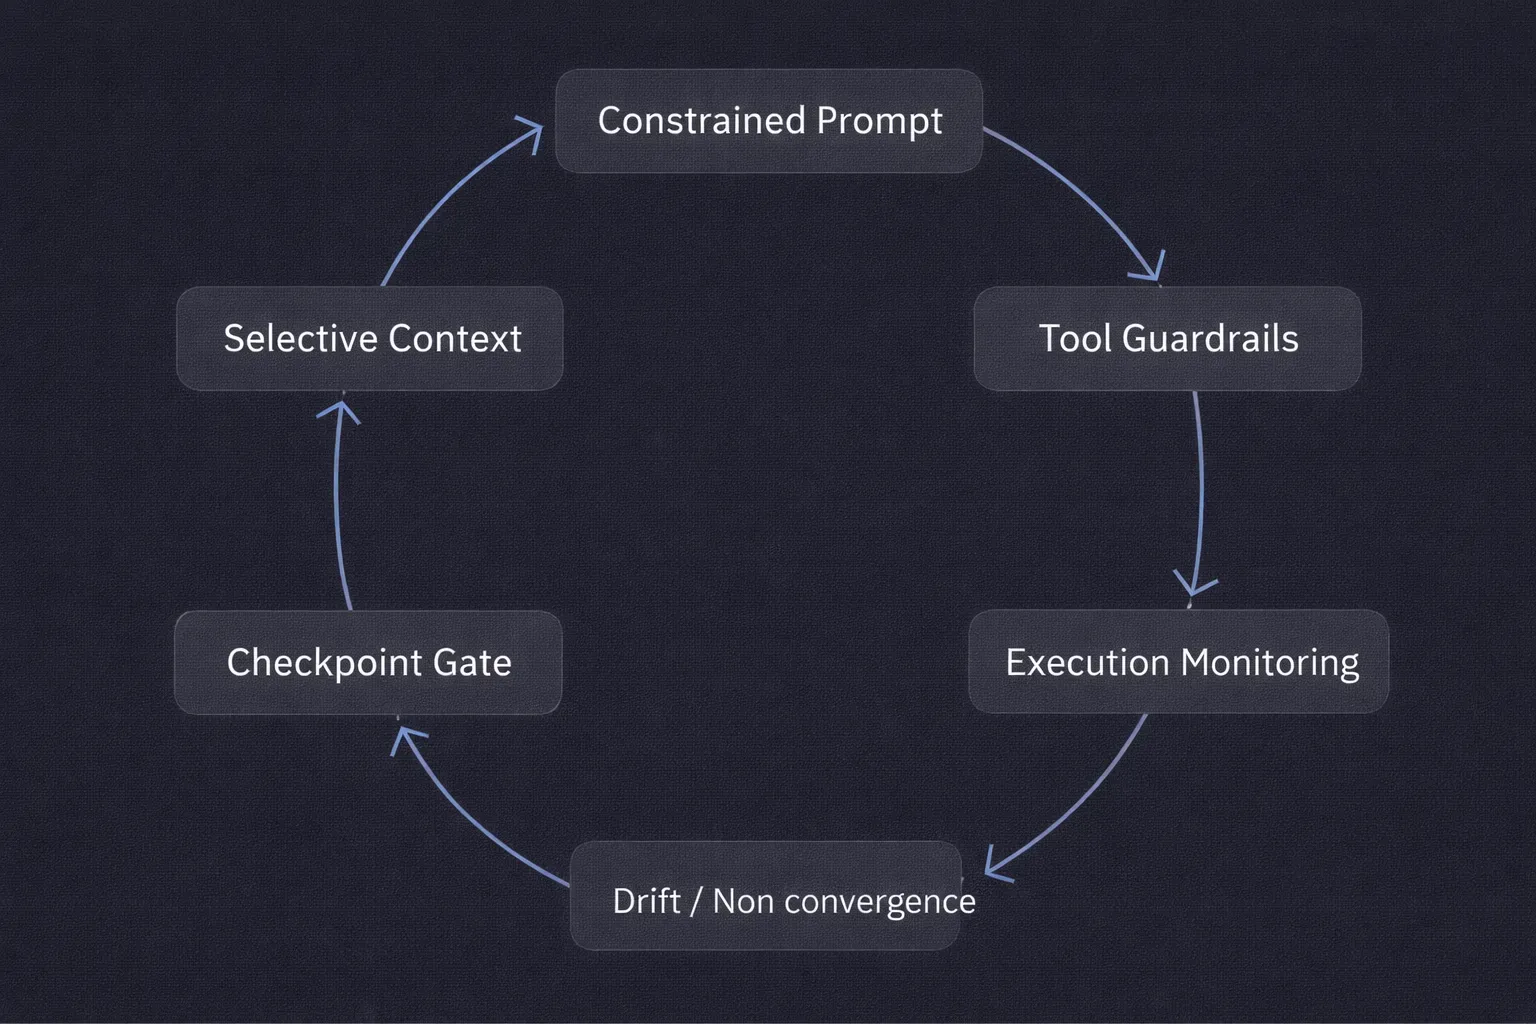
Betrachten Sie die Verifizierung nicht als letzten manuellen Schritt. Machen Sie Builds, Tests, Linting und andere relevante Prüfungen zu einem festen Bestandteil des Workflows selbst, sodass jede Änderung validiert wird, bevor sie weiterverarbeitet wird. Dies gibt dem Agenten sofortiges Feedback und macht eine erfolgreiche Ausführung leichter reproduzierbar.
Claude Code-Workflows sind nützlich für Aufgaben, die strukturiert genug sind, um automatisiert zu werden, aber so langweilig, dass man sie immer wieder aufschiebt. Das ist eine ziemlich spezifische Kategorie, und sich darüber im Klaren zu sein, spart Zeit.
Die Entscheidung lautet nicht Claude Code oder kein Claude Code. Es geht um Claude Code mit dem richtigen Umfang gegenüber Claude Code, von dem etwas verlangt wird, bei dem er sich nicht zuverlässig selbst einschränken kann.
Der Wandel von der Autovervollständigung zur agentenbasierten Ausführung ist bereits in vollem Gange. Claude Code ist keine intelligentere Vorschlags-Engine; es ist ein Ausführungssystem, das liest, handelt, beobachtet und anpasst. Diese Unterscheidung verändert die Bedeutung von Zuverlässigkeit.
Ein gut geführter Claude Code-Workflow bietet Ihnen einen echten Mehrwert: weniger Zeitaufwand für mechanische Refactorings, schnellere Testabdeckung und Migrationsaufgaben, die nicht im Backlog liegen bleiben. Aber das Wort „gut geführt“ ist hier entscheidend. Es erfordert eine sorgfältige Kontrolle des Kontexts, definierte Tool-Berechtigungen, strukturierte Prompts, Checkpoints vor der Ausführung und eine Instrumentierung dessen, was tatsächlich ausgeführt wurde.
Teams, die dies verstehen, behandeln den Workflow weniger wie einen cleveren Prompt und mehr wie ein begrenztes Ausführungssystem, das dieselbe operative Disziplin erfordert wie jede andere Infrastrukturkomponente, die Produktionscode berührt.
Sobald Workflows beginnen, Repositories zu ändern, Befehle auszuführen und in echten Umgebungen zu arbeiten, hören sie auf, Experimente zu sein. Sie werden zu Infrastruktur. Die Frage ist dann, ob das umgebende System genügend Transparenz und Kontrolle bietet, um dies sicher zu gestalten.
TrueFoundryTrueFoundry bietet Teams eine zentrale Ebene für die Verwaltung von Agentenausführung, Tool-Zugriff, Observability und KI-Governance, während Claude Code-Workflows in die Produktion übergehen. Wenn Sie Claude Code-Workflows in großem Maßstab entwickeln, unterstützt Sie TrueFoundry dabei, die Agentenausführung, den Tool-Zugriff, die Observability und die Governance über eine einzige Plattform zu steuern.
Demo buchenum zu sehen, wie es in Ihr Setup passt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















