Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.
9,9
Erstellung von RAG mit TrueFoundry und MongoDB Atlas
Aktualisiert: November 3, 2026
Published: April 20, 2026
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Verarbeitet mehr als 350 RPS auf nur 1 vCPU — kein Tuning erforderlich
Retrieval-Augmented Generation (RAG) kombiniert die Stärken von Retrieval-Systemen und generativen Modellen, um hochrelevante, kontextbezogene Ergebnisse zu erzeugen. Es fragt externe Wissensquellen – wie Datenbanken oder Suchindizes – ab, um relevante Informationen abzurufen, die dann von einem generativen Modell verfeinert werden.
Warum RAG?
Hochgradig relevante und kontextbezogene Ergebnisse.
Durch die Einbindung von dynamischem und aktuellem Wissen überwinden RAG-Systeme die Einschränkungen des statischen Pre-Trainings in generativen Modellen. Das macht sie äußerst effektiv für Anwendungen wie Frage-Antwort-Systeme, wissensintensive Aufgaben und die Erstellung personalisierter Inhalte.
Die modulare Natur von RAG ermöglicht eine Optimierung sowohl in der Retrieval- als auch in der Generationsphase, was eine größere Flexibilität und Skalierbarkeit beim Systemdesign bietet.
Cognita von TrueFoundry: Vereinfachung von RAG für skalierbare Anwendungen
Trotz seines Potenzials kann die Implementierung von RAG komplex sein, da sie Modellauswahl, Datenorganisation und Best Practices umfasst. Bestehende Tools vereinfachen das Prototyping, bieten jedoch keine Open-Source-Vorlage für eine skalierbare Bereitstellung – hier kommt Cognita ins Spiel.
Cognita ist ein Open-Source-RAG-Framework, das die Entwicklung und Bereitstellung skalierbarer Anwendungen vereinfacht. Indem es RAG in modulare Schritte unterteilt, gewährleistet es eine einfache Wartung, Interoperabilität mit anderen AI-Tools, Anpassbarkeit und Compliance. Cognita findet das Gleichgewicht zwischen Anpassungsfähigkeit und Benutzerfreundlichkeit und bleibt gleichzeitig skalierbar für zukünftige Entwicklungen.
Vorteile von Cognita
Ein zentrales, wiederverwendbares Repository für Parser, Loader, Embedder und Retriever.
Möglichkeit für nicht-technische Benutzer, mit der Benutzeroberfläche zu arbeiten – Dokumente hochladen und F&A mit Modulen durchführen, die vom Entwicklerteam entwickelt wurden.
Vollständig API-gesteuert – was die Integration mit anderen Systemen ermöglicht.
Large Language Models (LLMs) für die einfache Interaktion mit generativen Modellen wie GPT von OpenAI, Hugging Face-Modellen oder anderen LLM-APIs.
Vorgefertigte Integrationen zur einfachen Anbindung an Pinecone, Weaviate, ChromaDB oder MongoDB Atlas Vector Search.
Die Verwendung von MongoDB als Vektordatenbank für Ihre Retrieval-Augmented Generation (RAG)-Anwendung kann je nach Ihren Anforderungen von Vorteil sein. Hier ist, warum MongoDB eine gute Wahl sein könnte:
1. Native Unterstützung für Vector Search
MongoDB unterstützt Vektorindizierung über seine Atlas Vector Search. Dies ermöglicht effiziente Ähnlichkeitssuchen über hochdimensionale Daten, was für RAG-Workflows zentral ist. Die wichtigsten Vorteile:
Integration mit der Query Language von MongoDB: Kombiniert Vektorsuche mit traditionellen Abfragen und ermöglicht so eine flexiblere und leistungsfähigere Abfragezusammenstellung.
Hochleistungssuche: Verwendet Approximate Nearest Neighbor (ANN)-Algorithmen wie HNSW (Hierarchical Navigable Small World) für ein skalierbares und schnelles Retrieval von Vektoren.
2. Einheitliches Datenmanagement
RAG-Anwendungen erfordern oft die Verwaltung von sowohl unstrukturierten Daten (z. B. Text und Embeddings) als auch strukturierten Daten (z. B. Metadaten, Benutzereinstellungen).
Da MongoDB eine Dokumentendatenbank ist, können Sie Embeddings zusammen mit den zugehörigen Metadaten in einem einzigen Datensatz speichern. Zum Beispiel:
Dadurch wird die Komplexität vermieden, Embeddings in einem separaten System verwalten zu müssen.
3. Flexibilität und Skalierbarkeit
Schemaloses Design: Die Schemaflexibilität von MongoDB macht es einfach, Ihr Datenmodell im Zuge der Weiterentwicklung Ihrer RAG-Anwendung zu iterieren.
Horizontale Skalierung: MongoDB unterstützt Database Sharding, um Daten auf mehrere Server zu verteilen. Dies hilft Anwendungen, große Datensätze zu verwalten und mit ihrem Wachstum zu skalieren.
Ein Video-Tutorial, das zeigt, wie Sie Ihren kostenlosen MongoDB Atlas-Cluster erhalten, finden Sie hier.
Richten Sie ein MongoDB Atlas-Konto ein, indem Sie die Seite Registrieren besuchen, falls Sie noch kein Konto haben.
Um einen Cluster im Reiter "Overview" einzurichten, klicken Sie auf „Create“, wählen Sie den Cluster gemäß Ihren Anforderungen aus und klicken Sie auf „Create Deployment“.
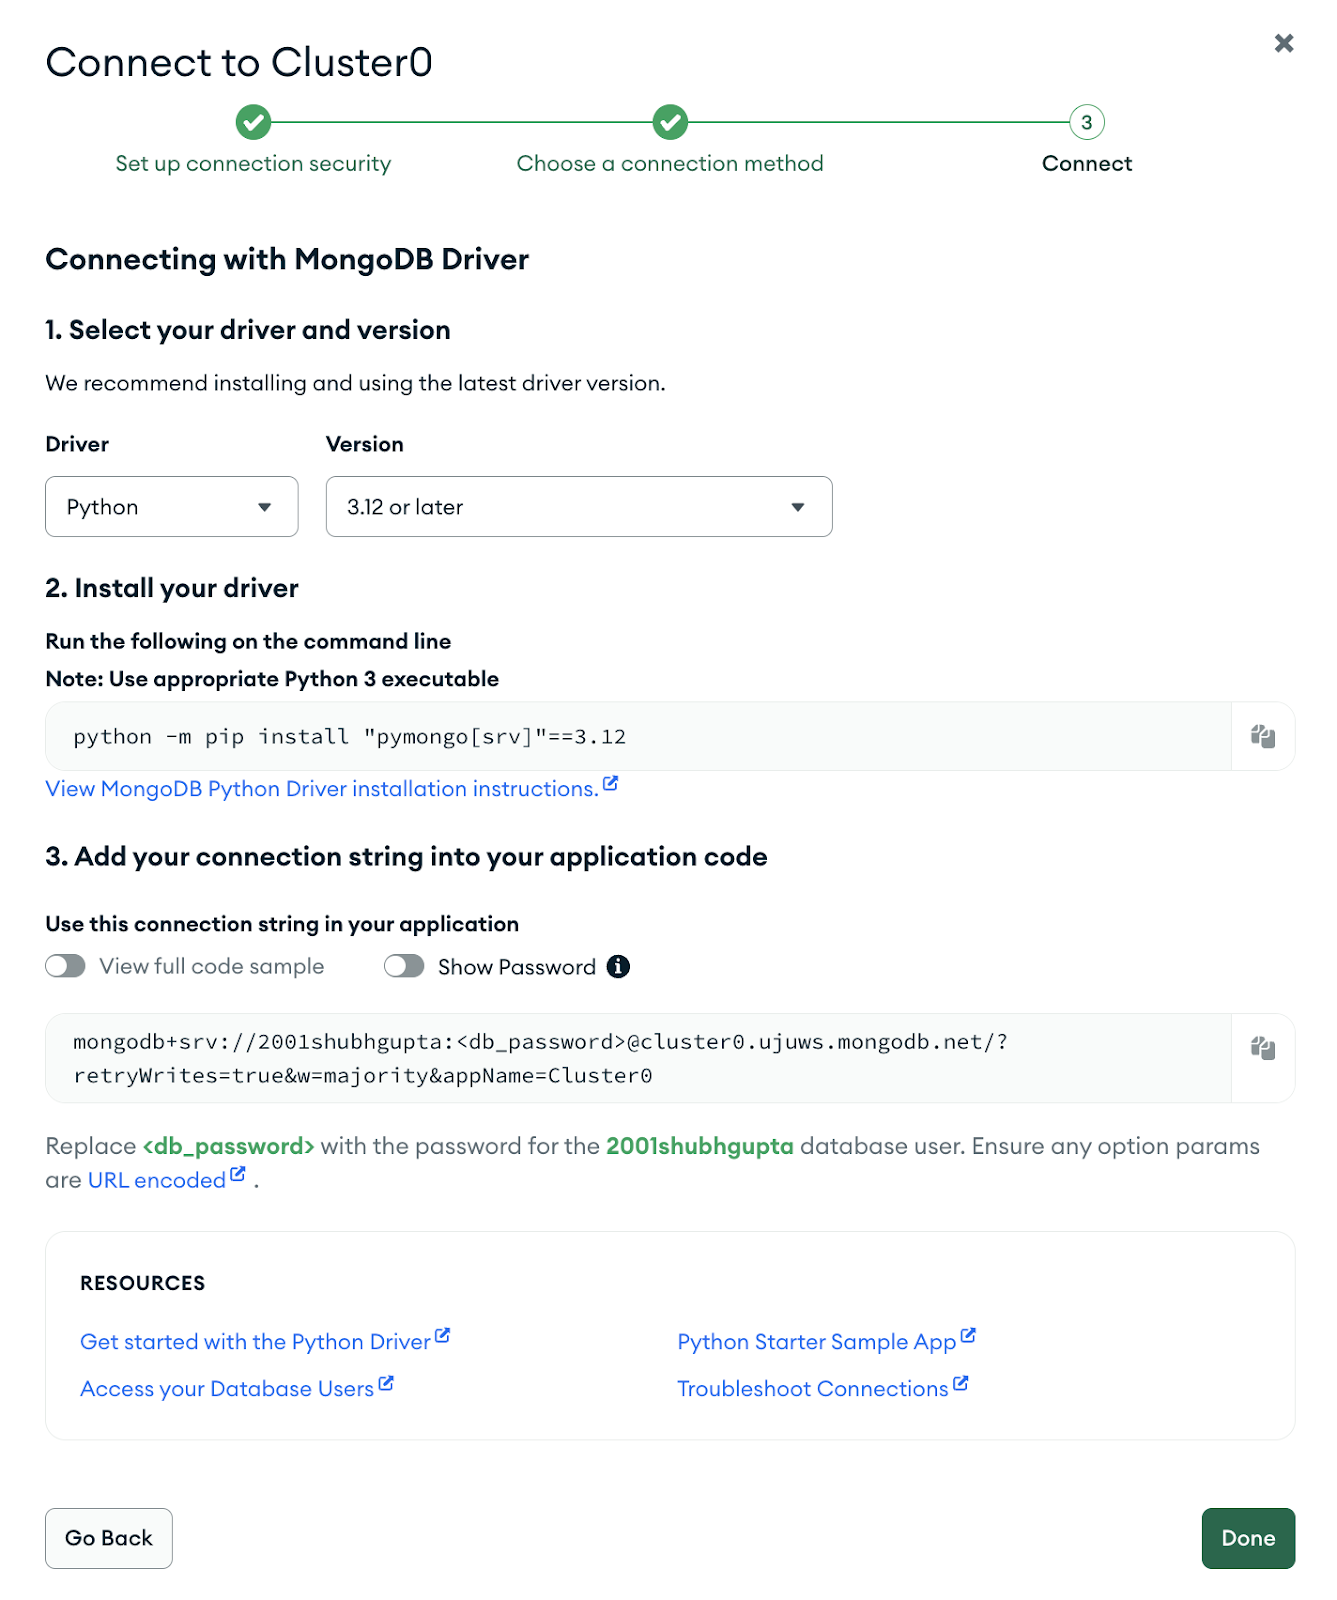
Um die erforderlichen Authentifizierungen hinzuzufügen, erstellen Sie im Fenster „Connect to Cluster“ einen Datenbankbenutzer.
Verbinden mit dem MongoDB-Treiber
Wählen Sie die Python-Version aus
Der Verbindungsstring enthält Ihren Benutzernamen und Ihr Passwort. Kopieren Sie den Verbindungsstring. Dieser wird im nächsten Schritt verwendet.
Schritt 2: Einrichten von Cognita zur Nutzung von MongoDB
Bevor wir die Dienste starten, müssen wir die Modellanbieter konfigurieren, die wir für das Embedding und die Generierung von Antworten benötigen. Kopieren Sie zu Beginn models_config.sample.yaml nach models_config.yaml.
cp models_config.sample.yaml models_config.yaml
Erstellen Sie eine MongoDB-Collection in der neu erstellten Datenbank, beispielsweise „cognita“. Dies ist die Collection, in der alle Chunks gespeichert und im Retrieval-Prozess verwendet werden.
Die Compose-Datei verwendet die Datei compose.env für Umgebungsvariablen. Sie können diese nach Ihren Bedürfnissen anpassen.
Bearbeiten Sie den Schlüssel „VECTOR_DB_CONFIG“ in der Umgebungsdatei. Diese Konfiguration wird im Bootstrap-Prozess verwendet, um sicherzustellen, dass MongoDB während der gesamten Laufzeit als Vektorspeicher verwendet wird. Der Verbindungsstring für die MongoDB wird hier verwendet. Folgend ein Beispiel, wie dies aussehen würde:
Standardmäßig sind in der Konfiguration lokale Anbieter aktiviert, die einen infinity- und einen ollama-Server benötigen, um Embedding und LLMs lokal auszuführen. Wenn Sie jedoch einen OpenAI API Key haben, können Sie den openai-Anbieter in models_config.yaml auskommentieren und OPENAI_API_KEY in compose.env aktualisieren. Nun können Sie den folgenden Befehl ausführen, um die Dienste zu starten:
docker-compose --env-file compose.env --profile ollama --profile infinity up
Die Compose-Datei startet die folgenden Dienste:
cognita-db – Postgres-Instanz zur Speicherung von Metadaten für Collections und Datenquellen.
cognita-backend – Wird verwendet, um den FastAPI-Backend-Server für Cognita zu starten.
cognita-frontend – Wird verwendet, um das Frontend für Cognita zu starten.
Sobald die Dienste laufen, können Sie unter http://localhost:5001 auf das Frontend zugreifen.
Schritt 3: Einrichten einer Datensammlung (Collection) in Cognita
Sobald Sie Cognita eingerichtet haben, zeigen die folgenden Schritte, wie Sie die Benutzeroberfläche zur Abfrage von Dokumenten verwenden:
1. Datenquelle erstellen
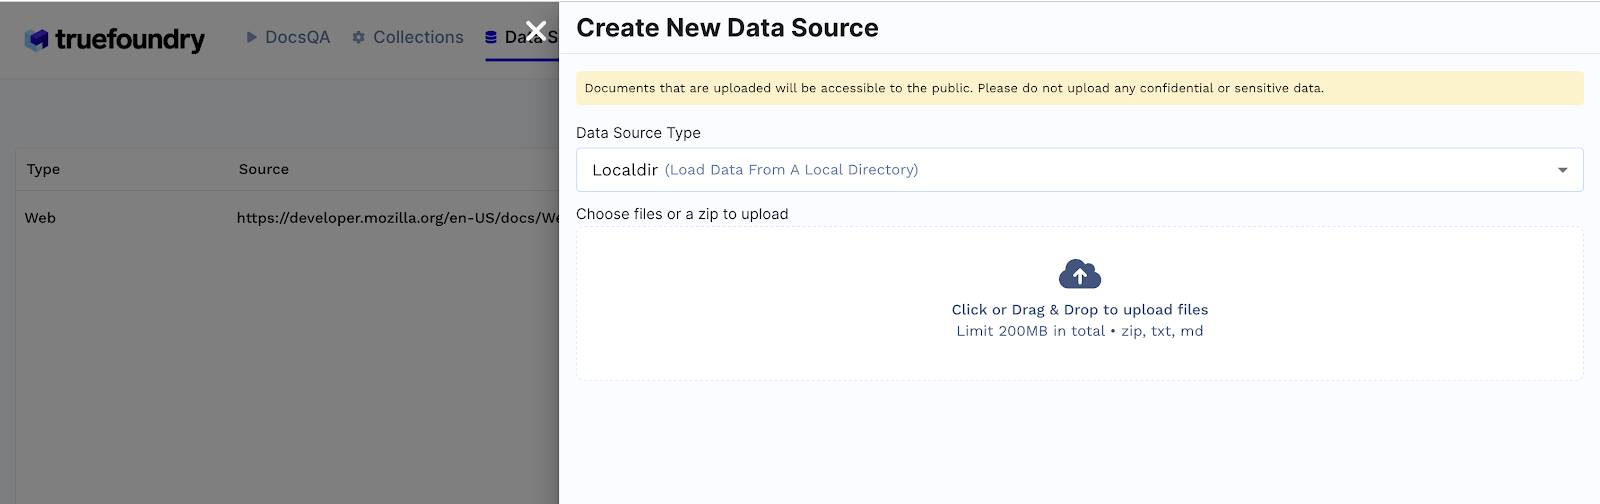
Klicken Sie auf den Reiter Data Sources
Klicken Sie auf + New Datasource
Der Datenquellentyp kann entweder Dateien aus einem lokalen Verzeichnis, eine Web-URL, eine GitHub-URL sein oder durch Angabe der TrueFoundry-Artefakt-FQN erfolgen. Beispiel: Wenn Localdir ausgewählt ist, laden Sie Dateien von Ihrem Gerät hoch und klicken Sie auf Submit.
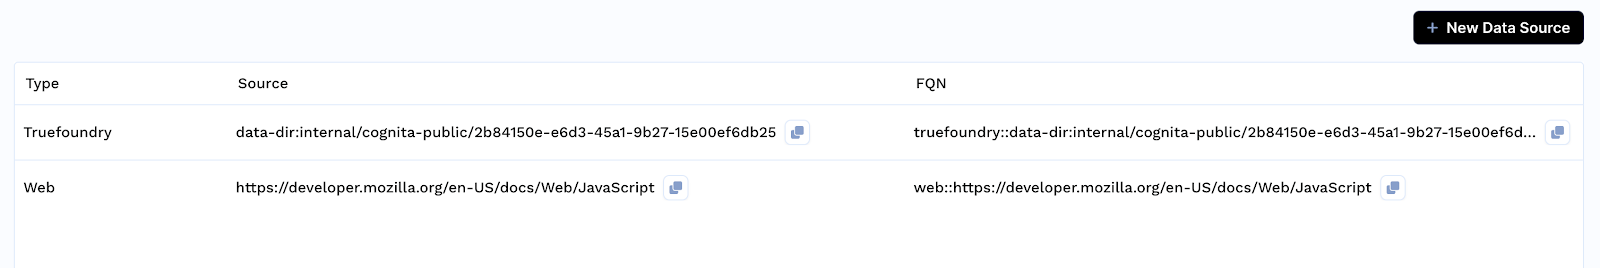
Die Liste der erstellten Datenquellen ist im Reiter Data Sources verfügbar.
2. Collection erstellen
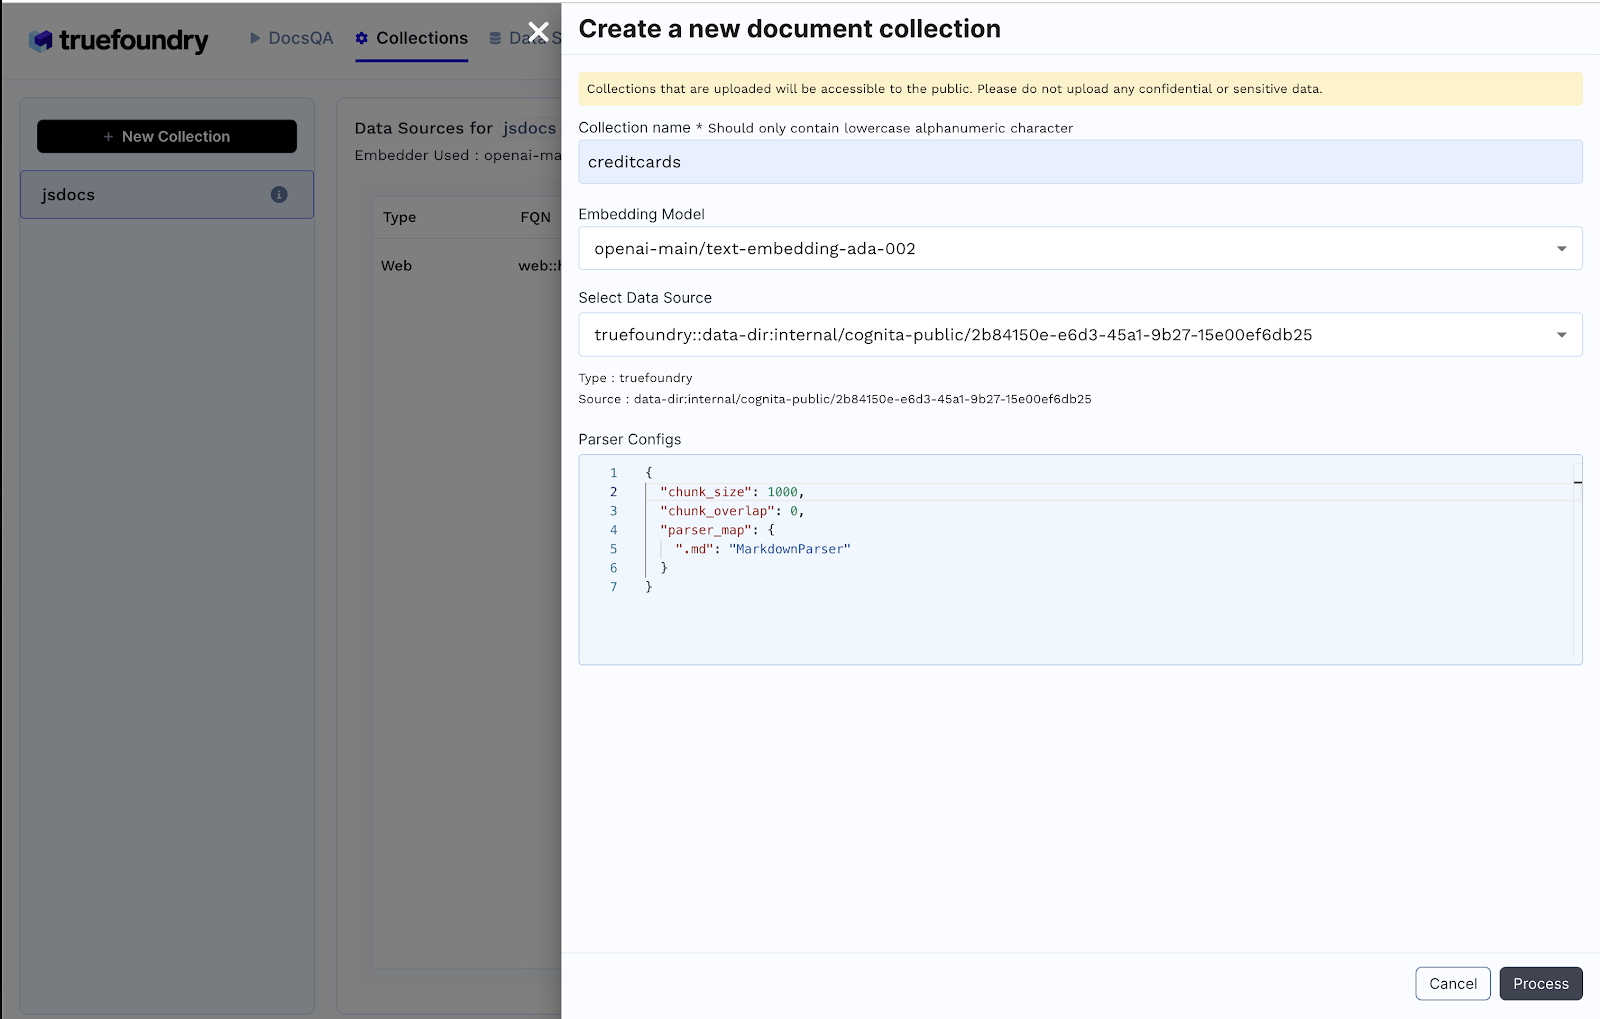
Klicken Sie auf den Reiter Collections
Klicken Sie auf + New Collection
Geben Sie den Collection Name ein
Wählen Sie das Embedding Model aus
Fügen Sie die zuvor erstellte Datenquelle und die erforderliche Konfiguration hinzu
Klicken Sie auf Process, um die Collection zu erstellen und die Daten zu indizieren
3. Nach dem Erstellen einer neuen Collection geschieht Folgendes hinter den Kulissen:
Erstellung einer neuen Collection in der konfigurierten MongoDB-Datenbank. Lautet der Name der Datenbank beispielsweise `cognita`, erstellt dieser Schritt eine Collection mit dem angegebenen Eingabenamen in der cognita-Datenbank in MongoDB.
Nach dem Erstellen einer Collection wird ein Vector Search Index mit dem folgenden Code-Snippet erstellt:
Dies stellt sicher, dass die neu erstellte Collection bereit für Vector Search-Abfragen ist. Beachten Sie, dass das Erstellen eines Index in MongoDB bis zu einer Minute dauern kann.
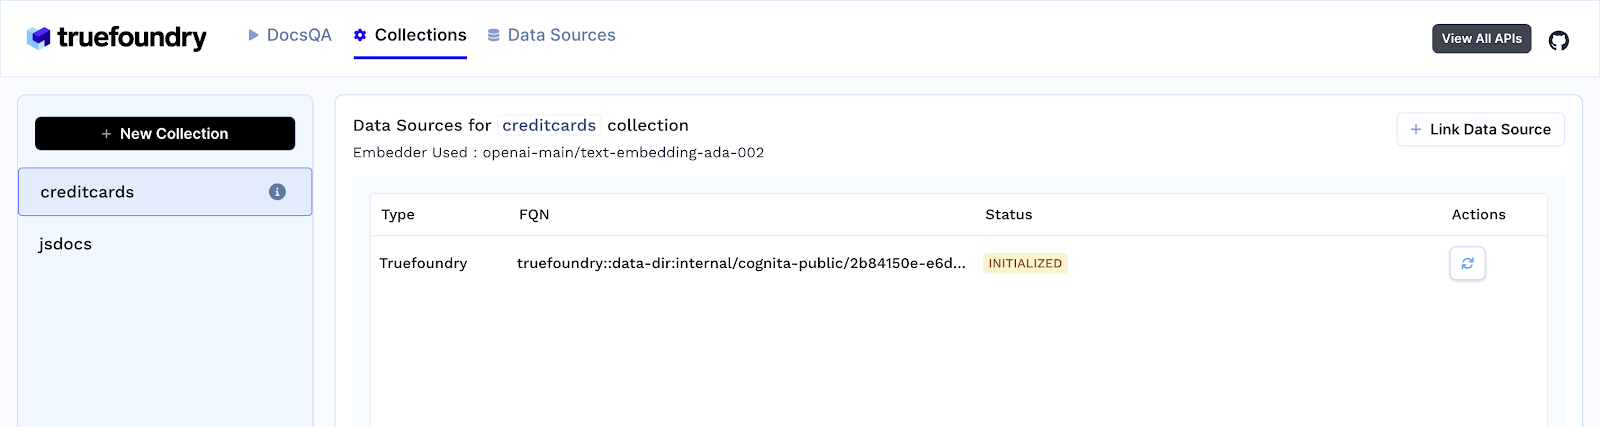
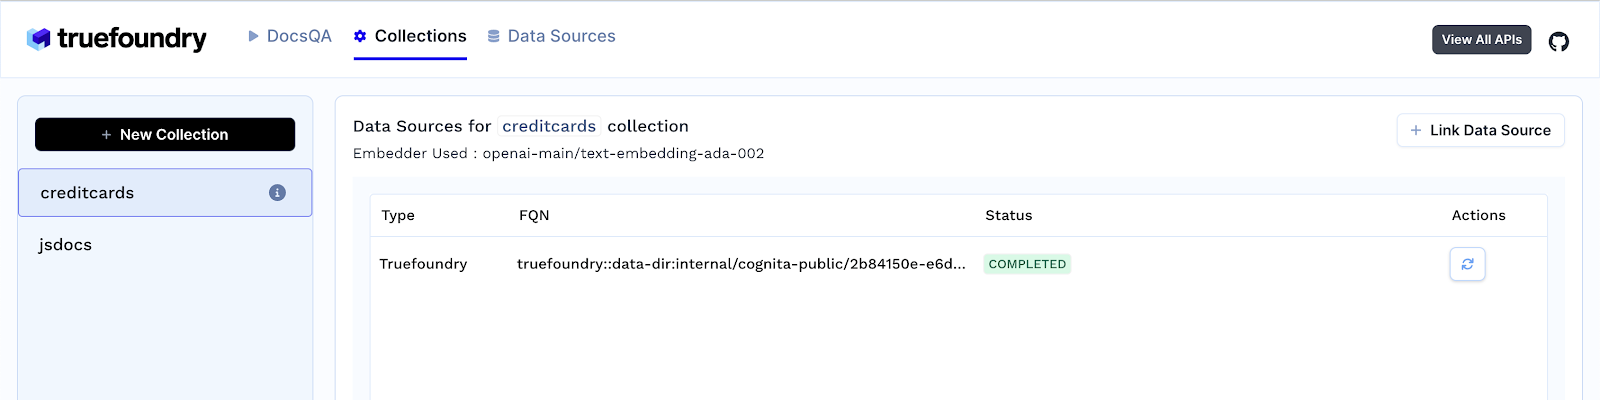
4. Sobald Sie die Collection erstellen, beginnt die Dateneinspitzung (Data Ingestion). Sie können deren Status anzeigen, indem Sie Ihre Collection im Reiter Collections auswählen. Dieser Schritt ist für das Parsen Ihrer Dateien, das Chunking und das Hinzufügen zu Ihrer MongoDB verantwortlich. Sie können später auch weitere Datenquellen hinzufügen und in der Collection indizieren. Fahren Sie mit dem nächsten Schritt fort, sobald der Status auf „Completed“ steht.
Schritt 4: Finden Sie die richtige Konfiguration für Ihre Anwendung
Nutzen Sie im Reiter DocsQA den Playground von Cognita, um mit den verschiedenen Einstellungen zu experimentieren und zu sehen, was für Ihre Anwendung am besten funktioniert. Sie können Verschiedenes ausprobieren:
Retrieval-Techniken
LLM-Modelle, Temperaturen etc.
LLM-Prompts
Embedding-Modelle
Für die Einstellung, die für Ihre Anwendung am besten funktioniert, klicken Sie auf „Create Application“. Dadurch wird ein API-Endpunkt für Ihre Anwendung bereitgestellt. Sie können zum Reiter „Applications“ gehen, um alle Ihre bereitgestellten Anwendungen zu sehen.
Fazit
Dieses Tutorial hat gezeigt, wie man in nur 10 Minuten eine produktionsbereite RAG-Anwendung mit Cognita und MongoDB baut. Die Synergie zwischen der Anpassungsfähigkeit und Benutzerfreundlichkeit von Cognita und dem flexiblen Dokumentenmodell mit Vektorsuche von MongoDB bietet ein solides Fundament für die Erstellung fortschrittlicher AI-Anwendungen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last