



November 10, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Beide sind serverlose GPU-Plattformen, beide skalieren standardmäßig auf null und beide betreiben produktive Workloads für bekannte Unternehmen. Es ist ein fairer Vergleich, doch die Ansätze unterscheiden sich grundlegend. Baseten hat eine Plattform für Modell-Inferenz entwickelt und diese stetig erweitert. Modal hingegen hat eine allgemeine Compute-Plattform geschaffen, bei der Inferenz nur eines von sechs Produkten ist. Das zeigt sich im SDK, in der Art der Abrechnung und darin, ob man die Plattform im eigenen Account betreiben kann.
Am nützlichsten ist hier die Erläuterung der Preismethodik, da die veröffentlichten GPU-Stundensätze nicht vergleichbar sind und der Fehler bei einem direkten Vergleich groß genug ist, um die Entscheidung zu beeinflussen. Die Zahlen wurden geprüft am 25. September 2026.
Baseten bietet produktive Inferenz für Open-Source-, benutzerdefinierte und feinabgestimmte Modelle über dedizierte Deployments, Token-basierte Modell-APIs und Training (Preise).
Gegründet 2019 von Tuhin Srivastava (CEO), Amir Haghighat (CTO), Phil Howes und Pankaj Gupta. Die Finanzierung verlief über die Serien B, C, D und eine 300-Millionen-Dollar-Serie E bei einer Bewertung von 5 Milliarden Dollar bis hin zu einer 1,5-Milliarden-Dollar-Serie F bei einer Bewertung von 13 Milliarden Dollar am 22. Juni 2026 (Ankündigung); die Gesamtsumme der Finanzierung liegt bei „über 2 Milliarden Dollar“. Der Umsatz soll im Jahresvergleich um das 20-fache gestiegen sein; der ARR ist nicht öffentlich [PRÜFEN]. Zu den Kunden zählen Cursor, Notion, Harvey, HubSpot, OpenEvidence und Vercel.
Zu einer Zahl, die Ihnen vielleicht begegnet ist: Presseberichte Ende September 2026 (Axios vom 22. Sep., Bloomberg vom 23. Sep.) beschreiben Gespräche über eine deutlich größere Runde in Höhe von kolportierten 26 Mrd. $. Baseten hat dazu nichts veröffentlicht. 13 Mrd. $ ist der letzte bestätigte Wert und der, den wir verwenden.
[SCREENSHOT: Baseten – das Dashboard für Dedicated Deployments zeigt Replikastatus, Autoscaling-Konfiguration und Latenz-Perzentile für ein Live-Modell]
Baseten hat zudem Blaxel übernommen, ein Unternehmen für Agent-Sandbox- und MicroVM-Infrastruktur, und kündigte dies am 10. September 2026an, Bedingungen nicht offengelegt (Ankündigung) – ein direkter Vorstoß in das Terrain von Modals Sandboxes, das erst zwei Wochen alt ist und bisher noch keine auslieferungsfähigen Ergebnisse vorzuweisen hat.
Wirklich besser für: regulierte Käufer, die Inferenz in ihrer eigenen VPC benötigen, wofür Modal kein Äquivalent bietet; alle, die mit PHI arbeiten, da HIPAA bereits im kostenlosen Tarif enthalten ist; Teams, die Optimierungen auf TensorRT-LLM-Niveau wünschen, ohne diese selbst entwickeln zu müssen; sowie für regionengebundene oder kleine GPU-Workloads.
Modal bezeichnet sich selbst als „eine für KI entwickelte Cloud. Keine zweckgebundene GPU-Cloud, sondern eine Plattform mit den richtigen Grundbausteinen“ (Series-C-Beitrag). Produkte: Inference, Sandboxes, Training, Notebooks, Batch, Core Platform. Diese Liste ist das Argument – Inference ist nur ein Punkt davon.
Gegründet 2021 von Erik Bernhardsson und Akshat Bubna; das Gründungsjahr stammt von TechCrunch, nicht von einer Modal-Seite [ÜBERPRÜFEN]. Das Team hat ein eigenes Dateisystem, eine Container-Runtime, einen Scheduler und einen Image-Builder entwickelt, was sich in den Cold-Start-Zeiten widerspiegelt. Die Finanzierung umfasste eine Seed-Runde, eine Series A und eine Series B über 87 Mio. $ bei einer Bewertung von 1,1 Mrd. $, bis hin zu einer Series C über 355 Mio. $ bei einer Bewertung von 4,65 Mrd. $ nach der Finanzierung am 21. Mai 2026; insgesamt „über 466 Mio. $“. Modal veröffentlicht, was Baseten nicht tut – „über 300 Millionen Dollar annualisierter Umsatz“, und dass „Sandboxes bereits mehr als ein Drittel unseres Umsatzes ausmachen“. Zu den Kunden zählen Cognition, DoorDash, Suno und Ramp.
[SCREENSHOT: Modal – das App-Dashboard zeigt Container-Anzahl, GPU-Auslastung und Cold-Start-Zeiten für eine bereitgestellte Funktion]
[SCREENSHOT: Modal – die Preisseite zeigt die GPU-Tabelle neben den separaten Posten für CPU und Speicher]
Wirklich besser für: alles, was kein Modell-Server ist – Sandboxes, nicht vertrauenswürdiger Code, RL-Umgebungen, Batch-Verarbeitung, Notebooks. Python-Ergonomie. Workloads mit großen GPUs, ohne feste Zuweisung und mit Lastspitzen. GPU-Vielfalt, da L40S, A100 40GB und B300 kein Baseten-Äquivalent haben. Und Init-lastige Kaltstarts, bei denen JIT und Importe mehr Zeit in Anspruch nehmen als das Laden der Gewichte.
Die ehrliche Einschätzung zu Kaltstarts: Sie lösen unterschiedliche Hälften desselben Problems. Baseten setzt bei der Bereitstellung der Gewichte an und nimmt die Übertragungszeit aus der Abrechnung. Modal setzt beim Prozessstatus mit Snapshot-Wiederherstellung an, was beim Laden der Gewichte explizit nicht hilft. Wenn Ihr Kaltstart 140 GB an Gewichten umfasst, ist der Ansatz von Baseten der relevante; wenn es um Importe, JIT und CUDA-Graph-Capture geht, ist es der von Modal.
Methodik. Baseten veröffentlicht Minutenpreise für All-in-Instanz-SKUs – die GPU wird mit festen vCPU- und RAM-Kapazitäten geliefert. Modal veröffentlicht Sekundenpreise für die reine GPU, wobei CPU und Arbeitsspeicher separat abgerechnet werden. Um einen direkten Vergleich zu ermöglichen, rechnen wir beide auf Stundenbasis um (Baseten x60, Modal x3600) und addieren zu Modals GPU-Preis die CPU- und Speicherkosten, die bei Baseten bereits enthalten sind, basierend auf Modals eigenen Tarifen: 0,04716 $ pro physischer Kernstunde (ein Kern = zwei vCPU) und 0,007992 $ pro GiB-Stunde. Multiplikatoren für Pinning und nicht unterbrechbare Instanzen sind ausgeschlossen; deren Hinzunahme würde Modal noch teurer machen. Quellen: baseten.co/pricing, docs.baseten.co/deployment/resources, modal.com/pricing.
Für L40S und A100 40GB gibt es keine Baseten-SKU für einen Vergleich.
Das Fazit: „Modal ist bei H100 um 40 % günstiger“ schrumpft auf etwa 19 % sobald man vergleichbare CPU- und Speicherressourcen hinzurechnet, und liegt bei nahezu Gleichstand bei der A100 80GB, und kehrt sich bei kleinen GPUs um, wo Baseten 9–22 % günstiger ist. Mit Pinning oder dem 3-fachen Multiplikator für nicht-präemptive Instanzen gewinnt Baseten bei jeder garantierten Workload eindeutig.
Ein Stolperstein für Benchmarker: Modals bloßes gpu="A100" kann stillschweigend auf 80 GB aufgerüstet werden, und gpu="H100" kann auf einer H200 landen. Fixieren Sie es mit gpu="H100!".
1. Die Preisliste ist nicht die Rechnung. Teams kalkulieren ein Budget auf Basis eines GPU-Stundensatzes, stoßen dann aber auf CPU-, Speicher-, Volume- und Regions-Multiplikatoren sowie einen 3-fachen Sandbox-Tarif. Die Bündelung von Baseten ist einfacher zu prognostizieren; die Einzelaufstellung von Modal entspricht eher dem tatsächlichen Verbrauch. Ohne die oben genannte Rechnung ist beides nicht vergleichbar.
2. Die Regionswahl ist nicht gleichbedeutend mit Datenresidenz. Modal fixiert einen Container zwar auf eu-west, speichert Ihre Logs, den dauerhaften Speicher und jegliche Payloads über 2 MiB jedoch weiterhin in den USA. Wenn ein Regulierungsbehörde nachfragt, ist die Container-Region nicht die Antwort.
3. Der Modellserver ist nur ein Teil des Systems. Sie benötigen außerdem kommerzielle Modell-APIs, Authentifizierung, Kostenzuordnung, Ratenbegrenzungen, Guardrails und einen Audit-Trail. Keine der beiden Plattformen deckt diese Ebene ab, und die Entscheidung für eine der beiden überlässt diesen Teil Ihnen.
Eine direkte Antwort statt eines konstruierten Dreikampfs. Baseten und Modal sind gehostete Inferenz-Clouds. TrueFoundry läuft in Ihrem eigenen Cloud-Account. Anderer Käufer, anderes Problem.
Sie beantworten die Frage: „Wie stelle ich dieses Modell bereit, ohne GPUs selbst zu betreiben?“ TrueFoundry beantwortet die Frage: „Wir haben bereits GPU-Kapazitäten, zugesagte Ausgaben oder regulatorische Anforderungen und benötigen eine Plattform auf unserer eigenen Infrastruktur.“ Wenn die erste Frage Ihre ist, kaufen Sie eines der beiden – der selbstgehostete Modus von Baseten bietet hier die größte Überschneidung.
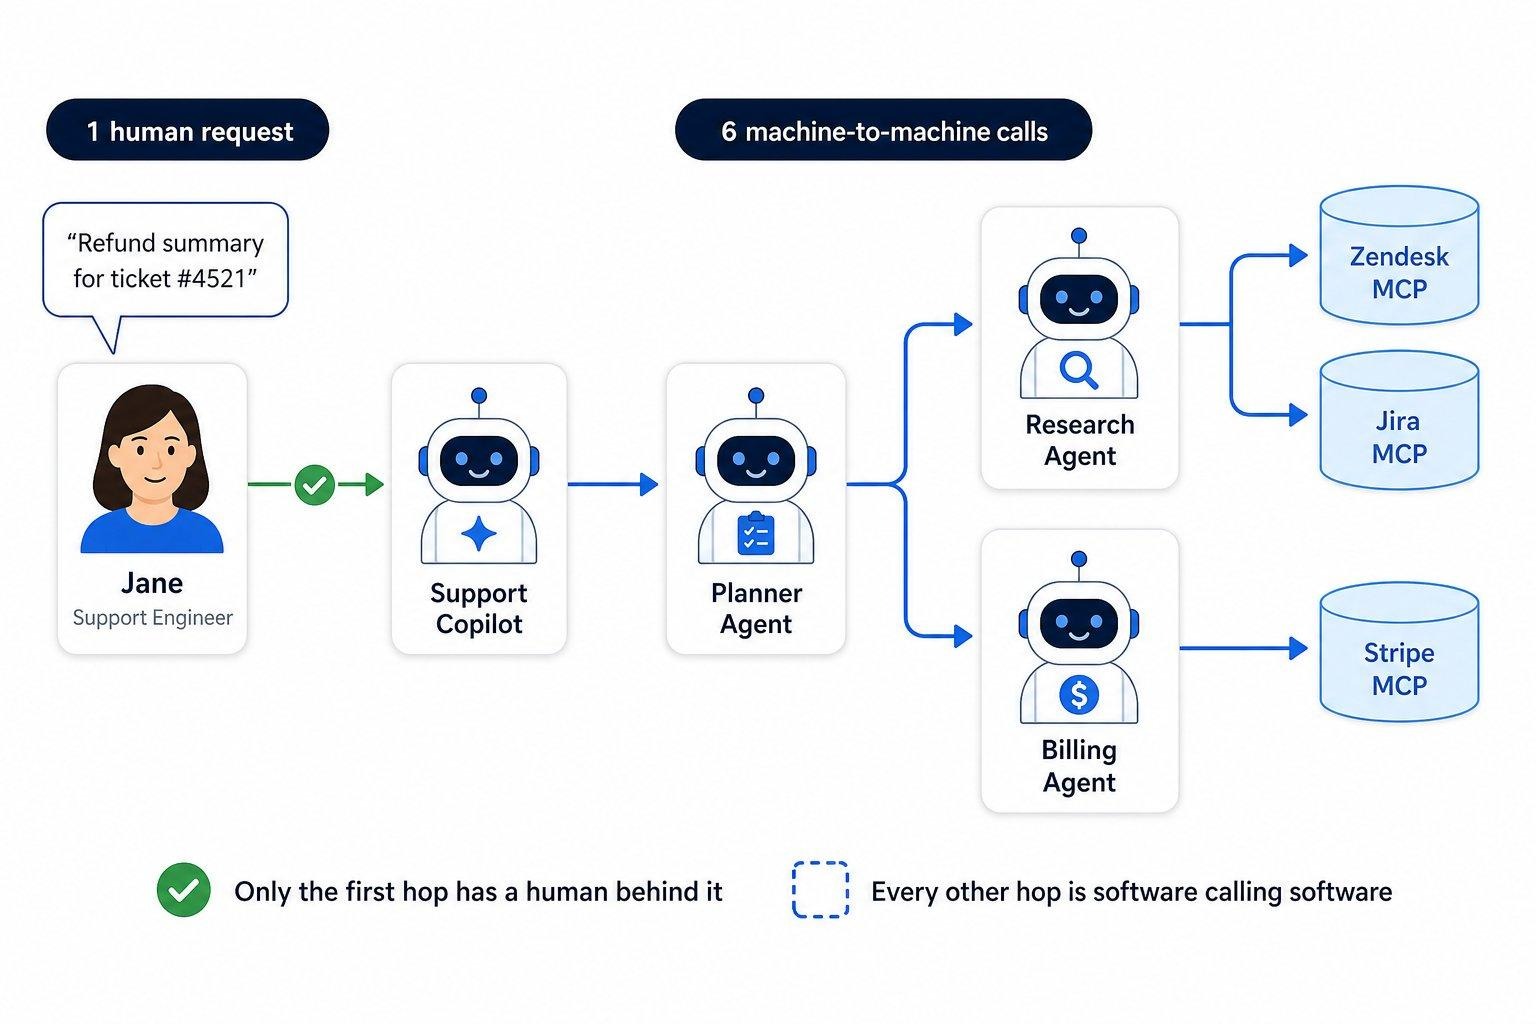
TrueFoundry lässt sich als SaaS in über 12 Regionen auf drei Clouds bereitstellen, oder selbst gehostet in Ihrer VPC via Helm und OpenTofu/Terraform, oder On-Premise, oder in Air-Gapped-Umgebungen. Bei der Selbst-Hosting-Variante bleibt der gesamte LLM-Traffic innerhalb Ihrer Infrastruktur und TrueFoundry befindet sich nicht im Live-Pfad. Das Serving umfasst vLLM, SGLang, Triton, TorchServe, MLflow und LitServe sowie eine Modell-Registry, Autoscaling nach CPU, RPS oder Cron und fraktionierte GPUs mittels Time-Slicing und MIG – was wichtig ist, wenn Sie die Hardware besitzen und eine ganze H100 für ein kleines Modell Verschwendung wäre.
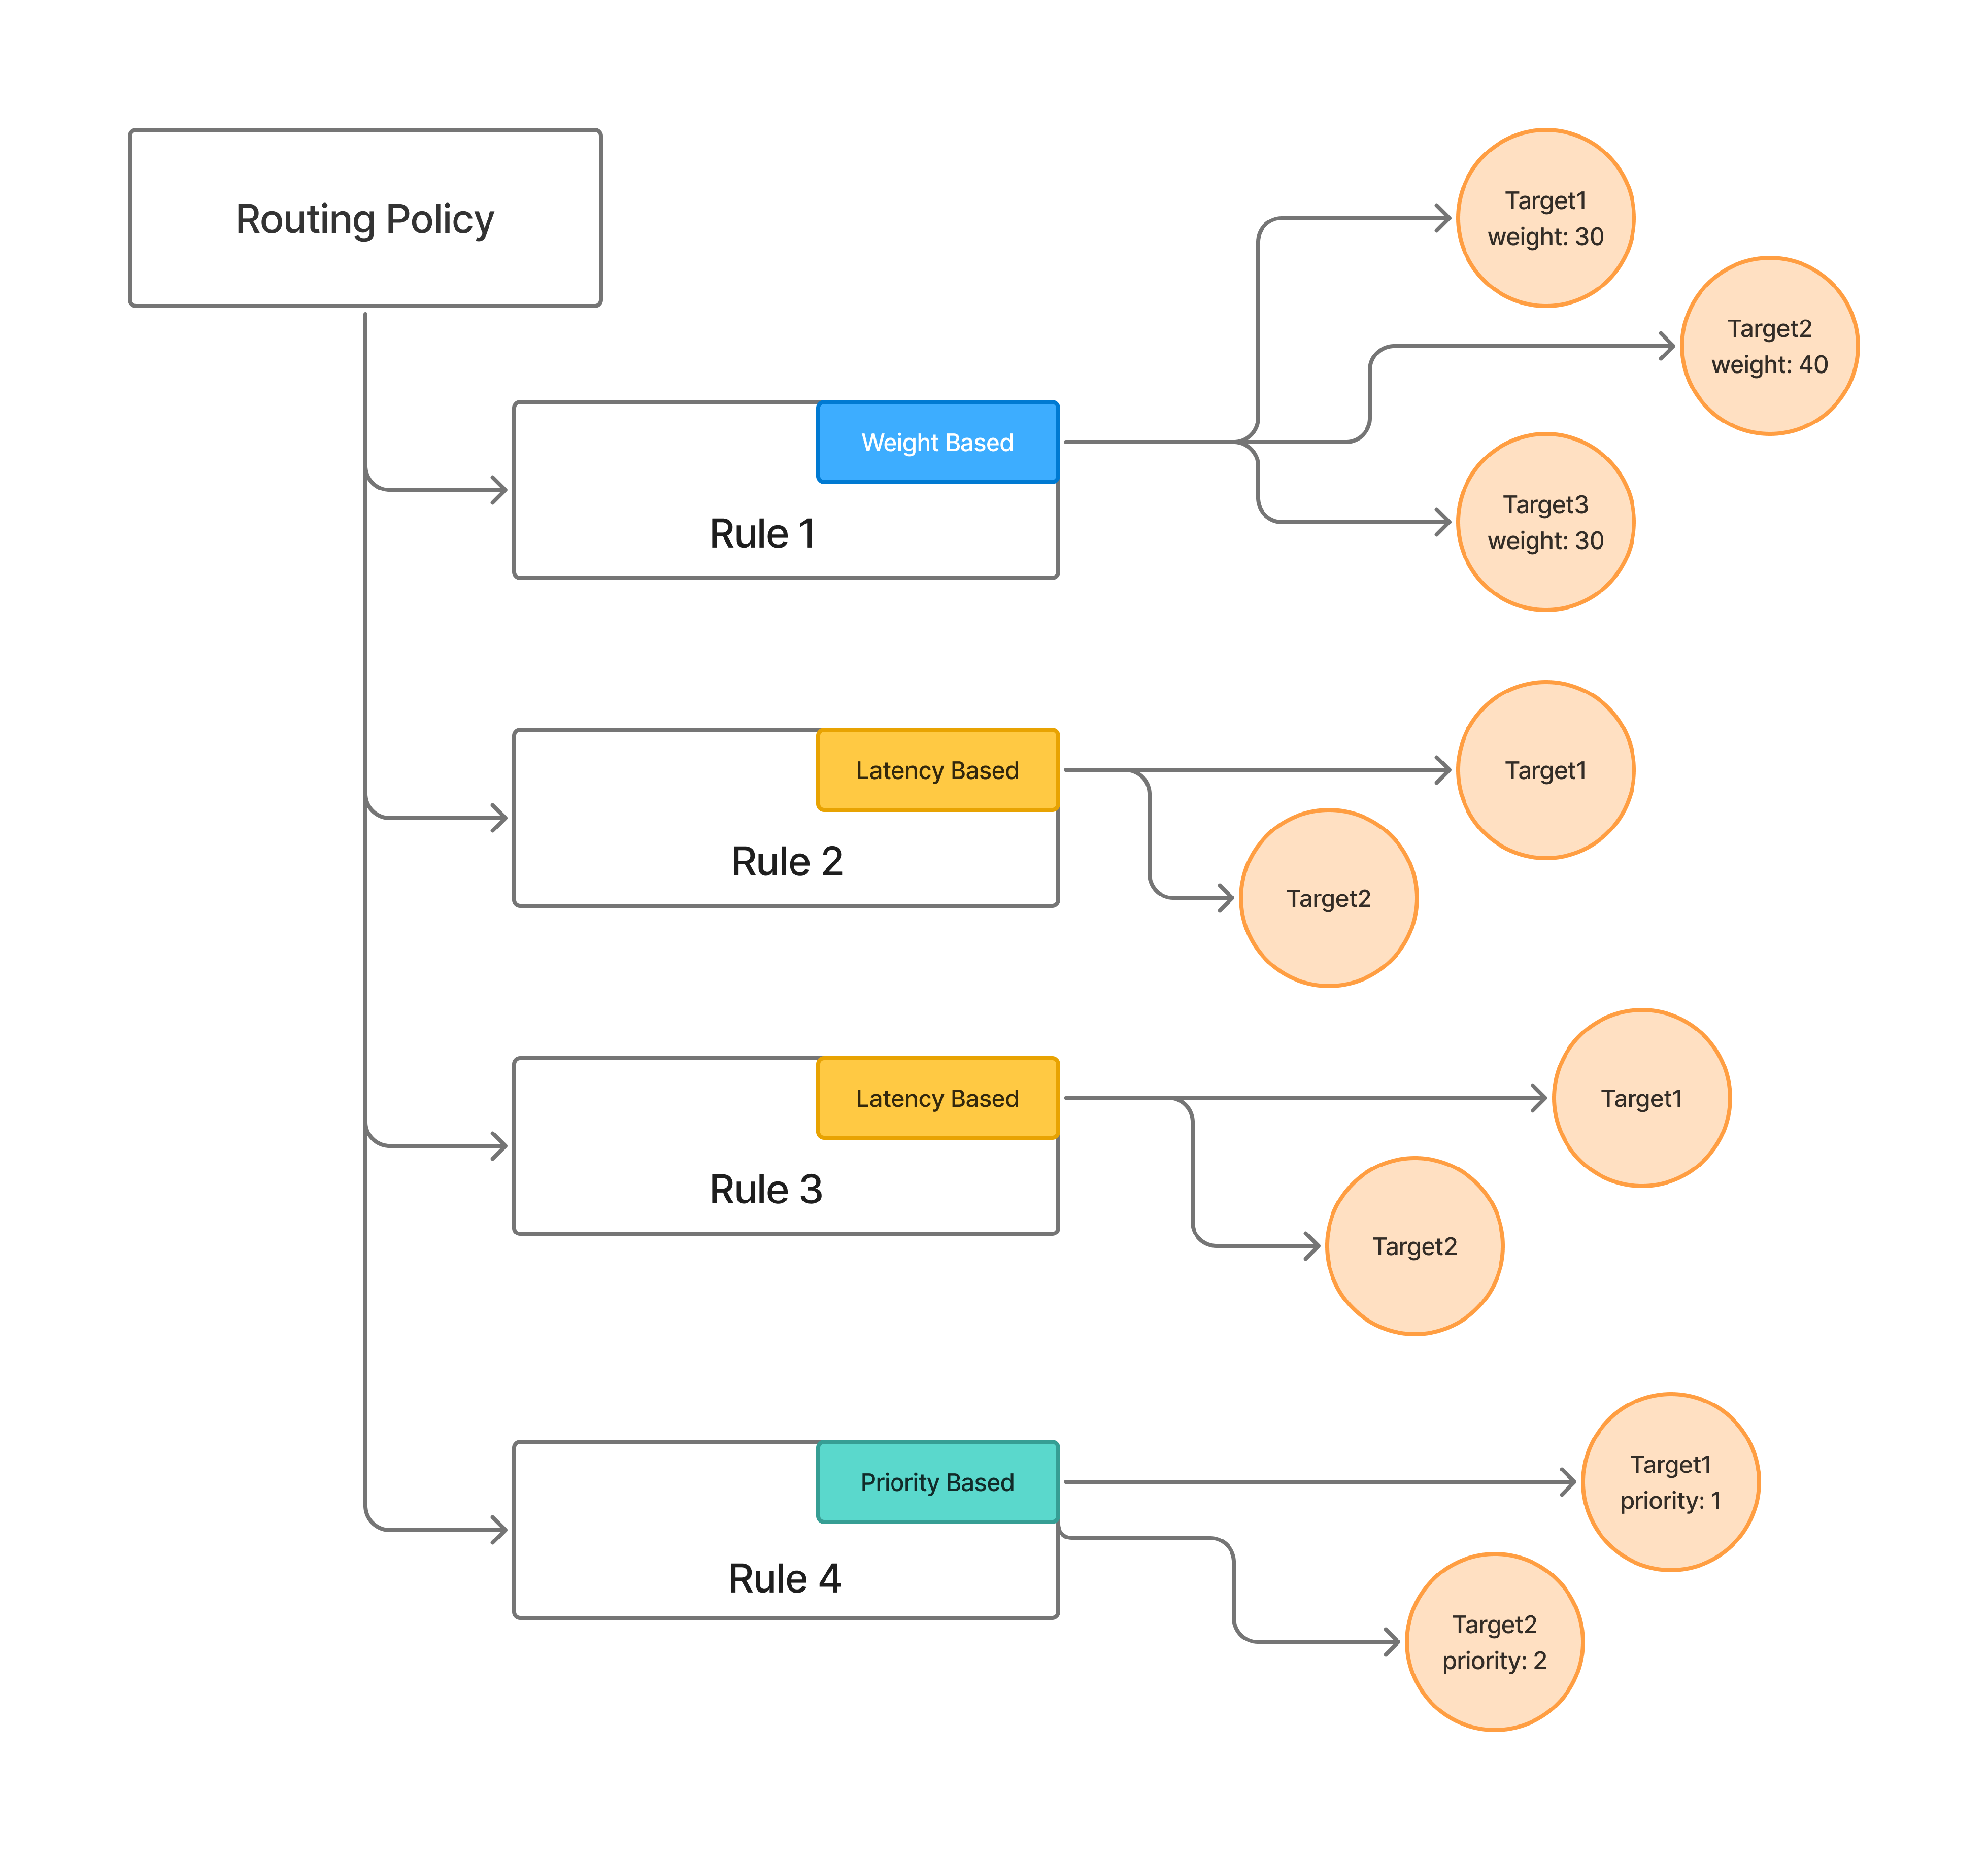
Die andere Hälfte ist das AI Gateway, bei dem selbst gehostete und gehostete Inferenz keine getrennten Probleme mehr darstellen. Es schaltet sich vor über 1.000 LLMs hinter einer OpenAI-kompatiblen API, fügt etwa 3-4 ms Latenz hinzu und bewältigt über 350 RPS auf 1 vCPU, sodass Ihr Baseten-Endpunkt, Ihr Modal-Endpunkt und Ihr OpenAI-Key hinter einer einzigen Schnittstelle mit gemeinsamer Kostenzuordnung, Ratenbegrenzung und Audit-Trail liegen. Auto-Routing ist der Kostenhebel: Bei 550 Prompts konnten die Kosten durch komplexitätsbasiertes Routing um 69 % gesenkt werden, bei gleichzeitiger Beibehaltung von 98 % der Qualität, wobei die durchschnittliche Latenz von 7,6 s auf 4,0 ssank.
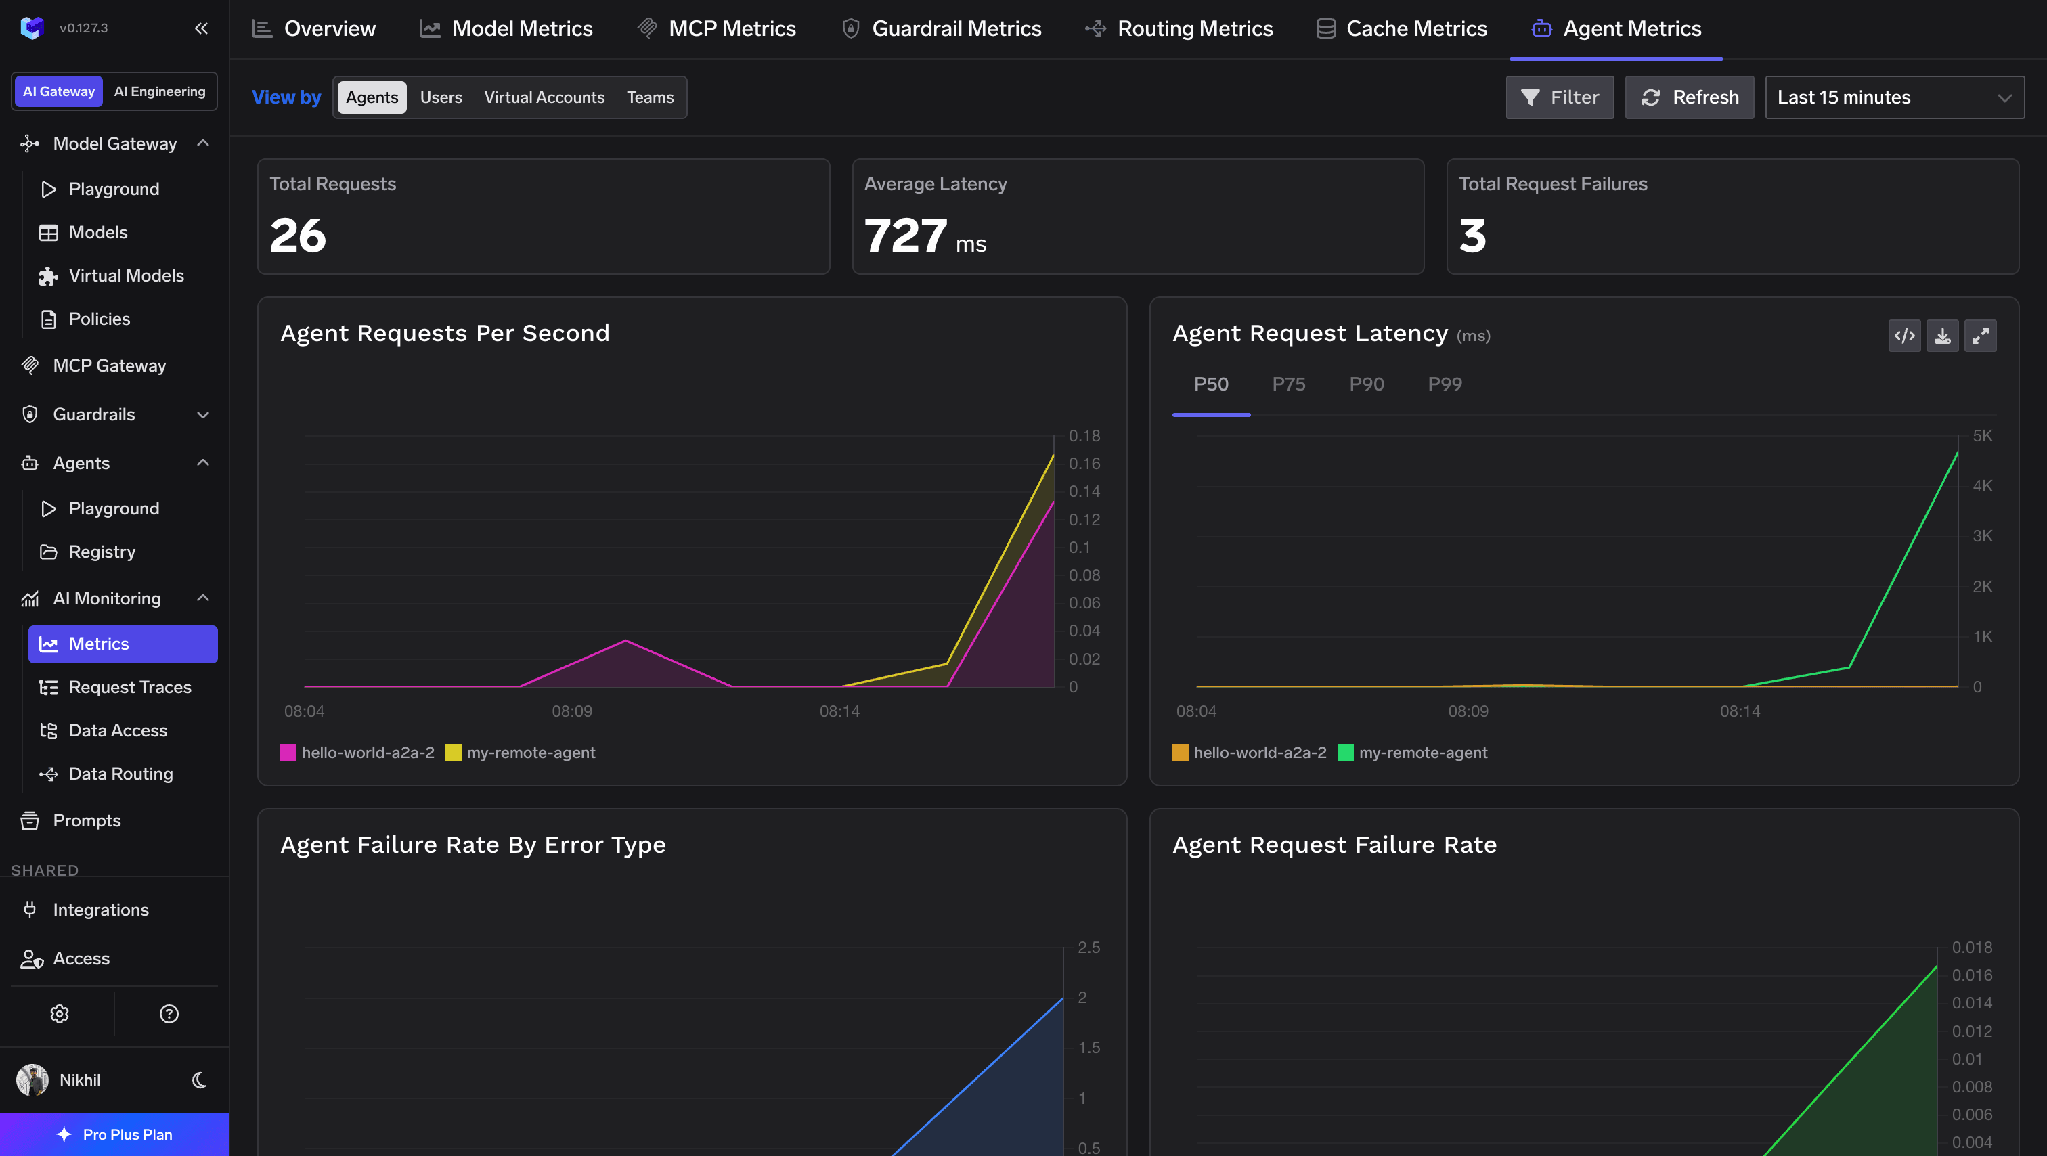
Ehrlicher Hinweis: TrueFoundry ist kein serverloser GPU-Marktplatz – Sie bringen die Kapazität mit. Wenn Sie keine GPUs haben und auch keine anschaffen möchten, wählen Sie stattdessen Baseten oder Modal.
Baseten und Modal sind beide gut. Der Vergleich ist bei dem Punkt, den die meisten zuerst prüfen – dem Preis – eng, aber bei den entscheidenden Faktoren für die Beschaffung liegen sie weit auseinander.
Wenn die Workload in Ihrer eigenen VPC laufen muss, Sie PHI verarbeiten, TensorRT-LLM ohne den Engine-Aufwand nutzen möchten oder kleine, fest zugewiesene GPUs betreiben, ist Baseten die richtige Wahl. Wenn Sie Sandboxes, Batch-Verarbeitung und Notebooks neben der Inferenz benötigen oder Python-Ergonomie für Sie an erster Stelle steht, ist Modal die Lösung.
Wir würden die Entscheidung nicht allein vom GPU-Listenpreis abhängig machen. Dieser ist zwischen den beiden Anbietern nicht direkt vergleichbar; bei einer korrekten Berechnung schrumpft ein scheinbarer Vorteil von 40 % auf 19 %, auf Gleichstand oder kehrt sich sogar zugunsten des anderen Anbieters um.
Wenn die eigentliche Einschränkung darin besteht, dass die Workload innerhalb Ihrer bereits vorhandenen und bezahlten Infrastruktur bleiben muss, ist keine der gehosteten Plattformen die richtige Lösung. Das ist ein Problem der Control Plane, und genau dafür entwickeln wir unsere Lösung.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Das hängt von der GPU ab, und die veröffentlichten Preise führen in die Irre. Nach den Listenpreisen wirkt Modal bei H100 und A100 80 GB um 37–40 % günstiger. Rechnet man CPU und Arbeitsspeicher hinzu, die Baseten bündelt, schrumpft der Abstand bei der H100 auf etwa 19 %, bei der A100 80 GB herrscht Gleichstand, und bei T4 und A10 ist Baseten um 9–22 % günstiger. Die Multiplikatoren von Modal für Pinning und nicht unterbrechbare Kapazität verschieben das Bild weiter zugunsten von Baseten, und die Team-Gebühr von 250 $/Monat sind Fixkosten, die Baseten nicht erhebt.
Starter 0 $/Monat mit 30 $/Monat kostenloser Rechenleistung; Team 250 $/Monat mit 100 $/Monat kostenloser Rechenleistung; Enterprise individuell. Rechenleistung wird sekundengenau und aufgeschlüsselt abgerechnet: GPU zum eigenen Preis, CPU zu 0,04716 $ pro physischer Kernstunde, Arbeitsspeicher zu 0,007992 $ pro GiB-Stunde. Sandbox- und Notebook-Rechenleistung kostet das Dreifache des Function-Preises, und für Pinning sowie nicht unterbrechbare Kapazität gelten Multiplikatoren.
Basic kostet 0 $/Monat im Pay-as-you-go-Modell ohne Plattformgebühr, einschließlich SOC 2 Type II und HIPAA; Pro und Enterprise gibt es auf Anfrage. GPU-Rechenleistung wird pro Minute nach All-in-Instanz-SKUs abgerechnet, die vCPU und RAM bündeln – 6,4998 $/Std. für eine H100 mit 80 GB. Die Preise pro Token für die Model API sind veröffentlicht; die Höhe des Gratisguthabens nicht.
Container starten in etwa einer Sekunde, und Memory Snapshots liefern laut Modals Dokumentation 3- bis 10-mal schnellere Wiederherstellungen. Die Angabe „100x“ in Modals Beitrag zur Series C wird durch die eigene Dokumentation nicht gestützt, planen Sie also mit 3–10x. GPU-Snapshots sind im Alpha-Stadium und beschleunigen das Laden von Gewichten aus dem Speicher nicht.
Nicht bestätigt. Die letzte von Baseten veröffentlichte Bewertung liegt bei 13 Mrd. $, aus einer Series F über 1,5 Mrd. $ vom 22. Juni 2026. Presseberichte von Ende September 2026 beschreiben Gespräche über eine größere Runde, aber dabei handelt es sich um Berichte über Gespräche, und das Unternehmen hat nichts veröffentlicht.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















