October 31, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die KI-Preise pro Token sind bei vielen Modellen gesunken, dennoch steigen die KI-Kosten in Unternehmen weiter an. Dies liegt daran, dass KI-Workloads über einfache Einzelabfragen hinausgehen. Moderne generative KI-Systeme unterstützen heute Agenten, Tool-Aufrufe, Wiederholungsversuche, multimodales Reasoning und lang laufende Workflows.
Eine einzelne Benutzeranfrage kann heute mehrere Modellaufrufe für Planung, Tool-Nutzung, Validierung und Antwortgenerierung auslösen. Aktuelle Untersuchungen zu agentischen Programmieraufgaben haben ergeben, dass Agenten weitaus mehr Token verbrauchen können als einfache Code-Chats oder Code-Analysen, wobei die Werte zwischen den Durchläufen stark schwanken. Dies macht das Kostenmanagement schwieriger als bei der herkömmlichen Cloud-Budgetierung.
Der Enterprise-KI-Bericht 2026 von Deloitte zeigt, dass der Zugriff der Mitarbeiter auf genehmigte KI-Tools im Jahr 2025 um 50 % gestiegen ist. Zudem wurde festgestellt, dass Unternehmen innerhalb weniger Monate mit einem starken Anstieg von KI-Projekten im Produktionsmaßstab rechnen. Dieser Wandel macht KI-Kostenoptimierung zu einem Thema für die Geschäftsführung und nicht mehr nur zu einer technischen Aufräumaufgabe.
Dieser Leitfaden erläutert die praktischen Optimierungsstrategien, die Unternehmensteams 2026 benötigen. Er behandelt Token-Ausgaben, GPU-Nutzung, Agenten-Schleifen, semantisches Caching, Kostenzuordnung und Kostensteuerung auf Gateway-Ebene. Zudem wird erklärt, wie TrueFoundry Teams dabei unterstützt, die KI-Kostenoptimierung durchzusetzen, bevor die Ausgaben außer Kontrolle geraten.
KI-Ausgaben wachsen selten in einer sauberen, vorhersehbaren Linie. Frühe Experimente wirken überschaubar, da die Nutzung begrenzt bleibt. Die Produktion ändert die Gleichung, da Teams Agenten, Workflows, KI-Anwendungen, Retrieval, Monitoring und eine abteilungsübergreifende kontinuierliche Nutzung hinzufügen.
Die Art der KI-Ausgaben unterscheidet sich zudem von gewöhnlichen Cloud-Kosten. Jede Anfrage kann Kosten für Modell, Token, Tools, Speicherung, Retrieval und Infrastruktur verursachen. Ohne Kostenüberwachung auf Anfrageebene sehen Teams die Rechnung erst, wenn der Verbrauch bereits stattgefunden hat.
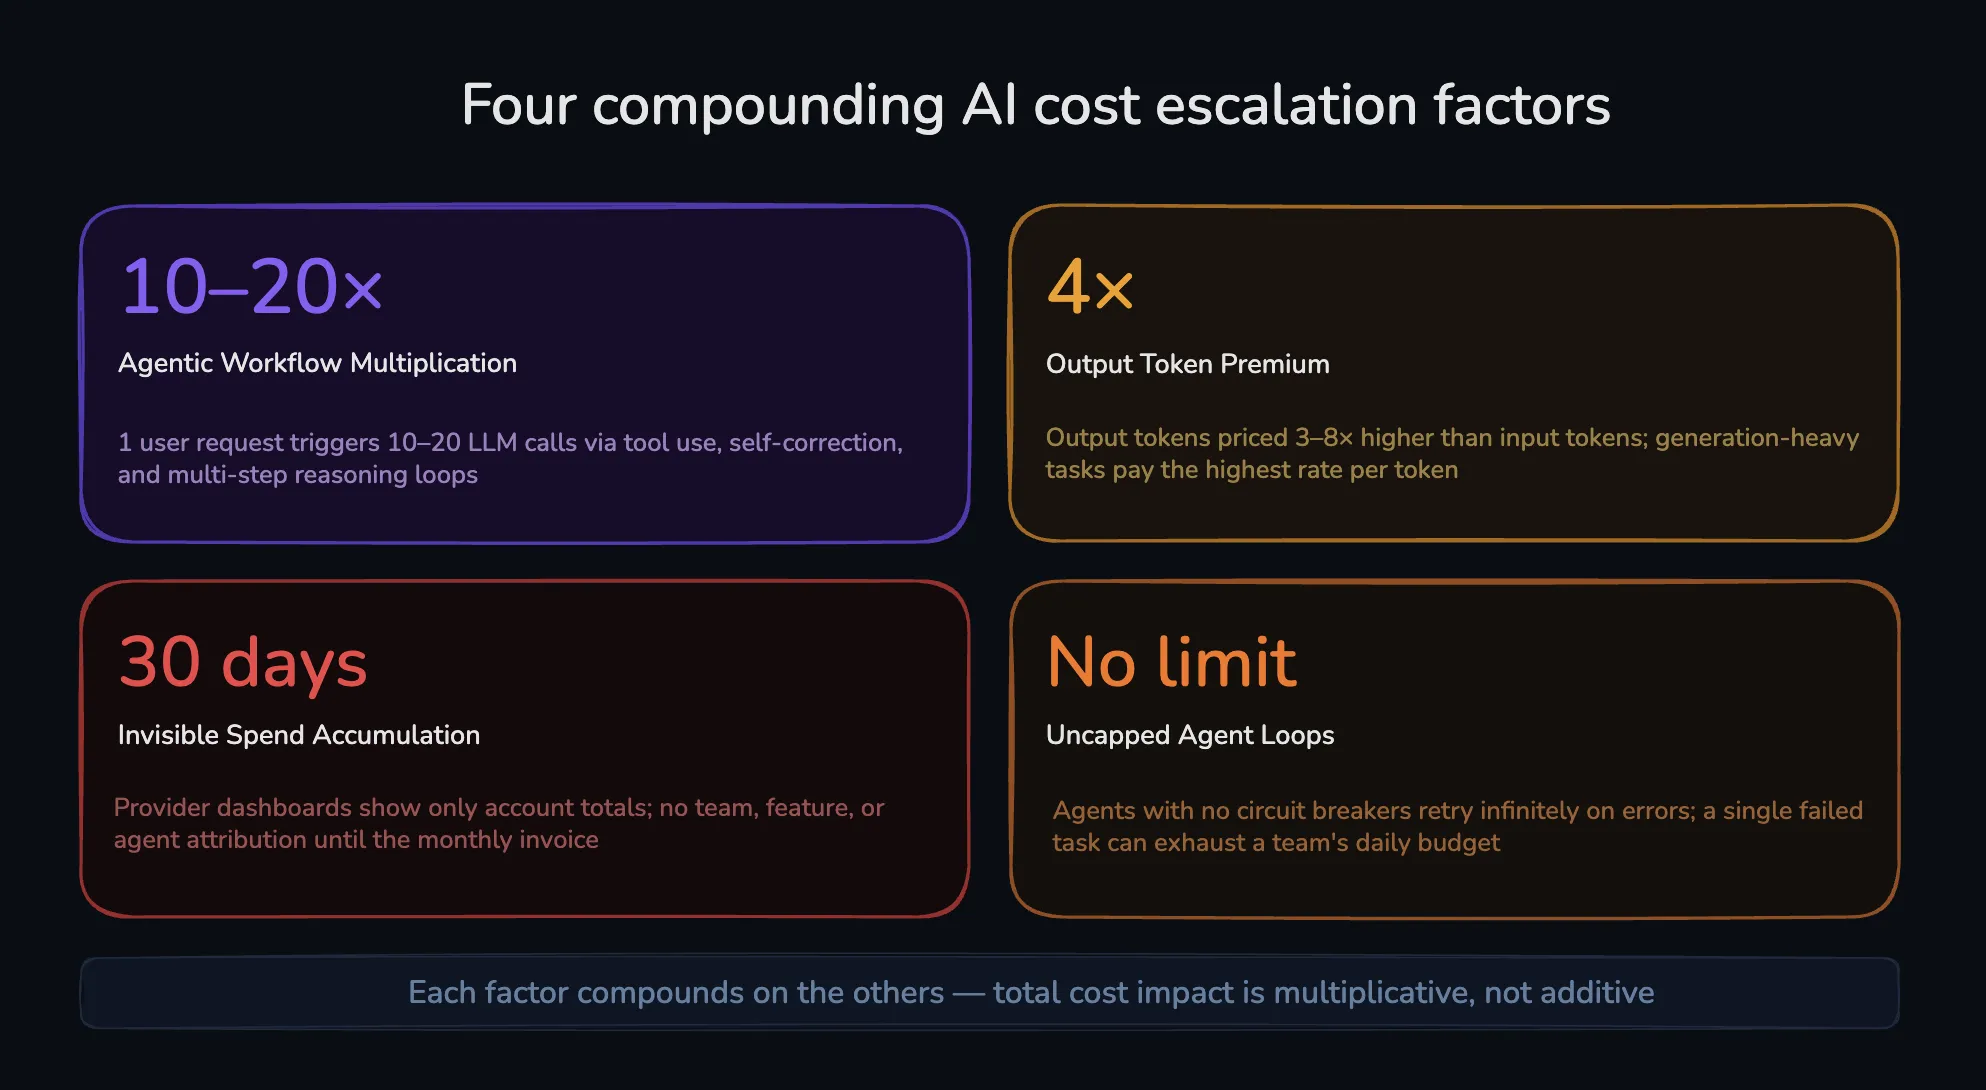
Chatbots verarbeiten normalerweise eine Anfrage nach der anderen. Agentische Workflows verhalten sich anders. Eine Aufgabe kann Planung, Tool-Aufrufe, Ergebnisprüfung, Wiederholungen bei Fehlern und Korrekturen der Ausgaben umfassen. Jeder Schritt kann eine neue Modellanfrage erzeugen.
Das Ergebnis ist, dass eine Anfrage in viele Inferenzen übersetzt wird. Jeder Schritt kann den Kontext durch vorherige Ausgaben, Tool-Ergebnisse und den Gesprächsverlauf erweitern. Dies erhöht den Token-Verbrauch und steigert die Betriebskosten für Agenten, Copiloten und Workflow-Automatisierungen.
Agentische KI führt zudem zu einer unvorhersehbaren Ressourcennutzung. Ein Workflow kann in einem Durchlauf schnell abgeschlossen sein und im nächsten weitaus mehr Token verbrauchen. Untersuchungen zeigen, dass der Token-Verbrauch bei identischen agentischen Aufgaben stark variieren kann, was proaktive Kontrollen unerlässlich macht.
Viele Modelle berechnen für Ausgabe-Token höhere Preise als für Eingabe-Token. Das bedeutet, dass die Antwort oft mehr kostet als die Anfrage. Langform-Generierungen, Zusammenfassungen, Berichte, Kundenantworten und mehrstufige Reasoning-Ausgaben können die Ausgaben schnell in die Höhe treiben.
Dies ist wichtig, da Teams oft die Prompts optimieren, aber die Ausgabegröße ignorieren. Das Large Language Model erhält möglicherweise eine kompakte Anweisung und generiert dennoch eine lange Antwort. Begrenzungen der Ausgabelänge, strukturierte Antworten und prägnante Formatierungen können die Kosten senken, ohne die Benutzererfahrung zu beeinträchtigen.
Dashboards der Anbieter zeigen oft nur die Ausgaben auf Kontoebene. Sie bieten in der Regel keine klare Aufschlüsselung nach Teams, Anwendungen, Funktionen oder Agenten. Dies schwächt die Kostentransparenz und macht plötzliche Kostenspitzen schwer erklärbar.
Ohne Zuordnung pro Anfrage können Finanzteams Ausgaben nicht mit Geschäftszielen verknüpfen. Die Technik kann teure Workflows nicht schnell identifizieren. Produktteams können den geschäftlichen Nutzen nicht gegen die Modellkosten abwägen. Finanzielle Verantwortlichkeit erfordert ein Tagging auf Ausführungsebene, nicht nur monatliche Berichte.
Autonome Agenten führen während der Ausführung Wiederholungsversuche, Validierungen und Selbstkorrekturen durch. Diese Verhaltensweisen sind kontrolliert nützlich, aber unkontrolliert kostspielig. Ein fehlgeschlagener Tool-Aufruf kann zu wiederholten Versuchen, einer unnötigen Erweiterung des Kontextes und überflüssigen Inferenzzyklen führen.
Ohne Schutzschaltungen oder Ausgabenlimits auf Aufgabenebene kann ein einzelner Agent schnell ein hohes Token-Budget verbrauchen. Ein fehlerhafter Workflow kann hohe Kosten verursachen, bevor das Team überhaupt eine Warnung erhält. Hier werden straffe Budgets und eine Kostenkontrolle zur Laufzeit unverzichtbar.
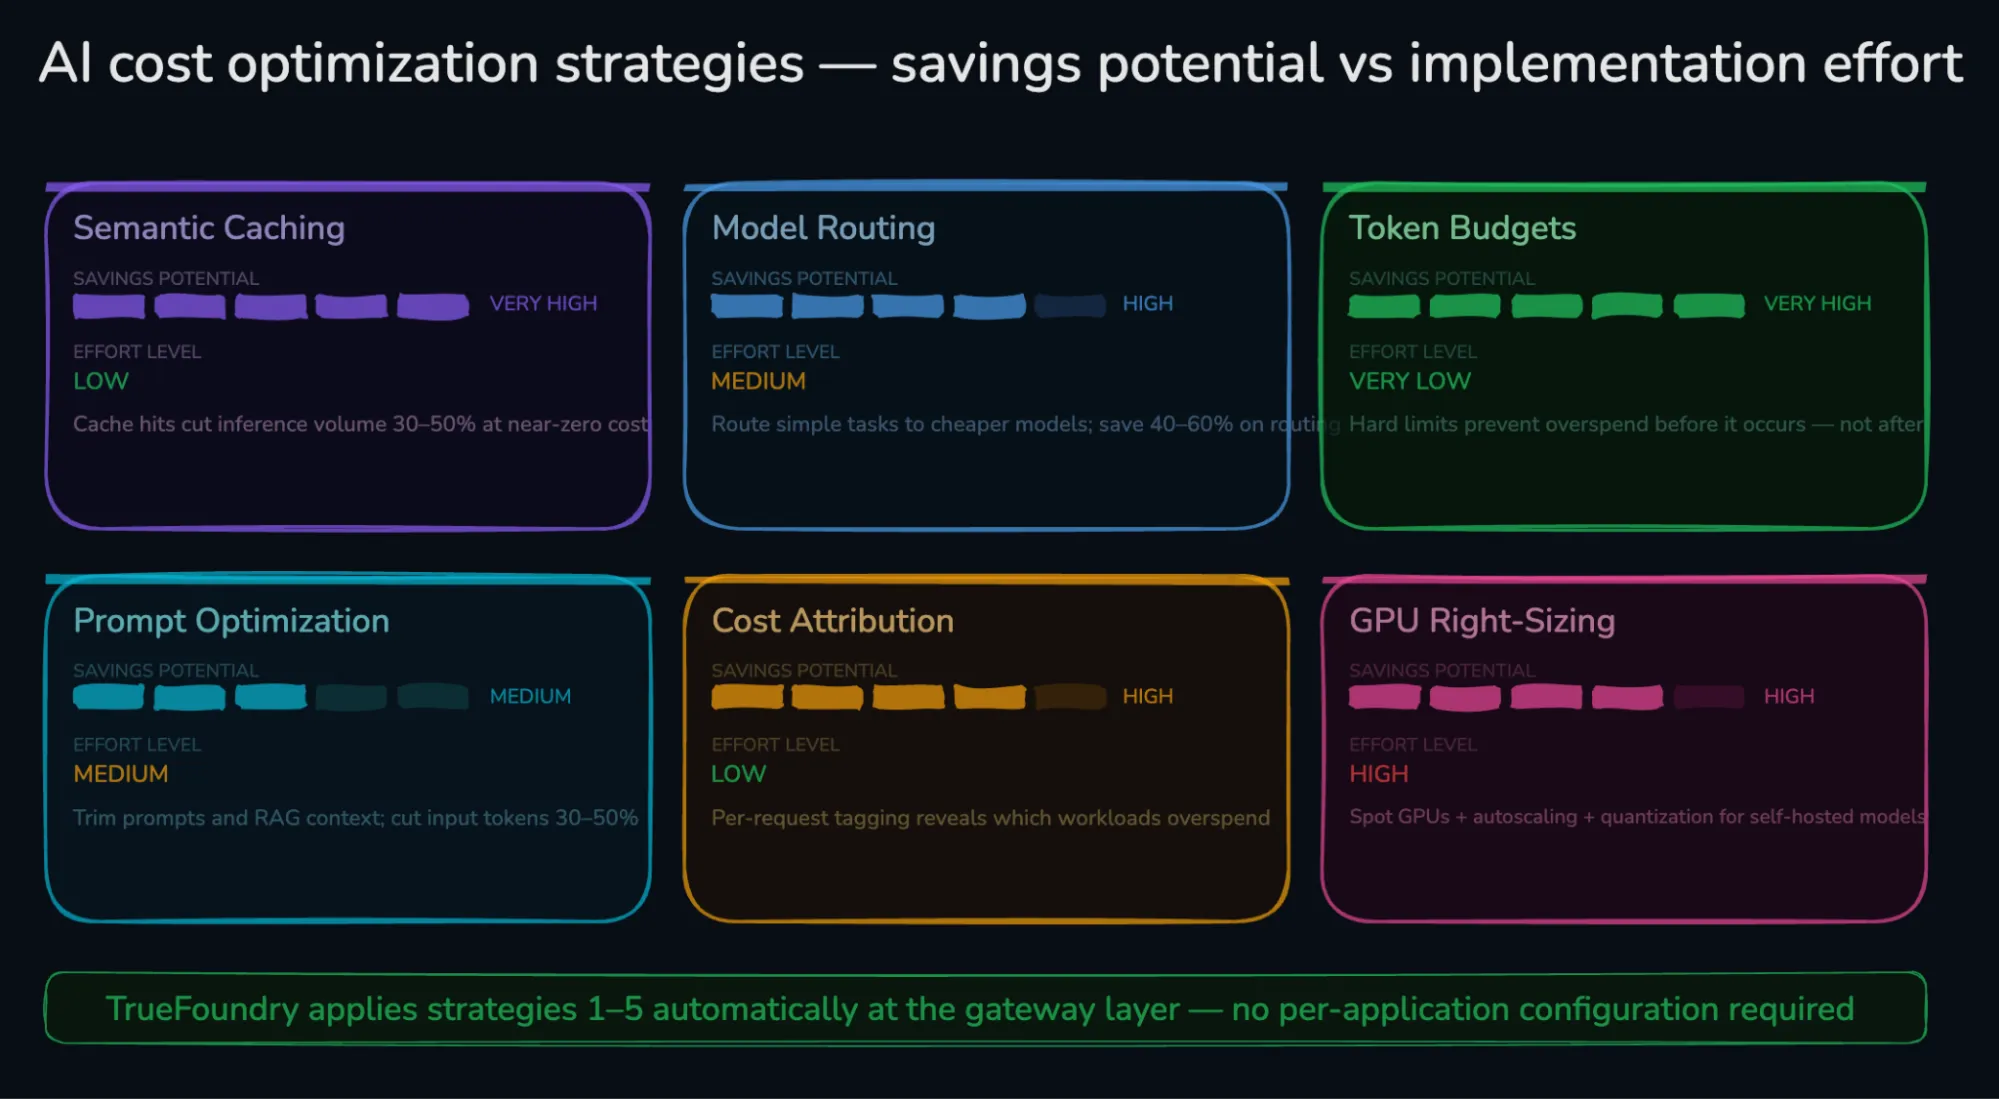
Die Optimierung von KI-Ausgaben erfordert mehr als nur Dashboards. Die besten Strategien zur KI-Kostenoptimierung setzen auf der Ausführungsebene an. Sie entscheiden, welches Modell verwendet wird, wann gecacht wird, wie viel Kontext übergeben wird und wann teure Workflows blockiert werden sollen.
Nicht jede Anfrage erfordert das teuerste KI-Modell. Klassifizierungen, Extraktionen, einfache Fragen und Antworten sowie Formatierungsaufgaben können oft von kleineren Modellen übernommen werden. Spitzenmodelle sollten komplexen Schlussfolgerungen, risikoreichen Ergebnissen und Aufgaben vorbehalten bleiben, die einen tieferen Kontext erfordern.
Dieser Ansatz bei der Modellauswahl fördert eine höhere Kosteneffizienz, ohne die Qualität zu beeinträchtigen. Teams können Aufgaben nach Komplexität, Latenzanforderungen, Risikostufe und Ergebniswert steuern. Der beste Ort für das Routing ist die Gateway-Ebene, damit jede Anwendung davon profitiert.
Das TrueFoundry LLM Gateway hilft Teams dabei, das Modell-Routing über verschiedene Anbieter und selbst gehostete Modelle hinweg zu zentralisieren. Dies erleichtert die Modelloptimierung über Teams, Anwendungen und Produktionsumgebungen hinweg.
Viele Unternehmens-Prompts ähneln semantisch früheren Anfragen. Semantisches Caching erkennt Ähnlichkeiten auf Bedeutungsebene und gibt bei Bedarf zwischengespeicherte Antworten zurück. Dies reduziert den Token-Verbrauch, die Latenz, die Anbieterkosten und wiederholte Modellaufrufe.
Semantisches Caching eignet sich hervorragend für Kundensupport, interne Suche, Richtlinien-Q&A, Dokumentationsassistenten und sich wiederholende Anwendungsfälle. TrueFoundry erläutert, dass semantisches Caching im Anforderungspfad vor der Modellinferenz platziert werden kann, was dazu beiträgt, wiederholte Aufrufe zu reduzieren.
Budgetwarnungen sind reaktiv. Token-Budgets sind proaktiv, da sie Anfragen blockieren oder umleiten, bevor übermäßige Ausgaben entstehen. Effektive Token-Budgets lassen sich nach Team, Anwendung, Umgebung, Benutzer, Modell und individuellem Agenten-Workflow anwenden.
Gute Strategien für Token-Budgets umfassen:
Dies verlagert das Kostenmanagement von der nachträglichen Rechnungsprüfung hin zur aktiven Ausführungssteuerung. Zudem wird die Kostensenkung verbessert, da Teams Verschwendung stoppen können, bevor sie Teil der monatlichen Betriebskosten wird.
Ein Teil der unnötigen KI-Ausgaben entsteht durch zu umfangreiche Prompts und zu große Kontextfenster. RAG-Pipelines rufen oft zu viele Dokumente ab. Lange Verläufe, wiederholte Systemanweisungen und redundante Kontextblöcke können den Verbrauch an Eingabe-Tokens in die Höhe treiben.
Effektive Verbesserungen sind unter anderem:
Kontrollen für Prompts und Kontext verbessern die Modellleistung und senken die Kosten pro Anfrage. Kleine Einsparungen bei der Token-Anzahl summieren sich bei Workflows mit hohem Volumen. Diese Kontrollen gehören zu den praxisorientiertesten Strategien zur Kostenoptimierung bei großen KI-Unternehmenseinsätzen.
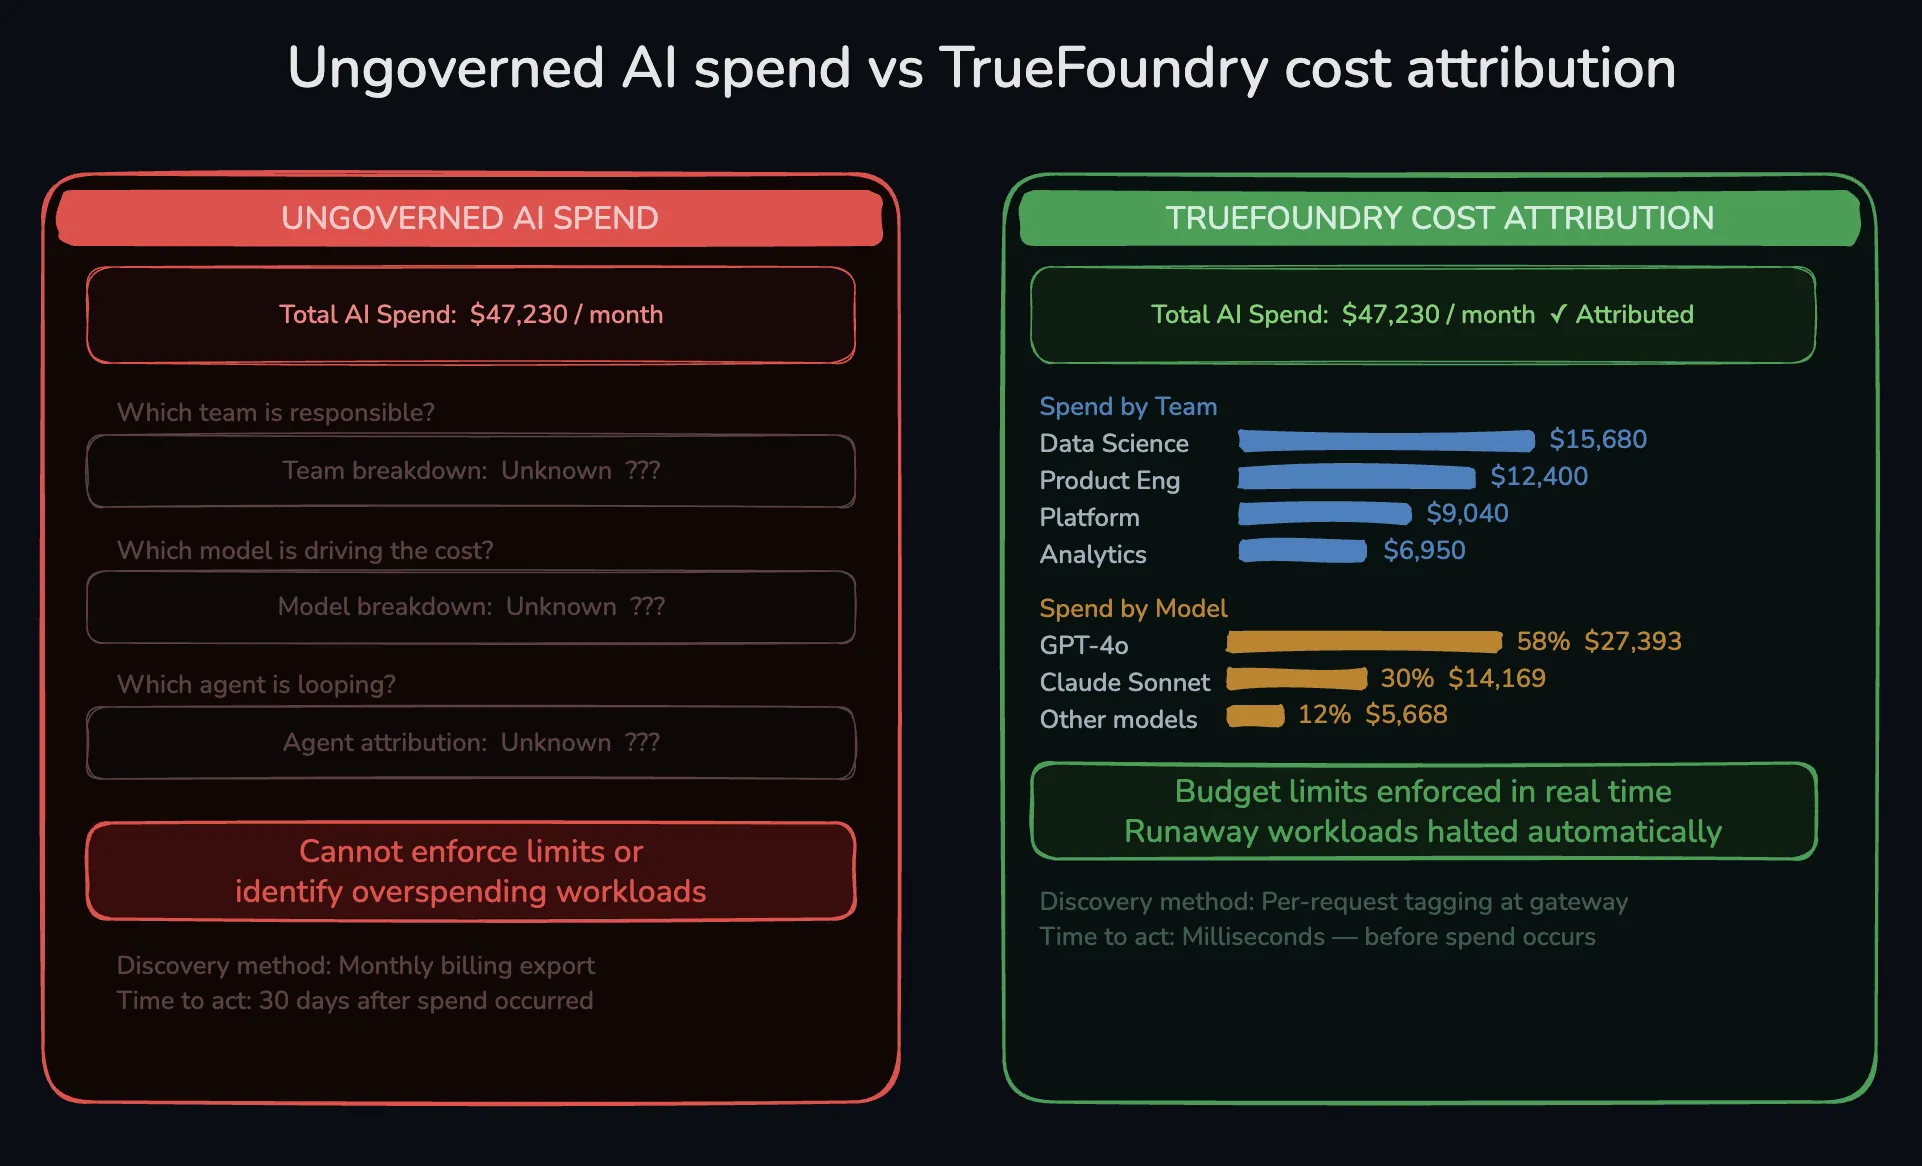
KI-Ausgaben werden zum schwarzen Loch, wenn die Zuordnung pro Anfrage fehlt. Dashboards der Anbieter zeigen die Gesamtausgaben auf Kontoebene. Sie zeigen jedoch selten, welches Team, welcher Agent, welche Funktion, Umgebung oder welcher Workflow die Kosten verursacht hat.
Die Zuordnung auf Ausführungsebene sollte Folgendes erfassen:
Damit wird das Cloud-Kostenmanagement in den täglichen Betrieb integriert. Zudem werden KI-Ausgaben mit Geschäftszielen, KI-Investitionen und messbarem geschäftlichem Mehrwert verknüpft. Ohne eine klare Zuordnung können Teams Kosteneinsparungen nicht dauerhaft im großen Maßstab aufrechterhalten.
Leerlaufende GPUs sind ein wesentlicher Kostentreiber für Teams, die Modelle hosten. Überdimensionierte Rechenressourcen kosten auch dann Geld, wenn die Auslastung gering ist. Daher sind GPU-Dimensionierung, Autoscaling und Scheduling zentrale Aspekte der KI-Infrastrukturplanung.
Nützliche Optionen sind:
Die richtige Dimensionierung senkt Infrastrukturkosten, Betriebsausgaben und die Verschwendung von ungenutzten Rechenressourcen. Zudem ermöglicht sie ein besseres Ressourcenmanagement für Training, Inferenz, Batch-Verarbeitung und Experimente.
Viele Teams implementieren Kontrollen für KI-Ausgaben innerhalb einzelner Anwendungen. Das kann zwar für eine bestimmte Arbeitslast helfen, lässt jedoch die unternehmensweiten Risiken ungelöst. Die gleiche Logik für Routing, Caching, Budgetierung und Zuordnung muss dann von mehreren Teams immer wieder neu entwickelt werden.
Zu den häufigsten Problemen gehören:
Das Problem ist architektonischer Natur. Die nachhaltigsten Strategien zur KI-Kostenoptimierung setzen auf der Ausführungsebene an. Dort laufen bereits jede Modellanfrage, jeder Agentenschritt und jeder MCP-Tool-Aufruf zusammen.
Ein Gateway-basierter Ansatz ermöglicht es Teams, Richtlinien einmalig festzulegen und auf alle KI-Projekte anzuwenden. Dies schafft zudem eine konsistente Kostensteuerung, Anfragen-Tagging und Durchsetzung über alle Produktionssysteme hinweg.
TrueFoundry integriert Strategien zur KI-Kostenoptimierung direkt in die zentrale KI-Plattform. Anstatt jedes Team zu verpflichten, eigene Kontrollmechanismen zu entwickeln, implementiert TrueFoundry Routing, Caching, Budgets und Kostenstellenrechnung über das KI-Gateway.
Das Gateway fungiert als Schnittstelle zwischen Anwendungen, Modellen, Agenten und MCP-Tools. Dies bietet Teams eine einheitliche Durchsetzungsebene für KI-Infrastruktur, KI-Systeme und agentische Ausführung. Der Leitfaden zur KI-Kostenoptimierung von TrueFoundry hebt zudem teambezogene Token-Budgets, Routing-Richtlinien und Echtzeit-Kostenzuordnung hervor.
Durch die Zentralisierung von Kostenoptimierung, Routing, Caching, Budgets und Zuordnung sorgt TrueFoundry für konsistente Kontrollen über alle Anwendungsfälle hinweg. Dies bietet Unternehmen eine bessere finanzielle Governance, ohne dass jedes Anwendungsteam die Kostenlogik neu entwickeln muss.
Demo buchen und erfahren Sie, wie TrueFoundry die KI-Kosten für Modelle, Agenten und MCP-Tools senkt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet