



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wenn Teams LLM-Anwendungen und KI-Agenten in die Produktion überführen, werden die Kosten schnell zu einem der am schwierigsten zu durchschauenden Probleme. Im Gegensatz zu traditionellen Cloud-Workloads werden KI-Kosten durch Nutzungsmuster getrieben, die dynamisch, nicht-deterministisch und oft hinter mehreren Abstraktionsschichten verborgen sind.
Eine einzelne Benutzeranfrage kann mehrere Modellaufrufe, Retries, Werkzeugaufrufe und Agentenschleifen auslösen. Kleine Änderungen an Prompts, Routing-Logiken oder dem Agentenverhalten können die Token-Nutzung und die Kosten erheblich steigern – oft ohne offensichtliche Signale, bis die Abrechnungsberichte eintreffen.
Aus diesem Grund ist KI-Kostenobservabilität in Produktionssystemen von entscheidender Bedeutung. Sie geht über das bloße Verfolgen von Token-Zahlen oder Lieferantenrechnungen hinaus. KI-Kostenobservabilität konzentriert sich darauf, Kosten den tatsächlichen Einheiten von KI-Systemen wie Anfragen, Prompts, Agenten, Werkzeugen und Benutzern zuzuordnen und gleichzeitig Teams in die Lage zu versetzen, Kostenprobleme frühzeitig zu erkennen und zu steuern.
In diesem Blogbeitrag erklären wir, was KI-Kostenobservabilität in der Praxis bedeutet, warum KI-Kosten schwer nachzuverfolgen sind und wie Teams Gateway-basierte Architekturen nutzen, um LLM-Ausgaben in der Produktion zu überwachen und zu steuern.
KI-Kostenobservabilität ist die Fähigkeit, die Kosten von KI-Workloads über Modelle, Agenten und Arbeitsabläufe hinweg in Echtzeit zu messen, zuzuordnen und zu analysieren.
In Produktionssystemen umfasst dies typischerweise:
In der Praxis reicht dies über einfache Billing-Dashboards hinaus bis hin zu einer strukturierten LLM-Kostenverfolgungslösung, bei der Token-Nutzung, Retries, Routing-Entscheidungen und Agentenverhalten direkt mit den realen Anwendungsworkflows verknüpft sind.
Im Gegensatz zum traditionellen Infrastruktur-Kostenmonitoring muss KI-Kostenobservabilität auf der Anwendungs- und Inferenzschicht ansetzen. Cloud-Abrechnungstools können Teams zwar sagen, wie viel sie insgesamt ausgegeben haben, aber sie erklären nicht, warum die Kosten gestiegen sind oder welcher Teil des Systems dies verursacht hat.
Effektive KI-Kostenobservabilität liefert Teams den erforderlichen Kontext, um Fragen zu beantworten wie:
Indem Kosten auf dieser Ebene sichtbar gemacht werden, können Teams KI-Ausgaben als betriebliche Kennzahl betrachten und nicht als überraschende Ausgabe.
KI-Kosten sind nicht deshalb schwer nachzuverfolgen, weil die Preisgestaltung undurchsichtig ist, sondern weil Kosten eine emergente Eigenschaft des Systemverhaltens sind. In Produktionsumgebungen wird die LLM-Nutzung durch Routing-Logik, Retries, Agenten und Werkzeugaufrufe geprägt, die alle auf nicht offensichtliche Weise miteinander interagieren.
Mehrere Faktoren machen die KI-Kostenobservabilität für Teams zu einer Herausforderung.
Die meisten LLM-Anbieter rechnen auf Basis von Token ab, aber die Token-Nutzung reagiert äußerst sensibel auf das Laufzeitverhalten. Kleine Änderungen an Prompts, Kontextgrößen oder Ausgabebeschränkungen können die Token-Anzahl erheblich erhöhen. Da diese Änderungen oft auf der Anwendungs- oder Prompt-Ebene stattfinden, sind sie allein über die Abrechnung auf Anbieter-Ebene schwer zu erkennen.
Produktionssysteme verlassen sich selten auf ein einzelnes Modell. Teams routen Anfragen über mehrere Modelle und Anbieter hinweg, um Kosten, Latenz und Qualität gegeneinander abzuwägen. Ohne eine zentralisierte Sicht werden Kostendaten über verschiedene Anbieter hinweg fragmentiert, was einen ganzheitlichen Vergleich oder eine Optimierung der Ausgaben erschwert.
Fehler sind in KI-Systemen teuer. Retries und Fallback-Logiken können die Kosten stillschweigend vervielfachen, insbesondere wenn Anfragen kaskadenartig über mehrere Modelle hinweg weitergeleitet werden. Ohne Observabilität auf Anfrageebene entgehen Teams diese versteckten Kostenmultiplikatoren oft, bis sie in den Gesamtrechnungen auftauchen.
Agentenbasierte Systeme verstärken die Kostenkomplexität. Ein einziger Agentendurchlauf kann mehrere Modellaufrufe, Planungsschritte und Werkzeugaufrufe umfassen. Wenn ein Agent in eine Schleife gerät oder Werkzeuge übermäßig nutzt, können die Kosten rasch eskalieren. Die Verfolgung dieses Verhaltens erfordert Einblick darin, wie Agenten Schritt für Schritt ausführen.
Cloud-Kostentools und Anbieter-Dashboards berichten die Nutzung auf Konto- oder Projektebene. Sie ordnen die Kosten nicht einzelnen Prompts, Agenten, Benutzern oder Workflows zu. Dies macht es für Plattform-Teams schwierig, Budgets durchzusetzen, oder für Anwendungsteams, ihre eigene Nutzung zu optimieren.
In der Praxis bedeuten diese Herausforderungen, dass KI-Kostenprobleme oft erst spät erkannt und reaktiv angegangen werden. Aus diesem Grund benötigen Teams, die KI-Workloads in der Produktion betreiben, eine Kostenobservabilität, die direkt in das AI Gateway und den Ausführungspfad integriert ist, den alle Anfragen passieren.
Um die KI-Ausgaben in der Produktion zu steuern, benötigen Teams mehr als eine monatliche Gesamtrechnung. Sie müssen verstehen, woher die Kosten kommen und warum. Die Kostenobservabilität baut auf der LLM-Observabilität auf, indem sie die Token-Nutzung und die Ausgaben an Prompts, Agenten und Workflows bindet. Eine effektive KI-Kostenobservabilität schlüsselt die Ausgaben nach Dimensionen auf, die der tatsächlichen Struktur und dem Betrieb von KI-Systemen entsprechen.
Zu den nützlichsten Kostendimensionen gehören die folgenden.
Dies ist das Fundament. Die Nachverfolgung der Kosten pro Anfrage hilft Teams zu verstehen, wie teuer einzelne Benutzerinteraktionen sind und wie sich diese Kosten im Laufe der Zeit verändern. Spitzen an dieser Stelle deuten oft auf ein Wachstum der Prompts, auf Retries oder Routing-Änderungen hin.
In Multi-Modell-Systemen weisen verschiedene Modelle sehr unterschiedliche Kostenprofile auf. Teams benötigen Transparenz darüber, wie viel Ausgaben in jedes Modell und jeden Anbieter fließen und wie sich Routing-Entscheidungen auf die Gesamtkosten auswirken. Dies ist unerlässlich, um fundierte Kompromisse zwischen Qualität, Latenz und Ausgaben einzugehen.
Prompts beeinflussen die Token-Nutzung direkt. Die Nachverfolgung der Kosten nach Prompt und Prompt-Version ermöglicht es Teams zu sehen, welche Prompts teuer sind und ob neuere Änderungen die Ausgaben erhöht oder verringert haben. Dies wird besonders wichtig, wenn Prompts über mehrere Anwendungen oder Agenten hinweg geteilt werden.
In agentenbasierten Systemen muss die Kostenzuordnung über einzelne Modellaufrufe hinausgehen. Teams müssen verstehen, wie viel ein vollständiger Agentendurchlauf oder Workflow durchgängig kostet, einschließlich Planungsschritten, Werkzeugaufrufen und Retries. Dies hilft, uneffizientes Agentenverhalten frühzeitig aufzudecken.
Für interne Plattformen und Unternehmensbereitstellungen ermöglicht die Zuordnung von Kosten zu Benutzern oder Teams Verantwortlichkeit und Budgetierung. Diese Dimension wird oft benötigt, um Nutzungslimits durchzusetzen oder Kosten intern zu verrechnen.
Die gemeinsame Beobachtung dieser Dimensionen ermöglicht es Teams, von einer reaktiven Kostenanalyse zu einer proaktiven Kostensteuerung überzugehen.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |

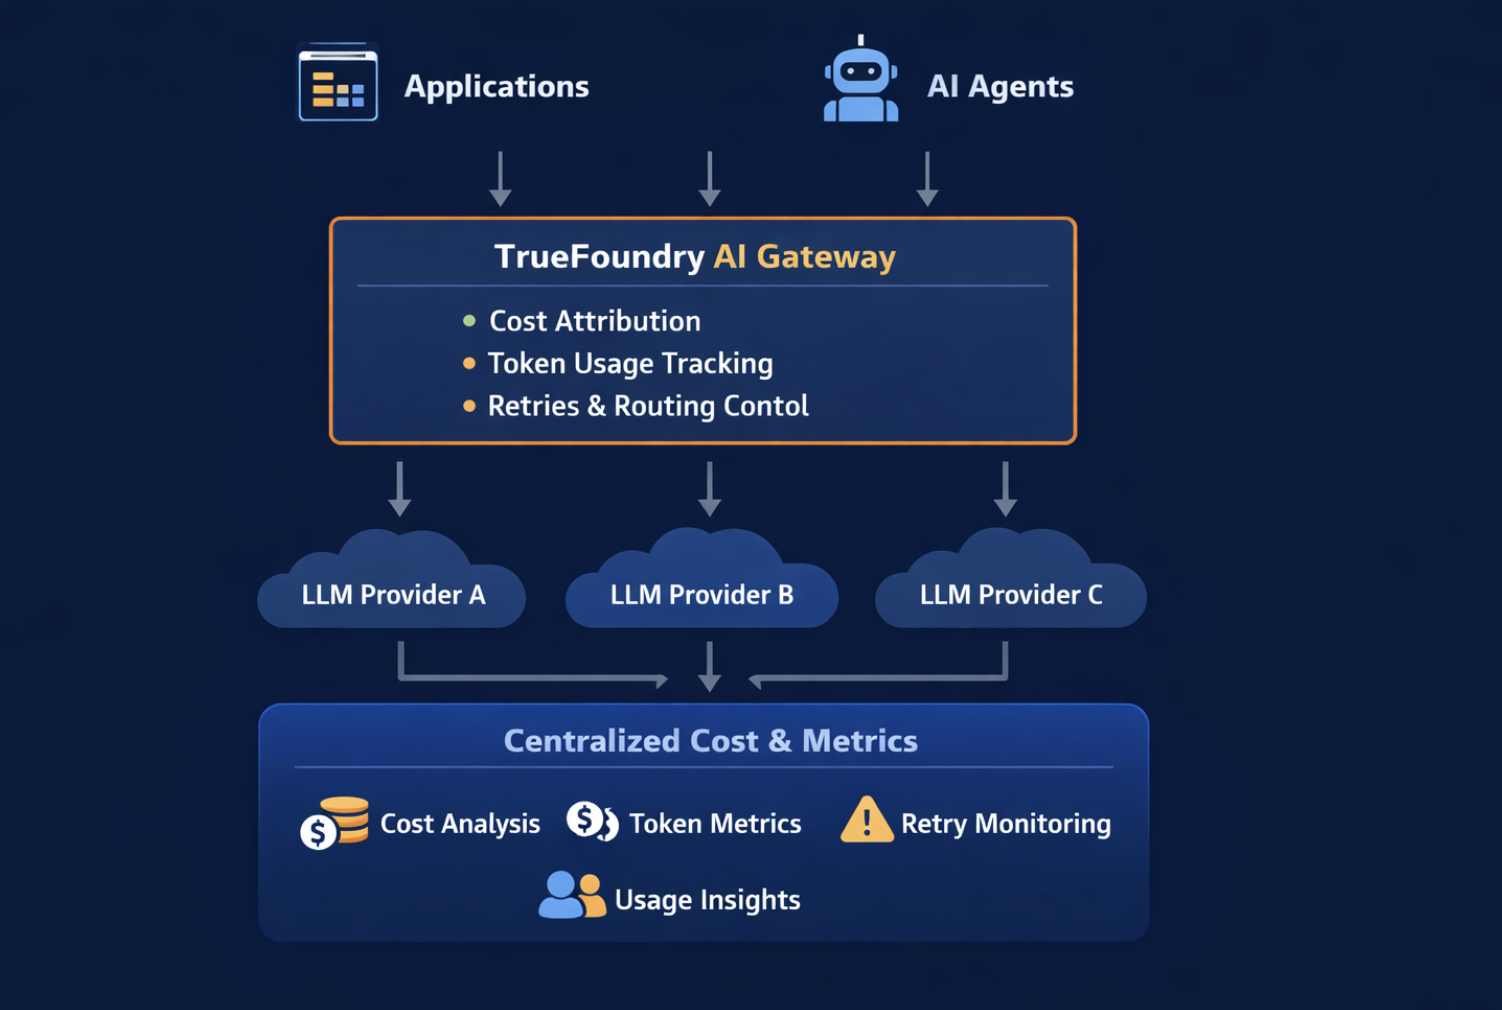
KI-Kostenobservabilität funktioniert am besten, wenn sie an einem zentralen Abfangpunkt implementiert wird, an dem alle Anfragen, Routing-Entscheidungen und Retries sichtbar sind. Aus diesem Grund spielen AI Gateways eine entscheidende Rolle.
Ein AI Gateway sitzt zwischen den Anwendungen oder Agenten und den Modellanbietern. Da jede Anfrage durch das Gateway fließt, kann es:
Ohne ein Gateway sind Kostendaten über SDKs, Dienste und Anbieter-Dashboards hinweg fragmentiert. Mit einem Gateway werden Kosten zu einem erstklassigen Signal, das analysiert und auf das reagiert werden kann, bevor die Ausgaben eskalieren.
In TrueFoundry bietet das AI Gateway diesen zentralen Kontrollpunkt, der es ermöglicht, KI-Kosten über Modelle, Agenten und Workflows hinweg auf einheitliche Weise zu beobachten und zu verwalten.
Agentenbasierte Systeme verstärken sowohl die Leistungsfähigkeit als auch die Kosten von KI-Workloads. Im Gegensatz zu Anwendungen mit einzelnen Anfragen führen Agenten mehrstufige Workflows aus, die Planung, Schlussfolgerungen, Retries und die Nutzung von Werkzeugen umfassen können. Dies macht das Kostenverhalten schwerer vorhersehbar und erfordert eine engmaschigere Überwachung.
Ein einziger Agentendurchlauf kann Folgendes umfassen:
Ohne angemessene Observabilität können diese Interaktionen die Kosten stillschweigend vervielfachen. Agentenschleifen, schlecht begrenzte Prompts oder eine übermäßige Werkzeugnutzung bleiben oft unbemerkt, bis die Gesamtausgaben erheblich steigen.
KI-Kostenobservabilität für Agenten erfordert Transparenz auf der Agentenausführungsebene, nicht nur auf der Ebene der Modellaufrufe. Teams müssen verstehen:
Hier wird eine Gateway-basierte Architektur besonders wertvoll. Durch das Erfassen von Agentenanfragen am Gateway können Teams die Kosten über den gesamten Lebenszyklus eines Agentendurchlaufs hinweg zuordnen, anstatt jeden Modellaufruf isoliert zu betrachten.
In TrueFoundry werden Agenten-Deployments mit dem AI Gateway integriert, sodass Teams die Kosten über Agentenschritte und Workflows hinweg beobachten können. Dies ermöglicht es Plattform- und Anwendungsteams, uneffizientes Agentenverhalten frühzeitig zu erkennen und Einschränkungen anzuwenden, bevor die Kosten außer Kontrolle geraten.

In TrueFoundry ist die KI-Kostenobservabilität direkt am AI Gateway und auf der Agentenausführungsschicht implementiert, wo alle Modellanfragen, Routing-Entscheidungen und Retries sichtbar sind. Dies bietet eine einheitliche und konsistente Sicht auf die Kosten über Modelle, Prompts, Agenten und Workflows hinweg.
Da jede Anfrage durch das Gateway fließt, kann TrueFoundry:
Dieser zentralisierte Ansatz verwandelt Kosten von einer passiven Metrik in ein betriebliches Signal. Teams können Benachrichtigungen für ungewöhnliche Ausgaben einrichten, Budgets auf der Routing-Schicht durchsetzen und kostenbewusste Entscheidungen bei der Auswahl von Modellen oder Fallback-Strategien treffen.
Für Teams, die KI-Workloads in der Produktion betreiben, stellt dies sicher, dass die Kosten vorhersehbar, erklärbar und steuerbar bleiben – selbst wenn die Systeme durch mehr Agenten, Modelle und Workflows an Komplexität gewinnen.
KI-Kosten werden schwer steuerbar, sobald LLM-Anwendungen in die Produktion gehen. Kosten werden nicht mehr durch einen einzelnen Modellaufruf getrieben, sondern durch eine Kombination aus Prompts, Routing-Entscheidungen, Retries, Agenten und der Nutzung von Werkzeugen. Ohne angemessene Transparenz entdecken Teams Kostenprobleme oft erst, nachdem die Ausgaben bereits gestiegen sind.
Die KI-Kostenobservabilität begegnet diesem Problem, indem sie Kosten zu einem erstklassigen Signal macht. Durch die Zuordnung von Ausgaben über Anfragen, Modelle, Prompts, Agenten und Workflows hinweg können Teams nicht nur verstehen, wie viel sie ausgeben, sondern auch warum. Dieser Grad an Einblick ist unerlässlich, um KI-Systeme in großem Maßstab zuverlässig zu betreiben.
Gateway-basierte Architekturen spielen eine zentrale Rolle bei der Ermöglichung dieser Transparenz. Durch das Erfassen von Anfragen an einem einzigen Kontrollpunkt können Teams KI-Ausgaben über Anbieter und Ausführungspfade hinweg konsistent beobachten, analysieren und steuern. In TrueFoundry ermöglicht dieser Ansatz Plattform- und Anwendungsteams, Ineffizienzen frühzeitig zu erkennen, Budgets durchzusetzen und Kosten mit Leistung abzuwägen, während KI-Workloads wachsen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















