August 27, 2025
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: October 6, 202615
Blazingly fast way to build, track and deploy your models!
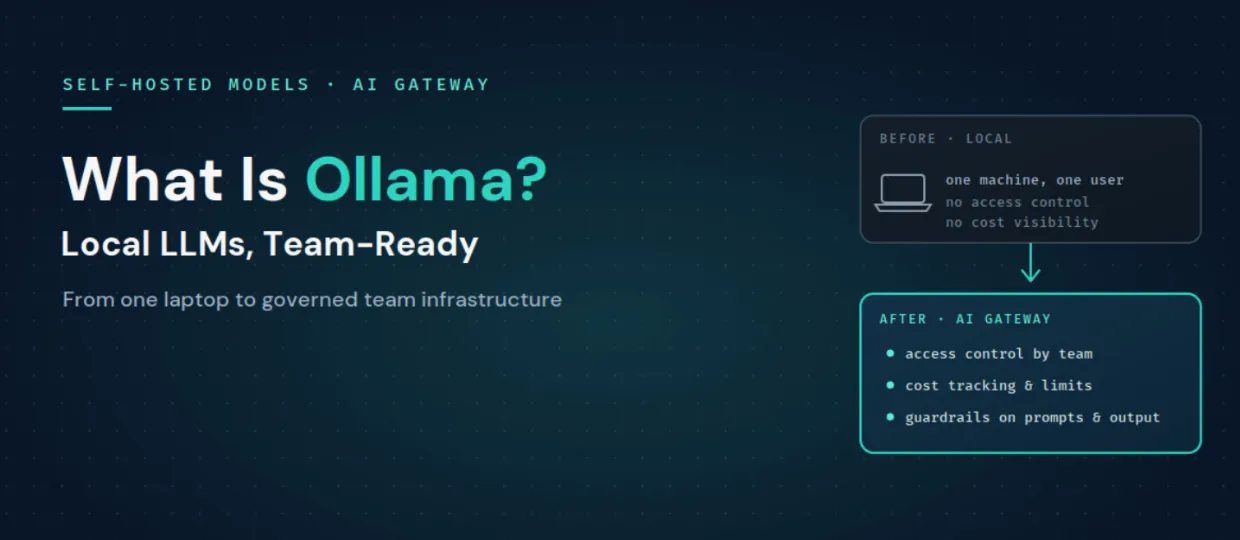
Ollama هو بيئة تشغيل مفتوحة المصدر لتشغيل النماذج اللغوية الكبيرة على بنيتك التحتية الخاصة، سواء كان ذلك على حاسوب محمول، أو خادم GPU محلي، أو مثيل في سحابة خاصة. يمكنك تنزيل نموذج مفتوح الأوزان مثل Llama أو Mistral أو Qwen، وسيقوم Ollama بتقديمه محلياً عبر نقطة نهاية HTTP. والأهم من ذلك، أن نقطة النهاية هذه تدعم واجهة برمجة تطبيقات متوافقة مع OpenAI، لذا يمكن للكود المكتوب باستخدام حزمة تطوير برمجيات OpenAI التواصل مع نموذج Ollama المحلي بمجرد تغيير عنوان URL الأساسي.
تختار الفرق Ollama لعدة أسباب واضحة:
المقارنة الأكثر شيوعاً هي بين Ollama وvLLM، لأن كلاهما يوفر واجهات برمجة تطبيقات متوافقة مع OpenAI وكلاهما يدعم الاستضافة الذاتية للنماذج مفتوحة الأوزان. لكنهما يركزان على جوانب مختلفة.
باختصار، تُعد Ollama أسهل وسيلة لتشغيل نموذج لمستخدم واحد، بينما صُممت vLLM لخدمة العديد من المستخدمين المتزامنين بمعدل إنتاجية عالٍ. تستخدم العديد من الفرق كليهما: Ollama للتطوير المحلي وvLLM للإنتاج. والخبر السار هو أنه نظرًا لأن كلاهما متوافق مع OpenAI، فيمكن لأي معيار تعتمده أن يعمل خلف نفس البوابة، بل ويمكنك حتى التوجيه بينهما.
تؤدي Ollama وظيفتها بشكل جيد، لكن تشغيلها على مستوى المؤسسة يكشف عن فجوات تقع خارج نطاق اختصاصها.
هذه هي بالضبط المخاوف التي وُجدت البوابة (Gateway) لمعالجتها، وهي الطريقة التي تحول بها أداة تشغيل النماذج المحلية إلى بنية تحتية للفريق.
تتعامل TrueFoundry مع خادم Ollama كنموذج مستضاف ذاتياً. يمكنك ربطه بـ بوابة الذكاء الاصطناعي (AI Gateway) من خلال توفير عنوان URL لنقطة النهاية وتفاصيل المصادقة، وبمجرد تسجيله يظهر في كتالوج نماذج البوابة جنباً إلى جنب مع مزودي الخدمات السحابية، مع تطبيق جميع ميزات البوابة: التوجيه، وحواجز الحماية، وتحديد معدل الاستخدام، وتتبع التكاليف، والمراقبة. يتم دعم Ollama بشكل صريح هنا لأنها توفر واجهة برمجة تطبيقات متوافقة مع OpenAI، وهو التنسيق الذي تعمل به البوابة بأفضل كفاءة.
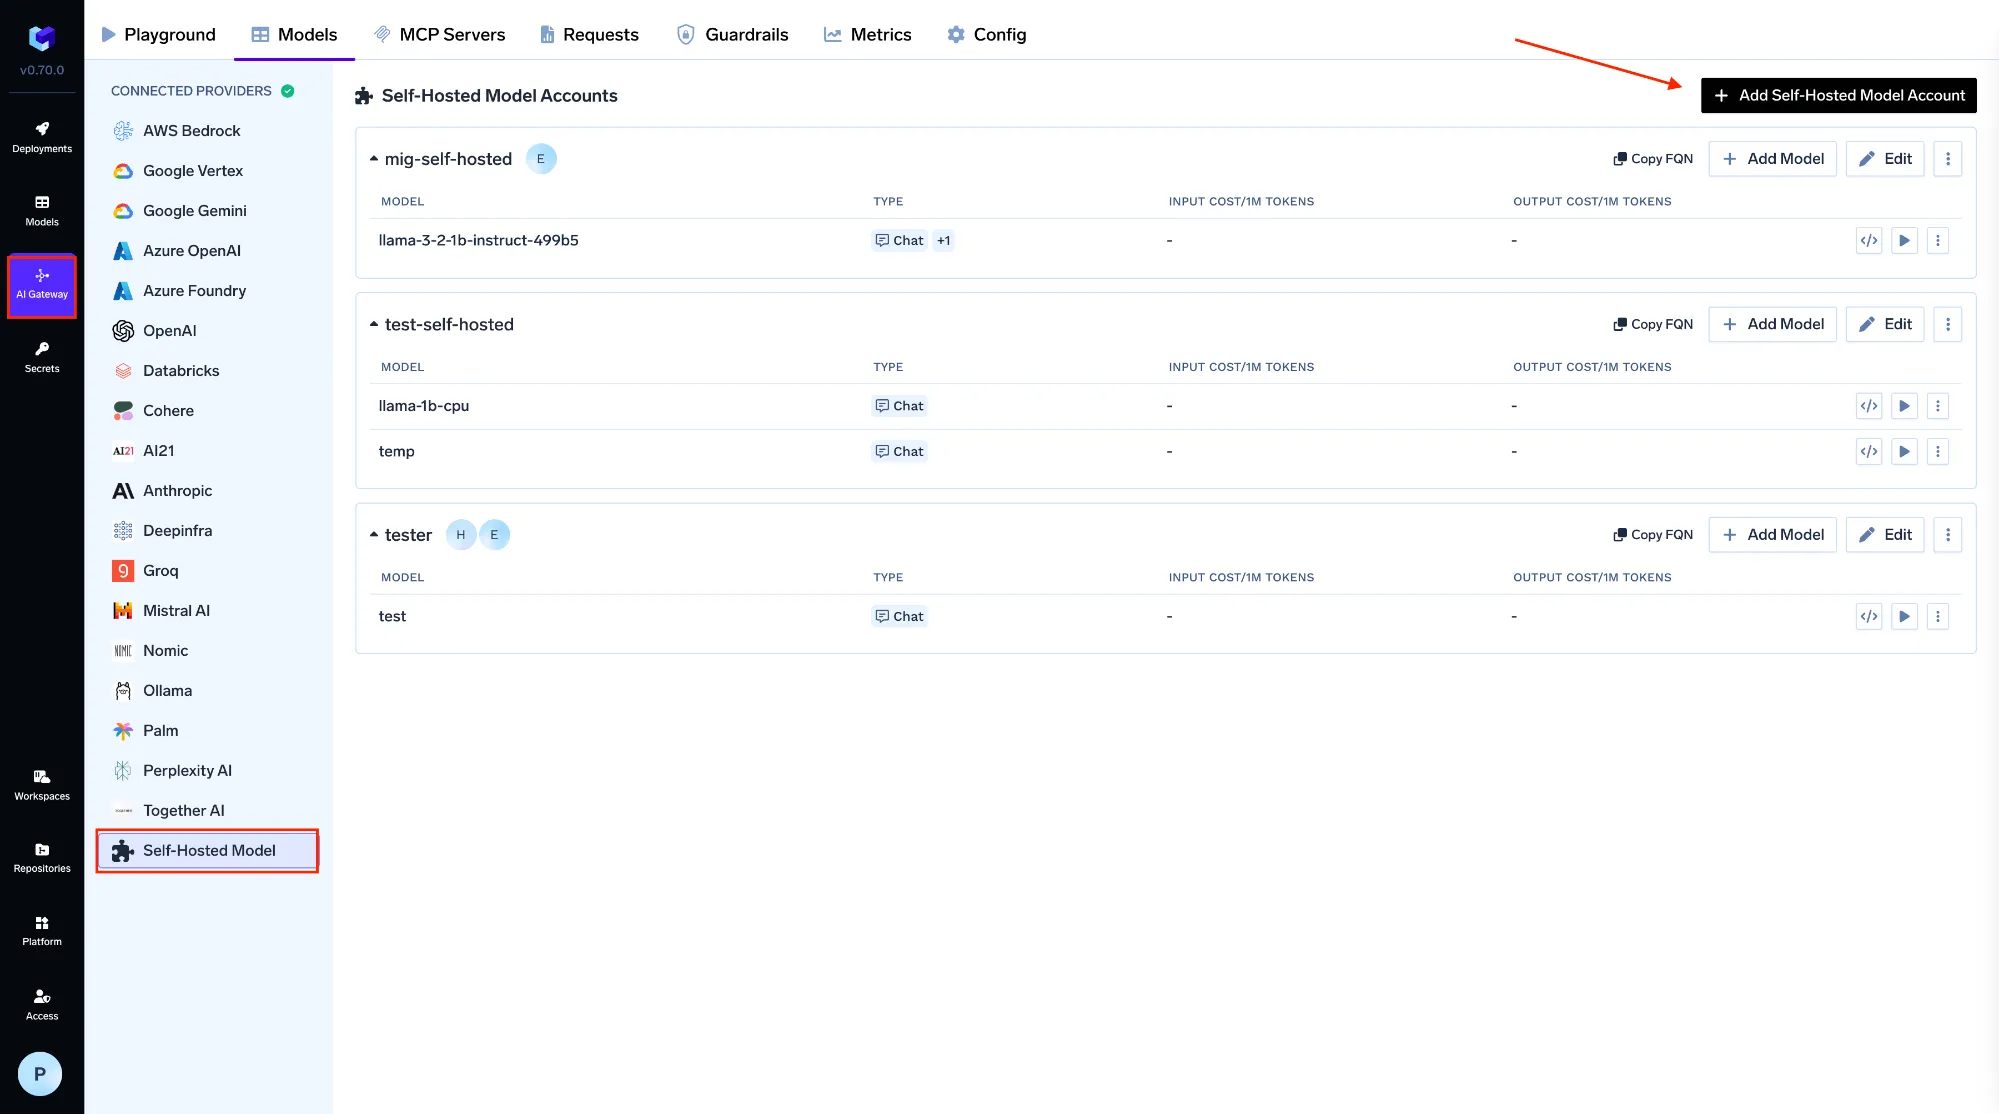
تقوم بتسجيل النموذج ضمن "بوابة الذكاء الاصطناعي" (AI Gateway)، ثم "النماذج" (Models)، ثم "النماذج المستضافة ذاتياً" (Self Hosted Models)، مع تحديد اسم للنموذج، ومعرف النموذج، وعنوان URL لخادم Ollama الخاص بك، ونوع خادم النموذج، مع خيار المصادقة. من تلك اللحظة، تتوقف التطبيقات والوكلاء عن الاتصال بنقطة نهاية محلية مباشرة، وبدلاً من ذلك يتصلون بالبوابة عبر واجهة برمجة تطبيقات موحدة:
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-api-key",   # a gateway token, not a raw endpoint
    base_url="https://gateway.truefoundry.ai",
)

resp = client.chat.completions.create(
    model="self-hosted/llama-3-8b-ollama",   # your registered Ollama model
    messages=[{"role": "user", "content": "Summarize this ticket"}],
)
هذا التغيير الوحيد هو ما يجعل Ollama قابلاً للاستخدام من قبل فريق العمل:
ولأن البوابة محايدة تجاه مزودي الخدمة ومتوافقة مع OpenAI عبر أكثر من 1000 نموذج، يمكنك أيضاً دمج نموذج Ollama محلي مع نشر vLLM وواجهات برمجة تطبيقات سحابية تحت واجهة واحدة، وهو ما يرتبط مباشرة بـ قابلية نقل وكلاء الذكاء الاصطناعي. وبما أن TrueFoundry تعمل داخل سحابتك الخاصة (VPC)، فإن الخصوصية التي دفعتك لاختيار Ollama في المقام الأول تظل محفوظة بالكامل من البداية إلى النهاية.
يُعد Ollama أسرع وسيلة لتشغيل نموذج محلياً، ومن الصعب منافسته من حيث الخصوصية والتكلفة. لكنه ببساطة لم يُصمم ليكون بنية تحتية لفرق العمل، وهنا يأتي دور التحكم في الوصول، ورؤية التكاليف، وضوابط الأمان، والتوجيه. اربط Ollama ببوابة الذكاء الاصطناعي (AI Gateway) كنموذج مستضاف ذاتياً، وسيحافظ على خصوصيته وتكلفته المنخفضة مع اكتساب كل ما يحتاجه الفريق لتشغيله في بيئة الإنتاج.
اكتشف كيف تحول TrueFoundry النماذج المحلية إلى بنية تحتية خاضعة للحوكمة وجاهزة لفرق العمل. احجز عرضاً توضيحياً أو ابدأ مجاناً.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


Ollama أداة مفتوحة المصدر تشغّل النماذج اللغوية الكبيرة محلياً على عتادك الخاص وتقدّمها خلف واجهة HTTP API بسيطة متوافقة مع OpenAI. وتستخدمه الفرق لاستدلال خاص وغير متصل بالإنترنت ومنخفض التكلفة مع نماذج مفتوحة الأوزان مثل Llama وMistral وQwen.
Ollama مهيأ لاستدلال محلي سهل على جهاز واحد، أما vLLM فمبني لتقديم النماذج في الإنتاج بإنتاجية عالية وتزامن مرتفع. وكلاهما يتيح واجهات API متوافقة مع OpenAI، ولذلك تستخدم فرق كثيرة Ollama للتطوير وvLLM للإنتاج، وتضع الاثنين خلف البوابة نفسها.
يعمل النموذج على بنية تحتية تتحكم بها، وهذا جيد للخصوصية، لكن نقطة نهاية Ollama المجردة لا تتضمن تحكماً في الوصول ولا نسبة للتكلفة ولا ضوابط حماية للمحتوى. ولاستخدامه بأمان ضمن فريق، ضعه خلف بوابة تضيف المصادقة وRBAC وحدود المعدل وفحص البيانات الشخصية (PII) والأسرار.
اربط خادم Ollama بـ AI Gateway كنموذج مستضاف ذاتياً بتزويده بعنوان URL وبيانات المصادقة. عندها تستدعي التطبيقات واجهة API الموحدة للبوابة بدلاً من نقطة نهاية مباشرة، ما يضيف فوق Ollama تحكماً مشتركاً في الوصول وتتبعاً للتكلفة وضوابط حماية وتوجيهاً.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فيبقى الاستدلال المحلي الخاص الذي يوفره Ollama خاصاً عبر المنظومة كلها.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد