


August 26, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
أصبحت النماذج اللغوية الكبيرة (LLMs) العمود الفقري لتطبيقات الذكاء الاصطناعي الحديثة، حيث تشغل كل شيء بدءًا من روبوتات الدردشة والمساعدين الافتراضيين إلى أدوات البحث والحلول المؤسسية. ومع ذلك، ليست كل نماذج LLMs متساوية—فلكل نموذج نقاط قوة وقيود وعوامل تكلفة فريدة. يتميز بعضها في التفكير والمنطق، بينما يبرع البعض الآخر في الكتابة الإبداعية، أو البرمجة، أو التعامل مع الاستعلامات الهيكلية. وهنا يأتي دور LLM Router.
يعمل LLM Router كموجه حركة مرور ذكي، حيث يوجه المطالبات المدخلة من المستخدم تلقائيًا إلى النموذج الأكثر ملاءمة بناءً على المهمة الحالية. بدلاً من الاعتماد على نموذج واحد، يمكن للشركات والمطورين تحسين الأداء والدقة والتكاليف عن طريق توجيه الاستعلامات إلى نموذج LLM المناسب في الوقت الفعلي. مع نمو اعتماد الذكاء الاصطناعي، أصبح توجيه LLM طبقة أساسية لبناء أنظمة ذكاء اصطناعي قابلة للتوسع وموثوقة وفعالة.
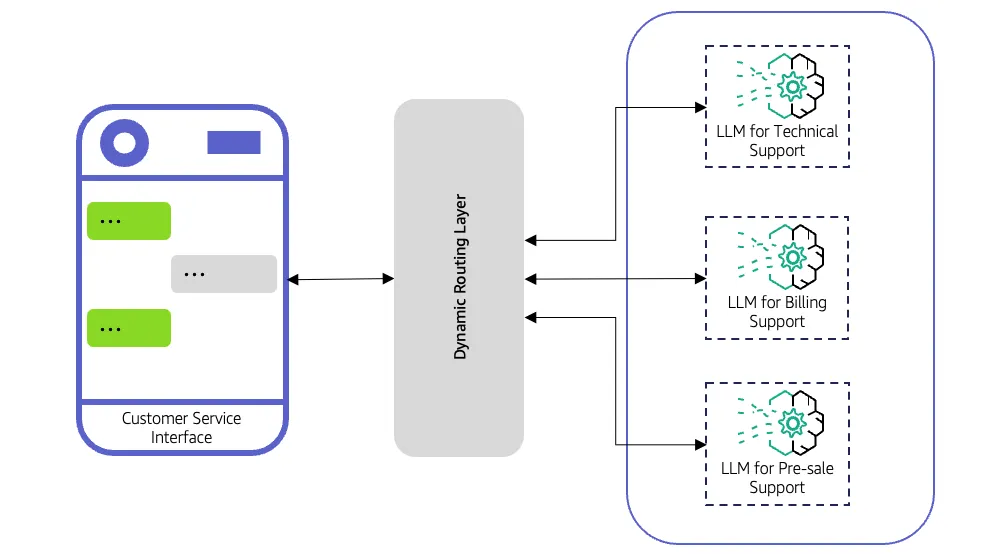
يحدد LLM Router النموذج اللغوي الكبير الذي يجب أن يتعامل مع كل طلب. بدلاً من إرسال كل استعلام إلى نموذج واحد، يقوم بتقييم المدخلات، وتطبيق منطق التوجيه، وإعادة توجيهها إلى النموذج الأكثر ملاءمة.
يمكن للموجه اتباع قواعد بسيطة، مثل توجيه الاستعلامات المتعلقة بالبرمجة إلى نموذج متخصص في البرمجة، أو استخدام استراتيجيات متقدمة مثل أدوات التصنيف (classifiers) أو التضمينات (embeddings) أو النماذج التنبؤية خفيفة الوزن لتحديد نموذج LLM الذي سيقدم أفضل استجابة.
كيف يعمل
يلغي هذا النهج مشكلة "حل واحد يناسب الجميع". تتعامل النماذج خفيفة الوزن مع الاستعلامات الروتينية بفعالية، بينما تذهب المهام المعقدة أو التي تتطلب تفكيرًا منطقيًا إلى نماذج LLMs أكثر قدرة.
من الناحية العملية، يقع الموجه بين التطبيقات ونماذج LLMs المتعددة، مما يحسن الأداء، ويقلل التكاليف، ويقلل الاعتماد على أي مزود واحد. يضمن هذا الإعداد وصول كل طلب إلى النموذج المناسب مع الحفاظ على موثوقية أنظمة الذكاء الاصطناعي ومرونتها.

AI governance technologies operationalize an organization’s AI policies by providing oversight, risk management, compliance, observability and security across the AI life cycle. This Hype Cycle identifies the technologies that will help organizations implement AI governance responsibly and drive adoption at scale.
تعتمد الشركات بشكل متزايد على النماذج اللغوية الكبيرة للمهام التي تتراوح من روبوتات الدردشة والمساعدين الافتراضيين إلى إنشاء المحتوى وتحليل البيانات.
ومع ذلك، فإن استخدام نموذج LLM واحد لجميع المهام يخلق تحديات. تتجاوب بعض النماذج بسرعة ولكنها تفتقر إلى العمق، بينما توفر نماذج أخرى نتائج دقيقة ولكن بزمن انتقال وتكلفة مرتفعين. بدون طريقة لإدارة هذه الاختلافات، تضحي الفرق باستمرار بالأداء أو الدقة أو الميزانية.
يحل LLM Router هذه المشكلة من خلال توجيه الطلبات بذكاء إلى النموذج الأنسب للمهمة.
تأمل هذا السيناريو -
يتلقى نظام دعم العملاء نوعين من الاستعلامات.
طلب بسيط مثل "ما هي ساعات عملكم؟" لا يحتاج إلى نموذج متقدم للغاية، بينما يحتاج السؤال الفني المعقد حول استكشاف أخطاء المنتج وإصلاحها إلى ذلك. بدون LLM Router، قد تذهب جميع الاستعلامات إلى نموذج عالي الطاقة ومكلف. وهذا يزيد من التكلفة ويؤدي إلى إبطاء أوقات الاستجابة. مع وجود الموجه، ينتقل الاستعلام البسيط إلى نموذج سريع وخفيف الوزن، بينما يتم توجيه الاستعلام المعقد إلى نموذج LLM أكثر قدرة، مما يحسن السرعة والتكلفة والدقة.
الفوائد بالنسبة للشركات
من خلال توجيه الاستعلامات بذكاء، تقدم الشركات خدمات ذكاء اصطناعي أسرع وأكثر دقة وتكلفة مناسبة. تحول أدوات LLM Routers نشر الذكاء الاصطناعي من نهج "مقاس واحد يناسب الجميع" إلى نظام مرن وموثوق وفعال، مما يجعلها عنصرًا أساسيًا للبنية التحتية الحديثة للذكاء الاصطناعي.
يعد LLM Router أكثر من مجرد موجه لحركة المرور، فهو يقدم العديد من الوظائف الأساسية التي تجعل أنظمة الذكاء الاصطناعي أكثر ذكاءً وأسرع وأكثر موثوقية. يساعد فهم هذه الوظائف المؤسسات على تصميم مسارات عمل ذكاء اصطناعي تتوسع بفعالية مع الحفاظ على الجودة.
قبل حدوث أي توجيه، يحلل الموجه الاستعلامات الواردة. يفحص البيانات الوصفية، والعلامات، ونوع الاستعلام، والتعقيد، وفي بعض الأحيان القصد أو المشاعر. يوفر هذا التحليل سياقًا حتى يتمكن الموجه من تحديد النموذج الأنسب للتعامل مع الطلب. على سبيل المثال، يمكن توجيه سؤال العميل حول الفواتير إلى نموذج LLM عام خفيف الوزن، بينما يتم إرسال استعلام استكشاف الأخطاء وإصلاحها الفني إلى نموذج متخصص في المجال.
يختار الموجه النموذج الأكثر ملاءمة بناءً على معايير متعددة، بما في ذلك:
من خلال مراعاة هذه العوامل، يضمن الموجه حصول كل طلب على أفضل توازن بين السرعة والدقة والتكلفة.
عندما تتمكن نماذج متعددة من التعامل مع نفس المهمة، يوزع الموجه الطلبات بذكاء لتجنب التحميل الزائد على أي نموذج بمفرده. هذا يحسن الاستجابة العامة للنظام ويضمن أداءً ثابتًا أثناء ذروة الاستخدام.
حتى أفضل النماذج يمكن أن تفشل، أو تنتهي مهلتها، أو ترجع استجابات منخفضة الثقة. ينفذ الموجه آليات الاحتياط، حيث يعيد توجيه الاستعلامات تلقائيًا إلى نماذج احتياطية. هذا يضمن الاستمرارية والموثوقية دون تعطيل المستخدم.
تتتبع الموجهات المتقدمة أنماط الاستخدام، وأداء النموذج، ونتائج الاستعلام. تساعد هذه الرؤى الفرق على تحسين استراتيجيات التوجيه، واختيار نماذج أفضل، وتقليل التكاليف بمرور الوقت.
يعمل LLM Router كمركز لاتخاذ القرار في أنظمة الذكاء الاصطناعي متعددة النماذج. من خلال تحليل الطلبات، واختيار النموذج المناسب، وموازنة الحمل، ومعالجة الأخفاقات، تقديم الرؤى، يضمن معالجة كل استعلام بفعالية ودقة وموثوقية. تجعل هذه المجموعة من الوظائف أدوات LLM Routers مكونًا حاسمًا في بناء حلول ذكاء اصطناعي قوية وقابلة للتوسع وفعالة من حيث التكلفة.
غالبًا ما يتم مناقشة LLM Routers و AI Gateways معًا لأن كلاهما يقع بين تطبيقات الذكاء الاصطناعي والنماذج اللغوية. ومع ذلك، فإنها تحل مشكلات مختلفة وتعمل في طبقات مختلفة من المكدس التكنولوجي للذكاء الاصطناعي.
يركز LLM Router على اختيار الطلبات وتوجيهها إلى النموذج اللغوي الأكثر ملاءمة بناءً على عوامل مثل التكلفة، أو زمن الانتقال، أو الأداء، أو التوفر، أو متطلبات المهمة. هدفه الرئيسي هو تحسين استخدام النموذج وتحسين أداء التطبيق.
يوفر AI Gateway مستوى تحكم أوسع لحركة مرور الذكاء الاصطناعي. بالإضافة إلى توجيه النماذج، توفر بوابات الذكاء الاصطناعي إمكانيات مثل المصادقة (authentication)، والتفويض (authorization)، وتحديد المعدل (rate limiting)، والقابلية للملاحظة (observability)، والحوكمة (governance)، وتتبع التكاليف، وضوابط الأمان. تتيح للمؤسسات إدارة وحماية أعباء عمل الذكاء الاصطناعي عبر نماذج وفريق وبيئات متعددة.
تستخدم موجهات LLM استراتيجيات مختلفة لتوجيه الاستعلامات إلى النموذج اللغوي الأكثر ملاءمة بكفاءة. تندرج هذه الاستراتيجيات عمومًا تحت ثلاث فئات: ثابتة، وديناميكية، وهجينة، مع تضمين التعلم المعزز في بعض الأنظمة المتقدمة.
يعتمد التوجيه الثابت على قواعد محددة مسبقًا لتحديد النموذج الذي يتعامل مع الاستعلام. يضمن سلوك توجيه ثابت وهو سهل التنفيذ.
يتكيف التوجيه الديناميكي في الوقت الفعلي، حيث يختار النماذج بناءً على الأداء الحالي للنظام وسياق الاستعلام.
تجمع الاستراتيجيات الهجينة بين الأساليب الثابتة والديناميكية لزيادة المرونة والكفاءة.
تستخدم بعض الأنظمة المتقدمة التعلم المعزز لتحسين قرارات التوجيه باستمرار. تتعلّم هذه الموجهات من الاستعلامات السابقة وأداء النماذج، مما يحسن التوجيه بمرور الوقت لأعباء العمل المعقدة أو المتطورة.
يوفر LLM Router العديد من الفوائد الرئيسية التي تجعل أنظمة الذكاء الاصطناعي أكثر كفاءة وموثوقية واقتصادية. إحدى المزايا الرئيسية هي الأداء المحسن.
من خلال توجيه كل استعلام بذكاء إلى النموذج الأنسب للمهمة، يضمن الموجه أن النماذج القوية والقادرة على التفكير المباشر تتعامل مع الأسئلة المعقدة، بينما تعالج النماذج الأخف وزنًا والأسرع الطلبات البسيطة. يوازن هذا النهج بين السرعة والدقة، مما يحسن تجربة المستخدم الإجمالية.
فائدة رئيسية أخرى هي كفاءة التكلفة. بدون موجه، قد تقوم الشركات بتشغيل جميع الاستعلامات من خلال نماذج عالية الطاقة، مما يزيد من التكاليف التشغيلية بشكل غير ضروري. يضمن الموجه الاحتفاظ بالنماذج المكلفة للاستعلامات ذات القيمة العالية أو المعقدة، بينما يتم التعامل مع المهام الروتينية أو المتكررة بواسطة نماذج أقل استهلاكًا للموارد، مما يقلل من نفقات الحوسبة ويزيد من عائد الاستثمار (ROI).
تتحسن الموثوقية أيضًا مع LLM Router. تتضمن الموجهات المتقدمة آليات احتياطية تعيد توجيه الاستعلامات تلقائيًا إذا فشل النموذج، أو انتهت مهلته، أو أرجع نتائج منخفضة الثقة. هذا يضمن أداءً ثابتًا وموثوقًا، مما يمنع الانقطاعات في التطبيقات التي تعمل في الوقت الفعلي مثل دعم العملاء أو المساعدين الافتراضيين.
بالإضافة إلى ذلك، توفر أدوات LLM Routers المرونة. يمكن للمؤسسات دمج نماذج متعددة من مزودين مختلفين، واختيار الأفضل لكل مهمة.
هذا يقلل من الاعتماد على مزود واحد ويسمح للفرق بالتجربة مع نماذج مختلفة مع ظهور قدرات جديدة.
أخيرًا، تدعم الموجهات القابلية للتوسع. مع نمو أحجام الاستعلامات، يوزع الموجه الطلبات بذكاء عبر النماذج، مما يمنع التحميل الزائد ويحافظ على أداء النظام السلس.
من خلال الجمع بين التوجيه المحسن، وتوفير التكاليف، والموثوقية، والمرونة، والقابلية للتوسع، يحول LLM Router عمليات نشر الذكاء الاصطناعي من نهج نموذج واحد صلب إلى نظام ديناميكي وفعال ومقاوم للصدمات.
تُستخدم LLM Routers بشكل متزايد عبر المؤسسات لتحسين أداء الذكاء الاصطناعي وموثوقيته وكفاءته. حيث تتيح التوجيه الذكي للاستعلامات، مما يضمن تعامل النموذج المناسب مع كل مهمة بناءً على التعقيد والمجال والسياق.
أتمتة دعم العملاء
تتعامل المؤسسات مع آلاف استعلامات العملاء يوميًا، من الأسئلة الشائعة البسيطة إلى المشكلات الفنية المعقدة. توجه أدوات LLM Routers الأسئلة الروتينية إلى نماذج سريعة وخفيفة الوزن مع توجيه المشكلات المعقدة إلى نماذج أكثر قدرة. هذا يضمن استجابات سريعة ودقيقة ومستمرة، مما يحسن رضا العملاء ويقلل الجهد التشغيلي.
إدارة المعرفة والبحث المؤسسي
تحتفظ الشركات بأسطول كبير من المستندات والكتيبات والسياسات الداخلية. تحلل الموجهات الاستعلامات وتوجهها إلى نماذج محسنة للتفكير، أو التلخيص، أو المعرفة الخاصة بالمجال. يتلقى الموظفون معلومات دقيقة وذات صلة بالسياق دون التحميل الزائد على النماذج عالية التكلفة.
أتمتة سير العمل والمهام
تُستخدم نماذج LLMs على نطاق واسع لإنشاء التقارير، وتحليل البيانات، ومهام دعم القرار. تعين الموجهات ديناميكيًا الاستعلامات عالية التعقيد لنماذج قوية والمهام الروتينية لنماذج أخف، مما يوازن بين السرعة والدقة وتكاليف الحوسبة عبر مسارات عمل المؤسسة.
التنسيق متعدد النماذج (Multi-Model Orchestration)
غالبًا ما تنشر المؤسسات نماذج LLMs متعددة عبر المزودين أو المجالات. تدير الموجهات اختيار النموذج، وموازنة الحمل، وآليات الاحتياط، مما يضمن الموثوقية والمرونة والقابلية للتوسع في أنظمة الذكاء الاصطناعي واسعة النطاق.
توصيات المنتجات والتخصيص
بالنسبة للتجارة الإلكترونية أو منصات SaaS، يمكن لـ LLM Routers تعيين مهام التخصيص للنماذج المدربة على سلوك المستخدم وسياقه مع تفويض التوصيات العامة لنماذج أبسط. هذا يحسن دقة التوصيات والأداء مع التحكم في التكاليف.
الامتثال وتحليل المخاطر
في المؤسسات المالية أو القانونية أو الرعاية الصحية، قد تتطلب الاستعلامات التزامًا صارمًا باللوائح أو الإرشادات الخاصة بالمجال. يمكن للموجهات توجيه الاستعلامات الحساسة أو عالية المخاطر إلى نماذج ذات خبرة في المجال، مما يضمن الامتثال بينما يتم التعامل مع المهام العامة بواسطة النماذج القياسية.
إنشاء المحتوى وتلخيصه
بالنسبة للتسويق أو مشاركة المعرفة أو التوثيق، يمكن لـ LLM Routers تخصيص مهام إنشاء المحتوى المعقد لنماذج عالية الجودة ومهام التلخيص أو المسودة الأبسط لنماذج أسرع، مما يحسن الكفاءة دون المساومة على جودة المخرجات.
من خلال تطبيق LLM Routers عبر هذه السيناريوهات المتنوعة، يمكن للمؤسسات توسيع نطاق الذكاء الاصطناعي بذكاء، والحفاظ على الأداء والموثوقية وكفاءة التكلفة عبر مسارات عمل وتطبيقات متعددة.
بعد استكشاف كيفية تمكين LLM Routers لمجموعة واسعة من التطبيقات المؤسسية، من المهم فهم كيف تختلف عن مكون رئيسي آخر في أنظمة الذكاء الاصطناعي متعددة النماذج.
يركز LLM Router على التوجيه الذكي للطلبات. وظيفته الأساسية هي تحليل الاستعلامات الواردة، وتقييم السياق والتعقيد والبيانات الوصفية، ثم توجيه كل طلب إلى النموذج الأنسب. غالبًا ما تتضمن الموجهات استراتيجيات متقدمة مثل التوجيه الديناميكي، واتخاذ القرارات المراعاة للسياق، وآليات الاحتياط للتحسين من حيث الدقة والسرعة والتكلفة.
تعتبر ذات أهمية خاصة في البيئات التي تتنوع فيها الاستعلامات بشكل كبير من حيث النوع أو المجال أو المتطلبات الحسابية، مما يسمح للمؤسسات بموازنة الحمل والحفاظ على أداء عالٍ.
من ناحية أخرى، يعمل LLM Gateway كنقطة وصول مركزية للتفاعل مع نموذج واحد أو نماذج LLMs متعددة. دوره الرئيسي هو تبسيط التكامل، وتوفير واجهات برمجة تطبيقات (APIs) موحدة، وإدارة المصادقة، والتعامل مع تحديد المعدل، ومراقبة الاستخدام.
على عكس الموجهات، لا تتخذ البوابات عادةً قرارات ذكية لاختيار النموذج؛ بل توفر وصولاً موحدًا وضوابط تشغيلية لتسهيل عمليات النشر متعددة النماذج. تركز البوابات بشكل أكبر على الإدارة على مستوى البنية التحتية، والأمان، والقابلية للتوسع بدلاً من التحسين على مستوى الاستعلام.
الفروق الرئيسية
غالباً ما تعمل الموجهات والبوابات معاً في أشكال هندسية متدرجة الطبقات. توفر البوابة نقطة دخول آمنة وموحدة للتطبيقات، بينما يقع الموجه خلفها، ليتخذ قرارات ذكية لاختيار النموذج. يتيح هذا الجمع للمؤسسات تحقيق كل من التحكم التشغيلي ومعالجة الاستعلامات المحسنة.
يساعد فهم الفارق بين LLM Routers و LLM Gateways المؤسسات على نشر أنظمة الذكاء الاصطناعي متعددة النماذج بفعالية.
تقود الموجهات الأداء الذكي والمراعي للسياق، بينما تضمن البوابات وصولاً آمنًا وقابلاً للتوسع وموثوقًا، مما يخلق أساسًا قوية للذكاء الاصطناعي في المؤسسات.
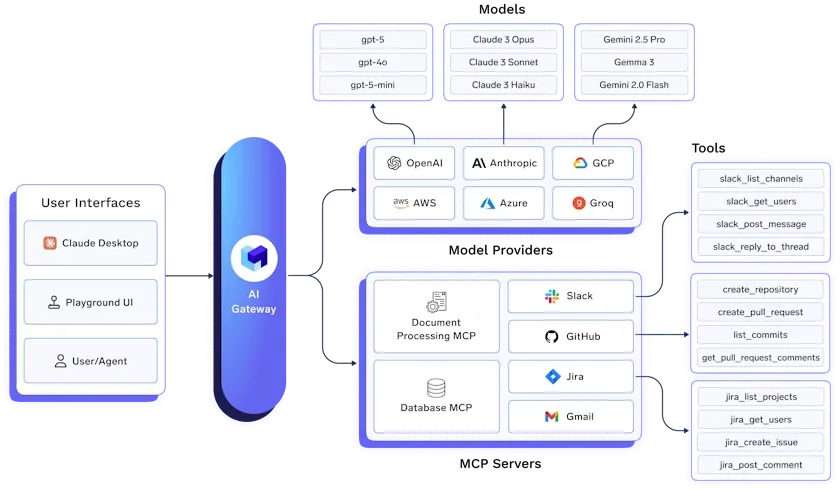
تُعد TrueFoundry LLM Gateway منصة جاهزة للمؤسسات توحد الوصول إلى جميع النماذج اللغوية الكبيرة (LLMs) الرئيسية من خلال API واحد وآمن وعالي الأداء.
فهي تبسط البنية التحتية للذكاء الاصطناعي التوليدي من خلال دمج أكثر من 250 نموذجًا، بما في ذلك OpenAI، و Anthropic Claude، و Gemini، و Groq، و Mistral، وأطر العمل مفتوحة المصدر، دون الحاجة إلى تغيير الكود. يمكن للفرق استخدام API موحد لجميع أعباء عمل الدردشة (chat)، والإكمال (completion)، والتضمين (embedding)، وإعادة الترتيب (reranking) مع تركيز المصادقة وإدارة مفاتيح API.
الميزات الرئيسية:
مع تزايد اعتماد المؤسسات على العديد من Large Language Models، أصبحت أدوات مثل LLM Routers و LLM Gateways لا غنى عنها لإدارة AI على نطاق واسع. تضفي LLM Routers ذكاءً على النظام، حيث تقوم بتحليل كل استعلام وضمان وصوله إلى النموذج الأكثر ملاءمة للمهمة. يؤدي هذا إلى تحسين الأداء، وتقليل التكاليف، وتعزيز الموثوقية، لا سيما في سير العمل المعقد وعالي الحجم.
في الوقت نفسه، توفر Gateways البنية التحتية الأساسية للوصول الآمن والموحد إلى Models، مما يسهل التكامل، ويراقب الاستخدام، ويفرض أدوات التحكم التشغيلية.
تشكل هذه المكونات معًا بنية AI متعددة الطبقات توازن بين الذكاء والكفاءة التشغيلية. ومن خلال الجمع بين قدرات اتخاذ القرار لدى Routers والموثوقية الهيكلية لـ Gateways، يمكن للمؤسسات تحقيق أقصى استفادة من LLMs المتعددة مع الحفاظ على القابلية للتوسع والتحكم.
لم يعد اعتماد LLM Routers أمرًا اختياريًا؛ بل أصبح ضرورة للمؤسسات التي تهدف إلى تقديم خدمات AI سريعة ودقيقة وتنافسية من حيث التكلفة. إن فهم دورها، إلى جانب Gateways، يجهز الفرق لتصميم بنيات تحتية قوية لـ AI تلبي احتياجات الأعمال المتنوعة.
مع استمرار تطور AI models وتعددها، سيكون إتقان التوجيه الذكي والوصول المنظم أمرًا حاسمًا للمؤسسات التي تسعى للحفاظ على تنافسيتها في مشهد AI المتقدم بسرعة.
يعمل توجيه LLM عن طريق تقييم الطلبات الواردة وفقًا لمنطق محدد مسبقًا، أو Embeddings دلالية، أو قواعد تصنيف. يقوم النظام بتوجيه الحركة بناءً على السياق، أو الدقة المطلوبة، أو Latency لدى مزود الخدمة. تدير Gateway مركزية هذه التكوينات المعقدة لأتمتة اختيار Model والـ Failover دون الحاجة إلى تغييرات يدوية في الكود لكل تحديث لـ Model.
يستخدم تصنيف توجيه LLM نموذجًا عالي الكفاءة لتصنيف Prompts قبل تنفيذ Inference. تحدد هذه الخطوة القصد، مثل التحيات البسيطة مقابل مهام البرمجة المعقدة. يمنع التصنيف المؤتمت الاستخدام المفرط لـ Frontier models المكلفة عن طريق توجيه الاستعلامات منخفضة التعقيد إلى بدائل أصغر وأسرع وأكثر فعالية من حيث التكلفة.
تجمع TrueFoundry بين قدرات توجيه LLM و AI Gateway من خلال دمج تنسيق الحركة مع الحوكمة والأمان. تتعامل المنصة مع Failover الخاص بـ Model، و Rate limiting، والتوجيه المراعي للتكلفة ضمن لوحة تحكم مركزية واحدة. تضمن هذه البنية التحتية أن تكون عمليات نشر enterprise AI عالية المرونة وفعالة من حيث التكلفة لبيئات الإنتاج واسعة النطاق.
تشمل أبرز LLM routers منصة TrueFoundry للتنسيق على مستوى المؤسسات، و LiteLLM لـ unified proxy API، و Martian لاختيار Model المؤتمت. تشمل الخيارات الرائدة الأخرى في القطاع Portkey لـ Guardrails المتقدمة، و Helicone لـ Observability فائقة السرعة، و OpenRouter للوصول البسيط إلى المئات من Open-source و Closed-source models.
تفحص LLM Routers البيانات الوصفية للاستعلام ونوعه وسياقه لاختيار Model. تتضمن عوامل الاختيار الخبرة في المجال، وقدرة الاستدلال، و Latency، والتكلفة. تذهب الاستعلامات البسيطة إلى Models خفيفة الوزن، والمهام المعقدة إلى Models عالية القدرة. قد تستخدم Routers المتقدمة Embeddings أو مصنفات التنبؤ للتوجيه الذكي لـ Model في الوقت الفعلي.
تتضمن الوظائف الأساسية لـ LLM router تحليل الطلبات، واختيار Model الذكي، وموازنة الحمل (Load balancing)، ومعالجة Fallback، والمراقبة. تقوم Routers بتوزيع الاستعلامات عبر LLMs متعددة، وإعادة توجيه الطلبات الفاشلة، وتتبع الأداء. يضمن هذا معالجة المهام بكفاءة، واستغلال Models بشكل أمثل، وبقاء النظام موثوقًا وقابلاً للتوسع في سير عمل enterprise AI.
تشمل الأنواع الشائعة لـ LLM routers التوجيه القائم على القواعد (Rule-based routing)، والتوجيه القائم على التكلفة (Cost-based routing)، والتوجيه القائم على الأداء (Performance-based routing)، والتوجيه القائم على المهمة (Task-based routing). تتبع Routers القائمة على القواعد شروطًا محددة مسبقًا، وتختار Routers القائمة على التكلفة models أرخص، وتحدد Routers القائمة على الأداء models ذات دقة أو سرعة أفضل، بينما ترسل Routers القائمة على المهام الطلبات إلى models متخصصة في مهام مثل البرمجة أو المحادثة أو التلخيص.
يتم توجيه LLM عن طريق تحليل طلب المستخدم وتوجيهه إلى Model الأكثر ملاءمة. يحدد المطورون القواعد أو يستخدمون خوارزميات تأخذ في الاعتبار عوامل مثل نوع المهمة، والتكلفة، و Latency، وقدرة Model. تقوم طبقة التوجيه بتقييم المدخلات وإرسال الاستعلام تلقائيًا إلى LLM المناسب.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد





















