احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.
٩.٩
رسم خريطة سوق الذكاء الاصطناعي المحلي (On-Prem): من الشرائح إلى مستويات التحكم
مع دفع المؤسسات بـ GenAI إلى بيئة الإنتاج، يعيد العديد منها اكتشاف فوائد النشر المحلي (on-premise) — سواء للحد من تكاليف السحابة، أو لتلبية متطلبات الامتثال الصارمة، أو لتقديم زمن استجابة منخفض للغاية. ولكن البنية التحتية للذكاء الاصطناعي المحلي ليست جهازًا واحدًا يمكنك تركيبه في الرف ونسيانه. بل هي منظومة متعددة الطبقات من العتاد، والتنسيق، ومنصات البيانات، وأطر عمل التقديم التي يجب أن تعمل جميعها بتناغم.
يقدم هذا الدليل جولة في كل طبقة من طبقات البنية التحتية الحديثة للذكاء الاصطناعي المحلي ويشرح القيمة المقدمة لكل مكون.
لماذا يكتسب الذكاء الاصطناعي المحلي (On-Premise) زخمًا متزايدًا
تواجه المؤسسات في قطاعات التمويل، والرعاية الصحية، والتصنيع، والقطاع الحكومي لوائح تنظيمية أشد قسوة بشأن سيادة البيانات، وارتفاع فواتير السحابة، واتفاقيات مستوى الخدمة (SLAs) للأداء التي لا تستطيع السحابة العامة تلبيتها دائمًا. وتُشكل هذه الطبقات معًا الأساس لـ منصة ذكاء اصطناعي محلي (on premise AI platform) يمكن للمؤسسات توسيعها وحوكمتها وتشغيلها بشكل مستقل عن قيود السحابة العامة.
التحكم في البيانات والامتثال: الحفاظ على البيانات الحساسة بالكامل خلف الجدار الناري الخاص بك. عند إرسال البيانات إلى سحابة عامة، قد يصبح موقعها الجغرافي الفعلي والولاية القضائية التي تخضع لها أمراً غامضاً، مما يخلق مخاطر امتثال كبيرة ويعقد عمليات التدقيق. يسمح الإعداد المحلي للمؤسسة بتخصيص البنية التحتية للذكاء الاصطناعي بالكامل لتتوافق مع هذه اللوائح، مما يوفر إطاراً قابلاً للدفاع عنه يلتزم بالمعايير القانونية ويتجنب تعقيدات قضايا نقل البيانات عبر الحدود.
الأداء وزمن الاستجابة: الدمج في نفس الموقع بين الحوسبة والتخزين للاستدلال في الوقت الفعلي. من خلال معالجة البيانات محليًا، يمكن للذكاء الاصطناعي المحلي تقديم زمن استجابة أقل بكثير والأهم من ذلك أنه أكثر قابلية للتنبؤ. يُعد هذا الأداء المتسق وعالي الإنتاجية ضروريًا للتطبيقات التي تتطلب اتخاذ قرارات فورية متداخلة الأنواع، مثل تحليل تدفق بيانات المستشعرات مع إحالتها إلى السجلات التاريخية. تمتد ميزة الأداء هذه لتشمل التكامل مع الأنظمة المؤسسية الحالية. وبفضل مرونتها وقابليتها للتخصيص، غالبًا ما يمكن دمج الحلول المحلية بسهولة وبثقة أكبر مع قواعد البيانات القديمة، وأنظمة ERP، وغيرها من التقنيات التشغيلية التي قد لا تكون متوافقة مع البيئات السحابية القياسية.
إمكانية التنبؤ بالتكاليف: الانتقال من معدلات الدفع حسب الاستخدام المتغيرة إلى الاستثمارات الثابتة في البنية التحتية. يمكن للرسوم الخفية لنقل البيانات للخارج (data egress)، واستدعاءات API، وتدريج التخزين، وأسعار الحوسبة المتذبذبة أن تأكل سريعًا الفوائد الأولية لـ CapEx المنخفض، مما يؤدي إلى ما وصفته بعض التحليلات بـ "الهدر الخالص" في الإنفاق السحابي. في المقابل، يوفر النشر المحلي، على الرغم من تكلفته الأولية العالية، نفقات تشغيلية (OpEx) طويلة الأجل يمكن التنبؤ بها وإدارتها. بالنسبة للمؤسسات التي لديها استخدام مستمر للذكاء الاصطناعي، غالبًا ما تثبت البنية التحتية المحلية أنها الخيار الأقل تكلفة على مدى أفق زمني من ثلاث إلى خمس سنوات.
التكامل المخصص: الاتصال بسلاسة مع الأنظمة القديمة، أو أجهزة الحافة (edge devices)، أو الأجهزة المملوكة للشركة.
ومع ذلك، فإن بناء وتشغيل هذه البنية التحتية داخليًا يتطلب نفقات رأسمالية، ومتطلبات لكفاءات متخصصة، وأعباء صيانة مستمرة.
ما هي البنية التحتية الحديثة للذكاء الاصطناعي المحلي؟
البنية التحتية الحديثة للذكاء الاصطناعي المحلي هي نظام معقد متعدد الطبقات يلعب فيه كل مكون دورًا حاسمًا. إنها ليست كيانًا موحدًا بل منظومة مترابطة من العتاد والبرامج المصممة لتقديم قدرات ذكاء اصطناعي قوية، وقابلة للتوسع، وكفؤة. يتطلب فهم هذه البنية تفكيكها طبقة تلو الأخرى، بدءًا من البنية التحتية المادية التي توفر القوة الخام وصولاً إلى المنصات عالية المستوى التي تمكّن سير عمل الذكاء الاصطناعي
في جوهرها، تجمع البنية التحتية للذكاء الاصطناعي المحلي بين:
البنية التحتية المادية (الحوسبة، التخزين، الشبكات)
تنسيق الموارد (الافتراضية، الحاويات، Kubernetes)
منصات البيانات وML (بحيرات البيانات، أدوات MLOps)
التقديم في الإنتاج (أطر عمل الاستدلال، التوسع، الحوكمة)
يجب هندسة كل طبقة لتحقيق أقصى قدر من الاستفادة، وضمان الموثوقية، والسماح بالتوسع السلس — دون الانحصار مع مورد واحد.
العتاد والبنية التحتية المادية
هذا هو الأساس للبنية التحتية للذكاء الاصطناعي بأكملها، والتجسيد المادي للقوة الحوسبية. وهو يتألف من محركات الحوسبة التي تجري الحسابات، وأنظمة التخزين التي تحتفظ بمجموعات البيانات الضخمة، ونسيج الشبكات الذي يربط كل شيء. يحدد أداء هذه الطبقة وقيودها إمكانيات جميع الطبقات اللاحقة
محركات الحوسبة
وحدات GPUs: صُممت وحدات GPUs في الأصل لتقديم الرسومات ثلاثية الأبعاد، وقد أصبحت الحصان الرابح في ثورة الذكاء الاصطناعي نظرًا لبنيتها المتوازية بشكل ضخم. فرضت NVIDIA موقعًا مهيمنًا في هذه السوق من خلال وحدات GPUs لمراكز البيانات، مثل A100، وH100، وسلسلة B200 القادمة. هذه الشرائح، المجهزة بآلاف النوى المتخصصة (مثل Tensor Cores)، يمكنها تقديم أداء لتدريب الذكاء الاصطناعي أسرع بما يصل إلى 20 مرة من وحدات CPUs التقليدية. وهي تمثل المعيار الفعلي الحالي لبناء عناقيد تدريب الذكاء الاصطناعي المحلية عالية الأداء.
وحدات CPUs: بينما تتولى وحدات GPUs العبء الأكبر من المعالجة المتوازية، تظل وحدات CPUs مكونات أساسية لخادم الذكاء الاصطناعي. فهي تدير عمليات النظام الإجمالية، وتتولى مهام المعالجة التسلسلية، وتنسق تدفق البيانات من وإلى وحدات GPUs. يوفر أحدث جيل من وحدات CPUs متعددة النوى من Intel وAMD القوة الحوسبية العامة اللازمة لدعم المسرعات المتخصصة
شرائح ASICs/TPUs: التوجه الناشئ والمحدث لتغيير جذري في حوسبة الذكاء الاصطناعي هو صعود الدوائر المتكاملة المخصصة لتطبيقات معينة (ASICs). هذه الشرائح صُممت من الصفر لغرض واحد: تشغيل أعباء عمل الذكاء الاصطناعي. وتُعد وحدات Tensor Processing Units (TPUs) من Google مثالاً بارزًا، حيث تم تحسينها لعمليات المصفوفات التي تقع في قلب الشبكات العصبية. في السوق المحلي، تتحدى فئة جديدة من الشركات الناشئة احتكار GPUs بشرائح ASICs متخصصة. تقوم شركات مثل Groq بتطوير شرائح للاستدلال ذي زمن الاستجابة المنخفض للغاية، بينما تقوم SambaNova Systems وCerebras بإنشاء بنيات مبتكرة (Reconfigurable Dataflow Units وWafer-Scale Engines، على التوالي) تعد بتكلفة إجمالية للملكية (TCO) وكفاءة طاقة أفضل لعمليات التدريب والاستدلال واسعة النطاق. تمثل هذه المسرعات المتخصصة مستقبل عتاد الذكاء الاصطناعي، حيث تقدم مسارًا يتجاوز قيود الطاقة والتكلفة للـ GPUs العامة.
خوادم المؤسسات والتخزين
الخوادم عالية الأداء: يقدم موردو عتاد المؤسسات الرائدون مثل Hewlett Packard Enterprise (HPE) مع خطوط ProLiant وApollo، وDell Technologies مع خوادم PowerEdge، وSupermicro، وIBM مع أنظمة Power Systems، هيكل الخادم للذكاء الاصطناعي المحلي. هذه ليست خوادم قياسية؛ بل تم هندستها خصيصًا لاستيعاب وحدات GPUs متعددة عالية الطاقة، وتوفير كميات هائلة من الذاكرة عالية السرعة (RAM)، ودمج حلول تبريد متقدمة للتعامل مع الانبعاث الحراري للمسرعات.
التخزين عالي الأداء: يتميز الذكاء الاصطناعي بالتغذية على البيانات، ويجب أن توفر طبقة التخزين وصولاً سريعًا ومتزامنًا إلى مجموعات البيانات الضخمة دون التسبب في اختناق. يتطلب هذا الانتقال لما هو أبعد من التخزين التقليدي. تُعد حلول التخزين عالية الأداء ذات زمن الاستجابة المنخفض مثل محركات NVMe (Non-Volatile Memory Express) SSDs وأنظمة الملفات الموزعة أمرًا أساسيًا. يتم تنظيم البيانات نفسها عادةً في بحيرات بيانات (data lakes) لتخزين كميات هائلة من البيانات الخام غير الهيكلية (الصور، النصوص، السجلات) ومستودعات بيانات (data warehouses) للبيانات الهيكلية الجاهزة للتحليل. يُعد المكون الناشئ الحاسم، خاصة للذكاء الاصطناعي التوليدي، هو قاعدة البيانات المتجهة (vector database)، والتي تم تحسينها لتخزين واستعلام التضمينات المتجهة عالية الأبعاد التي تمثل البيانات غير الهيكلية.
الشبكات عالية السرعة
تقدم أنسجة InfiniBand & RDMA ما يصل إلى 400 جيجابت في الثانية من إنتاجية زمن الاستجابة المنخفض، مما يضمن استمرار تزويد وحدات GPUs بالبيانات أثناء التدريب الموزع أو الاستدلال المتوازي. طبقة الشبكات هي "النظام العصبي" لمركز بيانات الذكاء الاصطناعي، وهي المسؤولة عن النقل السلس للبيانات بين أنظمة التخزين وعقد الحوسبة. بالنسبة للذكاء الاصطناعي واسع النطاق، وخاصة التدريب الموزع حيث يتم تدريب نموذج واحد عبر المئات أو الآلاف من وحدات GPUs، فإن شبكات Ethernet القياسية غير كافية ويمكن أن تصبح اختناقًا رئيسيًا للأداء. لمنع وحدات GPUs القوية من البقاء خاملة أثناء انتظار البيانات، تعتمد عناقيد الذكاء الاصطناعي المحلية على أنسجة شبكات عالية النطاق الترددي ومخفضة زمن الاستجابة. تُعد تقنيات مثل InfiniBand وRDMA (Remote Direct Memory Access) حاسمة. يمكن لـ InfiniBand، على سبيل المثال، دعم إنتاجية تصل إلى 400 جيجابت في الثانية، مما يضمن إمكانية نقل البيانات بين الخوادم والتخزين بالسرعة المطلوبة للحفاظ على الاستغلال الكامل لممحركات الحوسبة. يُعد هذا الربط البيني عالي السرعة مكونًا غير قابل للتفاوض في أي بنية تحتية جادة للذكاء الاصطناعي المحلي.
طبقة التنسيق والإدارة
تقع طبقة التنسيق والإدارة فوق العتاد المادي، وتتكون من البرامج التي تجرّد المورد الأساسية وتقسمها وتديرها. تحول هذه الطبقة مجموعة صلبة من الخوادم المادية إلى منصة مرنة، وقابلة للتوسع، وكفؤة لتطوير وتشغيل تطبيقات الذكاء الاصطناعي.
دور التقنيات الافتراضية والحاويات
التقنيات الأساسية لإدارة المورد هي التقنيات الافتراضية (Virtualization) والحاويات (Containerization). أينما تسمحان بتقسيم أعباء العمل وعزلها بكفاءة.
الآلات الافتراضية (VMs): كانت التقنيات الافتراضية عنصرًا أساسيًا في مركز البيانات لعقود من الزمن. ينشئ برنامج الـ hypervisor آلات افتراضية متعددة على خادم مادي واحد، ولكل منها نظام تشغيل كامل خاص بها. بينما تُعد الآلات الافتراضية قوية ومفهومة جيدًا، إلا أن لها بصمة موارد أكبر وأوقات بدء تشغيل أبطأ مقارنة بالحاويات. ومع ذلك، فإنها تظل ذات صلة، خاصة لتحديث التطبيقات القديمة جنباً إلى جنب مع أعباء عمل الذكاء الاصطناعي الجديدة. تم تصميم منصات مثل IBM Fusion وVates VMS خصيصًا توفير منصة محليّة موحدة يمكنها إدارة كل من VMs والحاويات، وغالباً مع ميزات مثل الوصول المباشر لـ GPU.
الحاويات (مثل Docker): تُعد الحاويات النهج الحديث وخفيف الوزن لعزل أعباء العمل. تقوم الحاوية بحزم التطبيق وجميع تبعياته (المكتبات، ملفات التكوين) في وحدة واحدة محمولة تشارك نواة نظام التشغيل المضيف. ينتج عن هذا بصمة أصغر بكثير، وأوقات بدء تشغيل أسرع، وكفاءة أكبر في الموارد مقارنة بـ VMs. بالنسبة للذكاء الاصطناعي، يعني هذا أنه يمكن تغليف النموذج وبيئته المحددة في صورة حاوية غير قابلة للتغيير. يمكن بعد ذلك نشر هذه الصورة بشكل متسق عبر الكمبيوتر المحمول للمطور، وخادم الاختبار، وعنقود الإنتاج، مما يقضي على مشكلة "كان يعمل على جهازي" ويضمن إمكانية إعادة الإنتاج.
Kubernetes: نظام تشغيل مركز بيانات الذكاء الاصطناعي
بينما يوفر Docker تنسيق الحاوية، يوفر Kubernetes الإدارة على نطاق واسع. Kubernetes هو منصة مفتوحة المصدر تقوم بأتمتة نشر، وتوسع، وشبكات، وإدارة التطبيقات الحاوية عبر عنقود من الآلات. لقد أصبح المعيار بلا منازع لتنسيق الحاويات وهو المحرك وراء معظم التطبيقات السحابية الأصلية الحديثة، سواء في السحابة العامة أو محليًا.
بالنسبة للذكاء الاصطناعي المحلي، يُعد Kubernetes الحلقة الحاسمة بين طبقة التطبيق والعتاد. صُممت توزيعات Kubernetes المؤسسية مثل Red Hat OpenShift خصيصًا للعمليات المحلية والبيئات السحابية الهجينة، مما يوفر الأمان والإدارة والدعم الذي تتطلبه الأعمال.
تُعد فوائد استخدام Kubernetes لأعباء عمل الذكاء الاصطناعي عميقة:
التوسع الآلي وموازنة الحمل: يمكن لـ Kubernetes تلقائيًا زيادة أو تقليل عدد نسخ الحاويات بناءً على الطلب الحوسبي وتوزيع طلبات الاستدلال عبرها، مما يضمن التوافر العالي والأداء.
إدارة الموارد وجدولتها: يمتلك Kubernetes قدرات جدولة واعية بـ GPU، مما يسمح له بوضع أعباء عمل الذكاء الاصطناعي بذكاء على العقد التي يتوفر فيها عتاد المسرعات اللازم، مما يعظم الاستفادة من هذه الموارد المكلفة.
المرونة والتعافي الذاتي: إذا فشلت حاوية أو عقدة، يمكن لـ Kubernetes إعادة تشغيلها أو إعادة جدولتها تلقائيًا على عقدة سليمة، مما يوفر المرونة المطلوبة لوظائف تدريب النماذج طويلة التشغيل وخدمات الاستدلال الحرجة لمهام الشركة.
في جوهره، يوفر Kubernetes نظام تشغيل ديناميكيًا، وآليًا، ومقاومًا للأخطاء لمركز بيانات الذكاء الاصطناعي المحلي.
تمكين البيانات والتعلم الآلي (Data & ML Enablement)
منصات البيانات والحوكمة
هذه هي أعلى طبقة برمجية في البنية التحتية، وتتحوي على الأدوات والمنصات المتخصصة التي يستخدمها علماء البيانات ومهندسو التعلم الآلي لتنفيذ دورة حياة الذكاء الاصطناعي الشاملة. تستفيد هذه الطبقة من العتاد الأساسي والتنسيق لإدارة البيانات وبناء، وتدريب، ونشر، ومراقبة نماذج الذكاء الاصطناعي.
نسيج البيانات (منصات البيانات)
قبل إمكانية بناء أي نموذج، يجب إدارة البيانات. توفر منصات البيانات بيئة موحدة لدورة حياة البيانات بأكملها، من الاستيعاب والمعالجة إلى التخزين والحوكمة.
Cloudera Data Platform (CDP): لاعب رئيسي في مشهد البيانات المحلي والهجين، تطورت Cloudera من جذورها في منظومة Hadoop لتصبح منصة بيانات مؤسسية شاملة. صُمم عرض CDP Private Cloud خصيصًا للعمل محليًا، عادةً فوق عنقود Kubernetes مثل Red Hat OpenShift. ويفر بنية open data lakehouse موحدة يمكنها التعامل مع كل من البيانات الهيكلية وغير الهيكلية بمقياس البيتابايت. بشكل حاسم للذكاء الاصطناعي المؤسسي، فهو يدمج أمانًا قويًا وممركزًا من خلال Apache Ranger وإطار عمل موحد للحوكمة والبيانات الوصفية يسمى Shared Data Experience (SDX)، مما يضمن تطبيق سياسات أمان متسقة على جميع البيانات والتحليلات عبر البيئة الهجينة.
Databricks والاتصال الهجين: بينما يُعد Databricks في المقام الأول منصة سحابية أصلية، فإن بروزها في مجال الذكاء الاصطناعي يعني أن العديد من المؤسسات تبني حلولاً لربط مصادر البيانات المحلية لديها، مثل عنقود Cloudera، ببيئة Databricks الخاصة بها. يؤكد هذا الواقع الطبيعة الهجينة للذكاء الاصطناعي المؤسسي الحديث، حيث غالبًا ما تتطلب جاذبية البيانات الاحتفاظ بمجموعات البيانات الكبيرة محليًا مع الاستفادة من الأدوات السحابية لمهام تحليلية معينة أو للتعاون.
عمليات التعلم الآلي (MLOps) والتجريب
تُعد MLOps (Machine Learning Operations) مجموعة من الممارسات التي تهدف إلى نشر نماذج التعلم الآلي وصيانتها في الإنتاج بشكل موثوق وكفء. منصات MLOps هي الأدوات التي تمكّن هذه الممارسات، حيث تقوم بأتمتة دورة حياة ML بأكملها وتجسير الفجوة بين علوم البيانات (بناء النماذج) وعمليات تقنية المعلومات (تشغيلها في الإنتاج).
تشمل الوظائف الرئيسية لمنصة MLOps: تتبع التجارب (تسجيل جميع المعلمات والمقاييس والمخرجات)، وإصدار النماذج وسجلها، وبناء خطوط تجميع CI/CD (Continuous Integration/Continuous Deployment) الآلية للنماذج، وإدارة نشر النماذج، ومراقبة أداء النماذج لمشكلات مثل انحراف البيانات (data drift).
تتميز سوق MLOps المحلية بمزيج من المنصات القوية مفتوحة المصدر والتجارية:
المصدر المفتوح: يُعد MLflow منصة MLOps مفتوحة المصدر رائدة، وتُستخدم على نطاق واسع لمرونتها، ونهجها المستقل عن أطر العمل، وميزاتها الشاملة لتتبع التجارب وإدارة النماذج. وتسمح للفرق ببناء سير عمل MLOps قوي دون الانحصار مع مورد معين.
المنصات التجارية: تقدم المنصات المُدارة بالكامل الشاملة مثل DataRobot وIguazio (التي استحوذت عليها McKinsey) حلولاً شاملة تغطي دورة الحياة بأكملها، وغالبًا ما تركز على سهولة الاستخدام، والأتمتة، والدعم بمستوى المؤسسات.
قم بتعزيز اختيار المنصة باستخدام AI Gateway RBAC، والضوابط (guardrails)، والميزانيات من TrueFoundry لضمان تطبيق السياسات بسلاسة عبر الفرق والنماذج
تقديم الذكاء الاصطناعي وتوسيعه في الإنتاج
بمجرد تدريب النموذج والتحقق من صحته، يجب نشره في بيئة الإنتاج حيث يمكنه استقبال بيانات المدخلات وإعادة التوقعات — وهي عملية تُسمى الاستدلال. تقديم النماذج هو مهمة متخصصة تتطلب برامج تم تحسينها للإنتاجية العالية وزمن الاستجابة المنخفض.
NVIDIA Triton Inference Server: خادم استدلال مفتوح المصدر وعالي الأداء من NVIDIA. نقاط قوته الرئيسية هي قدرته على تشغيل النماذج من أي إطار عمل تقريبًا (TensorFlow، PyTorch، ONNX، إلخ) وقدرته على التنفيذ المتزامن للنماذج، مما يسمح لتشغيل نماذج متعددة أو نسخ متعددة من نفس النموذج على وحدة GPU واحدة، مما يعظم الاستفادة من العتاد.
KServe: معيار لتقديم النماذج على Kubernetes. يوفر KServe منصة قابلة للتوسع والتوسيع لنشر النماذج. تشمل ميزاته البارزة قدرات الاستدلال خالي الخادم (Serverless) (مع التوسع الآلي الذي يمكنه تقليل الـ pods إلى الصفر عند عدم الاستخدام، مما يوفر الموارد) و"InferenceGraph" الذي يدعم استراتيجيات النشر المتقدمة مثل عمليات النشر التدريجي (canary rollouts)، وتطبيقات اختبار A/B، ومجموعات النماذج (model ensembles).
Seldon Core: منصة أخرى قوية ومفتوحة المصدر لتقديم النماذج لـ Kubernetes. يُعرف Seldon Core أيضًا بدعمه القوي لأنماط النشر المتقدمة، بما في ذلك اختبارات A/B، وعمليات النشر التدريجي (canary)، وmulti-armed bandits (MABs)، مما يجعله خيارًا قويًا للمؤسسات التي تحتاج إلى اختبار النماذج وتحسينها بدقة في الإنتاج.
أطر عمل أخرى: تتضمن المنظومة أيضًا أدوات قوية أخرى مفتوحة المصدر مثل Haystack، وهو إطار عمل لبناء خطوط معالجة وكيلة (agentic) وRAG معقدة، وRay، وهو محرك حوسبة موزع يُستخدم غالبًا كرباط أساسي لتدريب وتقديم تطبيقات الذكاء الاصطناعي واسعة النطاق.
تعمل TrueFoundry كـ مستوى بوابة/تحكم أعلى هذه الخوادم، بحيث يمكنك المزج والمطابقة (Triton لنماذج CV، وvLLM لـ LLMs، وKServe للحواف خالية الخادم) مع الحفاظ على واجهة واحدة، وسياسة واحدة، وطبقة قياس عن بُعد متسقة.
طبقة التطبيقات والتحكم: AI Gateway وMCP
تفر الطبقات الموصوفة حتى الآن الأساس لبناء ونشر نماذج الذكاء الاصطناعي. ومع ذلك، لجعل هذه النماذج متاحة بأمان وكفاءة لتطبيقات المستخدم النهائي ولتمكين سير العمل الوكيلي (agentic) المعقد، يلزم وجود طبقة برمجية نهائية: طبقة التطبيقات والتحكم. تعمل هذه الطبقة كنظام عصبي مركزي لجميع تفاعلات الذكاء الاصطناعي، حيث توفر الحوكمة والأمان وواجهة قياسية للاتصال. وتتكون من مكونين حاسمين وناشئين: بوابة الذكاء الاصطناعي (AI Gateway) بروتوكول سياق النموذج (Model Context Protocol - MCP).
بوابة الذكاء الاصطناعي (AI Gateway): مستوى تحكم ممركز
بوابة الذكاء الاصطناعي هي برمجية وسيطة متخصصة تعمل كنقطة تحكم واحدة وممركزة لجميع حركة مرور الذكاء الاصطناعي بين التطبيقات ونماذج الذكاء الاصطناعي الأساسية. يفر نشرها داخل البيئة المحلية، غالبًا على Kubernetes، مجموعة حاسمة من الوظائف لإدارة الذكاء الاصطناعي على نطاق المؤسسة.
وصول موحد وتوجيه ذكي: توفر البوابة نقطة نهاية API واحدة ومتسقة للمطورين، مما يجرد تعقيد التفاعل مع نماذج مختلفة متعددة (مثل مزيج من النماذج مفتوحة المصدر الضبط الدقيق والنماذج التجارية المتخصصة). ويمكنها إجبار توجيه قائم على السياق، وتوجيه الطلبات إلى النموذج الأكثر ملاءمة بناءً على عوامل مثل التكلفة، أو متطلبات الأداء، أو حالة الاستخدام المحددة، مما يحسن الكفاءة والنتائج معًا.
أمان قوي وحوكمة: بالنسبة للذكاء الاصطناعي المحلي، يُعد الأمان أمرًا بالغ الأهمية. تعمل AI Gateway كنقطة فرض للسياسات، وتتكامل مع بنية أمان المؤسسة لإدارة المصادقة، والتفويض، والتحكم في الوصول القائم على الدور (RBAC). وتتفحص كل من الأوامر الموجهة (prompts) الواردة والاستجابات الصادرة في الوقت الفعلي لمنع هجمات حقن الأوامر (prompt injection) وتسريب البيانات الحساسة مثل معلومات الهوية الشخصية (PII)، مما يضمن الامتثال للوائح مثل GDPR وHIPAA.
رؤية شاملة وتحكم في التكاليف: توفر البوابة لوحة قيادة موحدة لمراقبة جميع تفاعلات الذكاء الاصطناعي، وتتبع المقاييس الرئيسية مثل زمن الاستجابة، ومعدلات الأخطاء، واستخدام الرموز (token usage). تُعد هذه الرؤية الممركزة حاسمة لاستكشاف الأخطاء وإصلاحها وتحسين الأداء. علاوة على ذلك، فهي تمكّن من التحكم الدقيق في التكاليف من خلال فرض تحديد معدل الاستخدام بناءً على الرموز وميزانيات الاستخدام، مما يمنع التكاليف الخارجة عن السيطرة ويسمح بإعادة تحصيل التكاليف بدقة من وحدات الأعمال المختلفة.
بروتوكول سياق النموذج (MCP): اللغة العالمية لوكلاء الذكاء الاصطناعي
بينما تدير AI Gateway تدفق الطلبات، يُعد بروتوكول سياق النموذج (MCP) معيارًا مفتوحًا يحدث ثورة في ما يمكن لهذه الطلبات القيام به. يوفر MCP طريقة قياسية لنماذج الذكاء الاصطناعي لاكتشاف التفاعل مع الأدوات، والبيانات، والخدمات الخارجية، مما يحولها من "عقول" معزولة إلى وكلاء قادرين ومدمجين.
واجهة موحدة للأدوات: بدلاً من كتابة كود برمجي مخصص وهش لكل تكامل، يتيح MCP لأنظمة المؤسسات (مثل قواعد البيانات، أو أنظمة CRM، أو APIs الداخلية) الإعلان عن قدراتها من خلال "MCP server" خفيف الوزن. يمكن لتطبيق AI، الذي يعمل كـ "MCP host"، الاستعلام من هذه السيرفرات لفهم الأدوات المتاحة وكيفية استخدامها، مما ينشئ عملياً منظومة توصيل وتشغيل (plug-and-play) لوكلاء AI.
تمكين Agentic AI الداخلي (On-Premise): تتمثل الميزة الرئيسية لـ MCP في أنه بروتوكول مفتوح وقابل التدقيق يمكن نشره بالكامل داخل جدار الحماية الخاص بالمؤسسة. يتيح هذا للمؤسسات بناء وكلاء AI مستقلين وأقوياء يمكنهم التفاعل بأمان مع الأنظمة الداخلية الخاصة دون تعريض البيانات الحساسة للخدمات الخارجية.
منع الانغلاق على مورد معين (Vendor Lock-In): نظرًا لأن MCP هو معيار مستقل عن النماذج ومدعوم من أطراف رئيسية مثل Anthropic وOpenAI وMicrosoft، فإنه يفصل نموذج AI عن تكاملات الأدوات. يمنح هذا المؤسسات المرونة لاستبدال نموذج LLM الأساسي — على سبيل المثال، الانتقال من API تجاري إلى نموذج مُضبط دقيقاً ومستضاف ذاتياً — دون الحاجة إلى إعادة بناء بنية التكامل بالكامل، مما يحافظ على السيادة التكنولوجية.
معاً، يشكل كل من AI Gateway وMCP طبقة تحكم وتطبيق قوية تجعل AI الداخلي (On-Premise) ليس ممكناً فحسب، بل آمنًا ومُدارًا ومدمجًا بحق في نسيج المؤسسة.
يجمع MCP Gateway من TrueFoundry بين الاثنين: الحوكمة والأنظمة المراقبة (Observability) لكل طلب، بالإضافة إلى استدعاء أدوات آمن ومُدقق عبر MCP حتى تتمكن الوكلاء من العمل على أنظمتك الداخلية دون خروج البيانات من شبكتك.
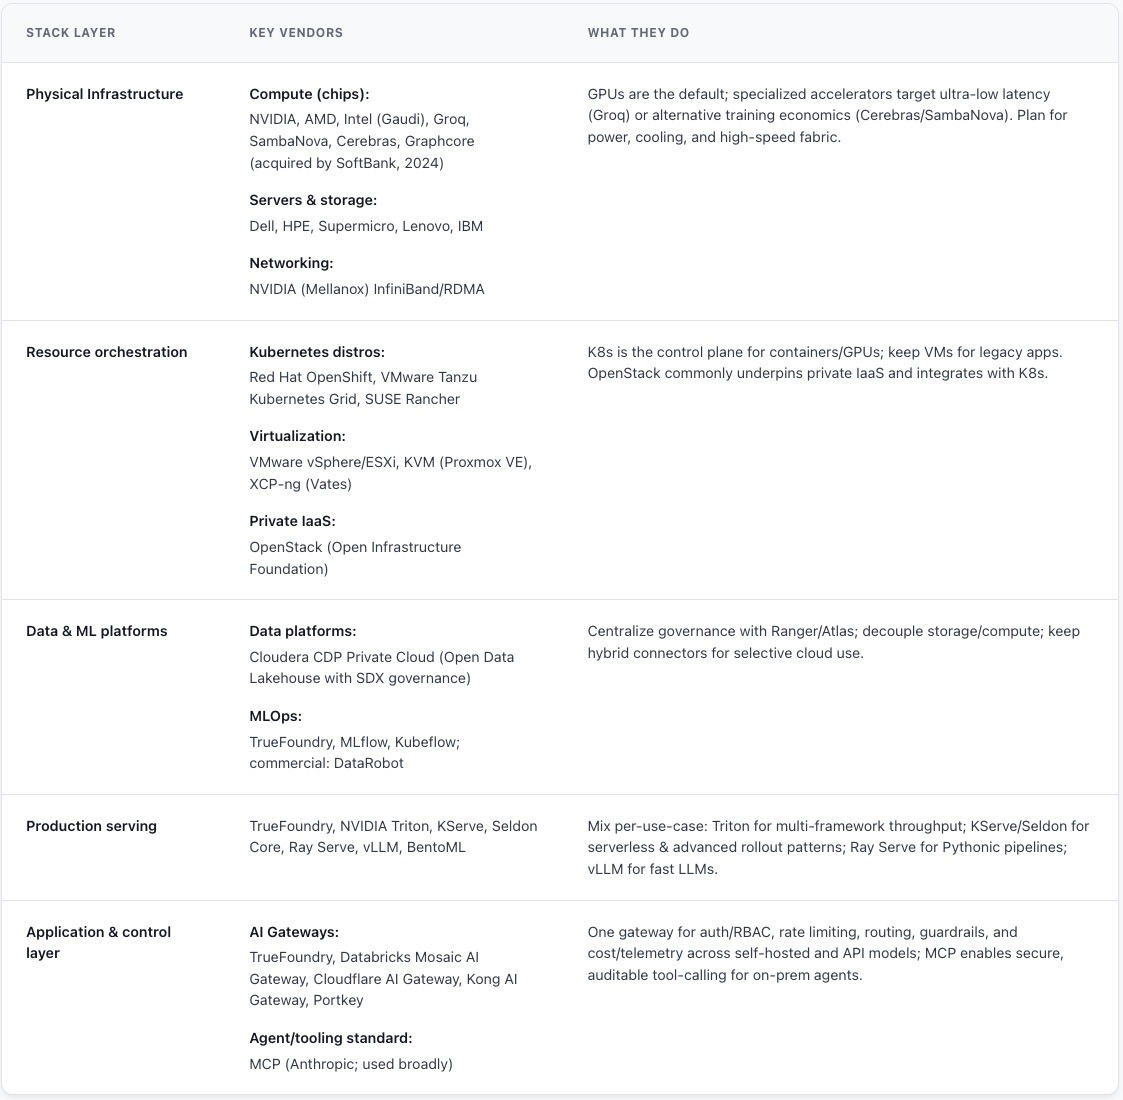
تحديد الموردين عبر طبقات بنية AI الداخلية (On-Premise)
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.