


نوفمبر 18, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
أطلقت Anthropic النموذج الثالث في عائلة Claude 5.5. تم إطلاق Claude Haiku 5.5 يوم الأربعاء 7 أكتوبر، وهو موجود بالفعل في كتالوج نماذج TrueFoundry AI Gateway مع تعبئة الأسعار وحدود السياق والإمكانيات.
يمكنك استدعاؤه من نفس نقطة النهاية المتوافقة مع OpenAI التي تستخدمها لجميع النماذج الأخرى. لا حاجة لـ SDK جديد، ولا تكامل منفصل، ولا انتظار لإصدار جديد من Gateway. كل ما عليك هو تغيير سلسلة النموذج إلى claude-haiku-5-5 وستنتقل إلى النموذج الجديد.
جرب Claude Haiku 5.5 على TrueFoundry AI Gateway ←
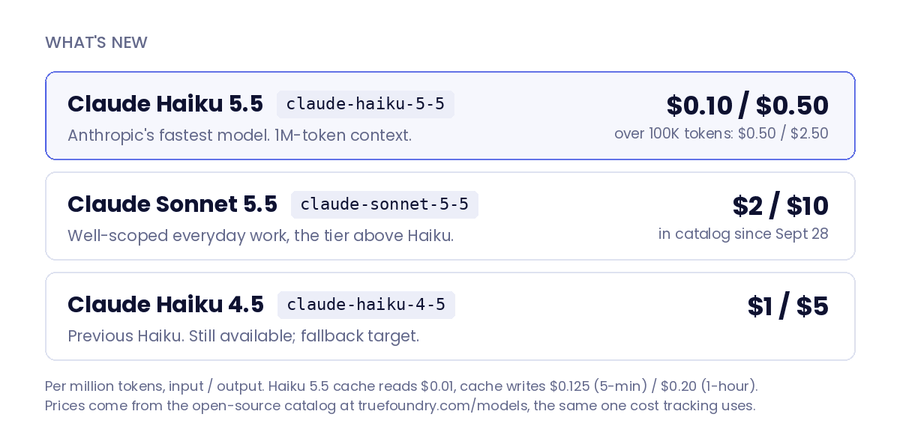
صممت Anthropic نموذج Haiku 5.5 للأعمال ذات الأحجام الكبيرة والحساسة لزمن الاستجابة: التصنيف، التوجيه، الاستخراج، التلخيص، ضغط السياق، ومهمات الوكلاء الفرعيين (subagents). الأرقام المهمة لميزانية الإنتاج:
تتم عادةً ترقيات Haiku بالمقايضة بين الإمكانيات والسعر. وفقاً للنتائج المنشورة من Anthropic، يكتسب هذا النموذج الكثير من الإمكانيات بسعر أقل. في اختبار Terminal-Bench 4.0، حقق Haiku 5.5 نتيجة 39.2% مقابل 0.0% لـ Haiku 4.5 و 16.4% لـ GPT-6 Luna الذي يُسعّر بنفس التكلفة $0.10 / $0.50. وفي OSWorld 2.1 (المجموعة الفرعية غير المتصلة بالإنترنت) وصل إلى 72.4% مقابل 15.7% و 48.9%، وفي GDPval-AA v2.1 حقق 1620 Elo مقارنة بـ 735 لـ Haiku 4.5 و 1437 لـ Luna.
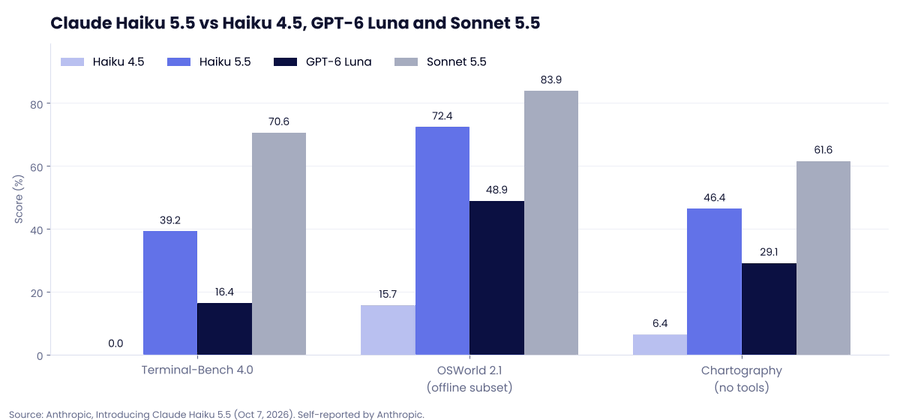
ملاحظتان مهمتان. هذه الأرقام هي الخاصة بـ Anthropic نفسها، ويبقى Sonnet 5.5 متقدماً بفارق كبير في البرمجة المعتمدة على الوكلاء (70.6% على Terminal-Bench 4.0) وفي الأعمال المعرفية الطويلة. قم بإجراء تقييماتك الخاصة على حركة المرور لديك قبل نقل أي بيئة عمل.
عند وضع النماذج الحالية جنباً إلى جنب: GPT-6 Luna و Haiku 5.5 بـ $0.10 لكل مليون توكن مدخلات، و Haiku 4.5 بـ $1، و Sonnet 5.5 بـ $2، و Opus 5.5 بـ $4، و Claude Fable 5.1 بـ $10. يتشارك Haiku 5.5 الدرجة السفلى مع Luna، ووفقاً لمقارنة Anthropic، فإنه يتفوق عليه في جميع الاختبارات المرجعية التي خضع لها كلا النموذجين.
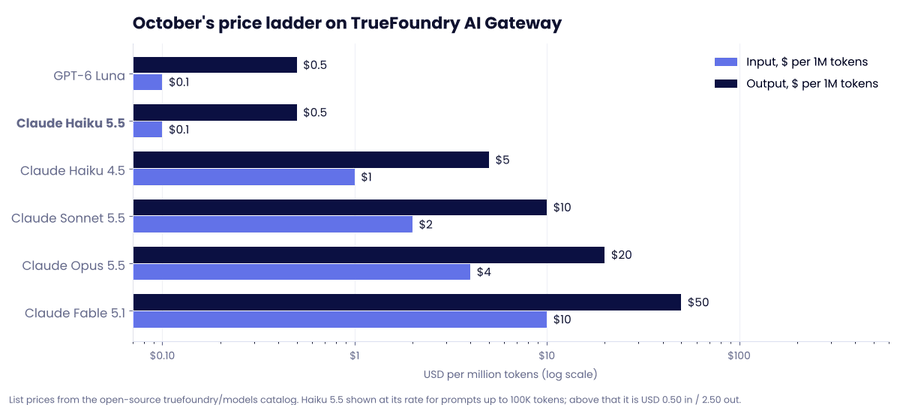
هذه هي الحجة للتعامل مع اختيار النموذج كتهيئة لـ gateway بدلاً من كونه كوداً برمجياً للتطبيق. تتكون معظم حركة مرور الإنتاج من عدد كبير من الطلبات القصيرة والبسيطة وعدد صغير من الطلبات الصعبة. إذا ذهبت الأغلبية البسيطة إلى Haiku 5.5 وذهب الباقي إلى Sonnet 5.5 أو Opus 5.5، فلن تشبه الفاتورة المجمعة فاتورة تعتمد كلياً على Sonnet. هذا يعمل فقط عندما يكون التغيير عبارة عن تعديل في التهيئة، وهو الغرض الأساسي من AI Gateway.
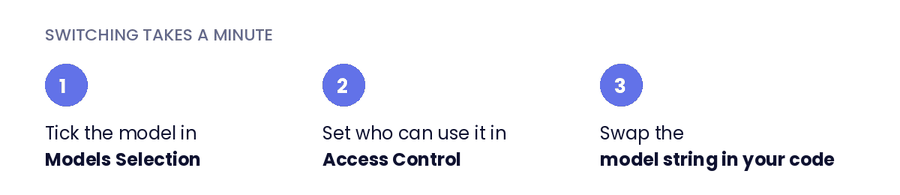
الخطوة 1: تمكين النموذج في حساب المزود الخاص بك. في الـ gateway، افتح Models ← حساب Anthropic الخاص بك ← Models Selection، وابحث عن claude-haiku-5-5 وقم بتحديده. تظهر الأسعار في نفس السطر ($0.10 للمدخلات / $0.50 للمخرجات لكل 1M توكن) لأنها تأتي مباشرة من الكتالوج. ثم اضبط Access Control بحيث يتم تحديد نطاق النموذج للفرق والمفاتيح الافتراضية المناسبة منذ اليوم الأول.
إذا كنت تشغل Claude عبر السحاب، فإن هذه المسارات موجودة في الكتالوج أيضاً: AWS Bedrock (الملفات الشخصية العامة، ولأمريكا الشمالية، وأوروبا، واليابان، وأستراليا)، و Google Vertex AI، و Microsoft Foundry، و OpenRouter، و Perplexity. نقاط النهاية الإقليمية ومناطق البيانات تُسعّر بـ $0.11 / $0.55. ألا ترى النموذج في قائمتك بعد؟ خيار + Add Model في أسفل القائمة يضيفه يدوياً.
الخطوة 2: استدعاؤه. افتح Playground، واختر النموذج، وانسخ البرمجية المجهزة في أي SDK تستخدمه. نسق OpenAI بلغة Python:
تتم تسمية معرفات النماذج ضمن مساحة أسماء كـ <حساب-المزود-الخاص-بك>/<النموذج>، لذا فإن التبديل بين anthropic-prod/claude-haiku-4-5 و anthropic-prod/claude-haiku-5-5 يتم بسطر واحد فقط. يقوم رأس X-TFY-METADATA بوسم كل استدعاء حتى يظهر الإنفاق حسب الفريق أو الميزة في عرض المقاييس.
الخطوة 3 (اختياري): وضعه خلف نموذج افتراضي. أنشئ نموذجاً افتراضياً واختر Auto Routing. يقوم الـ gateway بتصنيف كل طلب كبسيط، أو متوسط، أو معقد، ويرسله إلى الهدف الذي تخصصه لتلك الشريحة. استخدام Haiku 5.5 للطلبات البسيطة، و Sonnet 5.5 للمتوسطة، و Opus 5.5 للمعقدة، مع Haiku 4.5 كخيار احتياطي (fallback) أثناء استقرار حدود المعدلات في أسبوع الإطلاق، يُعد خريطة بدائية منطقية. في اختباراتنا المرجعية، خفض هذا النوع من التوجيه التكلفة بنسبة 50-70% عند حوالي 98% من الجودة. يستدعي تطبيقك اسم نموذج واحد فقط طوال الوقت.
Haiku 5.5 هو النموذج للجزء الأكبر من حركة المرور لديك: التصنيفات، الاستخراجات، استدعاءات التوجيه، وخطوات الوكلاء الفرعيين التي تعمل آلاف المرات يومياً. تشغيله عبر TrueFoundry يعني أن القرار بشأن الطلبات التي يتعامل معها يقع في تهيئة gateway، حيث يمكنك تغييره دون الحاجة لنشر كود جديد (deploy).
جرب Claude Haiku 5.5 على TrueFoundry AI Gateway ←
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد

















