



November 14, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
بعد أسبوع واحد فقط من إدراج GPT-6 Sol في الكتالوج، أطلقت OpenAI خليفته. GPT-6.1 Sol صدر يوم الثلاثاء 29 سبتمبر، وهو متوفر بالفعل في كتالوج نماذج بوابة TrueFoundry للذكاء الاصطناعي مع تفاصيل الأسعار وحدود السياق والقدرات.
يمكنك استدعاؤه من نفس نقطة النهاية المتوافقة مع OpenAI التي تستخدمها لكل شيء آخر. لا حاجة لمجموعة تطوير برمجية (SDK) جديدة، ولا تكامل منفصل، ولا انتظار لإصدار تحديث للبوابة. قم بتغيير سلسلة النموذج إلى gpt-6.1-sol على حساب OpenAI الخاص بك (openai/gpt-6.1-sol على OpenRouter) وستكون قد بدأت باستخدام النموذج الجديد.
جرب GPT-6.1 Sol على بوابة TrueFoundry للذكاء الاصطناعي ←
يحل GPT-6.1 Sol محل GPT-6 Sol بنفس السعر المعلن، مع تكلفة أقل للذاكرة المؤقتة ونفس الحدود. الأرقام التي تهم ميزانية الإنتاج هي:
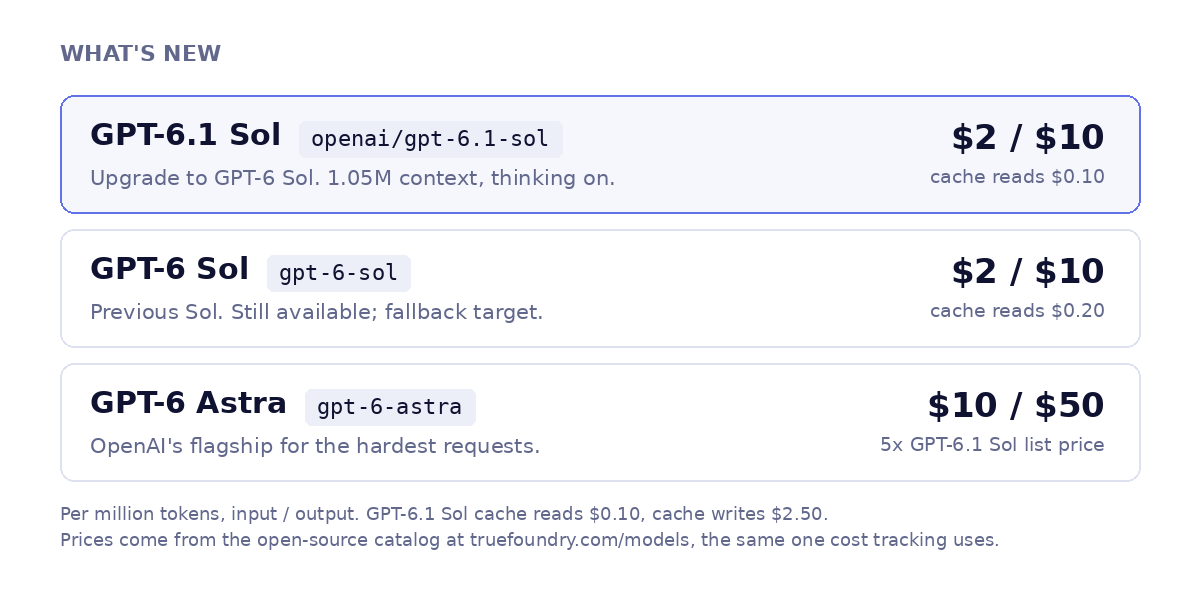
يُدرج الكتالوج GPT-6 Astra بسعر 10 دولارات لكل مليون رمز مدخل و50 دولاراً لكل مليون رمز مخرج. بينما يُدرج GPT-6.1 Sol بسعر 2 دولار و10 دولارات، أي خُمس السعر تماماً على كلا الجانبين، وتعد تكلفة قراءة التخزين المؤقت لديه البالغة 0.10 دولار عُشر تكلفة Astra البالغة 1 دولار.
قارن بين إصدارات هذا الشهر جنباً إلى جنب: GPT-6 Luna بسعر 0.10 دولار لكل مليون رمز مدخل، وGPT-6 Sol، وGPT-6.1 Sol، وClaude Sonnet 5.5 بسعر 2 دولار، وClaude Opus 5.5 بسعر 4 دولارات، وGPT-6 Astra بسعر 10 دولارات. يأخذ GPT-6.1 Sol مكان GPT-6 Sol في السلم بنفس السعر، مع أقل معدل لقراءة التخزين المؤقت في فئة الـ 2 دولار.
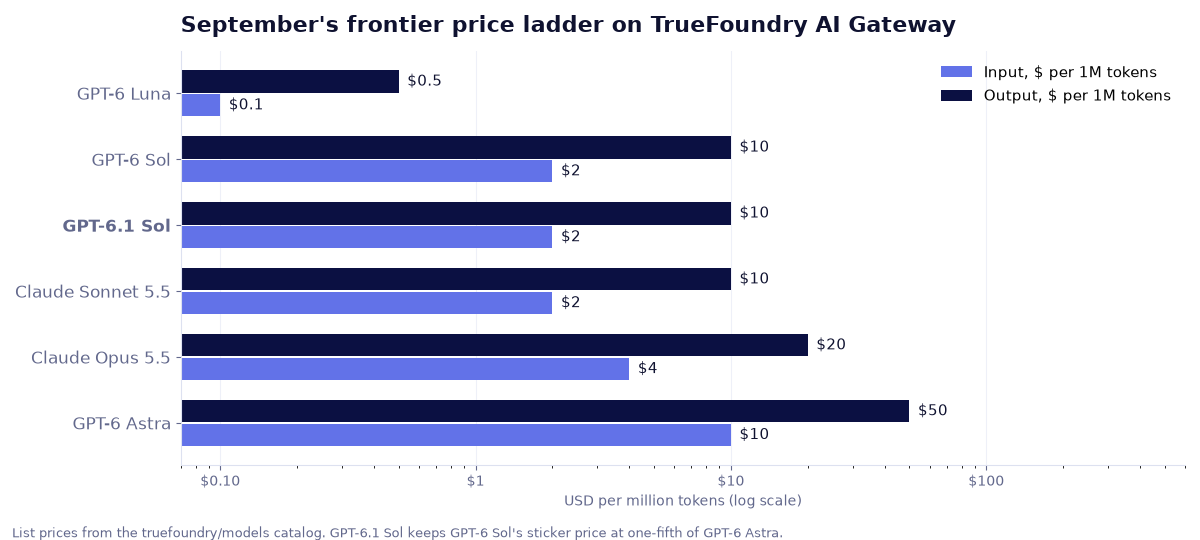
هذه هي الحجة لاعتبار اختيار النموذج بمثابة إعداد للبوابة (Gateway) بدلاً من كونه جزءاً من كود التطبيق. معظم حركة المرور في بيئة الإنتاج تتكون من عدد كبير من الطلبات السهلة وعدد قليل من الطلبات الصعبة. إذا تم توجيه الأغلبية السهلة إلى Luna، والطلبات المتوسطة إلى GPT-6.1 Sol، ولم يتم توجيه سوى الطلبات الصعبة إلى Astra، فإن الفاتورة الإجمالية لن تشبه أبداً فاتورة الاعتماد على Astra وحدها. هذا لا ينجح إلا عندما يكون التبديل مجرد تغيير في الإعدادات، وهو الغرض الذي صُممت من أجله بوابة الذكاء الاصطناعي (AI Gateway) .
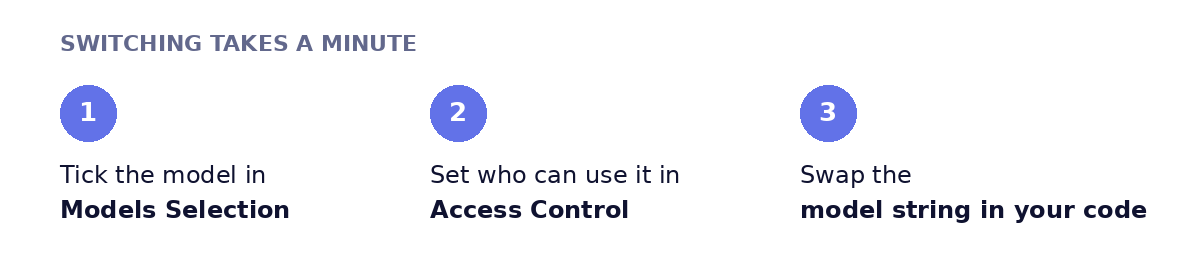
الخطوة 1: فعّل النموذج في حساب مزود الخدمة الخاص بك. في البوابة، افتح النماذج (Models) ← حساب OpenAI الخاص بك ← اختيار النماذج (Models Selection)، وابحث عن gpt-6.1-sol وقم بتحديده. تظهر الأسعار مباشرة (2 دولار للمدخلات / 10 دولارات للمخرجات لكل مليون رمز مميز) لأنها مستمدة مباشرة من الكتالوج. ثم قم بتعيين التحكم في الوصول بحيث يتم تحديد نطاق النموذج للفرق الصحيحة والمفاتيح الافتراضية منذ اليوم الأول.
OpenAI المباشر و OpenRouter (openai/gpt-6.1-sol) كلاهما متاحان في الكتالوج اليوم؛ كما أن إدخالات Microsoft Foundry و AWS Bedrock في طريقها للوصول.
ألا ترى النموذج في قائمتك؟ + إضافة نموذج في أسفل القائمة لإضافته يدوياً.
الخطوة 2: استدعاء النموذج. افتح ساحة التجربة (Playground)، واختر النموذج، وانسخ المقتطف البرمجي الذي تم إنشاؤه بأي حزمة تطوير برمجيات (SDK) تستخدمها. نسخة Python الخاصة بـ OpenAI هي:
from openai import OpenAI

client = OpenAI(
    api_key="<your-truefoundry-api-key>",
    base_url="https://gateway.truefoundry.ai",  # or your self-hosted gateway URL
)

# Model IDs are <provider-account>/<model>. Swap the string, keep everything else.
r = client.chat.completions.create(
    model="openai-main/gpt-6.1-sol",
    messages=[{"role": "user", "content": "Summarise this incident in three bullets: ..."}],
    extra_headers={"X-TFY-METADATA": '{"team": "platform", "feature": "incident-summary"}'},
)
print(r.choices[0].message.content)
يتم تحديد معرفات النماذج (Model IDs) بنظام النطاق <your-provider-account>/<model>، لذا فإن openai-main/gpt-6-sol و openai-main/gpt-6.1-sol يمكن استبدالهما في سطر واحد. يقوم ترويسة X-TFY-METADATA بتصنيف كل استدعاء بحيث يظهر الإنفاق لكل فريق أو لكل ميزة في عرض المقاييس.
الخطوة 3 (اختياري): وضعه خلف نموذج افتراضي. أنشئ نموذجاً افتراضياً واختر التوجيه التلقائي. تقوم البوابة بتصنيف كل طلب إلى بسيط أو متوسط أو معقد، ثم توجيهه إلى الوجهة التي تحددها لكل فئة. يُعد استخدام GPT-6 Luna للطلبات البسيطة، وGPT-6.1 Sol للمتوسطة، وGPT-6 Astra للمعقدة، مع تعيين GPT-6 Sol كخيار احتياطي أثناء استقرار حدود المعدل في أسبوع الإطلاق، خريطة بداية منطقية. في اختبارات الأداء لدينا، أدى هذا النوع من التوجيه إلى خفض التكاليف بنسبة 50-70% مع الحفاظ على جودة بنسبة 98% تقريباً. ويستخدم تطبيقك اسماً واحداً للنموذج في جميع الحالات.
يُعد GPT-6.1 Sol النموذج الأمثل عندما يتطلب الطلب قدرات أعلى من Luna ولكن يصعب تبرير تكلفة Astra، وعندما تقوم الوكلاء بإعادة إرسال سياق طويل تجعله تكلفة التخزين المؤقت البالغة 0.10 دولار رخيصاً. إن تشغيل هذا النموذج عبر TrueFoundry يعني أن قرار تحديد نوع الطلبات يتم في إعدادات البوابة، حيث يمكنك تغييره دون الحاجة إلى إعادة النشر.
جرب GPT-6.1 Sol على بوابة TrueFoundry للذكاء الاصطناعي →
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد


















